
Μοντέλα και πλατφόρμες AI
Παραγωγική τεχνητή νοημοσύνη: η ιδέα πίσω από το ChatGPT, το DALL-E, το Midjourney και άλλα εργαλεία

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΤα παραγωγικά μοντέλα ΤΝ όπως το GPT-4 δημιουργούν νέο περιεχόμενο από μοτίβα δεδομένων…
Δείτε περισσότερα
- Τα παραγωγικά μοντέλα ΤΝ όπως το GPT-4 δημιουργούν νέο περιεχόμενο από μοτίβα δεδομένων αντί απλώς να προβλέπουν αποτελέσματα.
- Ο μηχανισμός προσοχής της αρχιτεκτονικής Transformer επιτρέπει στην ΤΝ να εστιάζει στα σχετικά τμήματα κειμένου για ανώτερη παραγωγή γλώσσας.
- Τα μοντέλα διάχυσης όπως το DALL-E 2 βελτιώνουν επαναληπτικά τον θόρυβο σε εικόνες χρησιμοποιώντας προτροπές κειμένου.
Ο κόσμος της τέχνης, της επικοινωνίας και του πώς αντιλαμβανόμαστε την πραγματικότητα μεταμορφώνεται γρήγορα. Αν κοιτάξουμε πίσω στην ιστορία της ανθρώπινης καινοτομίας, ίσως να θεωρήσουμε την εφεύρεση του τροχού ή την ανακάλυψη της ηλεκτρικής ενέργειας ως κολοσσιαίες προόδους. Σήμερα, μια νέα επανάσταση λαμβάνει χώρα – γεφυρώνει το χάσμα μεταξύ της ανθρώπινης δημιουργικότητας και της υπολογιστικής μηχανής. Αυτή είναι η παραγωγική τεχνητή νοημοσύνη.
Τα παραγωγικά μοντέλα έχουν σβήσει τη γραμμή μεταξύ ανθρώπων και μηχανών. Με την έλευση μοντέλων όπως το GPT-4, το οποίο χρησιμοποιεί μονάδες μετασχηματιστών, έχουμε πλησιάσει τη φυσική και πλούσια σε συμφραζόμενα παραγωγή γλώσσας. Αυτές οι πρόοδοι έχουν τροφοδοτήσει εφαρμογές στη δημιουργία εγγράφων, συστήματα διαλόγου chatbot και ακόμη και σύνθεση μουσικής.
Πρόσφατες αποφάσεις μεγάλων εταιρειών υπογραμμίζουν τη σημασία τους. Η Microsoft (MSFT ) έχει ήδη διακόψει την εφαρμογή Cortana αυτόν τον μήνα για να προωθήσει νέες καινοτομίες της Παραγωγικής Τεχνητής Νοημοσύνης, όπως το Bing Chat. Η Apple (AAPL ) έχει επίσης αφιερώσει ένα σημαντικό μέρος του $22.6 δισεκατομμυρίων προϋπολογισμού έρευνας και ανάπτυξης στην παραγωγική τεχνητή νοημοσύνη, όπως ανέφερε ο διευθύνων σύμβουλος Tim Cook.
Μια Νέα Εποχή Μοντέλων: Παραγωγικά και διακριτικά μοντέλα
Η ιστορία της Παραγωγικής Τεχνητής Νοημοσύνης δεν αφορά μόνο τις εφαρμογές της, αλλά και τις εσωτερικές λειτουργίες της. Στο οικοσύστημα της τεχνητής νοημοσύνης, υπάρχουν δύο μοντέλα: διακριτικά και παραγωγικά.
Τα διακριτικά μοντέλα είναι αυτά που συναντάμε στην καθημερινή ζωή. Αυτοί οι αλγόριθμοι λαμβάνουν δεδομένα εισόδου, όπως κείμενο ή εικόνα, και τα ζευγαρώνουν με ένα στόχο εξόδου, όπως μια μετάφραση λέξης ή μια ιατρική διάγνωση. Ασχολούνται με τη χαρτογράφηση και την πρόβλεψη.
Τα παραγωγικά μοντέλα, από την άλλη πλευρά, είναι δημιουργοί. Δεν ερμηνεύουν απλώς ή προβλέπουν, αλλά γεννούν νέες, σύνθετες εξόδους από διανύσματα αριθμών που συχνά δεν σχετίζονται με πραγματικές τιμές.

Οι Τεχνολογίες Πίσω από τα Παραγωγικά Μοντέλα
Τα παραγωγικά μοντέλα οφείλουν την ύπαρξή τους στα βαθιά νευρωνικά δίκτυα, σύνθετες δομές που σχεδιάστηκαν για να μιμούνται τη λειτουργία του ανθρώπινου εγκεφάλου. Καταγράφοντας και επεξεργαζόμενα τις πολύπλοκες παραλλαγές στα δεδομένα, αυτά τα δίκτυα χρησιμεύουν ως η σπονδυλική στήλη πολλών παραγωγικών μοντέλων.
Πώς αυτά τα παραγωγικά μοντέλα έρχονται στη ζωή; Συνήθως, κατασκευάζονται με βαθιά νευρωνικά δίκτυα, βελτιστοποιημένα για να καταγράψουν τις πολύπλοκες παραλλαγές στα δεδομένα. Ένα πρωτοποριακό παράδειγμα είναι το Παραγωγικό Ανταγωνιστικό Δίκτυο (GAN), όπου δύο νευρωνικά δίκτυα, ο γεννήτορας και ο διακρίτης, ανταγωνίζονται και μαθαίνουν ο ένας από τον άλλον σε μια μοναδική σχέση δασκάλου-μαθητή. Από ζωγραφιές μέχρι μεταφορά στυλ, από σύνθεση μουσικής μέχρι παιχνίδι, αυτά τα μοντέλα εξελίσσονται και επεκτείνονται με τρόπους που προηγουμένως ήταν αδιανόητοι.
Αυτό δεν σταματάει στα GAN. Οι Μεταβλητοί Αυτοκωδικοποιητές (VAEs), είναι ένας ακόμη κρίσιμος παράγοντας στον τομέα των παραγωγικών μοντέλων. Οι VAEs ξεχωρίζουν για την ικανότητά τους να δημιουργούν φωτορεαλιστικές εικόνες από τυχαίους αριθμούς. Πώς; Επεξεργάζοντας αυτούς τους αριθμούς μέσω ενός λανθάνοντος διανύσματος, γεννιέται τέχνη που αντανακλά τις πολυπλοκότητες της ανθρώπινης αισθητικής.
Τύποι Παραγωγικής Τεχνητής Νοημοσύνης: Κείμενο σε Κείμενο, Κείμενο σε Εικόνα
Μετασχηματιστές και LLM
Το έγγραφο “Προσοχή είναι Όλα όσα Χρειάζεσαι” από το Google (GOOGL ) Brain σηματοδότησε μια στροφή στον τρόπο που σκεφτόμαστε για το μοντέλο κειμένου. Αντί για σύνθετες και ακολουθιακές αρχιτεκτονικές όπως τα Ανατροφοδοτούμενα Νευρωνικά Δίκτυα (RNNs) ή τα Συνελικτικά Νευρωνικά Δίκτυα (CNNs), το μοντέλο μετασχηματιστή εισήγαγε την έννοια της προσοχής, η οποία ουσιαστικά σήμαινε εστίαση σε διαφορετικά μέρη του κειμένου εισόδου ανάλογα με το πλαίσιο. Ένα από τα κύρια πλεονεκτήματα ήταν η ευκολία παραλληλοποίησης. Αντί για RNNs που επεξεργάζονται το κείμενο ακολουθιακά, καθιστώντας τα πιο δύσκολα να κλιμακωθούν, οι μετασχηματιστές μπορούν να επεξεργαστούν μέρη του κειμένου ταυτόχρονα, καθιστώντας την εκπαίδευση γρηγορότερη και πιο αποτελεσματική σε μεγάλες βάσεις δεδομένων.

Σε ένα μεγάλο κείμενο, δεν έχει κάθε λέξη ή πρόταση που διαβάζουμε την ίδια σημασία. Ορισμένα μέρη απαιτούν περισσότερη προσοχή με βάση το πλαίσιο. Αυτή η ικανότητα να μετατοπίζουμε την προσοχή μας με βάση τη σχετικότητα είναι αυτό που μιμείται ο μηχανισμός προσοχής.
Για να κατανοήσουμε αυτό, σκεφτείτε μια πρόταση: “Unite AI Δημοσιεύει Νέα για την Τεχνητή Νοημοσύνη και τη Ρομποτική.” Η πρόβλεψη της επόμενης λέξης απαιτεί κατανόηση του τι έχει σημασία περισσότερο στο προηγούμενο πλαίσιο. Ο όρος ‘Ρομποτική’ μπορεί να υποδηλώσει ότι η επόμενη λέξη θα σχετίζεται με μια συγκεκριμένη πρόοδο ή γεγονός στον τομέα της ρομποτικής, ενώ ο όρος ‘Δημοσιεύει’ μπορεί να δείξει ότι το επόμενο πλαίσιο μπορεί να ασχοληθεί με μια πρόσφατη δημοσίευση ή άρθρο.
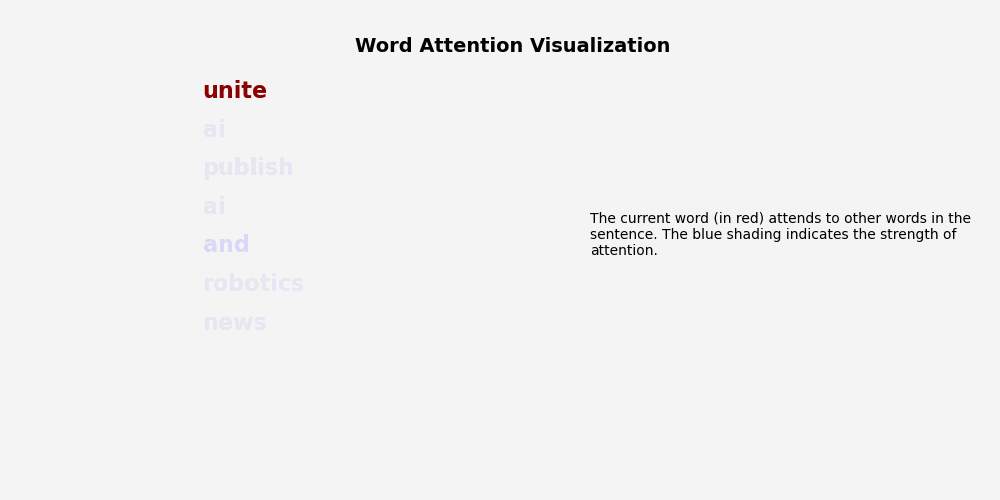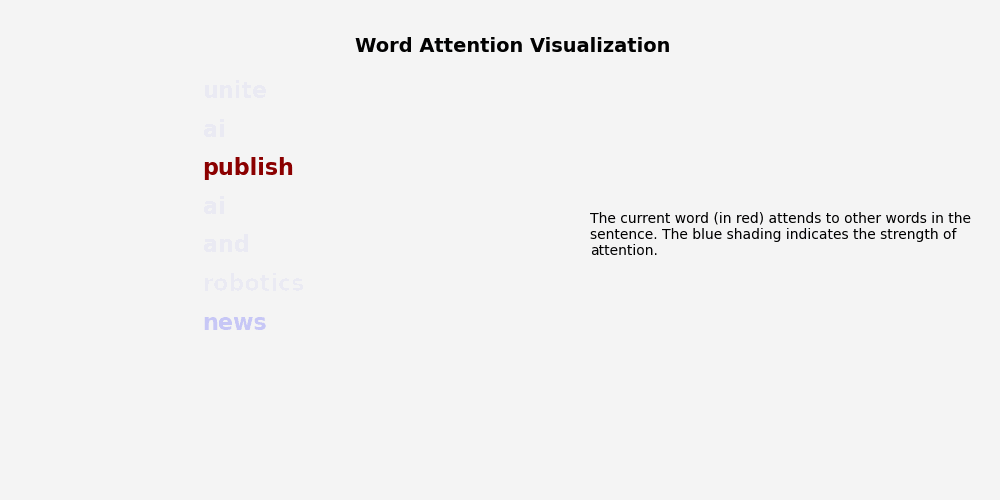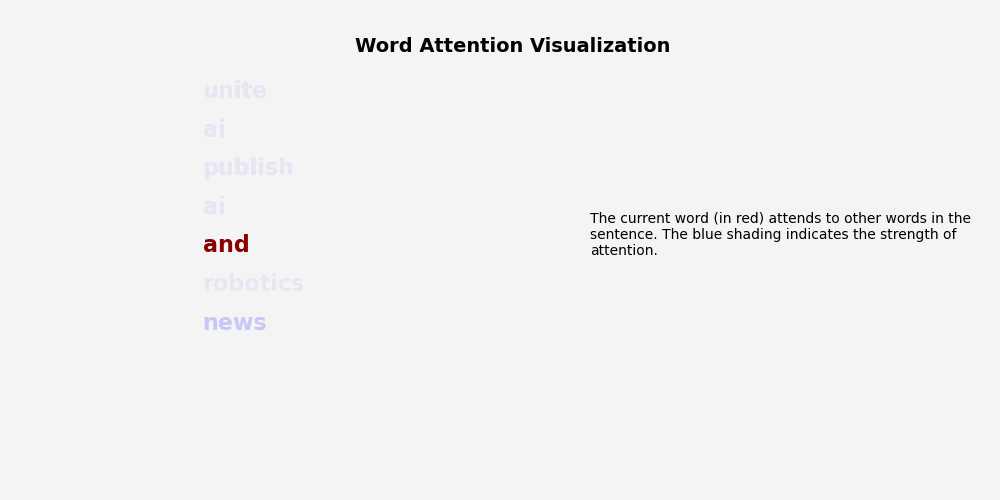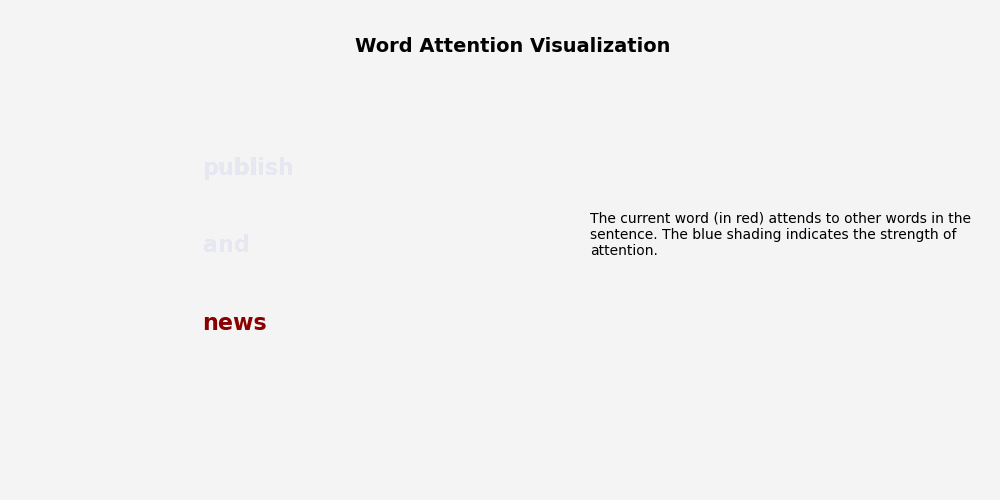
- Εικονογράφηση Αυτο-Προσοχής
Οι μηχανισμοί προσοχής στους μετασχηματιστές σχεδιάστηκαν για να επιτύχουν αυτήν την επιλεκτική εστίαση. Αξιολογούν τη σημασία των διαφορετικών μερών του κειμένου εισόδου και αποφασίζουν πού να “κοιτάξουν” όταν παράγουν μια απάντηση. Αυτό είναι μια απομάκρυνση από παλαιότερες αρχιτεκτονικές όπως τα RNNs που προσπάθησαν να συμπιέσουν την ουσία του ολόκληρου κειμένου σε μια μόνο “κατάσταση” ή “μνήμη”.
Η λειτουργία της προσοχής μπορεί να συγκριθεί με ένα σύστημα ανάκτησης κλειδιού-τιμής. Σε μια προσπάθεια να προβλέψουμε την επόμενη λέξη σε μια πρόταση, κάθε προηγούμενη λέξη προσφέρει ένα “κλειδί” που υποδηλώνει την πιθανή συνάφειά της, και με βάση πόσο καλά αυτά τα κλειδιά ταιριάζουν με το τρέχον πλαίσιο (ή ερώτημα), συνεισφέρουν μια «τιμή» ή βάρος στην πρόβλεψη.
Αυτά τα προηγμένα μοντέλα βαθιάς μάθησης έχουν ενσωματωθεί άψογα σε διάφορες εφαρμογές, από τις βελτιώσεις της μηχανής αναζήτησης της Google με το BERT μέχρι το Copilot της GitHub, το οποίο αξιοποιεί την ικανότητα των Μεγάλων Μοντέλων Γλώσσας (LLMs) για να μετατρέψει απλά αποσπάσματα κώδικα σε πλήρεις πηγαίους κώδικες.
Τα Μεγάλα Μοντέλα Γλώσσας (LLMs) όπως το GPT-4, το Bard και το LLaMA, είναι κολοσσιαίες κατασκευές σχεδιασμένες για να αποκωδικοποιήσουν και να γεννήσουν ανθρώπινη γλώσσα, κώδικα και άλλα. Το τεράστιο μέγεθός τους, που κυμαίνεται από δισεκατομμύρια έως τρισεκατομμύρια παραμέτρων, είναι ένα από τα οριστικά χαρακτηριστικά. Αυτά τα LLMs τροφοδοτούνται με τεράστιες ποσότητες δεδομένων κειμένου, επιτρέποντάς τους να κατανοήσουν τις ιδιαιτερότητες της ανθρώπινης γλώσσας. Ένα εντυπωσιακό χαρακτηριστικό αυτών των μοντέλων είναι η ικανότητά τους για μάθηση με λίγα παραδείγματα (few-shot). Αντί για συμβατικά μοντέλα που χρειάζονται τεράστιες ποσότητες ειδικών δεδομένων εκπαίδευσης, τα LLMs μπορούν να γενικεύσουν από πολύ περιορισμένα παραδείγματα (ή «παραδείγματα», shots)
Κατάσταση των Μεγάλων Μοντέλων Γλώσσας (LLMs) από τα μέσα του 2023
| Όνομα Μοντέλου | Δημιουργός | Παράμετροι | Διαθεσιμότητα και Πρόσβαση | Αξιοσημείωτα χαρακτηριστικά & Παρατηρήσεις |
| GPT-4 | OpenAI | 1.5 Τρισεκατομμύρια | Δεν είναι Ανοικτό Λογισμικό, Πρόσβαση μόνο μέσω API | Εντυπωσιακή απόδοση σε διάφορες εργασίες, μπορεί να επεξεργαστεί εικόνες και κείμενο, μέγιστο μήκος εισόδου 32.768 tokens |
| GPT-3 | OpenAI | 175 δισεκατομμύρια | Δεν είναι Ανοικτό Λογισμικό, Πρόσβαση μόνο μέσω API | Έδειξε ικανότητες few-shot και zero-shot μάθησης. Εκτελεί συμπλήρωση κειμένου σε φυσική γλώσσα. |
| BLOOM | BigScience | 176 δισεκατομμύρια | Λήψη Μοντέλου, Διαθέσιμο API | Πολυγλωσσικό LLM που αναπτύχθηκε από μια παγκόσμια συνεργασία. Υποστηρίζει 13 γλώσσες προγραμματισμού. |
| LaMDA | 173 δισεκατομμύρια | Δεν είναι Ανοικτό Λογισμικό, Χωρίς API ή Λήψη | Εκπαιδευμένο σε διάλογο, μπορεί να μάθει να μιλάει σχεδόν για οτιδήποτε. | |
| MT-NLG | Nvidia /Microsoft | 530 δισεκατομμύρια | Πρόσβαση API με αίτηση | Χρησιμοποιεί αρχιτεκτονική Megatron-με βάση Transformers για διάφορες εργασίες NLP. |
| LLaMA | Meta AI | 7B έως 65B) | Λήψη με αίτηση | Σκοπεύει να δημοκρατίσει την Τεχνητή Νοημοσύνη, προσφέροντας πρόσβαση σε ερευνητές, κυβερνήσεις και ακαδημαϊκούς. |
Πώς Χρησιμοποιούνται τα LLMs;
Τα LLMs μπορούν να χρησιμοποιηθούν με πολλούς τρόπους, συμπεριλαμβανομένων:
- Απευθείας Χρήση: Απλώς χρησιμοποιώντας ένα προ-εκπαιδευμένο LLM για παραγωγή ή επεξεργασία κειμένου. Για παράδειγμα, χρησιμοποιώντας το GPT-4 για να γράψετε ένα άρθρο blog χωρίς επιπλέον fine-tuning.
- Λεπτομερής προσαρμογή: Προσαρμόζοντας ένα προ-εκπαιδευμένο LLM για μια συγκεκριμένη εργασία, μια μέθοδος γνωστή ως μεταφορά μάθησης. Ένα παράδειγμα θα ήταν η προσαρμογή του T5 για να παράγει περίληψη για έγγραφα σε μια συγκεκριμένη βιομηχανία.
- Αναζήτηση Πληροφοριών: Χρησιμοποιώντας LLMs, όπως το BERT ή το GPT, ως μέρος μεγαλύτερων αρχιτεκτονικών για την ανάπτυξη συστημάτων που μπορούν να ανακτήσουν και να ταξινομήσουν πληροφορίες.

- Αρχιτεκτονική λεπτομερούς προσαρμογής του ChatGPT
Πολυκεφαλή Προσοχή: Γιατί Ένα Όταν Μπορείς Να Έχεις Πολλά;
Ωστόσο, η εξάρτηση από έναν μηχανισμό προσοχής μπορεί να είναι περιοριστική. Διαφορετικά λόγια ή ακολουθίες σε ένα κείμενο μπορούν να έχουν διαφορετικά είδη σχετικότητας ή συσχετίσεων. Αυτό είναι όπου η πολυκεφαλή προσοχή έρχεται. Αντί για ένα σύνολο βαρών προσοχής, η πολυκεφαλή προσοχή χρησιμοποιεί πολλά σύνολα, επιτρέποντας στο μοντέλο να καταγράψει μια πλουσιότερη ποικιλία σχέσεων στο κείμενο εισόδου. Κάθε “κεφαλή” προσοχής μπορεί να εστιάσει σε διαφορετικά μέρη ή πτυχές του κειμένου εισόδου, και η συνδυασμένη γνώση τους χρησιμοποιείται για την τελική πρόβλεψη.
ChatGPT: Το πιο Δημοφιλές Εργαλείο Παραγωγικής Τεχνητής Νοημοσύνης
Ξεκινώντας από την αρχή του GPT το 2018, το μοντέλο ήταν ουσιαστικά χτισμένο σε 12 στρώματα, 12 κεφαλές προσοχής και 120 εκατομμύρια παραμέτρους, κυρίως εκπαιδευμένο σε ένα σύνολο δεδομένων που ονομάζεται BookCorpus. Αυτή ήταν μια εντυπωσιακή αρχή, προσφέροντας μια ματιά στο μέλλον των μοντέλων γλώσσας.
Το GPT-2, που παρουσιάστηκε το 2019, διέθετε μια τετραπλή αύξηση σε στρώματα και κεφαλές προσοχής. Σημαντικά, ο αριθμός παραμέτρων του εκτοξεύτηκε σε 1,5 δισεκατομμύρια. Αυτή η ενισχυμένη έκδοση εκπαιδεύτηκε με το WebText, ένα σύνολο δεδομένων εμπλουτισμένο με 40GB κειμένου από διάφορους συνδέσμους Reddit.
Το GPT-3, που κυκλοφόρησε τον Μάιο του 2020, είχε 96 στρώματα, 96 κεφαλές προσοχής και έναν τεράστιο αριθμό παραμέτρων 175 δισεκατομμυρίων. Αυτό που ξεχώριζε το GPT-3 ήταν η ποικιλία των δεδομένων εκπαίδευσής του, που περιελάμβανε CommonCrawl, WebText, Αγγλική Βικιπαίδεια, συλλογές βιβλίων και άλλα, συνδυασμένα για ένα σύνολο 570 GB.
Οι λεπτομέρειες της λειτουργίας του ChatGPT παραμένουν ένα στενά φυλαγμένο μυστικό. Ωστόσο, μια διαδικασία που ονομάζεται «ενισχυτική μάθηση από ανθρώπινη ανατροφοδότηση» (RLHF) είναι γνωστό ότι είναι κρίσιμη. Προερχόμενη από ένα προηγούμενο έργο ChatGPT, αυτή η τεχνική ήταν ουσιαστική για την εξέλιξη του μοντέλου GPT-3.5 να είναι πιο συναρμονικό με γραπτές οδηγίες.
Η εκπαίδευση του ChatGPT αποτελείται από μια τριών σταδίων προσέγγιση:
- Λεπτομερής προσαρμογή με επίβλεψη: Περιλαμβάνει την επιμέρους επιλογή ανθρώπινων γραπτών εισοδών και εξοδών για να βελτιώσει το υποκείμενο μοντέλο GPT-3.5.
- Μοντέλο ανταμοιβής: Άνθρωποι βαθμολογούν διάφορες εξόδους του μοντέλου με βάση την ποιότητα, βοηθώντας στην εκπαίδευση ενός μοντέλου ανταμοιβής που βαθμολογεί κάθε έξοδο με βάση το πλαίσιο της συνομιλίας.
- Ενισχυτική μάθηση: Το πλαίσιο της συνομιλίας χρησιμεύει ως υπόβαθρο όπου το υποκείμενο μοντέλο προτείνει μια απάντηση. Αυτή η απάντηση αξιολογείται από το μοντέλο ανταμοιβής, και η διαδικασία βελτιώνεται χρησιμοποιώντας έναν αλγόριθμο που ονομάζεται proximal policy optimization (PPO).
Για εκείνους που μόλις αρχίζουν να εξερευνούν το ChatGPT, ένας ολοκληρωμένος οδηγός έναρξης μπορεί να βρεθεί εδώ. Αν ψάχνετε να βυθιστείτε πιο βαθιά στη μηχανική προτροπών με το ChatGPT, έχουμε έναν προηγμένο οδηγό που φωτίζει τις τελευταίες και τις πιο εξελιγμένες τεχνικές προτροπών, διαθέσιμο στο ‘ChatGPT & Προηγμένη Μηχανική Προτροπών: Οδηγώντας την Εξέλιξη της Τεχνητής Νοημοσύνης‘.
Διάχυση και πολυτροπικά μοντέλα
Ενώ μοντέλα όπως τα VAEs και GANs παράγουν τις εξόδους τους μέσα από μια μόνο διαδικασία, και επομένως είναι κλειδωμένα σε ό,τι παράγουν, τα μοντέλα διάχυσης έχουν εισαγάγει την έννοια της «επαναλαμβανόμενης βελτίωσης». Μέσω αυτής της μεθόδου, επιστρέφουν, διορθώνουν λάθη από προηγούμενα βήματα και σταδιακά παράγουν ένα πιο τελειοποιημένο αποτέλεσμα.
Κεντρικό στοιχείο των μοντέλων διάχυσης είναι η τέχνη της «αλλοίωσης» και “βελτίωσης”. Κατά τη φάση εκπαίδευσής τους, μια τυπική εικόνα αλλοιώνεται σταδιακά με την προσθήκη ποικίλου βαθμού θορύβου. Αυτή η θορυβώδης εκδοχή τότε παρέχεται στο μοντέλο, το οποίο προσπαθεί να “απαλλαγεί από θόρυβο” ή «αφαιρέσει την αλλοίωση». Μέσω πολλαπλών γύρων αυτής της διαδικασίας, το μοντέλο γίνεται ικανό στην αποκατάσταση, κατανοώντας τόσο τις λεπτές όσο και τις σημαντικές ανωμαλίες.

- Εικόνα που παράγεται από το Midjourney
Η διαδικασία της δημιουργίας νέων εικόνων μετά την εκπαίδευση είναι εντυπωσιακή. Ξεκινώντας από μια εντελώς τυχαία είσοδο, συνεχώς βελτιώνεται χρησιμοποιώντας τις προβλέψεις του μοντέλου. Ο στόχος είναι να επιτευχθεί μια καθαρή εικόνα με τον ελάχιστο αριθμό βημάτων. Ο έλεγχος του βαθμού αλλοίωσης γίνεται μέσω ενός «προγράμματος θορύβου», ενός μηχανισμού που καθορίζει πόσο θόρυβο εφαρμόζεται σε διάφορες φάσεις. Ένας χρονοπρογραμματιστής, όπως σε βιβλιοθήκες όπως το “diffusers“, καθορίζει τη φύση αυτών των θορυβωδών εκδοχών με βάση καθιερωμένους αλγορίθμους.
Βασικό αρχιτεκτονικό στοιχείο πολλών μοντέλων διάχυσης είναι το UNet, ένα συνελικτικό νευρωνικό δίκτυο προσαρμοσμένο σε εργασίες που απαιτούν εξόδους με χωρικές διαστάσεις αντίστοιχες των εισόδων. Συνδυάζει επίπεδα υποδειγματοληψίας και υπερδειγματοληψίας, συνδεδεμένα έτσι ώστε να διατηρούν δεδομένα υψηλής ανάλυσης, τα οποία είναι καθοριστικά για εξόδους εικόνας.
Εμβαθύνοντας στα παραγωγικά μοντέλα, το DALL-E 2 της OpenAI αποτελεί χαρακτηριστικό παράδειγμα συνδυασμού γλωσσικών και οπτικών δυνατοτήτων ΤΝ. Χρησιμοποιεί δομή τριών επιπέδων:
Το DALL-E 2 παρουσιάζει αρχιτεκτονική τριών μερών:
- Κωδικοποιητής κειμένου: Μετατρέπει την προτροπή κειμένου σε εννοιολογική ενσωμάτωση μέσα σε λανθάνοντα χώρο. Το μοντέλο δεν ξεκινά από το μηδέν· βασίζεται στο σύνολο δεδομένων Contrastive Language–Image Pre-training (CLIP) της OpenAI. Το CLIP γεφυρώνει οπτικά και γλωσσικά δεδομένα μαθαίνοντας οπτικές έννοιες μέσω φυσικής γλώσσας. Μέσω αντιθετικής μάθησης, αναγνωρίζει εικόνες και τις αντιστοιχίζει στις σχετικές περιγραφές κειμένου.
- Το prior: Η ενσωμάτωση κειμένου από τον κωδικοποιητή μετατρέπεται κατόπιν σε ενσωμάτωση εικόνας. Το DALL-E 2 δοκίμασε τόσο αυτοπαλινδρομικές μεθόδους όσο και μεθόδους διάχυσης γι’ αυτή την εργασία, με τις δεύτερες να παρουσιάζουν καλύτερα αποτελέσματα. Τα αυτοπαλινδρομικά μοντέλα, όπως οι μετασχηματιστές και το PixelCNN, παράγουν διαδοχικές εξόδους. Αντίθετα, τα μοντέλα διάχυσης, όπως εκείνο του DALL-E 2, μετατρέπουν τυχαίο θόρυβο σε προβλεπόμενες ενσωματώσεις εικόνας με τη βοήθεια των ενσωματώσεων κειμένου.
- Ο αποκωδικοποιητής: Στο τελικό στάδιο, αυτό το μέρος παράγει την οριστική οπτική έξοδο με βάση την προτροπή κειμένου και την ενσωμάτωση εικόνας του προηγούμενου σταδίου. Ο αποκωδικοποιητής του DALL-E 2 αντλεί την αρχιτεκτονική του από το GLIDE, ένα άλλο μοντέλο που μπορεί επίσης να παράγει ρεαλιστικές εικόνες από περιγραφές κειμένου.

- Απλοποιημένη αρχιτεκτονική του μοντέλου DALL-E
Οι χρήστες Python που ενδιαφέρονται για το Langchain μπορούν να συμβουλευτούν τον αναλυτικό οδηγό μας, που καλύπτει από τις βασικές αρχές έως τις προηγμένες τεχνικές.
Εφαρμογές της Παραγωγικής Τεχνητής Νοημοσύνης
Κειμενικά Πεδία
Ξεκινώντας από το κείμενο, η Παραγωγική Τεχνητή Νοημοσύνη έχει μεταμορφωθεί θεμελιωδώς από chatbots όπως το ChatGPT. Βασισμένα σε μεγάλο βαθμό στη Φυσική Γλώσσα και τα Μεγάλα Μοντέλα Γλώσσας (LLMs), αυτά τα συστήματα είναι ενδυναμωμένα να εκτελέσουν εργασίες που κυμαίνονται από την παραγωγή κώδικα και τη μετάφραση γλώσσας μέχρι τη σύνοψη και την ανάλυση συναισθήματος. Το ChatGPT, για παράδειγμα, έχει δει ευρεία υιοθέτηση, καθώς έγινε βασικό εργαλείο για εκατομμύρια ανθρώπους. Αυτό ενισχύεται από πλατφόρμες συνομιλίας, βασισμένες σε LLMs όπως το GPT-4, το PaLM, και το BLOOM, που παράγουν εύκολα κείμενο, βοηθούν στον προγραμματισμό και ακόμη και προσφέρουν μαθηματική λογική.
Από εμπορική άποψη, αυτά τα μοντέλα γίνονται ανεκτίμητα. Οι επιχειρήσεις τα χρησιμοποιούν σε πολλές λειτουργίες, μεταξύ των οποίων η διαχείριση κινδύνων, η βελτιστοποίηση αποθεμάτων και η πρόβλεψη ζήτησης. Χαρακτηριστικά παραδείγματα είναι το Bing AI, το BARD της Google και το API του ChatGPT.
Τέχνη
Ο κόσμος των εικόνων έχει δει δραματικές μεταμορφώσεις με τη Παραγωγική Τεχνητή Νοημοσύνη, ιδιαίτερα από την εισαγωγή του DALL-E 2 το 2022. Αυτή η τεχνολογία, που μπορεί να παράγει εικόνες από κειμενικές προτροπές, έχει και καλλιτεχνικές και επαγγελματικές επιπτώσεις. Για παράδειγμα, το midjourney έχει αξιοποιήσει αυτή τη τεχνολογία για να παράγει εντυπωσιακά ρεαλιστικές εικόνες. Αυτό το πρόσφατο άρθρο απομυθοποιεί το Midjourney σε έναν ολοκληρωμένο οδηγό, διευκρινίζοντας τόσο την πλατφόρμα όσο και τις λεπτομέρειες της μηχανικής προτροπών. Επιπλέον, πλατφόρμες όπως το Alpaca AI και το Photoroom AI χρησιμοποιούν τη Παραγωγική Τεχνητή Νοημοσύνη για προηγμένες λειτουργίες επεξεργασίας εικόνων, όπως αφαίρεση φόντου, διαγραφή αντικειμένων και ακόμη και αποκατάσταση προσώπου.
Παραγωγή Βίντεο
Η παραγωγή βίντεο, ενώ ακόμη βρίσκεται σε μια πρώιμη φάση στον κόσμο της Παραγωγικής Τεχνητής Νοημοσύνης, δείχνει υποσχόμενες προόδους. Πλατφόρμες όπως το Imagen Video, το Meta Make A Video και το Runway Gen-2 διευρύνουν τα όρια του δυνατού, ακόμη και αν πραγματικά ρεαλιστικά αποτελέσματα είναι ακόμη στον ορίζοντα. Αυτά τα μοντέλα προσφέρουν σημαντική χρησιμότητα για τη δημιουργία ψηφιακών βίντεο ανθρώπων, με εφαρμογές όπως το Synthesia και το SuperCreator να ηγούνται. Ιδιαίτερα, το Tavus AI προσφέρει ένα μοναδικό ανταγωνιστικό πλεονέκτημα, προσωπικοποιώντας βίντεο για μεμονωμένα μέλη του κοινού, ένα πλεονέκτημα για τις επιχειρήσεις.
Δημιουργία Κώδικα
Ο κώδικας, ένας απαραίτητος τομέας του ψηφιακού μας κόσμου, δεν έχει μείνει απαθής από τη Παραγωγική Τεχνητή Νοημοσύνη. Αν και το ChatGPT είναι ένα αγαπημένο εργαλείο, πολλές άλλες εφαρμογές Τεχνητής Νοημοσύνης έχουν αναπτυχθεί για σκοπούς προγραμματισμού. Αυτά τα εργαλεία, όπως το GitHub Copilot, το Alphacode και το CodeComplete, χρησιμεύουν ως βοηθοί προγραμματισμού και μπορούν ακόμη και να παράγουν κώδικα από κειμενικές προτροπές. Τι είναι εντυπωσιακό είναι η προσαρμοστικότητα αυτών των εργαλείων. Το Codex, η κινητήρια δύναμη πίσω από το GitHub Copilot, μπορεί να προσαρμοστεί στο προσωπικό στυλ προγραμματισμού, υπογραμμίζοντας το δυναμικό της προσωπικής προσαρμογής της Παραγωγικής Τεχνητής Νοημοσύνης.
Συμπέρασμα
Συνδυάζοντας την ανθρώπινη δημιουργικότητα με τον υπολογισμό από μηχανές, έχει εξελιχθεί σε ένα απαραίτητο εργαλείο, με πλατφόρμες όπως το ChatGPT και το DALL-E 2 να διευρύνουν τα όρια του δυνατού. Από τη δημιουργία κειμένου μέχρι τη δημιουργία οπτικών αριστουργημάτων, οι εφαρμογές τους είναι τεράστιες και ποικίλες.
Όπως και με κάθε τεχνολογία, οι ηθικές επιπτώσεις είναι πρωταρχικής σημασίας. Ενώ η Παραγωγική Τεχνητή Νοημοσύνη υπόσχεται απέραντη δημιουργικότητα, είναι κρίσιμο να τη χρησιμοποιούμε με ευθύνη, έχοντας επίγνωση των πιθανών προκαταλήψεων και της δύναμης της χειραγώγησης δεδομένων.
Με εργαλεία όπως το ChatGPT να γίνονται πιο προσιτά, τώρα είναι η ιδανική στιγμή να δοκιμάσουμε τα νερά και να πειραματιστούμε. Αν είστε καλλιτέχνης, προγραμματιστής ή λάτρης της τεχνολογίας, ο κόσμος της Παραγωγικής Τεχνητής Νοημοσύνης είναι πλήρης με δυνατότητες που περιμένουν να εξερευνηθούν. Η επανάσταση δεν είναι στον ορίζοντα, είναι εδώ και τώρα. Έτσι, Μπείτε μέσα!


