Η γωνία του Anderson
Πώς γνωρίζουμε αν τα συστήματα σύνθεσης εικόνων παράγουν πραγματικά πρωτότυπο υλικό

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΤο Rarity Score του KAIST και της NAVER μετρά την πρωτοτυπία μιας εικόνας μέσω…
Δείτε περισσότερα
- Το Rarity Score του KAIST και της NAVER μετρά την πρωτοτυπία μιας εικόνας μέσω αποστάσεων πλησιέστερου γείτονα.
- Υπάρχουσες μετρήσεις, όπως το Truncation Trick, ευνοούν την αυθεντικότητα έναντι της καινοτομίας σε παραγόμενες εικόνες.
- Το Rarity Score θα μπορούσε να εντοπίσει πραγματικά εφευρετικές εξόδους από συστήματα όπως το DALL-E 2.
Μια νέα μελέτη από τη Νότια Κορέα έχει προτείνει έναν τρόπο για να καθορίσετε εάν τα συστήματα σύνθεσης εικόνας παράγουν πραγματικά καινοτόμες εικόνες ή μικρές παραλλαγές των δεδομένων εκπαίδευσης, που μπορεί να υπονομεύουν τον στόχο τέτοιων αρχιτεκτονικών (όπως η παραγωγή καινοτόμων και πρωτότυπων εικόνων).
Πολύ συχνά, η εργασία προτείνει, το δεύτερο είναι αλήθεια, επειδή τα υπάρχοντα μετρικά που χρησιμοποιούν αυτά τα συστήματα για να βελτιώσουν τις παραγωγικές τους ικανότητες κατά τη διάρκεια της εκπαίδευσης είναι αναγκασμένα να ευνοούν εικόνες που είναι σχετικά κοντά στις (μη ψευδείς) πηγαίες εικόνες στη βάση δεδομένων.
Αφού, αν μια παραγόμενη εικόνα είναι “οπτικά κοντά” στα δεδομένα πηγής, είναι αναπόφευκτα πιθανό να λάβει υψηλότερη βαθμολογία για “αυθεντικότητα” από “καινοτομία”, αφού είναι “πιστή” – αν και μη εμπνευσμένη.
Σε ένα τομέα που είναι ακόμη νωπός και ανεξέταστος για τις νομικές του επιπτώσεις να είναι ακόμη άγνωστες, αυτό θα μπορούσε να αποδειχθεί σημαντικό νομικό ζήτημα, αν αποδειχθεί ότι εμπορικά συνθετικά περιεχόμενο εικόνας δεν διαφέρει αρκετά από το (συχνά) πνευματικά καταχωρημένο υλικό πηγής που σήμερα επιτρέπεται να διεισδύει στον τομέα της έρευνας με τη μορφή δημοφιλών συνόλων δεδομένων που έχουν συλλεχθεί από το ιντερνέτ (η πιθανότητα μελλοντικών αξιώσεων παραβίασης πνευματικών δικαιωμάτων αυτού του είδους έχει προβληθεί πρόσφατα σε σχέση με το GitHub Co-Pilot AI της Microsoft ).
Όσον αφορά την ολοένα και πιο συνεκτική και σημασιολογικά συνεκτική έξοδο από συστήματα όπως το DALL-E 2 της OpenAI, το Imagen της Google και τις κυκλοφορίες CogView της Κίνας (καθώς και το DALL-E mini με χαμηλότερες προδιαγραφές), υπάρχουν πολύ λίγοι εκ των υστέρων τρόποι για να δοκιμάσετε με αξιοπιστία την πρωτοτυπία μιας παραγόμενης εικόνας.
Πράγματι, η αναζήτηση για μερικές από τις πιο δημοφιλείς εικόνες του DALL-E 2 θα οδηγήσει συχνά μόνο σε περαιτέρω παραδείγματα των ίδιων εικόνων, ανάλογα με το μηχανή αναζήτησης.

Ανεβάζοντας μια ολοκληρωμένη ομάδα 9 εικόνων DALL-E 2 οδηγεί μόνο σε άλλες ομάδες DALL-E 2, επειδή η δομή του πλέγματος είναι το ισχυρότερο χαρακτηριστικό. Η διάσπαση και ανέβασμα της πρώτης εικόνας (από αυτή τη δημοσίευση του Twitter της 8ης Ιουνίου 2022, από το λογαριασμό ‘Weird Dall-E Generations’) προκαλεί στο Google να εστιάσει στην μπάλα του μπάσκετ στη φωτογραφία, οδηγώντας την αναζήτηση εικόνας σε μια σημασιολογικό αδιέξοδο. Για την ίδια αναζήτηση εικόνας, η Yandex φαίνεται τουλάχιστον να κάνει κάποια πραγματική ανάλυση pixel και αντιστοίχηση χαρακτηριστικών.
Αν και η Yandex είναι πιο πιθανό από το Google Search να χρησιμοποιήσει τα πραγματικά χαρακτηριστικά (δηλ. τα υπολογισμένα χαρακτηριστικά μιας εικόνας, όχι απαραίτητα τα χαρακτηριστικά προσώπου των ανθρώπων) και οπτικά (παρά σεμαντικά) χαρακτηριστικά μιας υποβεβλημένης εικόνας για να βρει παρόμοιες εικόνες, όλα τα μηχανήματα αναζήτησης εικόνας έχουν κάποιο είδος στόχευσης ή πρακτικής που μπορεί να κάνει δύσκολο να αναγνωριστούν περιπτώσεις πηγή>παραγόμενη λογοκλοπής μέσω αναζητήσεων στο διαδίκτυο.
Επιπλέον, τα δεδομένα εκπαίδευσης για ένα παραγωγικό μοντέλο μπορεί να μην είναι διαθέσιμα στο σύνολό τους, περαιτέρω εμποδίζοντας την εγκληματολογική εξέταση της πρωτοτυπίας των παραγόμενων εικόνων.
Ενδιαφέροντα, η εκτέλεση μιας αναζήτησης εικόνας στο διαδίκτυο για μια από τις συνθετικές εικόνες που παρουσιάζονται από τη Google στη αφιερωμένη ιστοσελίδα Imagen βρίσκει απολύτως τίποτα συγκρίσιμο με το αντικείμενο της εικόνας, όσον αφορά την πραγματική αναζήτηση εικόνας. Αντίθετα, η αναζήτηση εικόνας της Google για αυτή τη φωτογραφία Imagen δεν θα επιτρέψει μια καθαρή αναζήτηση εικόνας χωρίς να προσθέσει τους όρους αναζήτησης ‘imagen google’ ως πρόσθετο (και περιοριστικό) παράμετρο:

Η Yandex, αντίθετα, βρίσκει πολλές παρόμοιες (ή τουλάχιστον οπτικά συναφείς) πραγματικές εικόνες από την ερασιτεχνική καλλιτεχνική κοινότητα:

Γενικά, θα ήταν καλύτερο αν η καινοτομία ή η πρωτοτυπία της έξοδου των συστημάτων σύνθεσης εικόνας θα μπορούσε με κάποιον τρόπο να μετρηθεί, χωρίς να χρειάζεται να εξαγάγει χαρακτηριστικά από κάθε δυνατή εικόνα στο διαδίκτυο την ώρα που το μοντέλο εκπαιδεύτηκε, ή σε μη δημόσιες βάσεις δεδομένων που μπορεί να χρησιμοποιούν πνευματικά καταχωρημένο υλικό.
Σχετικά με αυτό το ζήτημα, ερευνητές από τη σχολή Kim Jaechul Graduate School of AI στο Korea Advanced Institute of Science and Technology (KAIST AI) έχουν συνεργαστεί με την παγκόσμια εταιρεία ICT και αναζήτησης NAVER Corp για να αναπτύξουν έναν Βαθμό Σπανιότητας που μπορεί να βοηθήσει στην αναγνώριση των πιο πρωτότυπων δημιουργιών των συστημάτων σύνθεσης εικόνας.

Εικόνες εδώ δημιουργούνται μέσω StyleGAN-FFHQ. Από αριστερά προς τα δεξιά, οι στήλες υποδεικνύουν από τις χειρότερες έως τις καλύτερες αποτελέσματα. Μπορούμε να δούμε ότι η μετρική ‘Truncation trick’ και η μετρική Realism έχουν τους δικούς τους στόχους, ενώ ο νέος ‘Βαθμό Σπανιότητας’ (πρώτη σειρά) αναζητά συνεκτικές αλλά πρωτότυπες εικόνες (παρά μόνο συνεκτικές εικόνες). Επειδή υπάρχουν περιορισμοί μεγέθους εικόνας σε αυτό το άρθρο, παρακαλούμε δείτε το αρχικό έγγραφο για καλύτερη λεπτομέρεια και ανάλυση. Πηγή: https://arxiv.org/pdf/2206.08549.pdf
Το νέο έγγραφο έχει τον τίτλο Βαθμό Σπανιότητας: Μια Νέα Μετρική για την Αξιολόγηση της Σπανιότητας των Συνθετικών Εικόνων και προέρχεται από τρεις ερευνητές στο KAIST και τρεις από την NAVER Corp.
Πέρα από το ‘Φθηνό Τρικ’
Μεταξύ των προηγούμενων μετρικών που το νέο έγγραφο προσπαθεί να βελτιώσει είναι η ‘Truncation trick’ που προτάθηκε το 2019 σε μια συνεργασία μεταξύ του Ηνωμένου Βασιλείου Heriot-Watt University και της Google’s DeepMind.
Η Truncation Trick χρησιμοποιεί μια διαφορετική λανθάνουσα κατανομή για δειγματοληψία από αυτή που χρησιμοποιήθηκε για την εκπαίδευση του παραγωγικού μοντέλου.
Οι ερευνητές που ανέπτυξαν αυτή τη μέθοδο ήταν έκπληκτοι που δούλεψε, αλλά παραδέχονται στο αρχικό έγγραφο ότι μειώνει την ποικιλία της παραγόμενης έξοδου. Παρόλα αυτά, η Truncation Trick έχει γίνει αποτελεσματική και δημοφιλής, στο πλαίσιο του τι θα μπορούσε να περιγραφεί ως ένα ‘φθηνό τρικ’ για την απόκτηση αυθεντικών αποτελεσμάτων που δεν πραγματικά ενσωματώνουν όλες τις δυνατότητες που υπάρχουν στα δεδομένα, και μπορεί να μοιάζει περισσότερο με τα δεδομένα πηγής από ό,τι επιθυμείται.
Σχετικά με την Truncation Trick, οι συγγραφείς του νέου εγγράφου παρατηρούν:
‘[Αυτή] δεν προορίζεται για τη δημιουργία σπάνιων δειγμάτων κατά την εκπαίδευση, αλλά για τη σύνθεση τυπικών εικόνων με μεγαλύτερη σταθερότητα. Υποθέτουμε ότι τα υπάρχοντα παραγωγικά μοντέλα θα μπορέσουν να παράγουν δείγματα πλουσιότερα στην πραγματική κατανομή δεδομένων εάν ο γεννήτορας μπορεί να προκαλέσει αποτελεσματικά σπάνια δείγματα.’
Για τη γενική τάση να βασίζονται σε παραδοσιακές μετρικές όπως η Frechet Inception Distance (FID, η οποία υποβλήθηκε σε έντονη κριτική τον Δεκέμβριο του 2021), η Inception Score (IS) και η Απόσταση Inception Kernel (KID) ως ‘δείκτες προόδου’ κατά την εκπαίδευση ενός παραγωγικού μοντέλου, οι συγγραφείς σχολιάζουν περαιτέρω*:
‘Αυτή η σχήμα μάθησης οδηγεί τον γεννήτορα να μην συνθέσει πολλά σπάνια δείγματα που είναι μοναδικά και έχουν ισχυρά χαρακτηριστικά που δεν αντιπροσωπεύουν μεγάλο ποσοστό της πραγματικής κατανομής εικόνας. Παραδείγματα σπάνιων δειγμάτων από δημόσιες βάσεις δεδομένων περιλαμβάνουν ανθρώπους με διάφορα αξεσουάρ στο FFHQ, λευκά ζώα στο AFHQ, και ασυνήθιστα αγάλματα στο Metfaces.
‘Η ικανότητα να παράγει σπάνια δείγματα είναι σημαντική όχι μόνο επειδή σχετίζεται με την ικανότητα των παραγωγικών μοντέλων, αλλά και επειδή η μοναδικότητα παίζει σημαντικό ρόλο στις δημιουργικές εφαρμογές όπως οι εικονικοί άνθρωποι.
‘Ωστόσο, τα ποιοτικά αποτελέσματα αρκετών πρόσφατων μελετών σπάνια περιλαμβάνουν αυτά τα σπάνια παραδείγματα. Υποθέτουμε ότι η φύση της ανταγωνιστικής μάθησης οδηγεί την κατανομή των παραγόμενων εικόνων να μοιάζει με αυτή της βάσης δεδομένων εκπαίδευσης. Έτσι, εικόνες με σαφή ατομικότητα ή σπανιότητα λαμβάνουν μόνο ένα μικρό μέρος των εικόνων που συνθέτουν τα μοντέλα.’
Τεχνική
Οι ερευνητές έχουν προσαρμόσει μια ιδέα που παρουσιάστηκε σε προγενέστερα έργα – τη χρήση K-Nearest Neighbors (KNNs) για να αντιπροσωπεύσουν τις πίνακες των γνήσιων (εκπαίδευσης) και συνθετικών (έξοδος) δεδομένων σε ένα σύστημα σύνθεσης εικόνας.
Σχετικά με αυτή τη νέα μέθοδο ανάλυσης, οι συγγραφείς δηλώνουν:
‘Υποθέτουμε ότι τα κανονικά δείγματα θα είναι πιο κοντά το ένα στο άλλο, ενώ τα μοναδικά και σπάνια δείγματα θα είναι σπάνια τοποθετημένα στον χώρο χαρακτηριστικών.’
Η εικόνα των αποτελεσμάτων πάνω δείχνει τις μικρότερες αποστάσεις των πλησιέστερων γειτόνων (NNDs) έως τις μεγαλύτερες, σε μια αρχιτεκτονική StyleGAN που εκπαιδεύτηκε στο FFHQ.
‘Για όλα τα σύνολα δεδομένων, τα δείγματα με τις μικρότερες NNDs δείχνουν αντιπροσωπευτικές και τυπικές εικόνες. Αντίθετα, τα δείγματα με τις μεγαλύτερες NNDs έχουν ισχυρή ατομικότητα και είναι σημαντικά διαφορετικά από τις τυπικές εικόνες με τις μικρότερες NNDs.’
Θεωρητικά, χρησιμοποιώντας αυτή τη νέα μετρική ως διακριτή, ή τουλάχιστον συμπεριλαμβάνοντάς την σε μια πιο σύνθετη αρχιτεκτονική διακριτή, ένα παραγωγικό σύστημα θα μπορούσε να οδηγηθεί μακριά από την απλή μίμηση προς μια πιο εφευρετικό αλγόριθμο, ενώ διατηρεί την απαραίτητη συνεκτικότητα των εννοιών που μπορεί να είναι κρίσιμες για την αυθεντική παραγωγή εικόνας (π.χ. ‘άνθρωπος’, ‘γυναίκα’, ‘αυτοκίνητο’, ‘εκκλησία’, κ.λπ.).
Συγκρίσεις και Πειράματα
Σε πειράματα, οι ερευνητές διεξήγαγαν μια σύγκριση της απόδοσης του Βαθμού Σπανιότητας με την Truncation Trick και το Σκορ Ρεαλισμού της NVIDIA του 2019, και βρήκαν ότι σε μια ποικιλία από πλαισιά και σύνολα δεδομένων, η προσέγγιση είναι σε θέση να αναγνωρίσει ‘μοναδικά’ αποτελέσματα.
Αν και τα αποτελέσματα που παρουσιάζονται στο έγγραφο είναι πολύ εκτενή για να συμπεριληφθούν εδώ, οι ερευνητές φαίνεται να έχουν αποδείξει την ικανότητα της νέας μεθόδου να αναγνωρίσει σπανιότητα και στις πηγαίες (πραγματικές) και στις παραγόμενες (ψευδείς) εικόνες σε μια παραγωγική διαδικασία:
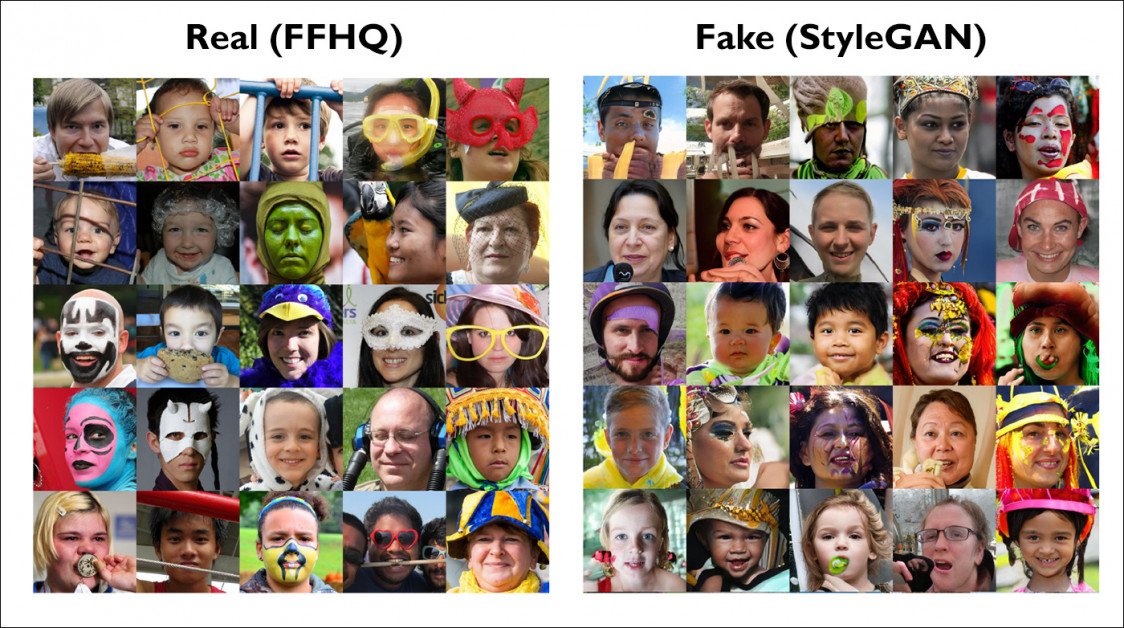
Επιλεγμένα παραδείγματα από τα εκτενή οπτικά αποτελέσματα που αναπαράγονται στο έγγραφο (δείτε την πηγή URL παραπάνω για περισσότερες λεπτομέρειες). Στο αριστερό μέρος, γνήσιες εικόνες από το FFHQ που έχουν πολύ λίγους κοντινούς γείτονες (δηλ. είναι καινούριες και ασυνήθιστες) στην αρχική βάση δεδομένων. Στο δεξί μέρος, ψευδείς εικόνες που παράγονται από το StyleGAN, τις οποίες η νέα μετρική έχει αναγνωρίσει ως πραγματικά καινούριες. Επειδή το άρθρο περιορίζει το μέγεθος των εικόνων, δείτε την αρχική μελέτη για περισσότερες λεπτομέρειες και υψηλότερη ανάλυση.
Ο νέος Βαθμό Σπανιότητας δεν επιτρέπει μόνο την αναγνώριση ‘καινούριων’ παραγωγικών εξόδων σε μία μόνο αρχιτεκτονική, αλλά και, όπως ισχυρίζονται οι ερευνητές, επιτρέπει τις συγκρίσεις μεταξύ παραγωγικών μοντέλων διαφορετικών αρχιτεκτονικών (π.χ. autoencoder, VAE, GAN, κ.λπ.).
Η μελέτη σημειώνει ότι ο Βαθμός Σπανιότητας διαφέρει από παλαιότερες μετρικές επειδή εστιάζει στην ικανότητα ενός παραγωγικού πλαισίου να δημιουργεί μοναδικές και σπάνιες εικόνες. Αντίθετα, οι παραδοσιακές μετρικές εξετάζουν πιο στενά την ποικιλία μεταξύ των παραγόμενων αποτελεσμάτων κατά την εκπαίδευση του μοντέλου.
Πέρα από τις περιορισμένες εργασίες
Αν και οι ερευνητές του νέου εγγράφου έχουν διεξαγάγει πειράματα σε περιορισμένους τομείς (όπως συνδυασμοί γεννήτορα/βάσης δεδομένων που έχουν σχεδιαστεί για να παράγουν εικόνες ανθρώπων ή γατών, για παράδειγμα), ο Βαθμό Σπανιότητας μπορεί δυνητικά να εφαρμοστεί σε οποιαδήποτε τυχαία διαδικασία σύνθεσης εικόνας όπου είναι επιθυμητό να αναγνωριστούν παραγόμενες εικόνες που χρησιμοποιούν τις κατανομές που προέρχονται από τα εκπαιδευμένα δεδομένα, αντί να αυξάνουν την αυθεντικότητα (και να μειώνουν την ποικιλία) με την επέμβαση ξένων κατανομών ή την εξάρτηση από άλλα ‘συντόμευση’ που συμβιβάζουν την καινοτομία με την αυθεντικότητα.
Επίδραση, τέτοια μετρική θα μπορούσε να διακρίνει πραγματικά καινούριες εξόδους σε συστήματα όπως η σειρά DALL-E, χρησιμοποιώντας την αναγνωρισμένη απόσταση μεταξύ μιας φαινομενικής ‘εξαιρετικής’ εικόνας, των δεδομένων εκπαίδευσης και των αποτελεσμάτων από παρόμοιες εισόδους (π.χ. εικόνες-εισόδους).
Στην πράξη, και στην απουσία μιας σαφούς κατανόησης του βαθμού στον οποίο το σύστημα έχει πραγματικά ενσωματώσει οπτικές και σεμαντικές έννοιες (συχνά εμποδισμένες από περιορισμένες γνώσεις σχετικά με τα δεδομένα εκπαίδευσης), αυτό θα μπορούσε να είναι ένας βιώσιμος τρόπος για να αναγνωρίσει μια πραγματική ‘στιγμή έμπνευσης’ σε ένα παραγωγικό σύστημα – το σημείο στο οποίο ένας επαρκής αριθμός εισόδων εννοιών και δεδομένων έχει οδηγήσει σε κάτι πραγματικά εφευρετικό, αντί για κάτι υπερβολικά παράγωγο άλλων έργων ή κοντά στα δεδομένα πηγής.
* Οι μετατροπές μου των εσωτερικών αναφορών των συγγραφέων σε υπερσύνδεσμους.
Πρώτη δημοσίευση 20ης Ιουνίου 2022.