
Η γωνία του Anderson
Ένα Σημαντικό Βήμα στην Ανθρώπινη-Ενεργημένη AI Βίντεο

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Σημείωση: Η σελίδα του έργου για αυτή τη δουλειά περιλαμβάνει 33 αυτόματα αναπαράγονται βίντεο υψηλής ανάλυσης που συνολικά φτάνουν τα μισά γιγαμπάιτ, τα οποία αποσταθεροποίησαν το σύστημά μου κατά τη φόρτωση. Για αυτόν το λόγο, δεν θα συνδέσω απευθείας σε αυτή. Οι αναγνώστες μπορούν να βρουν τη διεύθυνση URL στην περίληψη του εγγράφου ή στο PDF αν το επιθυμούν.
Ένα από τα κύρια αντικείμενα στην τρέχουσα έρευνα σύνθεσης βίντεο είναι η δημιουργία μιας πλήρους απόδοσης βίντεο που οδηγείται από την AI από μία μόνο εικόνα. Αυτή την εβδομάδα, μια νέα εργασία από το Bytedance Intelligent Creation περιέγραψε τι μπορεί να είναι το πιο ολοκληρωμένο σύστημα αυτού του είδους μέχρι τώρα, ικανό να παράγει κινούμενες απεικονίσεις ολόκληρου και άνω μέρους του σώματος που συνδυάζουν εκφραστική λεπτομέρεια προσώπου με ακριβή μεγάλη κίνηση, ενώ επίσης επιτυγχάνει βελτιωμένη διατήρηση της ταυτότητας – έναν τομέα όπου ακόμη και τα κορυφαία εμπορικά συστήματα συχνά αποτυγχάνουν.
Στο παρακάτω παράδειγμα, βλέπουμε μια απόδοση που οδηγείται από έναν ηθοποιό (πάνω αριστερά) και που προέρχεται από μία μόνο εικόνα (πάνω δεξιά), που παρέχει μια αξιοπρεπή και ευέλικτη απόδοση, χωρίς κανένα από τα συνήθη προβλήματα που σχετίζονται με τη δημιουργία μεγάλων κινήσεων ή “υποθέσεων” για κρυφές περιοχές (δηλαδή, μέρη ενδυμάτων και γωνιών προσώπου που πρέπει να υποθέτονται ή να εφευρεθούν επειδή δεν είναι ορατά στη μοναδική φωτογραφία αναφοράς):
Περιεχόμενο ήχου. Κάντε κλικ για αναπαραγωγή. Μια απόδοση γεννιέται από δύο πηγές, συμπεριλαμβανομένης της lip-sync, η οποία είναι συνήθως έργο εξειδικευμένων βοηθητικών συστημάτων. Αυτό είναι μια μειωμένη έκδοση από την πηγή ιστοσελίδας (δείτε τη σημείωση στην αρχή του άρθρου – ισχύει για όλα τα άλλα ενσωματωμένα βίντεο εδώ).
Αν και μπορούμε να δούμε κάποια υπολείμματα προκλήσεων σχετικά με τη διατήρηση της ταυτότητας σε κάθε κλιπ, αυτό είναι το πρώτο σύστημα που έχω δει που εξέχει γενικά (αν και όχι πάντα) στη διατήρηση της ταυτότητας για μεγάλο χρονικό διάστημα χωρίς τη χρήση LoRAs:
Περιεχόμενο ήχου. Κάντε κλικ για αναπαραγωγή. Περαιτέρω παραδείγματα από το έργο DreamActor.
Το νέο σύστημα, με τίτλο DreamActor, χρησιμοποιεί ένα τριμερές υβριδικό σύστημα ελέγχου που δίνει αφιερωμένη προσοχή στην έκφραση προσώπου, περιστροφή κεφαλής και βασικό σχεδιασμό σκελετού, επιτρέποντας απόδοσεις που οδηγούνται από την AI όπου ούτε η έκφραση του προσώπου ούτε η κίνηση του σώματος υποβαθμίζεται προς όφελος της άλλης – μια σπάνια, αν και άγνωστη ικανότητα μεταξύ παρόμοιων συστημάτων.
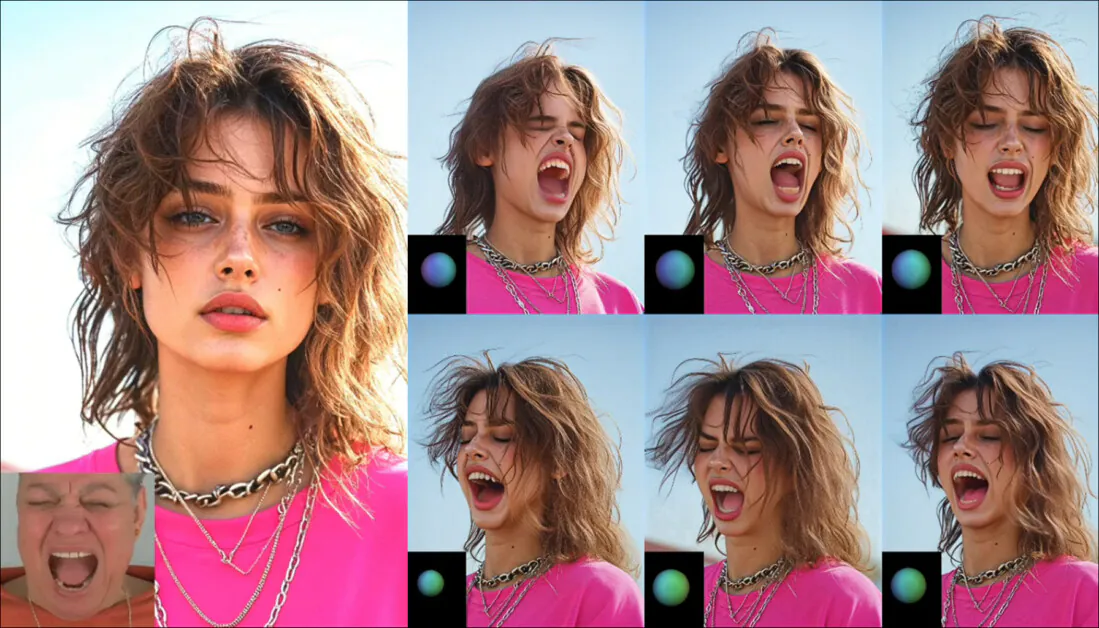
Κάτω από αυτό, βλέπουμε ένα από αυτά τα στοιχεία, περιστροφή κεφαλής, σε δράση. Η χρωματιστή μπάλα στη γωνία κάθε thumbnail προς τα δεξιά υποδηλώνει ένα είδος εικονικού γιμνάστου που ορίζει τον προσανατολισμό της κεφαλής ανεξάρτητα από την κίνηση και έκφραση προσώπου, η οποία εδώ οδηγείται από έναν ηθοποιό (κάτω αριστερά).
Κάντε κλικ για αναπαραγωγή. Η πολύχρωμη μπάλα που οπτικοποιείται εδώ αντιπροσωπεύει τον άξονα περιστροφής της κεφαλής του avatar, ενώ η έκφραση τροφοδοτείται από μια ξεχωριστή μονάδα και ενημερώνεται από την απόδοση ενός ηθοποιού (φαινόμενο εδώ κάτω αριστερά).
Μια από τις πιο ενδιαφέρουσες λειτουργίες του έργου, η οποία δεν περιλαμβάνεται ακόμη και σωστά στις δοκιμές του εγγράφου, είναι η ικανότητά του να εξάγει κίνηση lip-sync απευθείας από ήχο – μια ικανότητα που λειτουργεί ασυνήθιστα καλά ακόμη και χωρίς ένα βίντεο οδηγού με ηθοποιό.
Οι ερευνητές έχουν αναλάβει τους καλύτερους υφιστάμενους σε αυτήν την αναζήτηση, συμπεριλαμβανομένων των πολύ επαινεμένων Runway Act-One και LivePortrait, και αναφέρουν ότι το DreamActor ήταν σε θέση να επιτύχει καλύτερα ποσοτικά αποτελέσματα.
Επειδή οι ερευνητές μπορούν να ορίσουν τα δικά τους κριτήρια, τα ποσοτικά αποτελέσματα δεν είναι απαραίτητα ένα εμπειρικό πρότυπο· αλλά οι συνοδευτικές ποιοτικές δοκιμές φαίνεται να υποστηρίζουν τα συμπεράσματα των συγγραφέων.
Δυστυχώς, αυτό το σύστημα δεν προορίζεται για δημόσια κυκλοφορία, και η μόνη αξία που μπορεί να εξαγάγει η κοινότητα από αυτήν την εργασία είναι στην πιθανή αναπαραγωγή των μεθοδολογιών που περιγράφονται στο έγγραφο (όπως έγινε με αξιοσημείωτο αποτέλεσμα για το επίσης κλειστό Google Dreambooth το 2022 ).
Το έγγραφο αναφέρει*:
‘Η κινούμενη εικόνα ανθρώπου έχει πιθανές κοινωνικούς κινδύνους, όπως η κακοποίηση για τη δημιουργία ψευδών βίντεο. Η προτεινόμενη τεχνολογία θα μπορούσε να χρησιμοποιηθεί για τη δημιουργία ψευδών βίντεο ανθρώπων, αλλά τα υπάρχοντα εργαλεία ανίχνευσης [Demamba, Dormant] μπορούν να αναγνωρίσουν αυτές τις ψευδείς.
‘Για να μειώσουμε αυτούς τους κινδύνους, είναι απαραίτητες σαφείς ηθικοί κανόνες και οδηγίες για την υπεύθυνη χρήση. Θα περιορίσουμε αυστηρά την πρόσβαση στα βασικά μοντέλα και κώδικά μας για να αποτρέψουμε τη κακοποίηση.’
Φυσικά, οι ηθικές σκέψεις αυτού του είδους είναι βολικές από εμπορική πλευρά, καθώς παρέχουν έναν λόγο για την API-μόνο πρόσβαση στο μοντέλο, το οποίο μπορεί να μονεταριστεί. Η ByteDance έχει ήδη κάνει αυτό μια φορά το 2025, κάνοντας το πολύ επαινεμένο OmniHuman διαθέσιμο για πληρωμένα πιστωτικά σημεία στην ιστοσελίδα Dreamina. Επομένως, καθώς το DreamActor είναι πιθανώς ένα ακόμη ισχυρότερο προϊόν, αυτό φαίνεται το πιθανότερο αποτέλεσμα. Τι μένει να δούμε είναι το βαθμό στον οποίο οι αρχές του, όσο έχουν εξηγηθεί στο έγγραφο, μπορούν να βοηθήσουν την ανοιχτή κοινότητα.
Το νέο έγγραφο έχει τον τίτλο DreamActor-M1: Ολιστική, Εκφραστική και Ρομποτική Κινούμενη Εικόνα Ανθρώπου με Υβριδική Καθοδήγηση, και προέρχεται από έξι ερευνητές της Bytedance.
Μέθοδος
Το σύστημα DreamActor που προτείνεται στο έγγραφο έχει ως στόχο να δημιουργήσει κινούμενη εικόνα ανθρώπου από μια αναφορική εικόνα και ένα οδηγό βίντεο, χρησιμοποιώντας ένα Diffusion Transformer (DiT) πλαίσιο προσαρμοσμένο για λανθάνοντα χώρο (προφανώς κάποια παραλλαγή του Stable Diffusion, αν και το έγγραφο αναφέρει μόνο την δημοσίευση ορόσημο του 2022).
Αντί να βασίζεται σε εξωτερικά μοντέλα για την ενσωμάτωση αναφοράς, οι συγγραφείς ενώνουν τις εμφανίσεις και τις κινήσεις χαρακτηριστικά απευθείας μέσα στο DiT πλάισιο, επιτρέποντας την αλληλεπίδραση μεταξύ χώρου και χρόνου μέσω προσοχής:

Σχέδιο για το νέο σύστημα: DreamActor κωδικοποιεί στάση, κίνηση προσώπου και εμφάνιση σε ξεχωριστές λανθάνουσες αναπαραστάσεις, τα οποία συνδυάζονται με θορυβώδεις λανθάνουσες αναπαραστάσεις βίντεο που παράγονται από έναν τρισδιάστατο VAE. Αυτά τα σήματα συνδυάζονται μέσα σε έναν Diffusion Transformer χρησιμοποιώντας αυτο- και δια-προσοχή, με κοινά βάρη σε όλους τους κλάδους. Το μοντέλο ελέγχεται από την σύγκριση των αποθορυβωμένων εξόδων με καθαρές λανθάνουσες αναπαραστάσεις βίντεο. Πηγή: https://arxiv.org/pdf/2504.01724
Για να το κάνουν αυτό, το μοντέλο χρησιμοποιεί έναν προεκπαιδευμένο 3D αυτό-κωδικοποιητή για να κωδικοποιήσει τόσο την εισαγωγική εικόνα όσο και το αναφορικό βίντεο. Αυτές οι λανθάνουσες αναπαραστάσεις είναι patchified, συνενωμένα και τροφοδοτούνται στο DiT, το οποίο τα επεξεργάζεται από κοινού.
Αυτή η αρχιτεκτονική απομακρύνεται από την κοινή πρακτική της προσάρτησης ενός δευτερεύοντος δικτύου για έγχυση αναφοράς, η οποία ήταν η προσέγγιση για τα σημαντικά Animate Anyone και Animate Anyone 2 έργα.
Αντίθετα, το DreamActor χτίζει την ένωση μέσα στο κύριο μοντέλο, απλοποιώντας το σχέδιο ενώ ενισχύει τη ροή της πληροφορίας μεταξύ εμφανίσεων και κινήσεων. Το μοντέλο εκπαιδεύεται χρησιμοποιώντας συνδυασμό ροής αντί του τυπικού στόχου διάχυσης (Ο συνδυασμός ροής εκπαιδεύει τα μοντέλα διάχυσης προβλέποντας απευθείας τα πεδία ταχύτητας μεταξύ δεδομένων και θορύβου, παραλείποντας εκτίμηση βαθμολογίας).
Υβριδική Καθοδήγηση Κίνησης
Η μέθοδος Υβριδικής Καθοδήγηση Κίνησης που ενημερώνει τις νευρωνικές αναπαραστάσεις συνδυάζει συμβολικά στοιχεία που προέρχονται από 3D σκελετούς σώματος και σφαίρες κεφαλής· έμμεσες αναπαραστάσεις προσώπου που εξάγονται από έναν προεκπαιδευμένο κωδικοποιητή προσώπου· και αναφορικές εμφανίσεις που δειγματίζονται από την πηγή εικόνα.
Αυτά τα στοιχεία ενσωματώνονται μέσα στο Diffusion Transformer χρησιμοποιώντας διαφορετικές μηχανισμούς προσοχής, επιτρέποντας στο σύστημα να συντονίσει την καθολική κίνηση, την έκφραση προσώπου και την οπτική ταυτότητα καθ’ όλη τη διάρκεια της διαδικασίας δημιουργίας.
Για το πρώτο από αυτά, αντί να βασίζεται σε σημεία προσώπου, το DreamActor χρησιμοποιεί έμμεσες αναπαραστάσεις προσώπου για να οδηγήσει την δημιουργία έκφρασης, γεγονός που επιτρέπει μια πιο λεπτή έλεγχο της δυναμικής προσώπου ενώ αποσυνδέει την ταυτότητα και τη στάση κεφαλής από την έκφραση.
Για να δημιουργήσουν αυτές τις αναπαραστάσεις, η διαδικασία πρώτα ανιχνεύει και περικόπτει την περιοχή προσώπου σε κάθε καρέ του οδηγούντα βίντεο, αναδιατάσσοντας το σε 224×224. Τα περικομμένα πρόσωπα επεξεργάζονται από έναν κωδικοποιητή κίνησης προσώπου που προ-εκπαιδεύτηκε στο PD-FGC dataset, ο οποίος στη συνέχεια περνά από ένα επίπεδο MLP.

PD-FGC, που χρησιμοποιείται στο DreamActor, δημιουργεί ένα ομιλούν πρόσωπο από μια εικόνα αναφοράς με αποσυνδεδεμένο έλεγχο της lip-sync (από ήχο), στάση κεφαλής, κίνηση ματιών και έκφραση (από ξεχωρισά βίντεο), επιτρέποντας ακριβή, ανεξάρτητη διαχείριση κάθε στοιχείου. Πηγή: https://arxiv.org/pdf/2211.14506
Το αποτέλεσμα είναι μια ακολουθία διακριτικών κίνησης προσώπου, οι οποίες εγχύονται στο Diffusion Transformer μέσω ενός επιπέδου διασταυρούμενης προσοχής.
Το ίδιο πλαίσιο υποστηρίζει επίσης μια παραλλαγή καθοδηγούμενη από ήχο, στην οποία ένας ξεχωριστός κωδικοποιητής εκπαιδεύεται για να αντιστοιχίσει απευθείας την είσοδο ομιλίας σε αναφορικές κινήσεις προσώπου. Αυτό επιτρέπει τη δημιουργία συγχρονισμένης κίνησης προσώπου – συμπεριλαμβανομένης της lip-sync – χωρίς ένα βίντεο οδηγού με ηθοποιό.
Περιεχόμενο ήχου. Κάντε κλικ για αναπαραγωγή. Lip-sync που προέρχεται απευθείας από ήχο, χωρίς ένα βίντεο οδηγού με ηθοποιό. Η μόνη χαρακτήρας είσοδος είναι η στατική φωτογραφία που φαίνεται πάνω δεξιά.
Δεύτερον, για να ελέγξει τη στάση κεφαλής ανεξάρτητα από την έκφραση προσώπου, το σύστημα εισάγει μια τρισδιάστατη σφαίρα κεφαλής (δείτε το βίντεο που ενσωματώνεται νωρίτερα σε αυτό το άρθρο), η οποία αποσυνδέει την δυναμική προσώπου από την καθολική κίνηση κεφαλής, βελτιώνοντας την ακρίβεια και την ευελιξία κατά τη διάρκεια της κινούμενης απεικόνισης.
Οι σφαίρες κεφαλής δημιουργούνται με την εξαγωγή 3D παραμέτρων προσώπου – όπως περιστροφή και στάση της κάμερας – από το οδηγούντα βίντεο χρησιμοποιώντας την FaceVerse μέθοδο παρακολούθησης.

Σχέδιο για το έργο FaceVerse. Πηγή: https://www.liuyebin.com/faceverse/faceverse.html
Αυτά τα παράμετρα χρησιμοποιούνται για να αποδώσουν μια έγχρωμη σφαίρα που προβλέπεται στην 2D εικόνα, χωρικά ευθυγραμμισμένη με το οδηγούντα κεφάλι. Το μέγεθος της σφαίρας αντιστοιχεί στο αναφορικό κεφάλι, και το χρώμα της αντανακλά τον προσανατολισμό της κεφαλής. Αυτή η αφαίρεση μειώνει την πολυπλοκότητα της μάθησης 3D κίνησης κεφαλής, βοηθώντας να διατηρηθούν στιλισμένες ή υπερβολικές σχήματα κεφαλής σε χαρακτήρες που προέρχονται από κινούμενα σχέδια.

Οπτικοποίηση της σφαίρας ελέγχου που επηρεάζει τον προσανατολισμό της κεφαλής.
Τέλος, για να οδηγήσει την πλήρη κίνηση σώματος, το σύστημα χρησιμοποιεί 3D σκελετούς σώματος με προσαρμοστική ομαλοποίηση μήκους οστών. Οι παράμετροι σώματος και χεριών εκτιμώνται χρησιμοποιώντας 4DHumans και το χέρι-εντοπισμένο HaMeR, και τα δύο λειτουργούν στο SMPL-X μοντέλο σώματος.

SMPL-X εφαρμόζει ένα παραμετρικό πλέγμα στο πλήρες ανθρώπινο σώμα σε μια εικόνα, ευθυγραμμισμένο με την εκτιμώμενη στάση και έκφραση για να ενεργοποιήσει την διαχείριση με επίγνωση της στάσης χρησιμοποιώντας το πλέγμα ως ογκομετρικό οδηγό. Πηγή: https://arxiv.org/pdf/1904.05866
Από αυτά τα εξόδους, επιλέγονται κλειδιά αρθρώματα, προβάλλονται σε δύο διαστάσεις και συνδέονται σε γραμμικούς χάρτες σκελετού. Αντιθέτως με μεθόδους όπως Champ, που αποδίδουν πλήρη πλέγματα σώματος, αυτή η προσέγγιση αποφεύγει την επιβολή προκαθορισμένων προτύπων σχήματος, και με την εξάρτηση αποκλειστικά από τη σκελετική δομή, το μοντέλο ενθαρρύνεται να υποθέσει το σχήμα και την εμφάνιση σώματος απευθείας από τις αναφορικές εικόνες, μειώνοντας την προκατάληψη προς σταθερούς σωματότυπους, και βελτιώνοντας την γενίκευση σε μια σειρά από στάσεις και χτίσματα.
Κατά τη διάρκεια της εκπαίδευσης, οι 3D σκελετοί σώματος συνδυάζονται με σφαίρες κεφαλής και περνούν από έναν κωδικοποιητή στάσης, ο οποίος εξοδεύει χαρακτηριστικά που στη συνέχεια συνδυάζονται με θορυβώδεις λανθάνουσες αναπαραστάσεις βίντεο για να παράγουν τα θορυβώδη σύμβολα που χρησιμοποιούνται από το Diffusion Transformer.
Κατά τη διαδικασία συμπερασμού, το σύστημα λαμβάνει υπόψη τις σκελετικές διαφορές μεταξύ ανθρώπων με την ομαλοποίηση μήκους οστών. Το SeedEdit προ-εκπαιδευμένο μοντέλο επεξεργασίας εικόνας μετατρέπει και τις αναφορικές και τις οδηγούντες εικόνες σε μια τυπική κανονική διαμόρφωση. RTMPose χρησιμοποιείται στη συνέχεια για να εξαγάγει τις αναλογίες σκελετού, οι οποίες χρησιμοποιούνται για να προσαρμόσει το οδηγούν σκελετό για να ταιριάζει με την ανατομία του αναφορικού ανθρώπου.

Επισκόπηση της διαδικασίας συμπερασμού. Μπορούν να δημιουργηθούν ψευδοαναφορές για τον εμπλουτισμό των στοιχείων εμφάνισης, ενώ από το οδηγό βίντεο εξάγονται υβριδικά σήματα ελέγχου – έμμεση κίνηση προσώπου και ρητή στάση από σφαίρες κεφαλής και σκελετούς σώματος. Στη συνέχεια τροφοδοτούνται σε ένα μοντέλο DiT για την παραγωγή κινούμενου αποτελέσματος, με την κίνηση του προσώπου αποσυνδεδεμένη από τη στάση του σώματος, ώστε να μπορεί να χρησιμοποιηθεί και ο ήχος ως οδηγός.
Καθοδήγηση Εμφάνισης
Για να ενισχύσει την πιστότητα της εμφάνισης, ιδιαίτερα σε κρυφές ή σπάνια ορατές περιοχές, το σύστημα συμπληρώνει την πρωταρχική αναφορική εικόνα με ψευδο-αναφορές που δειγματίζονται από το εισαγωγικό βίντεο.
Κάντε κλικ για αναπαραγωγή. Το σύστημα προβλέπει την ανάγκη για ακριβή και συνεχή απόδοση κρυφών περιοχών. Αυτό είναι περίπου τόσο κοντά όσο έχω δει, σε ένα έργο αυτού του είδους, σε μια προσέγγιση αντιστοίχισης bitmap τύπου CGI.
Αυτά τα επιπλέον καρέ επιλέγονται για ποικιλία στάσης χρησιμοποιώντας RTMPose, και φιλτράρονται χρησιμοποιώντας CLIP-βασισμένη ομοιότητα για να διατηρηθούν συνεπή με την ταυτότητα του ανθρώπου.
Όλες οι αναφορικές εικόνες (πρωταρχικές και ψευδο-) κωδικοποιούνται από τον ίδιο οπτικό κωδικοποιητή και συνδυάζονται μέσω ενός μηχανισμού αυτοπροσοχής, επιτρέποντας στο μοντέλο να αποκτήσει συμπληρωματικές εμφανίσεις. Αυτή η ρύθμιση βελτιώνει την κάλυψη λεπτομερειών όπως προφίλ ή υφές μελών.
Εκπαίδευση
Το DreamActor εκπαιδεύτηκε σε τρεις στάδια για να εισαγάγει σταδιακά την πολυπλοκότητα και να βελτιώσει τη σταθερότητα.
Στο πρώτο στάδιο, χρησιμοποιήθηκαν μόνο 3D σκελετοί σώματος και 3D σφαίρες κεφαλής ως σήματα ελέγχου, εξαιρώντας τις έμμεσες αναπαραστάσεις προσώπου. Αυτό επέτρεψε στο βασικό μοντέλο βίντεο, αρχικοποιημένο από MMDiT, να προσαρμοστεί στην κινούμενη εικόνα ανθρώπου χωρίς να παραβληθεί από λεπτομερείς ελέγχους.
Στο δεύτερο στάδιο, προστέθηκαν έμμεσες αναπαραστάσεις προσώπου, αλλά όλες οι άλλες παράμετροι παγώθηκαν. Μόνο ο κωδικοποιητής κίνησης προσώπου και οι στρώσεις προσοχής προσώπου εκπαιδεύτηκαν σε αυτό το σημείο, επιτρέποντας στο μοντέλο να μάθει εκφραστικές λεπτομέρειες σε απομόνωση.
Στο τελικό στάδιο, όλα τα παράμετροι απελευθερώθηκαν για ομαδική βελτιστοποίηση σε εμφάνιση, στάση και δυναμική προσώπου.
Δεδομένα και Δοκιμές
Για τη φάση δοκιμών, το μοντέλο αρχικοποιείται από έναν προεκπαιδευμένο σημείο εκκίνησης DiT και εκπαιδεύεται σε τρεις στάδια: 20.000 βήματα για καθένα από τα δύο πρώτα στάδια και 30.000 βήματα για το τρίτο.
Για να βελτιώσει τη γενίκευση σε διαφορετικές διάρκειες και αναλύσεις, τα βίντεο κλιπ δειγματίζονται τυχαία με μήκη μεταξύ 25 και 121 καρέ. Αυτά στη συνέχεια αναδιατάσσονται σε 960x640px, διατηρώντας την αναλογία πλευρών.
Η εκπαίδευση πραγματοποιήθηκε σε οκτώ (συμβατό με τους κινεζικούς περιορισμούς) NVIDIA H20 GPU, καθεμία με 96GB VRAM, χρησιμοποιώντας τον AdamW βελτιστοποιητή με έναν (αρκετά υψηλό) ρυθμό μάθησης 5e−6.
Κατά τη διαδικασία συμπερασμού, κάθε τμήμα βίντεο περιείχε 73 καρέ. Για να διατηρηθεί η συνεχή σε όλα τα τμήματα, η τελική λανθάνουσα αναπαράσταση του ενός τμήματος επαναχρησιμοποιήθηκε ως την αρχική λανθάνουσα αναπαράσταση για το επόμενο, το οποίο περιβάλλει την εργασία ως μια διαδοχική εικόνα-σε-βίντεο δημιουργία.
Η καθοδήγηση χωρίς ταξινομητή εφαρμόστηκε με βάρος 2,5 και για τις αναφορικές εικόνες και τα σήματα κίνησης.
Οι συγγραφείς κατασκεύασαν ένα σύνολο δεδομένων εκπαίδευσης (χωρίς πηγές που αναφέρονται στο έγγραφο) που αποτελείται από 500 ώρες βίντεο από διαφορετικούς τομείς, που παρουσιάζουν περιπτώσεις (μεταξύ άλλων) χορού, αθλητισμού, ταινιών και δημόσιων ομιλιών. Ο συνδυασμός δεδομένων σχεδιάστηκε για να καλυφθεί ένα ευρύ φάσμα ανθρώπινης κίνησης και έκφρασης, με μια ισορροπημένη κατανομή μεταξύ πλήρους και ημι-σώματος.
Για να βελτιώσει την ποιότητα σύνθεσης προσώπου, Nersemble ενσωματώθηκε στη διαδικασία προετοιμασίας δεδομένων.

Παραδείγματα από το συνδυασμό Nersemble, που χρησιμοποιήθηκαν για να εμπλουτίσουν τα δεδομένα για το DreamActor. Πηγή: https://www.youtube.com/watch?v=a-OAWqBzldU
Για την αξιολόγηση, οι ερευνητές χρησιμοποίησαν το συνδυασμό δεδομένων τους ως σημείο αναφοράς για να αξιολογήσουν τη γενίκευση σε διάφορες καταστάσεις.
Η απόδοση του μοντέλου μετρήθηκε χρησιμοποιώντας τυπικά μετρικά από προηγούμενη εργασία: Fréchet Inception Distance (FID); Δείκτης Ομοιότητας Δομής (SSIM); Μαθημένη Πειραματική Ομοιότητα Εικόνας (LPIPS); και Ανώτατο Αναλογικό Σήμα-Θόρυβος (PSNR) για την ποιότητα καρέ. Fréchet Βίντεο Απόσταση (FVD) χρησιμοποιήθηκε για την αξιολόγηση της χρονικής συνάφειας και της συνολικής πιστότητας βίντεο.
Οι συγγραφείς διεξήγαγαν πειράματα σε εργασίες animation σώματος και κινούμενη απεικόνιση πορτρέτου, όλες χρησιμοποιώντας μία μόνο εικόνα αναφοράς.
Για την κινούμενη απεικόνιση σώματος, το DreamActor-M1 συγκρίθηκε με Animate Anyone; Champ; MimicMotion, και DisPose.

Ποσοτικές συγκρίσεις με ανταγωνιστικά πλαίσια.
Αν και το PDF παρέχει μια στατική εικόνα ως οπτική σύγκριση, ένα από τα βίντεο από την ιστοσελίδα του έργου μπορεί να υπογραμμίσει τις διαφορές πιο καθαρά:
Περιεχόμενο ήχου. Κάντε κλικ για αναπαραγωγή. Μια οπτική σύγκριση μεταξύ των αντίπαλων πλαισίων. Το οδηγούν βίντεο φαίνεται πάνω αριστερά, και το συμπέρασμα των συγγραφέων ότι το DreamActor παράγει τα καλύτερα αποτελέσματα φαίνεται εύλογο.
Για τις δοκιμές κινούμενη απεικόνιση πορτρέτου, το μοντέλο αξιολογήθηκε με LivePortrait; X-Portrait; SkyReels-A1; και Act-One.

Ποσοτικές συγκρίσεις για κινούμενη απεικόνιση πορτρέτου.
Οι συγγραφείς σημειώνουν ότι η μέθοδός τους κερδίζει στις ποσοτικές δοκιμές, και ισχυρίζονται ότι είναι επίσης ανώτερη ποιοτικά.
Περιεχόμενο ήχου. Κάντε κλικ για αναπαραγωγή. Παραδείγματα συγκρίσεων κινούμενη απεικόνιση πορτρέτου.
Αξιολογώντας το τρίτο και τελευταίο από τα κλιπ που εμφανίζονται στο βίντεο παραπάνω, φαίνεται λιγότερο πειστική lip-sync σε σύγκριση με κάποια από τα αντίπαλα πλαισία, αν και η γενική ποιότητα είναι εξαιρετικά υψηλή.
Συμπέρασμα
Προβλέποντας την ανάγκη για υφές που υπονοούνται αλλά δεν είναι πραγματικά παρόντες στη μοναδική εικόνα που τροφοδοτεί αυτές τις αναπαραστάσεις, η Bytedance έχει αντιμετωπίσει μία από τις μεγαλύτερες προκλήσεις που αντιμετωπίζουν οι διάχυτες-βίντεο γεννήτριες – συνεχείς, πιστές υφές. Το επόμενο λογικό βήμα μετά την τελειοποίηση μιας τέτοιας προσέγγισης θα ήταν να δημιουργηθεί ένας αναφορικός άτλας από το αρχικό γεννημένο κλιπ που θα μπορούσε να εφαρμοστεί σε μεταγενέστερες, διαφορετικές γεννήσεις, για να διατηρήσει την εμφάνιση χωρίς LoRAs.
Αν και μια τέτοια προσέγγιση θα ήταν ακόμη ένα εξωτερικό αναφορά, αυτό δεν διαφέρει από το texture-mapping στις παραδοσιακές CGI τεχνικές, και η ποιότητα του ρεαλισμού και της πιστότητας είναι πολύ υψηλότερη από αυτές τις παλαιότερες μεθόδους.
Όμως, το πιο εντυπωσιακό χαρακτηριστικό του DreamActor είναι το συνδυασμένο τριμελές σύστημα καθοδήγησης, το οποίο γέμιζε την παραδοσιακή διαίρεση μεταξύ face-εστιασμένης και σώματος-εστιασμένης ανθρώπινης σύνθεσης με έξυπνο τρόπο.
Μόνο μένει να δούμε αν κάποιες από αυτές τις βασικές αρχές μπορούν να χρησιμοποιηθούν σε πιο προσιτές προσφορές· καθώς το DreamActor φαίνεται να είναι προορισμένο να γίνει ακόμη μια σύνθεση-ως-υπηρεσία προσφορά, σοβαρά δεσμευμένη από περιορισμούς στη χρήση, και από την ακαταλληλότητα της πειραματικής διεξαγωγής με μια εμπορική αρχιτεκτονική.
* Η αντικατάσταση μου των υπερσυνδέσμων για τους συγγραφείς; εσωτερικές αναφορές
† Όπως αναφέρθηκε νωρίτερα, δεν είναι σαφές ποιο είδος Stable Diffusion χρησιμοποιήθηκε σε αυτό το έργο.
Πρώτη δημοσίευση Παρασκευή, 4 Απριλίου 2025


