
Η γωνία του Anderson
Εκτός οράσεως, εκτός μνήμης: αντιμετωπίζοντας το μεγαλύτερο πρόβλημα των βίντεο AI

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
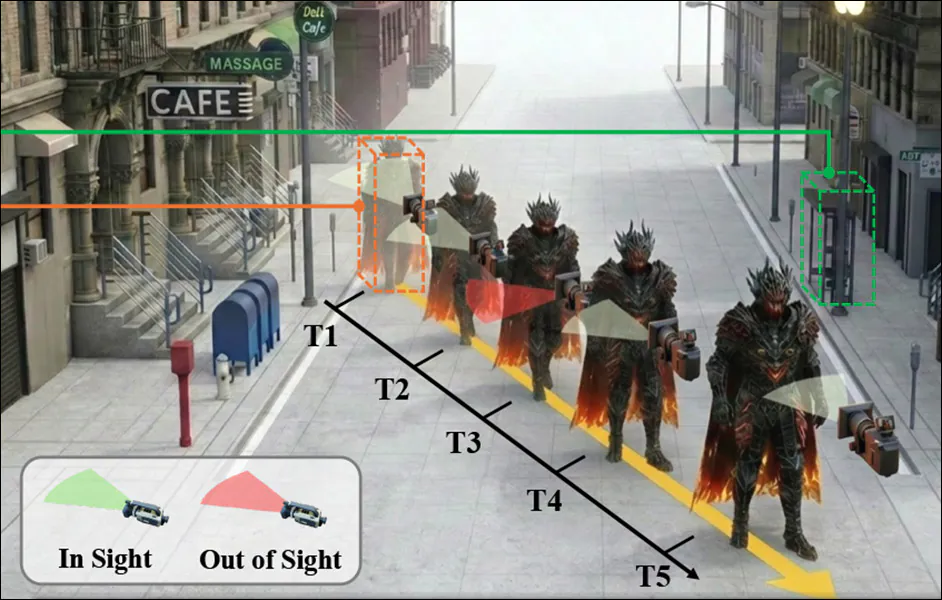
Βασικά σημείαΈνα νέο υβριδικό σύστημα μνήμης λύνει τη χρόνια αμνησία των βίντεο τεχνητής νοημοσύνης…
Δείτε περισσότερα
- Ένα νέο υβριδικό σύστημα μνήμης λύνει τη χρόνια αμνησία των βίντεο τεχνητής νοημοσύνης διατηρώντας συνεπείς χαρακτήρες εκτός οθόνης.
- Η μέθοδος χρησιμοποιεί διακριτοποίηση μνήμης και δυναμική ανάκτηση για τη διατήρηση της εμφάνισης και της κίνησης κατά τις εξόδους.
- Το HyDRA ξεπερνά τις προηγούμενες προσεγγίσεις αποσυνδέοντας δυναμικά υποκείμενα από στατικά φόντα στον λανθάνοντα χώρο.
Το μεγαλύτερο πρόβλημα ακόμη και των καλύτερων γεννητριών βίντεο με AI είναι η χρόνια αμνησία τους — μια πρόκληση που τώρα αντιμετωπίζει νέα έρευνα από την Κίνα.
Το μεγαλύτερο πρόβλημα ακόμη και των καλύτερων και πιο προηγμένων συστημάτων δημιουργίας βίντεο με AI είναι ότι όλα πάσχουν από χρόνια αμνησία: αν η κάμερα στραφεί μακριά από αυτό στο οποίο εστιάζει και μετά επιστρέψει, δεν θα βρει ό,τι υπήρχε αρχικά. Οι χαρακτήρες θα έχουν εξαφανιστεί ή θα έχουν αλλάξει εμφάνιση ή τρόπο κίνησης, ενώ πιθανότατα θα έχει αλλάξει και το φόντο.
Αυτό συμβαίνει επειδή το σύστημα δημιουργίας που βασίζεται στη διάχυση διαθέτει ένα περιορισμένο, κυλιόμενο παράθυρο προσοχής και ασχολείται πάντα μόνο με όσα μπορεί να δει εκείνη τη στιγμή. Πρόκειται για πραγματική εφαρμογή του σολιψισμού: ό,τι βρίσκεται έξω από το κάδρο δεν υπάρχει για τη γενετική AI — κυριολεκτικά απορρίπτεται από τη μνήμη.
Αυτό δεν υπήρξε ποτέ πρόβλημα στα παραδοσιακά CGI, τα οποία μπορούν πάντα να ανατρέξουν σε ένα θέμα και να αναδημιουργήσουν με ακρίβεια την εμφάνιση και την κίνησή του, σε οποιοδήποτε σημείο ενός αποδοθέντος βίντεο χρειαστεί ξανά.

Τα παραδοσιακά πλέγματα CGI και οι υφές bitmap μπορούν πάντα να επανεισαχθούν στην απόδοση, εξασφαλίζοντας σταθερή εμφάνιση. Αυτό είναι πολύ δυσκολότερο στις προσεγγίσεις AI, επειδή δεν υπάρχει αντίστοιχο ανεξάρτητο αρχείο αναφοράς ή συλλογή συναφών αρχείων.
Τα επιμέρους στοιχεία των CGI, όπως το πλέγμα και οι υφές (βλ. εικόνα παραπάνω), τα αρχεία κίνησης και οι άλλες δυναμικές συμπεριφορές, μπορούν να αποθηκεύονται χωριστά στον δίσκο και να εισάγονται σε μια σύνθεση ανά πάσα στιγμή.
Στη γενετική AI βίντεο δεν υπάρχει τέτοιο ανεξάρτητο αποθετήριο. Η πλησιέστερη λειτουργία είναι τα LoRA: ειδικά εκπαιδευμένα βοηθητικά αρχεία που μπορούν να εκπαιδευτούν σε καταναλωτικό εξοπλισμό, επιτρέποντας σε νέους χαρακτήρες και συγκεκριμένα ρούχα να εισαχθούν αναγκαστικά στο βίντεο.
Πατήστε για αναπαραγωγή. Το πρόβλημα σολιψισμού των βίντεο AI μπορεί να μετριαστεί ως έναν βαθμό με LoRA, αλλά η επίδρασή τους μπορεί να είναι υπερβολικά έντονη.
Ωστόσο, αυτή δεν είναι ιδανική λύση. Αφενός, τα LoRA συνδέονται με μια απολύτως συγκεκριμένη έκδοση ενός βασικού μοντέλου, όπως το Wan2+ ή το Hunyuan Video, και πρέπει να δημιουργούνται ξανά κάθε φορά που αλλάζει το βασικό μοντέλο. Αφετέρου, τα LoRA τείνουν να αλλοιώνουν τα βάρη του βασικού μοντέλου, με αποτέλεσμα η ταυτότητα που έμαθαν να επιβάλλεται σε όλους τους χαρακτήρες μιας σκηνής. Επιπλέον, τέτοιες μέθοδοι λεπτής προσαρμογής είναι πολύ ευαίσθητες σε ανεπαρκώς επιμελημένα σύνολα δεδομένων.
Ακριβείς επανεμφανίσεις
Μια νέα συνεργασία ακαδημαϊκών και βιομηχανίας από την Κίνα προσφέρει τώρα την πρώτη σημαντική λύση που έχω παρατηρήσει σε περισσότερα από τρία χρόνια κάλυψης αυτού του ζητήματος. Η μέθοδος χρησιμοποιεί αυτό που οι ερευνητές ονομάζουν υβριδική μνήμη, ώστε ο χαρακτήρας εκτός κάδρου και το άμεσο περιβάλλον του να παραμένουν ενεργοί και ακριβείς στον λανθάνοντα χώρο του μοντέλου. Έτσι, όταν η οπτική μας γωνία επιστρέφει σε αυτά, το αποτέλεσμα παραμένει συνεπές.
Πατήστε για αναπαραγωγή. Δύο παραδείγματα από τον ιστότοπο της νέας εργασίας: χαρακτήρες που δημιουργήθηκαν με AI (WAN) βγαίνουν από το κάδρο και επιστρέφουν με ακρίβεια. Πηγή
Πρέπει να τονιστεί ότι αυτό δεν ταυτίζεται με την επίτευξη συνέπειας χαρακτήρων μεταξύ διαφορετικών πλάνων. Η τελευταία υποτίθεται ότι επιτεύχθηκε πριν από έναν χρόνο με την κυκλοφορία του Gen 4 της Runway και παραμένει ενεργός και διαρκής ερευνητικός στόχος στη σχετική βιβλιογραφία.
Εδώ λύνεται κάτι που δεν έχει καταφέρει κανένα εμπορικό ή πειραματικό πλαίσιο από όσα έχω δει: η οπτικά συνεπής επανεμφάνιση της προηγούμενης εμφάνισης, κίνησης και του περιβάλλοντος ενός χαρακτήρα που είχε βρεθεί εκτός κάδρου.
Πατήστε για αναπαραγωγή. Τα άλλα δύο βασικά παραδείγματα στον ιστότοπο της νέας πρωτοβουλίας.
Οι ίδιες αρχές μπορούν προφανώς να εφαρμοστούν και αλλού, όπως στην εξερεύνηση πόλεων, στην οδήγηση από την οπτική του οδηγού ή σε άλλες αποδόσεις χωρίς χαρακτήρες.
Πρέπει επίσης να υπογραμμιστεί ότι η νέα προσέγγιση δεν επιλύει ούτε εξετάζει το ζήτημα που η Runway Gen4 και άλλες πλατφόρμες κλειστού κώδικα ισχυρίζονται ότι αντιμετώπισαν αναδημιουργώντας χαρακτήρες μεταξύ διαφορετικών πλάνων. Αντίθετα, πετυχαίνει αυτό που καμία τους δεν έχει καταφέρει: διατηρεί έναν χαρακτήρα και ένα περιβάλλον στη μνήμη χωρίς να πρέπει να είναι συνεχώς ορατά στον θεατή.
Η νέα εργασία περιλαμβάνει ένα ειδικό σύνολο δεδομένων που δημιουργήθηκε μέσω Unreal Engine, ειδικά μέτρα αξιολόγησης του προβλήματος σολιψισμού* και ένα προσαρμοσμένο γενετικό πλαίσιο βασισμένο στο WAN. Σε δοκιμές με τα λίγα διαθέσιμα ανάλογα συστήματα, οι συγγραφείς ισχυρίζονται ότι πετυχαίνουν κορυφαία αποτελέσματα και σχολιάζουν:
«Οι μηχανισμοί μνήμης έχουν αναδειχθεί σε κρίσιμο πεδίο εξέλιξης των μοντέλων κόσμου, επειδή η χωρητικότητα της μνήμης καθορίζει τη χωρική και χρονική συνέπεια του παραγόμενου περιεχομένου.
«Συγκεκριμένα, η μνήμη είναι η γνωστική άγκυρα που επιτρέπει στο μοντέλο να διατηρεί ιστορικό πλαίσιο αναφοράς κατά τις αλλαγές οπτικής γωνίας ή τη μακροπρόθεσμη προεκβολή.
«Χωρίς στιβαρή μνήμη, ένας προσομοιωμένος κόσμος διαλύεται γρήγορα σε ασύνδετα, χαοτικά καρέ.»
Η νέα εργασία έχει τίτλο Εκτός οράσεως, αλλά όχι εκτός μνήμης: υβριδική μνήμη για δυναμικά μοντέλα κόσμου βίντεο και προέρχεται από επτά ερευνητές του Πανεπιστημίου Επιστήμης και Τεχνολογίας Huazhong και της ομάδας Kling στην Kuaishou Technology.
Μέθοδος
Κεντρικό στοιχείο της εργασίας είναι η υβριδική μνήμη, που επιτρέπει προεκβολή εκτός οπτικού πεδίου: τη διατήρηση χαρακτήρων και του πλαισίου τους όταν ο θεατής κοιτάζει αλλού ή ο ίδιος ο χαρακτήρας βγαίνει από το κάδρο. Το πλαίσιο πρέπει τότε να πραγματοποιεί χωροχρονική αποσύζευξη, εστιάζοντας ταυτόχρονα στην παραγωγή της ορατής εικόνας και στην ύπαρξη του πλέον αόρατου χαρακτήρα έξω από το κάδρο.

Παραδείγματα κίνησης κάμερας που οδηγεί σε είσοδο και έξοδο από το κάδρο. Εδώ η κίνηση της κάμερας προκαλεί την έξοδο του χαρακτήρα, ενώ σε άλλα δείγματα ο ίδιος ο χαρακτήρας μετακινείται προσωρινά εκτός κάδρου. Πηγή
Οι συγγραφείς σημειώνουν ότι στις λανθάνουσες ενσωματώσεις της διάχυσης, τα χαρακτηριστικά που πρέπει να εξαχθούν και να χρησιμοποιηθούν είναι έντονα διαπλεγμένα με άλλα χαρακτηριστικά και ιδιότητες. Η προσπάθεια εξαγωγής τους συχνά κάνει το αντικείμενο να «παγώνει» μέσα στο φόντο. Γι’ αυτό σχεδίασαν και επιμελήθηκαν το σύνολο δεδομένων HM-World**, ειδικά για την εκπαίδευση υβριδικής μνήμης.

Δείγματα των τεσσάρων κατηγοριών του HM-World από την εργασία.
Η συλλογή οργανώνεται σε τέσσερις διαστάσεις: τροχιές αντικειμένων, τροχιές κάμερας, σκηνές και αντικείμενα.
Τα συνθετικά δεδομένα του HM-World περιλαμβάνουν 17 σκηνές και 49 αντικείμενα, μεταξύ τους ανθρώπους διαφορετικής εμφάνισης και ζώα πολλών ειδών. Συνδυασμοί τους τοποθετούνται διαδικαστικά σε μια σκηνή μέσω Unreal Engine, με ξεχωριστή κίνηση για το καθένα, και στη συνέχεια ακολουθούν μια τυχαία επιλεγμένη τροχιά.
Οι συγγραφείς αναφέρουν ότι το σύνολο δεδομένων παρουσιάζει ποικίλα συμβάντα εξόδου και εισόδου, με 28 διαφορετικές τροχιές κάμερας, καθεμία με πολλαπλά σημεία εκκίνησης.
Η τελική συλλογή περιλαμβάνει 59.225 βιντεοκλίπ, καθένα σχολιασμένο από το MiniCPM-V, ένα πολυτροπικό μεγάλο γλωσσικό μοντέλο (MLLM).
Οι ερευνητές επισημαίνουν τα στατιστικά πλεονεκτήματα της συλλογής τους έναντι των προηγούμενων συνόλων δεδομένων WorldScore, Context-As-Memory, Multi-Cam Video και 360° Motion:

Σύγκριση υπάρχοντων συνόλων δεδομένων με το HM-World. Το «Dynamic Subject» δηλώνει την παρουσία κινούμενων οντοτήτων, το «Subject Exit-Enter» κλιπ με αντικείμενα που βγαίνουν από το κάδρο και επιστρέφουν, και το «Subject Pose» την ύπαρξη σχολιασμένων τρισδιάστατων στάσεων.
Ο λιγότερο πατημένος δρόμος
Με δεδομένα αρκετά προηγούμενα καρέ και μια γνωστή διαδρομή κάμερας, ζητούμενο είναι η πρόβλεψη μελλοντικών εικόνων καθώς αλλάζει η οπτική γωνία του θεατή. Παράλληλα πρέπει να λαμβάνονται υπόψη αντικείμενα που κινούνται ανεξάρτητα και ενδέχεται να βγουν από το κάδρο πριν επιστρέψουν. Δεν αρκεί λοιπόν ένα σταθερό φόντο: το μοντέλο πρέπει να διατηρεί συνεπή εσωτερική καταγραφή της εμφάνισης και της συμπεριφοράς κάθε κινούμενου αντικειμένου ακόμη και όταν αυτό δεν είναι ορατό.
Η μέθοδος Hybrid Dynamic Retrieval Attention (HyDRA) των συγγραφέων εισάγει μια ειδική οδό μνήμης που διαχωρίζει τα δυναμικά αντικείμενα από τη στατική αναπαράσταση της σκηνής. Έτσι διατηρούνται στον χρόνο και επανεμφανίζονται με συνεπή εμφάνιση και κίνηση.

Εννοιολογικό διάγραμμα του μοντέλου HyDRA.
Η HyDRA βασίζεται στο Wan2.1-T2V-1.3B, με την κεντρική διαδικασία διάχυσης να παραμένει σε μεγάλο βαθμό ανέπαφη. Εισάγεται όμως ένα τροποποιημένο μπλοκ transformer που ενσωματώνει δυναμική προσοχή ανάκτησης. Το μοντέλο μπορεί έτσι να ανακαλεί επιλεκτικά στοιχεία κίνησης και εμφάνισης από προηγούμενα καρέ, αντί να εξαρτάται από σταθερό ή τοπικό πλαίσιο αναφοράς.
Η διαδικασία χρησιμοποιεί έναν προσαρμοσμένο στόχο εκπαίδευσης Flow Matching αντί της τυπικής απώλειας διάχυσης.
Για την ευθυγράμμιση των σκηνών με την κίνηση της κάμερας, οι τροχιές της εισάγονται ως ρητό σήμα συνθήκης. Η στάση κάθε καρέ ορίζεται με περιστροφή και μετατόπιση και μετατρέπεται σε συμπαγή αναπαράσταση της εξέλιξης της οπτικής γωνίας στον χρόνο.
Όπως στην προηγούμενη πρωτοβουλία της Kling, ReCamMaster, το αποτέλεσμα επεξεργάζεται ένας κωδικοποιητής κάμερας υλοποιημένος ως πολυστρωματικό perceptron. Η έξοδός του κατανέμεται και προστίθεται στα χαρακτηριστικά του Diffusion Transformer, επιτρέποντας στο μοντέλο να διατηρεί συνεπείς θέσεις αντικειμένων καθώς κινείται η κάμερα.
Δημιουργία tokens
Οι ακατέργαστες λανθάνουσες αναπαραστάσεις διάχυσης αναμειγνύουν την κίνηση, την εμφάνιση και το φόντο σε μία διαπλεγμένη αναπαράσταση. Η απευθείας ανάκτηση από αυτόν τον χώρο μπορεί να εισαγάγει άσχετο πλαίσιο αναφοράς ή να κάνει τα κινούμενα αντικείμενα να συγχωνεύονται με το φόντο.
Η HyDRA χρησιμοποιεί έναν Memory Tokenizer βασισμένο σε τρισδιάστατη συνέλιξη, που επεξεργάζεται χώρο και χρόνο μαζί. Αντί να μεταδίδει ολόκληρο το ιστορικό λανθανουσών αναπαραστάσεων, το συμπιέζει σε συμπαγή tokens μνήμης με επίγνωση της κίνησης, τα οποία διατηρούν την εμφάνιση και την κίνηση των αντικειμένων.

Επισκόπηση της HyDRA. Αριστερά, ο Memory Tokenizer μετατρέπει τα προηγούμενα καρέ σε συμπαγή tokens μνήμης με επίγνωση της κίνησης. Δεξιά, η Dynamic Retrieval Attention αξιολογεί το τρέχον ερώτημα ως προς τα tokens, ανακτά τα πιο συναφή και αποκαθιστά συνεπή εμφάνιση και κίνηση στο παραγόμενο καρέ.
Αυτά τα tokens σχηματίζουν δομημένη υβριδική μνήμη που φιλτράρει τον θόρυβο και διατηρεί τη μακροχρόνια δυναμική. Όταν δίνονται στη μονάδα Dynamic Retrieval Attention, το μοντέλο μπορεί να ανακαλεί επιλεκτικά αντικείμενα εκτός κάδρου ώστε να επανεμφανίζονται με συνεπή εμφάνιση, κίνηση και πλαίσιο αναφοράς.
Δυναμική προσοχή ανάκτησης
Ο διπλός μηχανισμός μνήμης της HyDRA χρησιμοποιεί επίσης δυναμική προσοχή ανάκτησης σε έναν διακριτό αλλά συμπληρωματικό ρόλο.
Η δημιουργία tokens μνήμης συμπιέζει τις προηγούμενες λανθάνουσες αναπαραστάσεις σε δομημένα tokens με επίγνωση της κίνησης. Διαχωρίζουν τα δυναμικά αντικείμενα από το στατικό περιεχόμενο της σκηνής, μειώνοντας τη διαπλοκή που συχνά οδηγεί σε συγχώνευση με το φόντο. Σχηματίζουν μια μόνιμη τράπεζα μνήμης και όχι πλήρες ιστορικό καρέ.
Κατά τη δημιουργία εικόνας, η δυναμική προσοχή ανάκτησης συγκρίνει το τρέχον ερώτημα με τα αποθηκευμένα tokens και ανακαλεί επιλεκτικά όσα είναι πιο σχετικά με το εξελισσόμενο καρέ. Τα αντικείμενα εκτός κάδρου μπορούν έτσι να συνεχίζουν τη λανθάνουσα εξέλιξή τους, όπως να περπατούν ή να τρέχουν ενώ δεν τα βλέπουμε, και να επιστρέφουν με συνεπή εμφάνιση και κίνηση αντί να μηδενίζονται ή να υποβαθμίζονται.
Δεδομένα και δοκιμές
Στις δοκιμές, το σύστημα HyDRA που βασίζεται στο Wan κωδικοποίησε και υποδειγματολήπτησε 77 καρέ πλαισίου αναφοράς πριν τα επεξεργαστεί με έναν τρισδιάστατο Variational Autoencoder (VAE). Ο προαναφερθείς tokenizer μνήμης χρησιμοποιούσε τρισδιάστατη συνέλιξη με μέγεθος πυρήνα 2×4×4.
Το μοντέλο εκπαιδεύτηκε στο HW-World για 10.000 επαναλήψεις σε 32 GPU απροσδιόριστου τύπου, με μέγεθος παρτίδας 32.
Στις δοκιμές χρησιμοποιήθηκαν ασυνήθιστα πολλά μέτρα αξιολόγησης: πέρα από τα συνήθη Peak Signal-to-Noise Ratio (PSNR), Structural Similarity Index (SSIM) και Learned Perceptual Similarity Metrics (LPIPS), οι συγγραφείς χρησιμοποίησαν επίσης συνέπεια αντικειμένου και συνέπεια φόντου από τη σουίτα VBench, για την αξιολόγηση της συνοχής σε επίπεδο καρέ.
Επιπλέον, σχεδίασαν ένα δικό τους μέτρο με τίτλο Dynamic Subject Consistency (DSC), που χρησιμοποιεί πλαίσια οριοθέτησης από το YOLO V11 για να δημιουργεί αποκομμένες περιοχές με κινούμενα αντικείμενα. Από αυτές εξάγονται σημασιολογικά χαρακτηριστικά και έπειτα υπολογίζονται οι ομοιότητές τους.
Η HyDRA συγκρίθηκε με το Diffusion Forcing Transformer (DFoT) και το Context-As-Memory, με βάση ένα Wan2.1-T2V-1.3B εξοπλισμένο με κωδικοποιητή κάμερας για την αναπαράσταση της υποκειμενικής οπτικής που είναι κοινή σε όλα τα κλιπ. Όλα τα μοντέλα εκπαιδεύτηκαν στο HW-World και το WorldPlay χρησιμοποιήθηκε επίσης ως δεύτερη συλλογή δοκιμής σε καθεστώς zero-shot, χωρίς ειδική πρόσθετη εκπαίδευση.
Στις αρχικές ποσοτικές συγκρίσεις, η HyDRA ξεπέρασε όλα τα βασικά μοντέλα, αυξάνοντας το PSNR από 18.696 σε 20.357 και το SSIM από 0.517 σε 0.606. Πέτυχε επίσης τις υψηλότερες βαθμολογίες Dice με αναφορά στο πλαίσιο και στην πραγματική τιμή, 0.827 και 0.849 αντίστοιχα, με τη συνέπεια αντικειμένου και φόντου να φτάνει στο 0.926 και 0.932.

Αποτελέσματα της αρχικής ποσοτικής σύγκρισης με προηγούμενες προσεγγίσεις.
Το DFoT πέτυχε PSNR 17.693 και το Context-As-Memory 18.921. Οι βελτιώσεις αποδίδονται στον συνδυασμό δημιουργίας tokens μνήμης και δυναμικής προσοχής ανάκτησης.

Ποσοτική σύγκριση της HyDRA με τις σημερινές κορυφαίες προσεγγίσεις.
Για τις δοκιμές με το WorldPlay, οι συγγραφείς δηλώνουν:
«Η μέθοδός μας ξεπερνά το WorldPlay σε όλα τα μέτρα, με αξιοσημείωτη διαφορά PSNR 5.502. Παρότι το WorldPlay έχει χαμηλότερη απόδοση σε μέτρα με αναφορά στην πραγματική τιμή, όπως PSNR 14.855 και DSCGT 0.832, λόγω διαφορετικής κατανομής πεδίου και έλλειψης ειδικής λεπτής προσαρμογής, εμφανίζει αξιοσημείωτη ανθεκτικότητα σε μέτρα με αναφορά στο πλαίσιο, πετυχαίνοντας DSCctx 0.822.
«Αυτή η παρατήρηση επιβεβαιώνει ότι εκτενώς εκπαιδευμένα μοντέλα διαθέτουν ικανοποιητική υβριδική συνέπεια και υποστηρίζει έμμεσα τη λογική των προτεινόμενων μέτρων DSC ως προς την αποτύπωση της δυναμικής συνέπειας αντικειμένου.
«Τελικά, αυτά τα εντυπωσιακά αποτελέσματα αναδεικνύουν τις εξαιρετικές δυνατότητες του μοντέλου μας και την υπεροχή του ακόμη και έναντι καθιερωμένων εμπορικών μοντέλων.»
Η εργασία δίνει στατικές απεικονίσεις των ποιοτικών συγκρίσεων που έγιναν στις δοκιμές:

Ποιοτική σύγκριση εξόδου και επιστροφής υπό κίνηση κάμερας. Οι συγγραφείς ισχυρίζονται ότι η HyDRA διατηρεί την ταυτότητα, τη στάση και τη συνέχεια κίνησης μετά την έξοδο και επιστροφή του αντικειμένου, προσεγγίζοντας την πραγματική αναφορά. Οι ανταγωνιστικές μέθοδοι εμφανίζουν ολίσθηση, ασυνεπή κίνηση ή υποβάθμιση αντικειμένου, σημειωμένα με κόκκινο. Οι συνεπείς επαναφορές σημειώνονται με πράσινο.
Οι συγγραφείς σχολιάζουν αυτά τα αποτελέσματα ως εξής:
«Σε σύνθετα συμβάντα εξόδου και εισόδου, το βασικό μοντέλο και το Context-as-Memory εμφανίζουν σοβαρή παραμόρφωση αντικειμένου και ασυνεπή κίνηση. Το DFoT αποτυγχάνει να διατηρήσει την ακεραιότητα του αντικειμένου, που εξαφανίζεται τελείως. Το WorldPlay διατηρεί τη συνέπεια εμφάνισης, αλλά εμφανίζει διακοπτόμενες κινήσεις και αφύσικες ενέργειες.
«Αντίθετα, η μέθοδός μας διατηρεί επιτυχώς υβριδική συνέπεια, διαφυλάσσοντας τόσο την ταυτότητα του αντικειμένου όσο και τη συνοχή της κίνησης μετά την επιστροφή του στο κάδρο.»
Περισσότερα αποτελέσματα σε μορφή βίντεο διατίθενται στον συμπληρωματικό ιστότοπο. Συγκεντρώσαμε τα πρώτα τέσσερα παραδείγματα στο παρακάτω βίντεο.
Πατήστε για αναπαραγωγή. Τέσσερα από τα έξι αποτελέσματα δοκιμών που παρουσιάζονται στον ιστότοπο του έργου. Πηγή
Συμπέρασμα
Κάθε προσπάθεια αντιμετώπισης ενός από τα μεγαλύτερα προβλήματα δημιουργίας βίντεο AI είναι ευπρόσδεκτη. Ωστόσο, μου φαίνεται αναπόφευκτο ότι η βέλτιστη λύση για τέτοια ζητήματα εξόδου και επιστροφής θα είναι, όπως στα CGI, ανεξάρτητα υλικά αναφοράς που θα μπορούν να τροποποιούνται χωριστά και να εισάγονται σε έναν χώρο σύνθεσης.
Η προσπάθεια να διατηρείται ενεργή μια ενσωμάτωση με ad hoc τρόπο και κατά τη διάρκεια της δημιουργίας φαίνεται εξαντλητική. Επίσης δεν δείχνει σαφή πορεία προς τη συνέπεια μέσα στο ίδιο πλάνο, την οποία προσφέρουν τώρα διάφορες υπηρεσίες μαύρου κουτιού, όπως η Runway. Αν ένα επόμενο πλάνο χρειάζεται πρόσβαση στον λανθάνοντα χώρο του προηγούμενου, γιατί να μην αποθηκεύει κάθε μία από τις δύο περιπτώσεις μια αυτοτελή, ξεχωριστή ενσωμάτωση χαρακτήρα;
* Κανείς άλλος δεν έχει ονομάσει το πρόβλημα και η συζήτηση είναι δύσκολη χωρίς κοινούς όρους.
** Στη σελίδα του έργου αναφέρεται προς το παρόν ότι «έρχεται σύντομα».
Πρώτη δημοσίευση την Παρασκευή 27 Μαρτίου 2026.


