
Andersons vinkel
UniTune: Googles alternative teknik til neural billedredigering

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterUniTune finjusterer en diffusionsmodel på et enkelt billede for at muliggøre præcise…
Vis mere
- UniTune finjusterer en diffusionsmodel på et enkelt billede for at muliggøre præcise tekststyrede redigeringer.
- I modsætning til DreamBooth eller Textual Inversion afviser UniTune begge tilgange for bedre detaljebevarelse.
- Metoden opnår høj semantisk adskillelse og holder ansigter intakte under radikale baggrundstransformationer.
Google Research ser ud til at angribe tekstbaseret billede-redigering fra flere sider, og venter sandsynligvis på at se, hvad der “får succes”. Kort efter udgivelsen af deres Imagic-artikel i denne uge, har det store søgefirma foreslået en yderligere latent diffusionsbaseret metode til at udføre ellers umulige AI-baserede redigeringer af billeder via tekstkommandoer, denne gang kaldet UniTune.
Baseret på eksemplerne i projektets nye artikel, har UniTune opnået en ekstraordinær grad af disentanglement af semantisk pose og idé fra faktisk billedindhold:

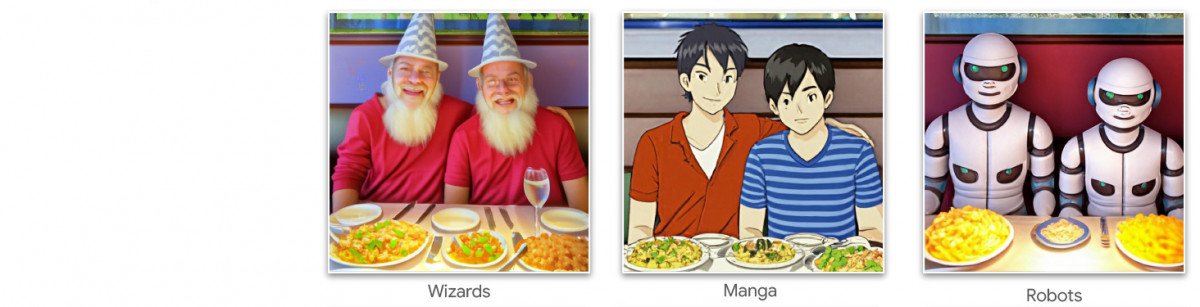

UniTunes kommando over semantisk komposition er fremragende. Bemærk, hvordan i den øverste række af billeder, ansigterne på de to personer ikke er forvrænget af den ekstraordinære transformation på resten af kildebilledet (højre). Kilde: https://arxiv.org/pdf/2210.09477.pdf
Som Stable Diffusion-fans vil have lært, kan det være svært at anvende redigeringer på dele af et billede uden at ændre resten af billedet. Selv om populære distributioner som AUTOMATIC1111 kan oprette masker for lokale og begrænsede redigeringer, er processen tortur og ofte uforudsigelig.
Det åbenlyse svar, i hvert fald for en computer vision-praktiker, er at indsætte et lag af semantisk segmentering, der kan genkende og isolere objekter i et billede uden brugerindgreb, og der har faktisk været flere nye initiativer på dette område.
En anden mulighed for at låse ned besværlige og sammenflettede neurale billede-redigeringer er at udnytte OpenAIs inflydelsesrige Contrastive Language-Image Pre-training (CLIP)-modul, der er hjertet i latente diffusionsmodeller som DALL-E 2 og Stable Diffusion, for at fungere som et filter ved det punkt, hvor en tekst-til-billede-model er klar til at sende en fortolket gengivelse tilbage til brugeren. I denne sammenhæng bør CLIP fungere som vagt og kvalitetskontrol, der afviser fejlbehæftede eller uegnede billeder. Dette skal snart indføres (Discord-link) i Stability.ais API-drevne DreamStudio-portal. Men CLIP er muligvis både årsag og løsning her, fordi det også har påvirket, hvordan billedet blev skabt. Desuden kan hardwarekravene overstige det, som en slutbruger normalt har lokalt, så tilgangen er måske ikke ideel.
Komprimeret Sprog
Det foreslåede UniTune “finjusterer” en eksisterende diffusionsmodel – i dette tilfælde Googles egen Imagen, selv om forskerne fastslår, at metoden er kompatibel med andre latente diffusionsarkitekturer – sådan at en unik token indsættes i den, som kan tilkaldes ved at inkludere den i en tekstprompt.
Det lyder på overfladen som Google DreamBooth, som i øjeblikket er en besættelse blandt Stable Diffusion-fans og -udviklere, som kan indsætte nye karakterer eller objekter i en eksisterende checkpoint, ofte på under en time, baseret på blot et par kildebilleder; eller som Textual Inversion, som opretter “sidecar”-filer til en checkpoint, som derefter behandles, som om de oprindeligt var trænet ind i modellen, og kan udnytte modellens egne enorme ressourcer ved at ændre dens tekstklassifikator, hvilket resulterer i en lille fil (i forhold til de minimum 2 GB pruned checkpoints i DreamBooth).
I virkeligheden fastslår forskerne, at UniTune afviste begge disse tilgange. De fandt, at Textual Inversion udelod for mange vigtige detaljer, mens DreamBooth ‘fungerede dårligere og tog længere tid’ end den løsning, de endelig valgte.
UniTune bruger dog samme indkapslede semantiske «metaprompt»-tilgang som DreamBooth. De indlærte ændringer kaldes frem med unikke ord valgt af træneren, som ikke kolliderer med ord, der allerede findes i den omhyggeligt trænede offentlige model. QUOTEOPEN«For at udføre redigeringen sampler vi de finjusterede modeller med prompten “[rare_tokens] edit_prompt” (for eksempel “beikkpic to hunde i en restaurant” eller “beikkpic en minion”).»QUOTECLOSE
Processen
Selv om det er forbløffende, hvorfor to næsten identiske papirer, med hensyn til deres endelige funktion, skulle ankomme fra Google i samme uge, er der, på trods af en enorm mængde ligheder mellem de to initiativer, i hvert fald én klar forskel mellem UniTune og Imagic – sidstnævnte bruger “ukomprimeret” naturligt sprog til at guide billede-redigering, hvorimod UniTune træner i unikke DreamBooth-stil tokens.
Derfor, hvis du redigerede med Imagic og ønskede at udføre en transformation af denne art…

Fra UniTune-papiret – UniTune sætter sig op imod Googles favorit-rival neurale redigeringssystem, SDEdit. UniTunes resultater er på yderste højre side, mens den estimerede maske ses i andet billede fra venstre.
.. i Imagic ville du indtaste ‘den tredje person, siddende i baggrunden, som et sødt, pelsklædt monster’.
Den tilsvarende UniTune-kommando ville være ‘Manden bagi som [x]’, hvor x er det underlige og unikke ord, der var bundet til det finjusterede koncept, der var forbundet med den pelsklædte monsterfigur.
DreamBooth og Textual Inversion får flere billeder for at skabe en deepfake-lignende abstraktion, der kan vises i mange positurer. UniTune og Imagic får derimod kun ét billede: den oprindelige, uændrede kilde. Det minder om de senere års GAN-baserede redigeringsværktøjer, der omdanner inputbilledet til koder i GAN-modellens latente rum og sender koderne til andre dele af rummet for at ændre billedet, for eksempel ved at projicere en ung mørkhåret person gennem koder for «gammel» eller «blond». Resultaterne af denne metode i en diffusionsmodel er dog overraskende præcise og langt mindre tvetydige i sammenligning. 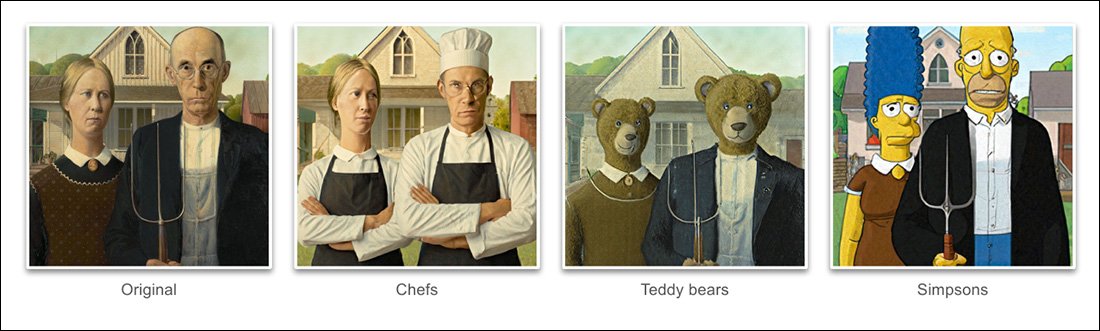
Finjusteringsprocessen
UniTune-metoden sender essentielt det originale billede gennem en diffusionsmodel med et sæt instruktioner om, hvordan det skal ændres, ved hjælp af de enorme mængder af tilgængelige data, der er trænet ind i modellen. I virkeligheden kan du gøre dette lige nu med Stable Diffusions img2img-funktion – men ikke uden at forvrænge eller på en eller anden måde ændre dele af billedet, som du ville foretrække at bevare.
Under UniTune-processen finjusteres systemet, hvilket vil sige, at UniTune tvinger modellen til at genoptage træningen, med de fleste af dens lag ufrosne (se nedenfor). I de fleste tilfælde vil finjustering sandsynligvis sænke det overordnede generelle tabsværdier for en hårdt vundet højpræsterende model til fordel for at indsætte eller forbedre et andet aspekt, der ønskes at blive skabt eller forbedret.
I UniTune ser modelkopien, selv om den fylder flere gigabyte eller mere, ud til at blive behandlet som en midlertidig engangsskal og kasseret til sidst efter ét formål. Sådanne datamængder bliver en daglig lagerkrise for DreamBooth-brugere, hvis beskårne modeller stadig fylder mindst 2 GB per motiv. Som i Imagic foregår hovedjusteringen på de to nederste af Imagens tre niveauer (basis 64px, 64px>256px og 256px>1024px). I modsætning til Imagic ser forskerne også mulig værdi i at optimere det sidste og største superopløsningsniveau, selv om de endnu ikke har prøvet. På det nederste 64px-niveau styres modellen mod basisbilledet under træningen med gentagne billede/tekst-par i 128 iterationer, batchstørrelse 4 og Adafactor som tabsfunktion ved læringsrate 0,0001. Kun T5-enkoderen er frosset under finjusteringen, ligesom under Imagens primære træning. Operationen gentages på 64>256px-niveauet med den samme støjaugmentering som i Imagens oprindelige træning.
Sampling
Der er mange mulige sampling-metoder, som kan anvendes til at fremkalde ændringerne, der er gjort, herunder Classifier Free Guidance (CFG), en hovedsagelig del af Stable Diffusion. CFG definerer grundlæggende, i hvilken udstrækning modellen er fri til at “følge sin fantasi” og udforske rendering-mulighederne – eller også, ved lavere indstillinger, i hvilken udstrækning den skal holde sig til input-data og gøre færre omfattende eller dramatiske ændringer.

Ligesom Textual Inversion (lidt mindre med DreamBooth), er UniTune egnet til at anvende distinkte grafiske stilarter til originale billeder, samt mere fotorealistiske redigeringer.
Forskere har også eksperimenteret med SDEdits “sen start”-teknik, hvor systemet opmuntres til at bevare original detaljer ved at være kun delvist “støj” fra starten, men i stedet fastholde sine essentielle karakteristika. Selv om forskerne kun anvendte dette på det nederste niveau (64px), mener de, at det kan blive en nyttig supplerende samplingteknik i fremtiden.
Forskerne brugte også prompt-til-prompt som en ekstra tekstbaseret teknik til at betinge modellen: QUOTEOPEN«I indstillingen “prompt to prompt” fandt vi, at teknikken, vi kalder Prompt Guidance, er særlig nyttig til at justere trofasthed og udtryksfuldhed.»QUOTECLOSEQUOTEOPEN«Prompt Guidance ligner Classifier Free Guidance, men bruger en anden prompt som udgangspunkt i stedet for den ubetingede model. Det leder modellen mod forskellen mellem de to prompts.»QUOTECLOSE

Prompt-til-prompt i UniTune isolerer effektivt de områder, der skal ændres.
Forfatterne oplyser dog, at promptvejledning kun var nødvendig nogle gange, når CFG ikke gav det ønskede resultat. En anden ny samplingtilgang under udviklingen af UniTune var interpolation, hvor områderne er tilstrækkeligt adskilte og det oprindelige og ændrede billede tilstrækkeligt ens i komposition til, at mere «naiv» interpolation kan bruges.

Interpolation kan gøre UniTunes mere krævende processer overflødige, når de områder, der skal ændres, er adskilte og klart afgrænsede.
Forfatterne foreslår, at interpolation kan fungere så godt på mange kildebilleder, at den kan bruges som standard. Den kan også skabe store transformationer, når komplekse okklusioner ikke skal håndteres med mere intensive metoder. UniTune kan lave lokale ændringer med eller uden redigeringsmasker og kan selv bestemme deres placering med en usædvanlig kombination af fortolkningskraft og robust bevarelse af kildedataenes væsentlige træk:

I det øverste billede i anden kolonne har UniTune placeret det ønskede «røde tog i baggrunden» på et passende og autentisk sted. De øvrige eksempler viser, at kildens semantiske integritet bevares selv under store ændringer i pixelindhold og grundlæggende stil.
Latens
Selv om den første iteration af et nyt system altid vil være langsomt, og selv om det er muligt, at enten fællesskabsengagement eller virksomhedsengagement (det er sjældent begge) vil til sidst accelerere og optimere en ressource-krævende rutine, både UniTune og Imagic udfører nogle ret betydelige maskinlæringsmanøvrer for at skabe disse fantastiske redigeringer, og det er tvivlsomt, i hvilken udstrækning en sådan ressource-krævende proces nogensinde kan skaleres ned til hjemmebrug, snarere end API-drevet adgang (selv om sidstnævnte måske er mere ønskværdigt for Google).
For øjeblikket er rundturen fra input til resultat omkring 3 minutter på en T4 GPU, med omkring 30 sekunder ekstra til inferens (som per enhver inferens-rutine). Forfatterne indrømmer, at dette er høj latens, og knap nok kvalificerer sig som “interaktivt”, men de tilføjer også, at modellen forbliver tilgængelig for yderligere redigeringer, efter at den først er finjusteret, indtil brugeren er færdig med processen, hvilket reducerer redigeringstiden per redigering.
Offentliggjort første gang den 21. oktober 2022.


