
Andersons vinkel
Mere effektiv fjernelse af objekter fra video med maskinlæring

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterE2FGVI forener tre videoudfyldningstrin til ét ende-til-ende-system for betydelige…
Vis mere
- E2FGVI forener tre videoudfyldningstrin til ét ende-til-ende-system for betydelige effektivitetsgevinster.
- Systemet kører femten gange hurtigere end tidligere optiske flow-metoder, samtidig med at det opnår state-of-the-art resultater.
- En ny temporal fokal transformer udvider opmærksomhed fra 2D til 3D for sammenhængende indholdshallucination på tværs af billeder.
Ny forskning fra Kina rapporterer om resultater på højeste niveau i forskningsfeltet – samt en imponerende forbedring i effektivitet – for et nyt video inpainting-system, der kan fjerne objekter fra optagelser med stor dygtighed.
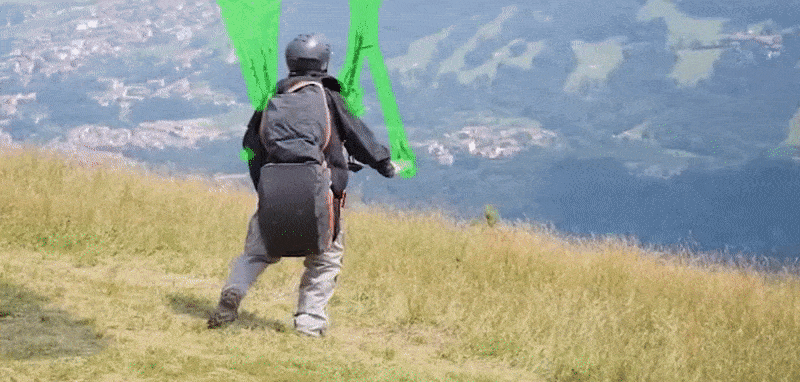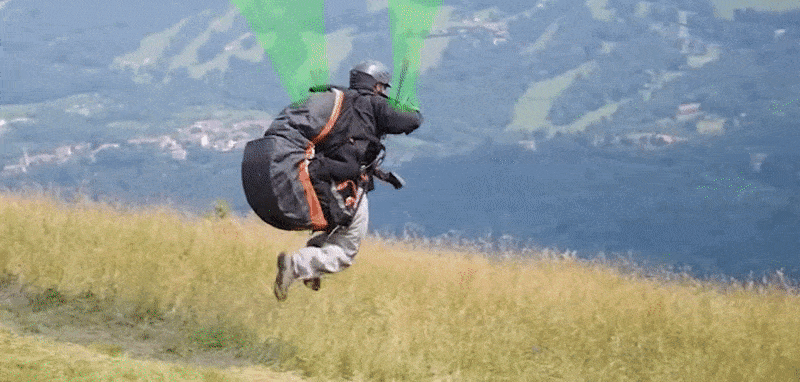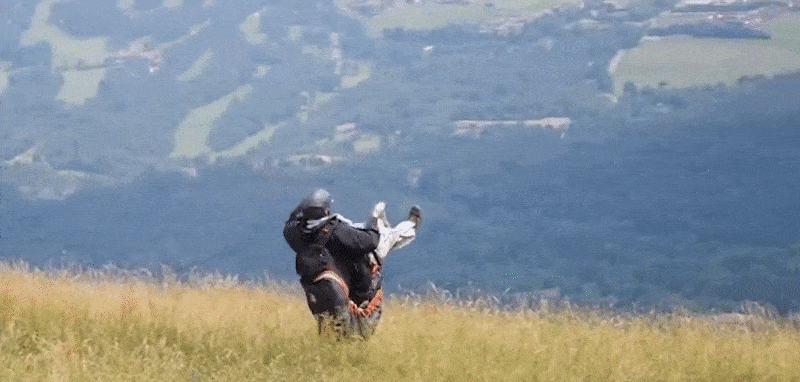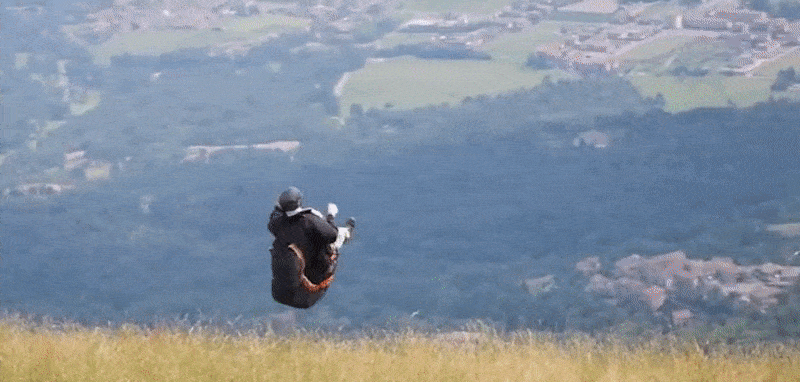
En hanggliderpilots sele bliver fjernet fra billedet af den nye procedure. Se kildevideoen for bedre opløsning og flere eksempler. Kilde: https://www.youtube.com/watch?v=N–qC3T2wc4
Metoden, der hedder End-to-End framework for Flow-Guided video Inpainting (E2FGVI), er også i stand til at fjerne vandmærker og andre former for occlusion fra videoindhold.
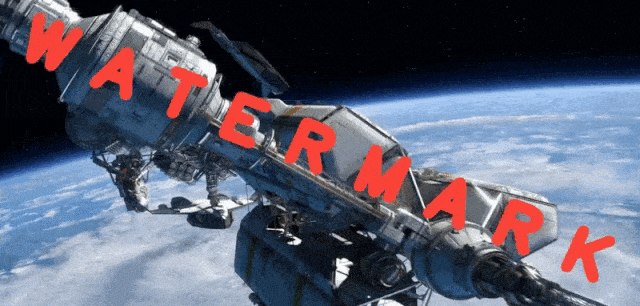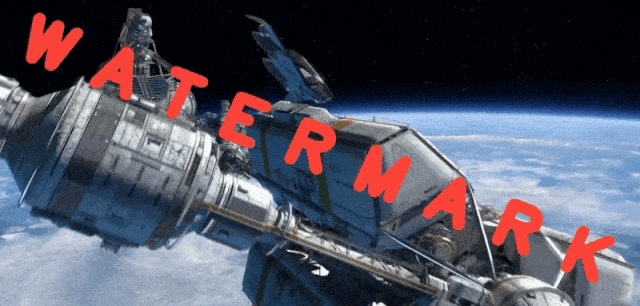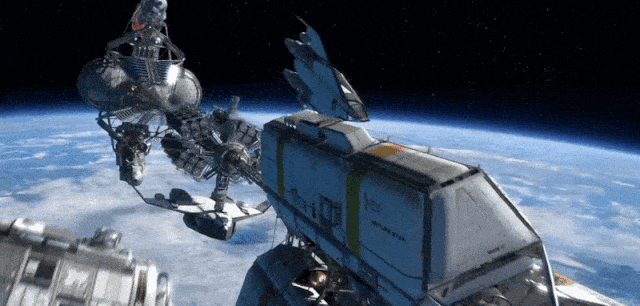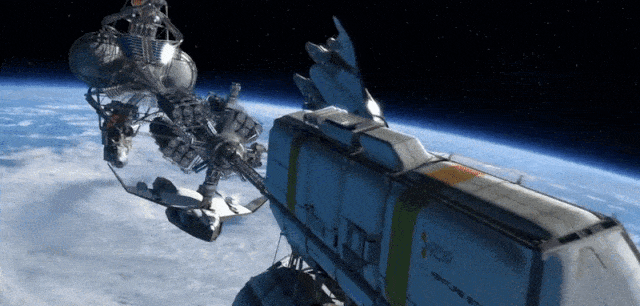
E2FGVI beregner forudsigelser for indhold, der ligger bag occlusioner, hvilket muliggør fjernelse af selv bemærkelsesværdige og vanskelige vandmærker. Kilde: https://github.com/MCG-NKU/E2FGVI
(For at se flere eksempler i bedre opløsning, se videoen)
Selvom modellen i den publicerede artikel var trænet på 432px x 240px videoer (typisk små inputstørrelser, begrænset af tilgængelig GPU-plads vs. optimale batch-størrelser og andre faktorer), har forfatterne siden udgivet E2FGVI-HQ, der kan håndtere videoer i vilkårlig opløsning.
Koden for den aktuelle version er tilgængelig på GitHub, mens HQ-versionen, der blev udgivet sidste søndag, kan downloades fra Google Drive og Baidu Disk.

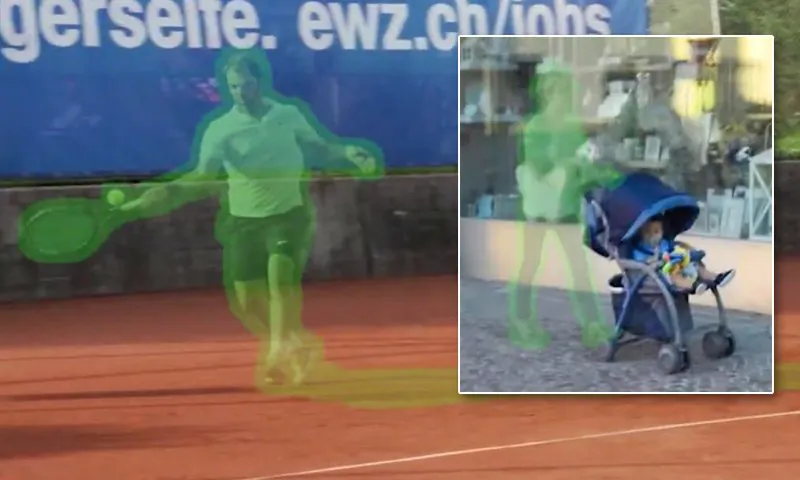
Barnet bliver i billedet.
E2FGVI kan behandle 432×240 video på 0,12 sekunder per frame på en Titan XP GPU (12GB VRAM), og forfatterne rapporterer, at systemet opererer femten gange hurtigere end tidligere førende metoder baseret på optical flow.
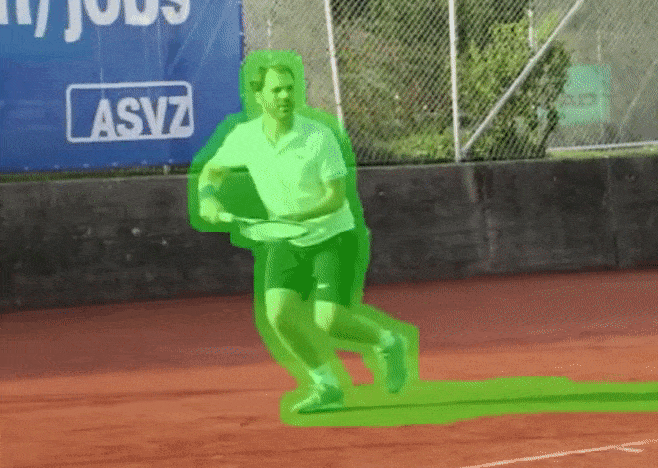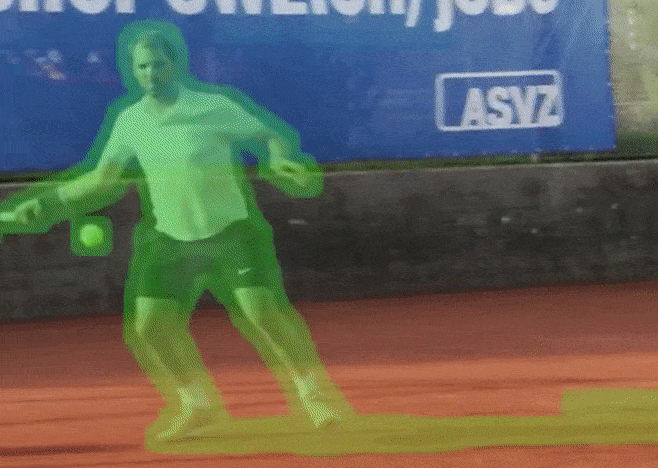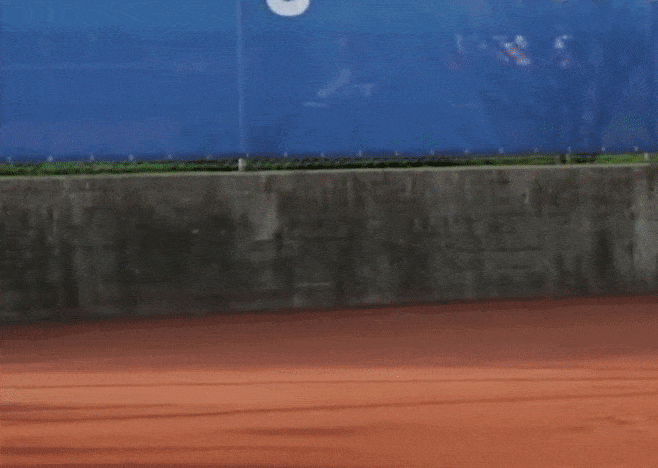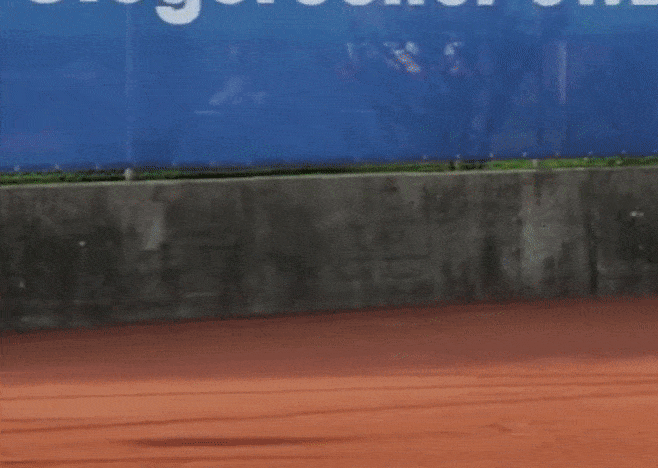
En tennisspiller forlader pladsen uventet.
Testet på standard datasets for denne undersektor af forskning i billedsyntese, var den nye metode i stand til at overgå rivaler i både kvalitative og kvantitative evalueringer.

Test mod tidligere tilgange. Kilde: https://arxiv.org/pdf/2204.02663.pdf
Artiklen hedder Towards An End-to-End Framework for Flow-Guided Video Inpainting, og er et samarbejde mellem fire forskere fra Nankai University, sammen med en forsker fra Hisilicon Technologies.
Hvad mangler i dette billede
Ud over dens åbenlyse anvendelser for visuelle effekter, er højkvalitets video inpainting på vej til at blive en kernefunktion i nye AI-baserede teknologier til billedsyntese og billedændring.
Dette er særligt tilfældet for krop-ændrende modeapplikationer og andre rammer, der søger at ‘slanke’ eller på anden måde ændre scener i billeder og videoer. I sådanne tilfælde er det nødvendigt at udfylde på overbevisende vis den ekstra baggrund, der bliver afsløret af syntesen.

Fra en ny artikel, er en krop-‘omformnings’-algoritme sat til at udfylde den nyopdagede baggrund, når en person bliver ændret i størrelse. Her er manglen repræsenteret af den røde kontur, som den (i virkeligheden, se billedet til venstre) mere fyldige person tidligere havde besat. Baseret på kildemateriale fra https://arxiv.org/pdf/2203.10496.pdf
Kohærent optisk flow
Optisk flow (OF) er blevet en kerne-teknologi i udviklingen af video-objekt-fjernelse. Ligesom et atlas, giver OF et kort over en tidssekvens. OF bruges ofte til at måle hastighed i computer vision-initiativer, og kan også muliggøre temporalt konsistent inpainting, hvor opgaven som helhed kan overvejes i en enkelt passering, i stedet for Disney-stil ‘per-frame’-opmærksomhed, der uundgåeligt fører til temporal diskontinuitet.
Video inpainting-metoder indtil nu har centreret sig om en tre-trinsproces: flow completion, hvor videoen grundlæggende kortlægges til en diskret og udforskbar enhed; pixel propagation, hvor hullerne i ‘korrupte’ videoer fyldes med pixels, der spredes i begge retninger; og content hallucination (pixel ‘opfindelse’, der er kendt for de fleste af os fra deepfakes og tekst-til-billede-rammer som DALL-E-serien), hvor det estimerede ‘manglende’ indhold opfindes og indsættes i optagelserne.
Den centrale innovation i E2FGVI er at kombinere disse tre trin i et end-to-end-system, der eliminerer behovet for manuelle operationer på indholdet eller processen.

Artiklen bemærker, at behovet for manuel indgriben kræver, at ældre processer ikke udnytter en GPU, hvilket gør dem ret tidskrævende. Fra artiklen*:
‘Tag DFVI som eksempel, tager færdiggørelsen af en video med størrelsen 432 × 240 fra DAVIS, der indeholder omkring 70 frames, omkring 4 minutter, hvilket er uacceptabelt i de fleste virkelige anvendelser. Ud over ovennævnte ulemper ignorerer kun brug af et forudtrænet billed inpainting-netværk på indholdshallucinations-stadiet indholdets relationer på tværs af temporale naboer, hvilket fører til inkonsistent genereret indhold i videoer.’
Ved at forene de tre trin i video inpainting, er E2FGVI i stand til at erstatte det andet trin, pixel propagation, med spredning af kendetegn. I de mere segmenterede processer i tidligere arbejder er kendetegn ikke lige så bredt tilgængelige, fordi hvert trin er relativt hermetisk, og arbejdsgangen kun semi-automatiseret.
Derudover har forskerne udviklet en temporal focal transformer til indholdshallucinations-stadiet, der ikke kun tager hensyn til direkte naboer af pixels i det aktuelle billede (dvs. hvad der sker i den del af billedet i det foregående eller næste billede), men også fjerne naboer, der er mange billeder væk, og alligevel vil påvirke den samlede effekt af enhver operation, der udføres på videoen som helhed.

Arkitektur af E2FGVI.
Den nye kendetegnbaserede centrale sektion af arbejdsgangen kan udnytte flere processer på kendetegnsniveau og lærbare sampling-offsets, mens projektets nye fokustransformer, ifølge forfatterne, udvider størrelsen af fokus-vinduer ‘fra 2D til 3D’.
Tests og data
For at teste E2FGVI, evaluerede forskerne systemet mod to populære video-objekt-segmenterings-datasets: YouTube-VOS og DAVIS. YouTube-VOS indeholder 3741 træningsvideo-klip, 474 valideringsklip og 508 testklip, mens DAVIS indeholder 60 træningsvideo-klip og 90 testklip.
E2FGVI blev trænet på YouTube-VOS og evalueret på begge datasets. Under træning blev objektmasker (de grønne områder i billederne ovenfor, og den tilhørende YouTube-video) genereret for at simulere video-gennemførelse.
For metrikkerne valgte forskerne Peak signal-til-støj-forhold (PSNR), strukturel lighed (SSIM), Video-baseret Fréchet Inception Distance (VFID) og Flow Warping Error – sidstnævnte for at måle temporal stabilitet i den påvirkede video.
De tidligere arkitekturer, som systemet blev testet mod, var VINet, DFVI, LGTSM, CAP, FGVC, STTN og FuseFormer.

Fra den kvantitative resultatssektion af artiklen. Op og ned-pile viser, at højere eller lavere tal er bedre, henholdsvis. E2FGVI opnår de bedste score på tværs af brættet. Metoderne er evalueret ift. FuseFormer, selvom DFVI, VINet og FGVC ikke er end-to-end-systemer, hvilket gør det umuligt at estimere deres FLOPs.
Ud over at opnå de bedste score mod alle konkurrerende systemer, gennemførte forskerne en kvalitativ brugerundersøgelse, hvor videoer, der var transformeret med fem repræsentative metoder, blev vist individuelt til tyve frivillige, der blev bedt om at bedømme dem i forhold til visuel kvalitet.

Den lodrette akse repræsenterer procentdelen af deltagere, der foretrak E2FGVI-udgangen i forhold til visuel kvalitet.
Forfatterne bemærker, at på trods af den enstemmige foretrækning for deres metode, er et af resultaterne, FGVC, ikke i overensstemmelse med de kvantitative resultater, og de foreslår, at dette indikerer, at E2FGVI muligvis på misvisende vis genererer ‘mere visuelt behagelige resultater’.
I forhold til effektivitet bemærker forfatterne, at deres system kraftigt reducerer flydende-komma-operationer per sekund (FLOPs) og inferens-tid på en enkelt Titan GPU på DAVIS-datasettet, og observerer, at resultaterne viser, at E2FGVI kører x15 hurtigere end flow-baserede metoder.
De kommenterer:
‘[E2FGVI] har de laveste FLOPs i modsætning til alle andre metoder. Dette indikerer, at den foreslåede metode er meget effektiv for video inpainting.’
*Min konvertering af forfatternes kildehenvisninger i den løbende tekst til hyperlinks.
Først publiceret 19. maj 2022.
Ændret tirsdag den 28. oktober 2025, for at fjerne fejlbehæftet video-indlejring og ændre henvisninger til indlejret video i artiklens indhold.


