
Andersons vinkel
Ensartet redigering af AI-videoindhold med tekststyret input

 Føj Unite.AI til dine foretrukne kilder på Google
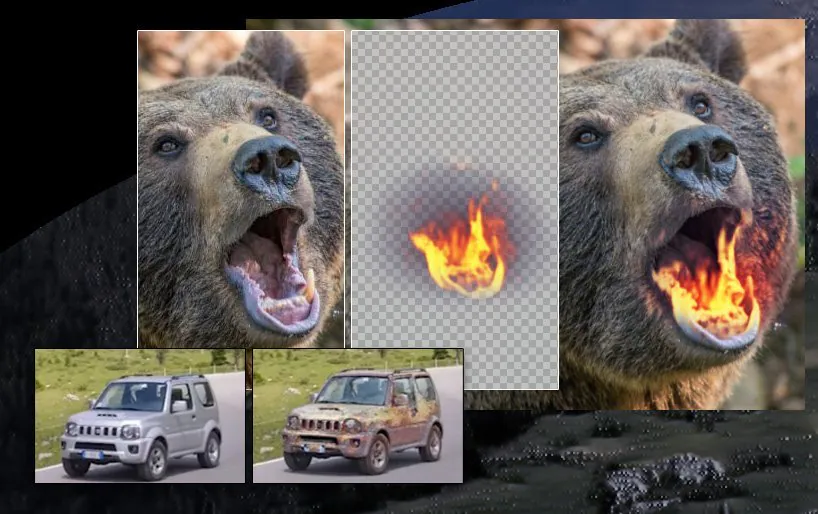
NøglepunkterText2Live muliggør konsistente videoredigeringer fra tekstprompter uden…
Vis mere
- Text2Live muliggør konsistente videoredigeringer fra tekstprompter uden per-frame-behandling.
- Systemet bruger et neuralt lagdelt atlas til at anvende redigeringer én gang på tværs af hele videotidslinjen.
- Text2Live automatiserer maskering og kompositering, hvilket eliminerer behovet for rotoscoping eller grønne skærme.
Mens det professionelle VFX-miljø er fascineret – og lejlighedsvis føler sig lidt truet – af nye innovationer inden for billed- og videosyntese, så mangler de fleste af disse projekter tidsmæssig kontinuitet, og de bliver derfor ofte betegnet som “psykedeliske” med skinnende og hurtigt skiftende teksturer og strukturer, inkonsistente effekter og en slags grov teknologi, der minder om foto-kemisk æra af visuelle effekter.
Hvis du ønsker at ændre noget meget specifikt i en video, der ikke falder inden for kategorien deepfakes (dvs. påføring af en ny identitet på eksisterende optagelser af en person), så opererer de fleste af de nuværende løsninger under ret begrænsede muligheder, når det kommer til præcisionen, der kræves for produktion af visuelle effekter af høj kvalitet.
En undtagelse er det løbende arbejde af en løs sammenslutning af akademikere fra Weizmann Institute of Science. I 2021 annoncerede tre af instituttets forskere, i samarbejde med Adobe (ADBE ), en ny metode til at dekomponere video og påføre en konsistent intern kortlægning – et lagdelt neuralt atlas – i et sammensat resultat, komplet med alpha-kanaler og tidskoherent output.
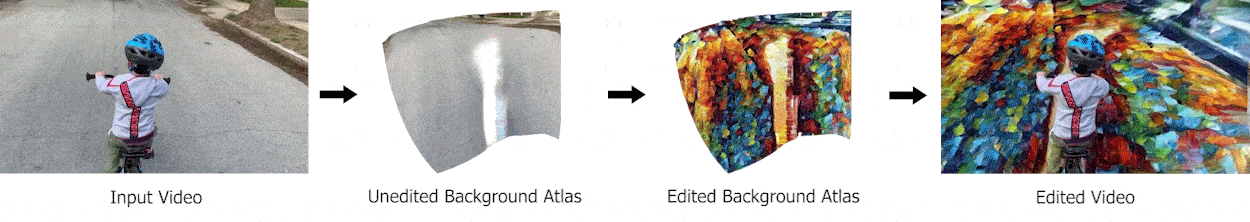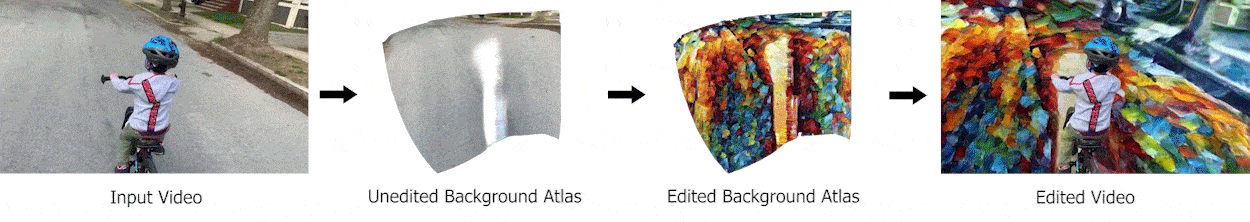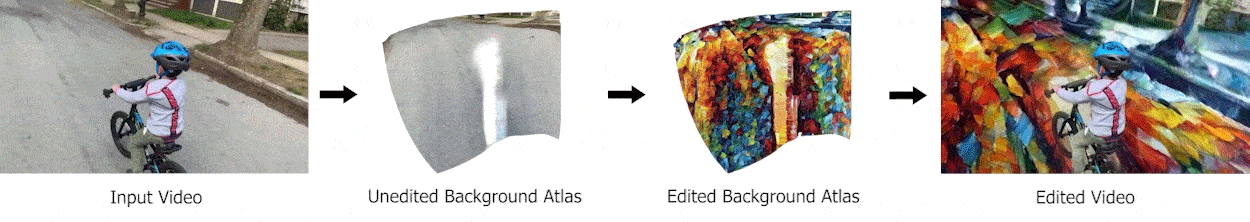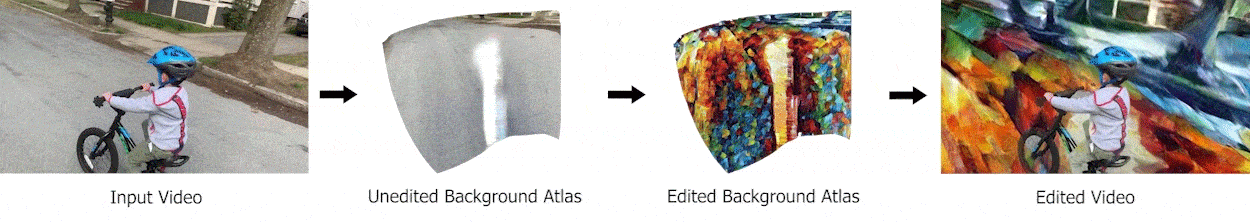
Fra forskningsartiklen fra 2021: en estimering af det fulde gennemløb af vejen i kildeklippet redigeres via et neuralt netværk på en måde, der traditionelt ville kræve omfattende rotoscoping og match-moving. Da baggrund og forgrundselementer håndteres af forskellige netværk, er masker virkelig ‘automatiske’. Kilde: https://layered-neural-atlases.github.io/
Selv om det falder et sted i området dækket af optisk flow i VFX-pipelines, har det lagdelte atlas ingen direkte pendant i traditionelle CGI-workflows, da den i virkeligheden udgør et ‘tidsmæssigt teksturkort’, der kan produceres og redigeres gennem traditionelle softwaremetoder. I det andet billede i illustrationen ovenfor repræsenteres baggrunden af vejoverfladen (figurativt) over hele videoens løbetid. At ændre dette grundbillede (tredje billede fra venstre i illustrationen ovenfor) producerer en konsistent ændring i baggrunden.
Billederne af det ‘udfoldede’ atlas ovenfor repræsenterer kun enkeltfortolkede billeder; konsistente ændringer i ethvert målbillede kortlægges tilbage til det oprindelige billede, hvilket fastholder eventuelle nødvendige tildækninger og andre påkrævede sceneeffekter, såsom skygger eller refleksioner.
Kernearkitekturen bruger en Multilayer Perceptron (MLP) til at repræsentere de udfoldede atlaser, alpha-kanaler og kortlægninger, som alle optimeres samlet, og helt i et 2D-rum, hvilket eliminerer behovet for forhåndsviden om 3D-geometripunkter som i NeRF, dybdekort og lignende CGI-stil attributter.
Referenceatlasset for de enkelte objekter kan også ændres pålideligt:
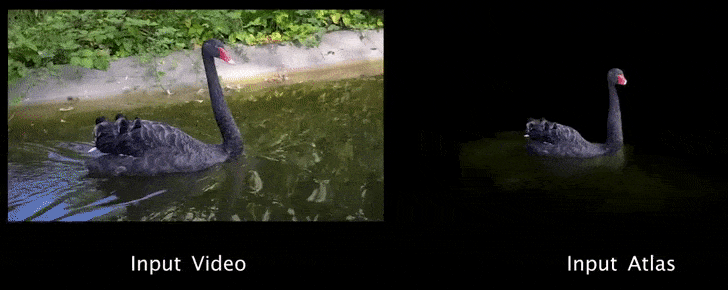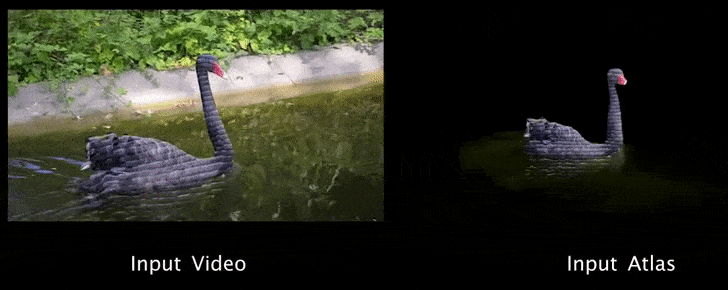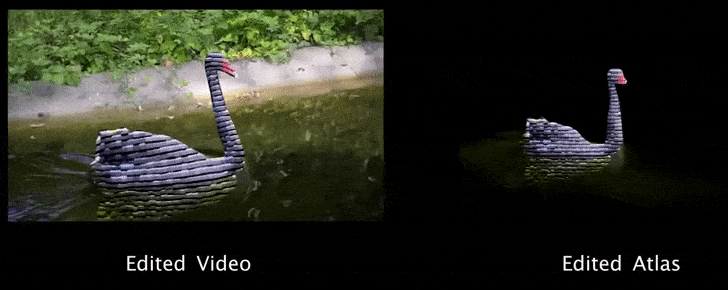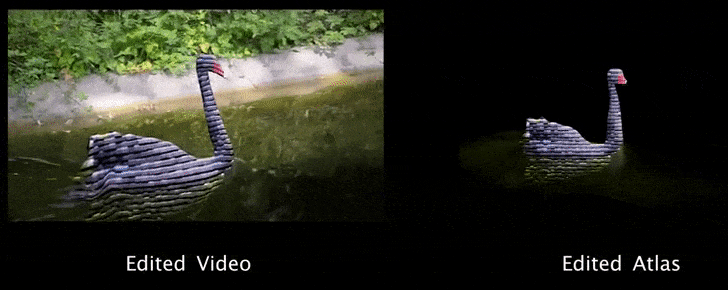
Konsistent ændring af et bevægeligt objekt under 2021-rammen. Kilde: https://www.youtube.com/watch?v=aQhakPFC4oQ
Grundlæggende er 2021-systemet en kombination af geometrisk justering, match-moving, kortlægning, gen-teksturering og rotoscoping i en særskilt neural proces.
Text2Live
De tre oprindelige forskere bag forskningsartiklen fra 2021, sammen med NVIDIA (NVDA ) Research, er blandt bidragerne til en ny innovation på teknikken, der kombinerer kraften fra lagdelte atlaser med den slags tekst-guidet CLIP-teknologi, der er kommet tilbage i fokus denne uge med OpenAI’s udgivelse af DALL-E 2-rammen.
Den nye arkitektur, med navnet Text2Live, giver brugeren mulighed for at oprette lokaliserede redigeringer af faktisk videoindhold baseret på tekstprompts:
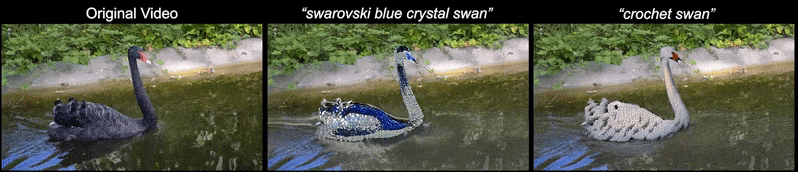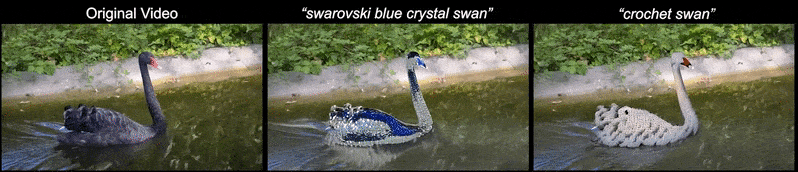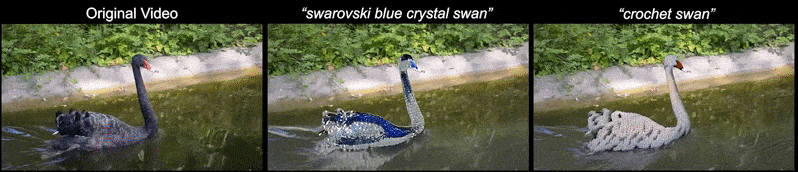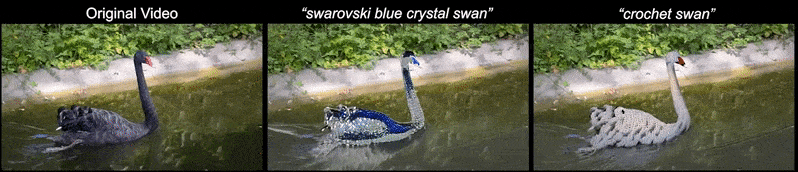
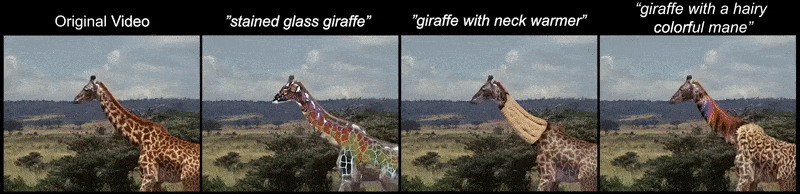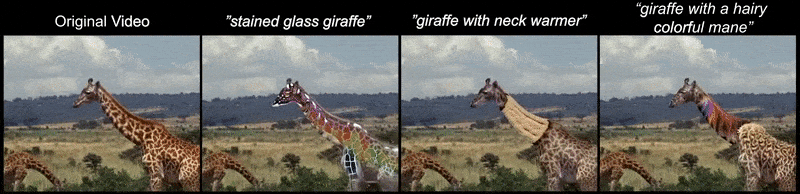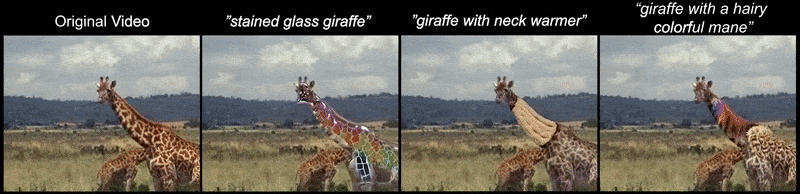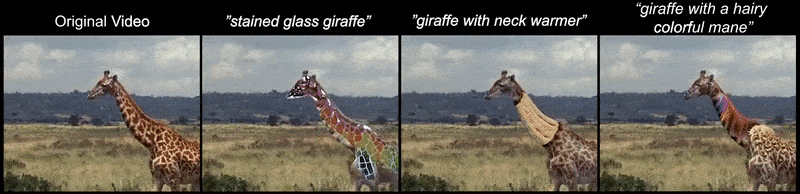
To eksempler på forgrundredigering. For bedre opløsning og skarphed, se de originale videoer på https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live tilbyder semantisk og meget lokal redigering uden brug af en forudtrænet generator, ved at benytte en intern database, der er specifik for det video-klip, der påvirkes.

Baggrund og forgrund (objekt) transformationer under Text2Live. Kilde: https://text2live.github.io/sm/pages/video_results_atlases.html
Teknikken kræver ikke brugerdefinerede masker, såsom en typisk rotoscoping eller green-screen workflow, men estimerer i stedet relevans-kort gennem en bootstrapping-teknik baseret på 2021-forskning fra The School of Computer Science at Tel Aviv University og Facebook AI Research (FAIR).

Output-kort genereret via en transformer-baseret generisk opmærksomhedsmodel.
Den nye artikel har titlen Text2LIVE: Text-Driven Layered Image and Video Editing. Omer Bar-Tal fra Weizmann og Yoni Kasten fra NVIDIA Research har sluttet sig til det oprindelige hold fra 2021.
Arkitektur
Text2Live består af en generator, der er trænet på et enkelt inputbillede og mål-tekstprompts. En Contrastive Language-Image Pretraining (CLIP) model, der er forudtrænet på 400 millioner tekst/billede-par, giver associeret visuelt materiale, hvorfra bruger-input-transformationer kan fortolkes.

Generatoren accepterer et inputbillede (billede) og producerer et mål-RGBA-lag, der indeholder information om farve og uigennemsigtighed. Dette lag komponeres derefter ind i den oprindelige optagelse med yderligere augmenteringer.

Alpha-kanalen i det genererede RGBA-lag giver en intern kompositorisk funktion uden at ty til traditionelle arbejdsgange, der involverer pixel-baseret software såsom After Effects.
Ved at træne på interne billeder, der er relevante for det mål-video eller billede, undgår Text2Live kravet om enten at invertere inputbilledet til latent rummet af en Generative Adversarial Network (GAN), en praksis, der i øjeblikket er langt fra præcis nok for produktionsvideo-redigeringens krav, eller også bruge en Diffusionsmodel, der er mere præcis og konfigurerbar, men kan ikke fastholde trofasthed til mål-videoen.

Forskellige prompt-baserede transformationer fra Text2Live.
Tidligere tilgange har enten brugt propagations-baserede metoder eller optisk flow-baserede tilgange. Da disse teknikker er til en vis grad ramme-baserede, kan ingen af dem skabe en konsistent tidsmæssig fremtoning af ændringer i output-video. Et lagdelt neuralt atlas giver i stedet et enkelt rum, hvor ændringer kan behandles, og som kan fastholde den pågældende ændring, mens videoen skrider frem.
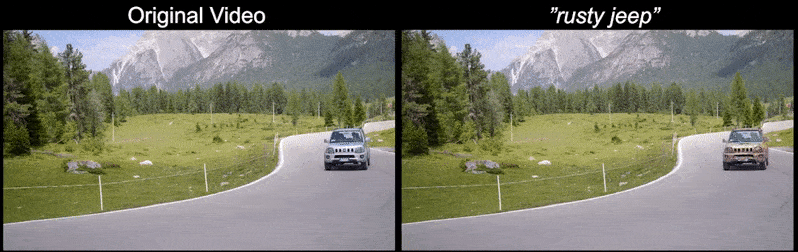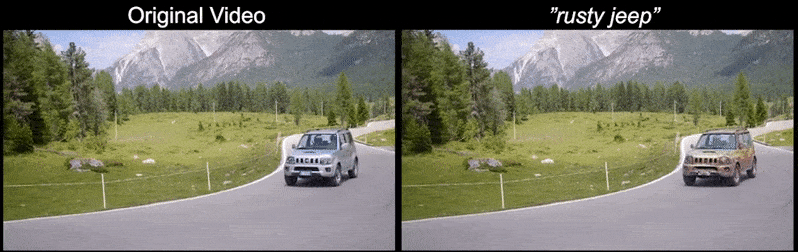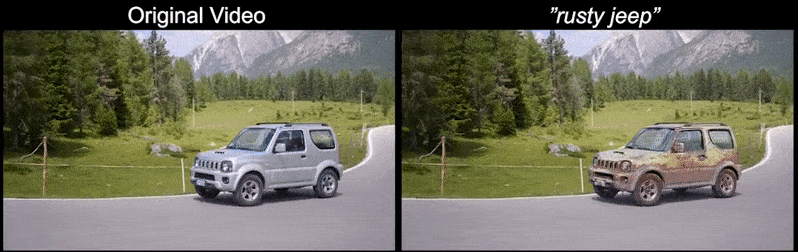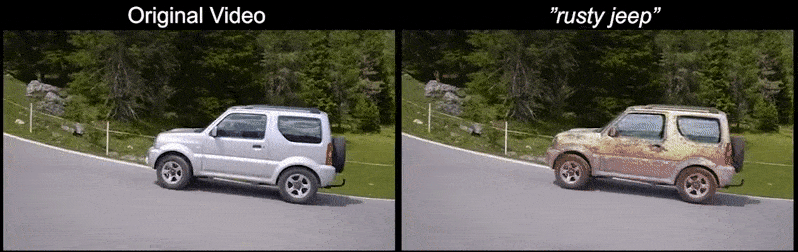
Ingen flimren eller tilfældige hallucinationer: Text2Live opnår en fortolkning af tekstprompten ‘rusty jeep’ og anvender den én gang på den neurale lagdelte atlas af bilen i videoen, i stedet for at genstarte transformationen for hvert fortolket billede.

Workflow for Text2Lives konsistente transformation af en Jeep til et rustent vrag.
Text2Live er tættere på et gennembrud i AI-baseret komposition, snarere end i det frugtbare tekst-til-billede-felt, der har tiltrukket så megen opmærksomhed denne uge med udgivelsen af anden generation af OpenAI’s DALL-E-ramme (der kan inkorporere mål-billeder som en del af den transformative proces, men forbliver begrænset i dens evne til direkte at intervenere i et billede, ud over censurering af kilde-træningsdata og pålægning af filtre, designet til at forhindre bruger-misbrug).
Text2Live giver i stedet brugeren mulighed for at udtrække et atlas og derefter redigere den i ét trin i pixelbaserede miljøer med høj grad af kontrol såsom Photoshop (og måske endda mere abstrakte billed-syntese-rammer såsom NeRF), før den føres tilbage til et korrekt orienteret miljø, der ikke afhænger af 3D-estimation eller CGI-tilgange, der vender tilbage til ældre metoder.
Desuden er Text2Live, ifølge forfatterne, det første sammenlignelige rammeværk til at opnå maskering og komposition på en fuldstændig automatisk måde.
Udgivet første gang 7. april 2022.





