
AI-modeller og platforme
Nye færdige datasets fra Appen accelererer AI-udvikling

 Føj Unite.AI til dine foretrukne kilder på Google
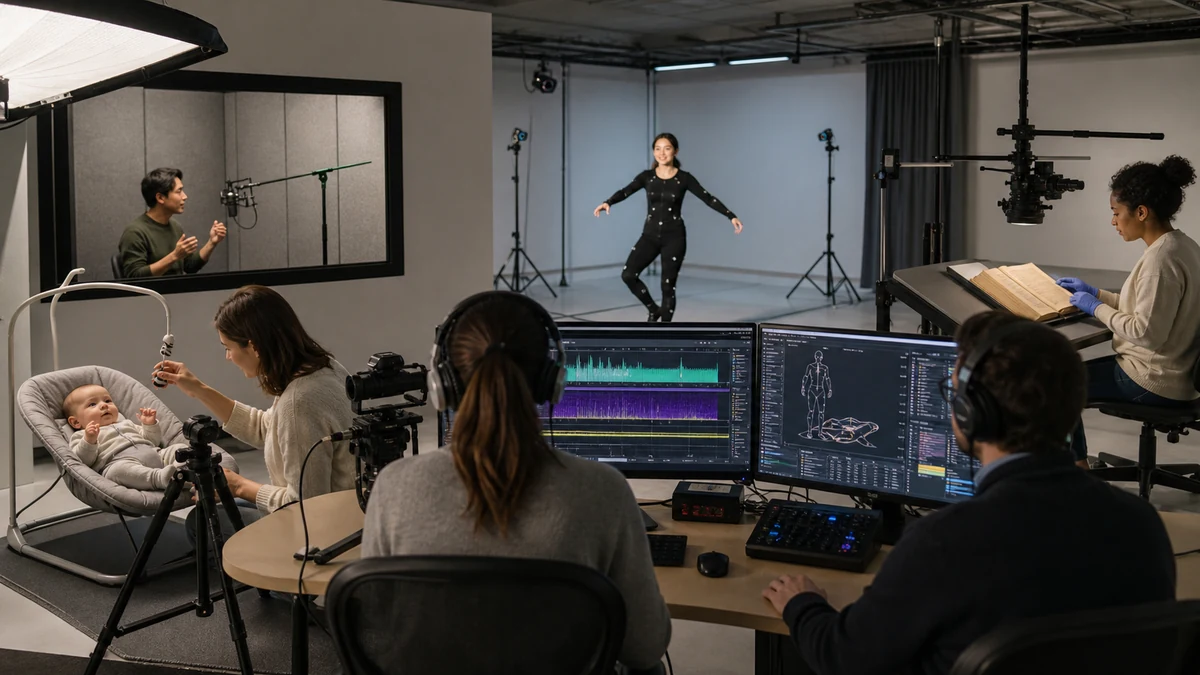
Appen Limited (ASX:APX), den førende leverandør af højkvalitets træningsdata til organisationer, der bygger effektive AI-systemer i stor skala, annoncerede i dag nye færdige datasets (OTS). Disse datasets er designede til at gøre det lettere og hurtigere for virksomheder at erhverve den højkvalitets træningsdata, der er nødvendig for at accelerere deres kunstig intelligens (AI) og maskinlæringsprojekter. De nye OTS-datasets omfatter menneskekroppsbevægelser og innovative babylæte, samt skriptet tale og billeder med tekst, der er egnet til optisk tegnkendelse (OCR) for højefterspurgte, men svært tilgængelige sprog, såsom arabisk, kroatisk, græsk, ungarsk, thai og mere. Med de udvidede datasets omfatter Appens samlede OTS-tilbud over 250 datasets, der består af over 11.000 timers audio, over 25.000 billeder og over 8,7 millioner ord på 80 sprog og multiple dialekter.
Appens OTS-datasets er et hurtigt og omkostningseffektivt værktøj til at starte et AI- eller ML-projekt med konsekvent højkvalitets træningsdata. Hold, der udvider deres AI-kapaciteter, kan også udnytte OTS-datasets til effektivt at forbedre nøjagtigheden, udvikle nye modelkompetencer og inkorporere andre forbedringer i deres AI-modeller. Et OTS-dataset leveres ofte på en uge, for eksempel, sammenlignet med de otte til tolv uger for et nyt dataset-samling- og annotationsprojekt – eller endnu længere, afhængigt af kompleksiteten. Alle Appen-datasets er udviklet ved hjælp af en fuldt gennemsigtig, frivillig metode, så AI-specialister kan være sikre på, at deres data er ren og compliant, og eliminerer den potentielle risiko for backlash og reputationskade.
“AI-hold over hele verden, der arbejder på projekter med stramme deadline og fleksible datakrav, kan drage fordel af at bruge færdige datasets,” sagde Wilson Pang, teknisk direktør i Appen. “OTS-datasets forkorter tiden til værdi og giver adgang til højkvalitetsdata til en lavere samlet omkostning end ved traditionelle metoder. Vi i Appen tager de nødvendige skridt til at sikre, at alle vores datasets er etisk kildevældede og demografisk balancerede, hvilket ermöglicherer virksomheder at opretholde ansvarlige AI-praktikker ved at minimere bias i deres modeller og sikre en fair behandling af data-annotatorer. Du ved altid den præcise kvalitet af et OTS-dataset, hvilket hjælper med at bygge bedre AI, der fungerer i den virkelige verden.”
MediaInterface har leveret sprogteknologiske løsninger til sundhedsrelaterede institutioner i Tyskland og andre dele af Europa i over 20 år. Da virksomheden udvidede sig til Frankrig, havde den fuldt lokaliseret software, men manglede fransk leksikondata, især franske navne og stednavne, der ofte henvises til i patientens sundhedsinformation. Ved hjælp af Appen OTS-datasets erhvervede MediaInterface ca. 21.000 franske navne og 14.000 stednavne. “De kritiske data fra Appen er blevet inkorporeret i vores baggrundskatalog til at lancere med succes på et nyt marked, og dette hjælper os med at bygge nye ordforråd til vores kunder og styrke vores tilgang til fremtidige markedsudgivelser,” sagde Ines Wendler, produktchef i MediaInterface.
De mest erfarne AI-eksperter kombinerer OTS-datasets med påkrævet dataindsamling og annotationsprojekter for at imødekomme deres komplekse AI-modeltræningsdatakrav. Appen er lederen i at tilbyde fortsat støtte gennem en række specifikke dataindsamlingstjenester, såsom kontinuerlig dataannotation og smart mærkning, gennem AI-drevne værktøjer og automatiserede arbejdsgange for at maksimere effektiviteten.
“Vi interagerer med AI fra det øjeblik, vi vågner, til det øjeblik, vi går i seng – gennem virtuelle assistenter, chatbots, søgemaskiner, sociale netværk, medicinske enheder, smarte biler og andre applikationer,” sagde Judith Bishop, Appens senior direktør for AI-specialister, der leder et hold på 100 AI-lingvister og sprogeksperter. “Sprog er ofte den primære grænseflade for mange af disse overbevisende AI-brugsområder, så for at garantere en god oplevelse, skal modellen være trænet til at fungere for alle. Appens engagement i højkvalitetsdata og ansvarlig, etisk AI-udvikling ermögiller virksomheder, der køber vores færdige datasets, at accelerere deres AI-projekter med fuld tillid til deres data.”
Tilføjet til de hundredvis af datasets, der allerede er live på appen.com, er listen over nye Appen OTS-datasets, der nu er tilgængelige:
- Skriptet tale for arabisk (Egypten), arabisk (Saudi-Arabien), arabisk (Forenede Arabiske Emirater), central khmer (Cambodja), kroatisk, græsk, ungarsk, polsk, spansk (Spanien) og tyrkisk
- Billede-OCR for forenklet kinesisk trykt tekst, thai trykt tekst og finsk trykt tekst – Inkluderer forudindspillede reklameplakater, ydre emballage, skilte, blade og menuer til at træne og opdatere computer-vision OCR-modeller
- Menneskekroppsbevægelser (Kina) – Inkluderer annoterede videoer af mennesker i bevægelse, sporet på pixelniveau, egnet til spiludvikling, fitness-applikationer og mere
- Babylæte audio (Kina) – Inkluderer forudindspillede og annoterede babylæte, der kan bruges til at træne AI-modeller til at genkende forskellige græde-lyde og advare forældre
For mere information og for at anmode om et Appen OTS-dataset-eksempel, klik her.


