
AI-modeller og platforme
Indenfor OpenAI’s o3 og o4-mini: Fremme af nye muligheder gennem multimodal fornuft og integrerede værktøjsæt

 Føj Unite.AI til dine foretrukne kilder på Google
Den 16. april 2025 offentliggjorde OpenAI opdaterede versioner af deres avancerede fornuftsmodeller. Disse nye modeller, navngivet o3 og o4-mini, tilbyder forbedringer over deres forgængere, o1 og o3-mini, respectively. De seneste modeller leverer forbedret ydelse, nye funktioner og større tilgængelighed. Denne artikel udforsker de primære fordele ved o3 og o4-mini, fremhæver deres hovedfunktioner og diskuterer, hvordan de kan påvirke fremtiden for AI-anvendelser. Men før vi dykker ned i, hvad der gør o3 og o4-mini særlige, er det vigtigt at forstå, hvordan OpenAI’s modeller er udviklet over tid. Lad os starte med en kort oversigt over OpenAI’s rejse i udviklingen af stadig mere avancerede sprog- og fornuftsmodeller.
OpenAI’s udvikling af store sprogmodeller
OpenAI’s udvikling af store sprogmodeller begyndte med GPT-2 og GPT-3, som bragte ChatGPT til mainstream-brug på grund af deres evne til at producere flydende og kontekstligt nøjagtige tekster. Disse modeller blev bredt anvendt til opgaver som sammenfatning, oversættelse og spørgsmålssvar. Men da brugerne anvendte dem til mere komplekse scenarier, blev deres svagheder tydelige. Disse modeller havde ofte svært ved opgaver, der krævede dyb fornuft, logisk konsistens og flertrinsproblemløsning. For at imødegå disse udfordringer introducerede OpenAI GPT-4 og skiftede fokus mod at forbedre fornuftsmodellerne. Dette skift ledte til udviklingen af o1 og o3-mini. Begge modeller anvendte en metode kaldet chain-of-thought-prompting, som tillod dem at generere mere logiske og nøjagtige svar ved at tænke skridt for skridt. Mens o1 er designed til avancerede problemløsningsbehov, er o3-mini bygget til at levere lignende funktioner på en mere effektiv og omkostningsvenlig måde. Bygget på denne grundlag har OpenAI nu introduceret o3 og o4-mini, som yderligere forbedrer fornuftsmodellerne. Disse modeller er designet til at producere mere nøjagtige og velovervejede svar, især i tekniske fag som programmering, matematik og videnskabelig analyse – områder, hvor logisk præcision er afgørende. I den følgende sektion vil vi undersøge, hvordan o3 og o4-mini forbedrer deres forgængere.
Nøgleforbedringer i o3 og o4-mini
Forbedret fornuft
En af de vigtigste forbedringer i o3 og o4-mini er deres forbedrede fornuftsevne til komplekse opgaver. I modsætning til tidligere modeller, der leverede hurtige svar, tager o3 og o4-mini-modellerne mere tid til at bearbejde hver prompt. Denne ekstra bearbejdning tillader dem at tænke mere grundigt og producere mere nøjagtige svar, hvilket fører til forbedrede resultater på benchmarks. For eksempel overgår o3 o1 med 9% på LiveBench.ai, en benchmark, der vurderer ydelse på tværs af multiple komplekse opgaver som logik, matematik og kode. På SWE-benchmark, der tester fornuft i software-udviklingsopgaver, opnåede o3 en score på 69,1%, og overgik selv konkurrerende modeller som Gemini 2.5 Pro, der opnåede en score på 63,8%. Imens opnåede o4-mini en score på 68,1% på samme benchmark, og tilbød næsten samme fornuftsdybde til en langt lavere omkostning.
Multimodal integration: Tænkning med billeder
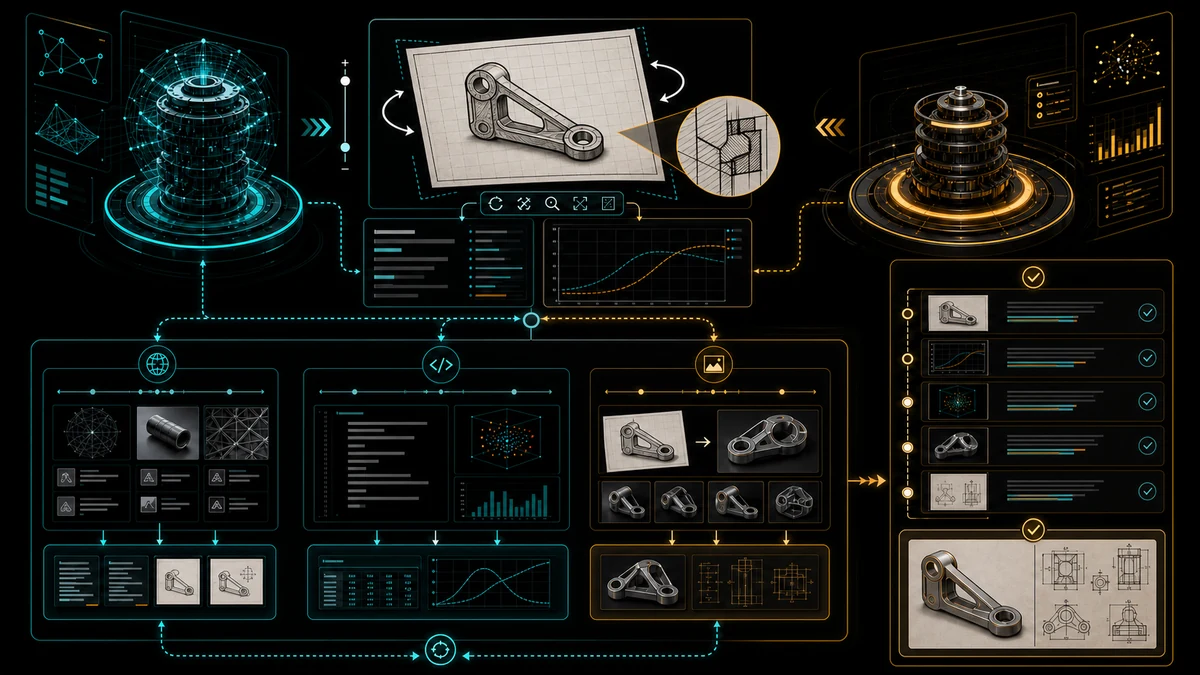
En af de mest innovative funktioner i o3 og o4-mini er deres evne til at “tænke med billeder”. Dette betyder, at de ikke kun kan bearbejde tekstinformation, men også integrere visuel data direkte i deres fornuftproces. De kan forstå og analysere billeder, selv hvis de er af lav kvalitet – som håndskrevne noter, skitser eller diagrammer. For eksempel kunne en bruger uploade et diagram over et komplekst system, og modellen kunne analysere det, identificere potentielle problemer eller endda foreslå forbedringer. Denne funktion bropper gapet mellem tekst- og visuel data, og muliggør mere intuitive og omfattende interaktioner med AI. Begge modeller kan udføre handlinger som at zoome ind på detaljer eller rotere billeder for bedre at forstå dem. Denne multimodale fornuft er en betydelig forbedring over forgængere som o1, der primært var tekstbaserede. Den åbner nye muligheder for anvendelser i fag som uddannelse, hvor visuelle hjælpemidler er afgørende, og forskning, hvor diagrammer og grafer ofte er centrale for at forstå.
Avanceret værktøjsanvendelse
o3 og o4-mini er de første OpenAI-modeller, der anvender alle værktøjerne i ChatGPT samtidigt. Disse værktøjer omfatter:
- Web-browsing: Tillader modellerne at hente den seneste information til tidsfølsomme forespørgsler.
- Python-kodekørsel: Muliggør, at de kan udføre komplekse beregninger eller dataanalyse.
- Billedebehandling og -generering: Forbedrer deres evne til at arbejde med visuel data.
Ved at anvende disse værktøjer kan o3 og o4-mini løse komplekse, flertrinsproblemer mere effektivt. For eksempel, hvis en bruger stiller et spørgsmål, der kræver aktuel data, kan modellen udføre en web-søgning for at hente den seneste information. Ligesom, for opgaver, der involverer dataanalyse, kan den køre Python-kode for at bearbejde data. Denne integration er et betydeligt skridt mod mere autonome AI-agenter, der kan håndtere en bredere række opgaver uden menneskelig indgriben. Introduktionen af Codex CLI, en letvægts-, open-source-kodeagent, der arbejder med o3 og o4-mini, forbedrer yderligere deres nytte for udviklere.
Konsekvenser og nye muligheder
Udgivelsen af o3 og o4-mini har vidtrækkende konsekvenser på tværs af industrier:
- Uddannelse: Disse modeller kan hjælpe studerende og lærere ved at give detaljerede forklaringer og visuelle hjælpemidler, og gøre læring mere interaktiv og effektiv. For eksempel kunne en studerende uploade en skitse af et matematikproblem, og modellen kunne give en trin-for-trin-løsning.
- Forskning: De kan accelerere opdagelsen ved at analysere komplekse datasæt, generere hypoteser og fortolke visuel data som grafer og diagrammer, hvilket er uvurderligt for fag som fysik eller biologi.
- Industri: De kan optimere processer, forbedre beslutningstagning og forbedre kundeinteraktioner ved at håndtere både tekst- og visuelle forespørgsler, som f.eks. at analysere produkt-design eller fejlfinde tekniske problemer.
- Kreativitet og medier: Forfattere kan bruge disse modeller til at omdanne kapitelforklaringer til simple storyboard. Musikere kan matche visuelle effekter til en melodi. Filmredaktører modtager pacing-forslag. Arkitekter kan omdanne håndtegnede gulvplaner til detaljerede 3D-blåtryk, der inkluderer struktur- og bæredygtighedsnoter.
- Tilgængelighed og inklusion: For blinde brugere beskriver modellerne billeder i detaljer. For døve brugere konverterer de diagrammer til visuelle sekvenser eller undertekst. Deres oversættelse af både ord og visuelle hjælpemidler hjælper med at brokke gapet mellem sprog- og kulturelle forskelle.
- Mod autonome agenter: Fordi modellerne kan browse på webben, køre kode og bearbejde billeder i én arbejdsgang, danner de grundlag for autonome agenter. Udviklere beskriver en funktion; modellen skriver, tester og deployer koden. Videnarbejdere kan delegere dataindsamling, -analyse, -visualisering og rapportering til en enkelt AI-assistent.
Begrænsninger og hvad der kommer herefter
Trods disse fremskridt har o3 og o4-mini stadig en videnafskæring fra august 2023, hvilket begrænser deres evne til at svare på de seneste begivenheder eller teknologier, medmindre suppleret med web-browsing. Fremtidige iterationer vil sandsynligvis imødegå dette gap ved at forbedre realtidsdata-indtagelse.
Vi kan også forvente yderligere fremgang i autonome AI-agenter – systemer, der kan planlægge, tænke, handle og lære kontinuerligt med minimal overvågning. OpenAI’s integration af værktøjer, fornuftsmodeller og realtidsdataadgang signalerer, at vi er på vej mod sådanne systemer.
Sammenfatning
OpenAI’s nye modeller, o3 og o4-mini, tilbyder forbedringer i fornuft, multimodal forståelse og værktøjsintegration. De er mere nøjagtige, fleksible og nyttige på tværs af en bred række af opgaver – fra at analysere komplekse data og generere kode til at fortolke billeder. Disse fremskridt har potentialet til at betydeligt forbedre produktiviteten og accelerere innovation på tværs af forskellige industrier.





