
AI-modeller og platforme
OpenAIs GPT-4o: Den multimodale AI-model, der forandrer menneske-maskine-interaktionen

 Føj Unite.AI til dine foretrukne kilder på Google

NøglepunkterGPT-4o kombinerer for første gang tekst, lyd og billede naturligt i én model.
Vis mere
- GPT-4o kombinerer for første gang tekst, lyd og billede naturligt i én model.
- GPT-4o registrerer følelsesmæssige signaler og tilpasser sin tone for at svare med empati.
- OpenAI tilbyder GPT-4o's kernefunktioner gratis til alle brugere.
OpenAI har udgivet sin seneste og mest avancerede sprogmodel hidtil – GPT-4o, også kendt som “Omni“-modellen. Dette revolutionerende AI-system repræsenterer et kæmpe skridt fremad, med kapaciteter der udvisker grænsen mellem menneskelig og kunstig intelligens.
I hjertet af GPT-4o ligger dens native multimodale natur, der tillader den at ubesværet behandle og generere indhold på tværs af tekst, lyd, billeder og video. Denne integration af multiple modaliteter i en enkelt model er en første gang, og lover at forandre, hvordan vi interagerer med AI-assistenter.
Men GPT-4o er langt mere end bare en multimodal system. Den har en overvældende præstationsforbedring i forhold til sin forgænger, GPT-4, og efterlader konkurrerende modeller som Gemini 1.5 Pro, Claude 3 og Llama 3-70B i støvet. Lad os dykke dybere ind i, hvad der gør denne AI-model virkelig banebrydende.
Ubegrænset Præstation og Effektivitet
En af de mest imponerende aspekter af GPT-4o er dens ubesværet præstationskapaciteter. Ifølge OpenAIs evalueringer har modellen en bemærkelsesværdig 60 Elo-point føring over den tidligere top-performer, GPT-4 Turbo. Denne betydelige fordel placerer GPT-4o i en liga for sig selv, overgående selv de mest avancerede AI-modeller, der i øjeblikket er tilgængelige.
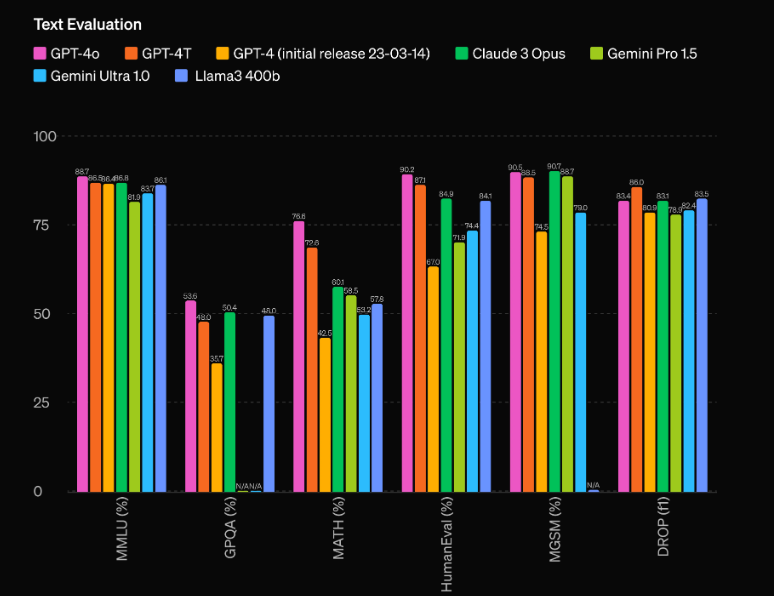
Men raw præstation er ikke det eneste område, hvor GPT-4o skinner. Modellen har også imponerende effektivitet, der opererer med dobbelt så stor hastighed som GPT-4 Turbo, mens den kun koster halvt så meget at køre. Denne kombination af overlegen præstation og omkostningseffektivitet gør GPT-4o til en ekstremt attraktiv mulighed for udviklere og virksomheder, der søger at integrere avancerede AI-kapaciteter i deres applikationer.
Multimodale Kapaciteter: Blænding af Tekst, Lyd og Syn
Måske den mest banebrydende aspekt af GPT-4o er dens native multimodale natur, der tillader den at ubesværet behandle og generere indhold på tværs af multiple modaliteter, herunder tekst, lyd og syn. Denne integration af multiple modaliteter i en enkelt model er en første gang, og lover at revolutionere, hvordan vi interagerer med AI-assistenter.
Med GPT-4o kan brugere engagere i naturlige, real-tids-samtaler ved hjælp af tale, med modellen, der øjeblikkeligt genkender og responderer til lyd-indtastninger. Men kapaciteterne stopper ikke der – GPT-4o kan også fortolke og generere visuelt indhold, åbner op for en verden af muligheder for applikationer, der spænder fra billedanalyse og -generering til video-forståelse og -skabelse.
En af de mest imponerende demonstrationer af GPT-4os multimodale kapaciteter er dens evne til at analysere en scene eller et billede i realtid, nøjagtigt beskrive og fortolke de visuelle elementer, den opfatter. Denne funktion har dybe implikationer for applikationer som assistive teknologier for synshandicappede, såvel som i felter som sikkerhed, overvågning og automatisering.
Men GPT-4os multimodale kapaciteter strækker sig ud over blot at forstå og generere indhold på tværs af forskellige modaliteter. Modellen kan også ubesværet blande disse modaliteter, skabe rigtigt immersive og engagerende oplevelser. For eksempel kunne GPT-4o under OpenAIs live-demo generere en sang baseret på input-forhold, blande sin forståelse af sprog, musikteori og lyd-generering i en kohærent og imponerende output.
Brug af GPT0 med Python
import openai
<p># Erstat med din faktiske API-nøgle
OPENAI_API_KEY = "din_openai_api_nøgle_her"</p>
<p># Funktion til at hente respons-indhold
def get_response_content(response_dict, exclude_tokens=None):
if exclude_tokens is None:
exclude_tokens = []</p>
<p> if response_dict and response_dict.get("choices") and len(response_dict["choices"]) > 0:
content = response_dict["choices"][0]["message"]["content"].strip()
if content:
for token in exclude_tokens:
content = content.replace(token, '')
return content</p>
<p> raise ValueError(f"Unable to resolve response: {response_dict}")</p>
<p># Asynkron funktion til at sende en anmodning til OpenAIs chat-API
async def send_openai_chat_request(prompt, model_name, temperature=0.0):
openai.api_key = OPENAI_API_KEY</p>
<p> message = {"role": "user", "content": prompt}
response = await openai.ChatCompletion.acreate(
model=model_name,
messages=[message],
temperature=temperature,
)</p>
<p> return get_response_content(response)</p>
<p># Eksempel på brug
async def main():
prompt = "Hej!"
model_name = "gpt-4o-2024-05-13"
response = await send_openai_chat_request(prompt, model_name)
print(response)</p>
<p>if __name__ == "__main__":
import asyncio
asyncio.run(main())</p>
Jeg har:
- Importeret openai-modulen direkte i stedet for at bruge en brugerdefineret klasse.
- Omdøbt openai_chat_resolve-funktionen til get_response_content og lavet nogle mindre ændringer i dens implementering.
- Erstattet AsyncOpenAI-klassen med openai.ChatCompletion.acreate-funktionen, som er den officielle asynkrone metode, der leveres af OpenAIs Python-bibliotek.
- Tilføjet et eksempel på en main-funktion, der demonstrerer, hvordan man kan bruge send_openai_chat_request-funktionen.
Vær opmærksom på, at du skal erstatte “din_openai_api_nøgle_her” med din faktiske OpenAI-API-nøgle for at koden skal fungere korrekt.


