
Andersons vinkel
GAN som ansigtsrenderer til ‘traditionel’ CGI

 Føj Unite.AI til dine foretrukne kilder på Google

NøglepunkterAt adskille identitet fra udtryk i GAN's latente rum forbliver den centrale uløste…
Vis mere
- At adskille identitet fra udtryk i GAN's latente rum forbliver den centrale uløste udfordring for syntese af ansigtsvideoer.
- Parametriske CGI-modeller som SMPL og 3DMM'er bruges i stigende grad til at påtvinge orden på GAN'ers uregerlige latente koder.
- Disneys hybride tilgang Rendering with Style producerede uhyggelige resultater ved at fusionere traditionelle teksturkort med GAN-genereret billedmateriale.
Kommentar Da Generative Adversarial Networks (GANs) først demonstrerede deres evne til at reproducere slående realistiske 3D-ansigter, udløste det en guldrush for den uudnyttede potentiale for GANs til at skabe tidsmæssigt konsistente videoer med menneskeansigter.
Et sted i GAN’s latente rum syntes der at måtte være skjult orden og rationalitet – et mønster af spirende semantisk logik, begravet i de latente koder, der ville tillade en GAN at generere konsistente flere visninger og fortolkninger (såsom udtryksændringer) af det samme ansigt – og herefter tilbyde en tidsmæssigt overbevisende deepfake video-metode, der ville overgå autoencodere markant.
Højopløselig udgang ville være trivialt i forhold til de lavopløselige miljøer, som GPU-begrænsninger tvinger DeepFaceLab og FaceSwap til at operere i, mens ‘swap-zonen’ af et ansigt (i autoencoder-arbejdsgange) ville blive ‘skabelseszonen’ af en GAN, informeret af et par inputbilleder eller endda kun ét enkelt billede.
Der ville ikke være nogen uoverensstemmelse længere mellem ‘swap’ og ‘host’-ansigter, fordi hele billedet ville blive genereret fra bunden, herunder hår, kæbepartier og de yderste udstrækninger af ansigtets linjeføring, som ofte viser sig at være en udfordring for ‘traditionelle’ autoencoder-deepfakes.
GAN-ansigtsvideo-vinteren
Det viste sig, at det ikke ville være nær så let. Til sidst viste disentanglement sig at være det centrale problem, og forbliver det primære udfordring. Hvordan kan man fastholde en distinkt ansigtsidentitet og ændre dens pose eller udtryk uden at samle en korpus af tusinder af referencebilleder, der lærer et neuralt netværk, hvad der sker, når disse ændringer udføres, på samme måde som autoencoder-systemer så omhyggeligt gør?
Senere tanker i ansigtsanimering med GAN og syntese-forskning var, at en input-identitet måske kunne gøres til genstand for teleologiske, generiske, skabelonbaserede transformationer, der ikke er specifikke for identiteten. Et eksempel på dette ville være at anvende et udtryk på et GAN-ansigt, der ikke var til stede i nogen af billederne af personen, som GAN kender til.

Fra 2022-studiet Tensor-based Emotion Editing in the StyleGAN Latent Space, anvendes skabelonbaserede udtryk på et input-ansigt fra FFHQ-datasættet. Kilde: https://arxiv.org/pdf/2205.06102.pdf
Det er åbenbart, at en ‘one size fits all’-tilgang ikke kan dække den mangfoldighed af ansigtsudtryk, der er unik for en person. Vi må undre os over, om et smil så unikt som det, Jack Nicholson eller Willem Dafoe har, nogensinde kunne modtage en trofast fortolkning under påvirkning af sådanne ‘gennemsnitsudtryks’-latente koder.

Hvem er denne charmerende latinske fremmed? Selvom GAN-metoden producerer et mere ‘realistisk’ og højopløseligt ansigt, er transformationen ikke informeret af multiple virkelige billeder af skuespilleren, som er tilfældet med DeepFaceLab, der træner omhyggeligt på en database med tusinder af sådanne billeder, og følgelig er ligheden kompromitteret. Her (baggrund) importeres et DeepFaceLab-model til DeepFaceLive, en streaming-implementation af det populære og kontroversielle software. Eksempler er fra https://www.youtube.com/watch?v=9tr35y-yQRY (2022) og https://arxiv.org/pdf/2205.06102.pdf.
Et antal GAN-ansigtsudtryksredigeringer er blevet foreslået over de sidste par år, de fleste af dem beskæftiger sig med ukendte identiteter, hvor troværdigheden af transformationerne er umulig for den almindelige læser at vide, da disse ikke er velkendte ansigter.

Ukendte identiteter transformeret i 2020-tilbuddet Cascade-EF-GAN. Kilde: https://arxiv.org/pdf/2003.05905.pdf
Måske er det GAN-ansigtsredigeringsværktøj, der har modtaget mest interesse (og citeringer) i de sidste tre år, InterFaceGAN, der kan udføre latente rum-gennemløb i latente koder relateret til pose (kamera-/ansigtsvinkel), udtryk, alder, race, køn og andre essentielle kvaliteter.
1980’er-stil ‘morphing’-funktionerne i InterFaceGAN og lignende rammer er primært en måde at illustrere vejene mod transformation, da et billede projiceres tilbage gennem en passende latent kode (såsom ‘alder’). I forhold til at producere videooptagelser med tidsmæssig kontinuitet, kvalificerer sådanne skemaer indtil videre som ‘imponerende katastrofer’.
Hvis man tilføjer dette, den sværhed ved at skabe tidsmæssigt konsistente hår, og det faktum, at teknikken med latent kode-eksploration/manipulation ikke har nogen indbyggede tidsmæssige retningslinjer at arbejde med (og det er svært at vide, hvordan man injicerer sådanne retningslinjer i en ramme, der er designet til at kunne generere og håndtere billeder, og som ikke har nogen indbygget understøttelse for video-udgang), kunne det være logisk at konkludere, at GAN ikke er Alt, du behøver ™ for ansigtsvideo-syntese.
Derfor har efterfølgende bestræbelser resulteret i inkrementelle forbedringer i disentanglement, mens andre har boltet på andre konventioner i computer-vision som et vejledningslag, såsom brugen af semantisk segmentering som en kontrol-mekanisme i en undersøgelse fra slutningen af 2021, studie SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
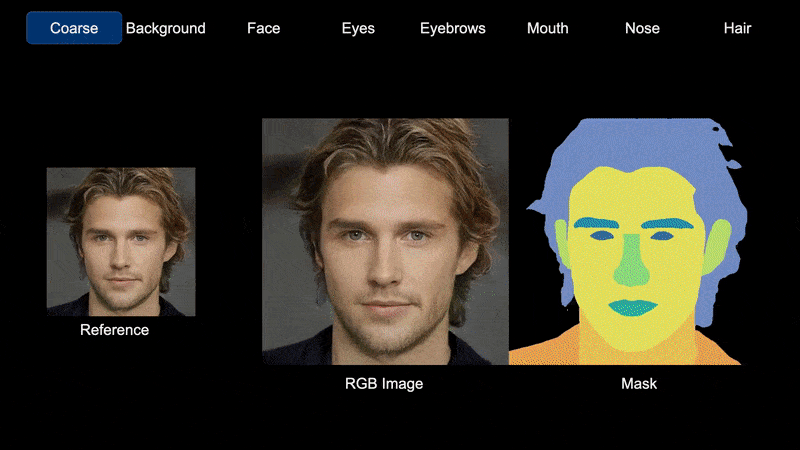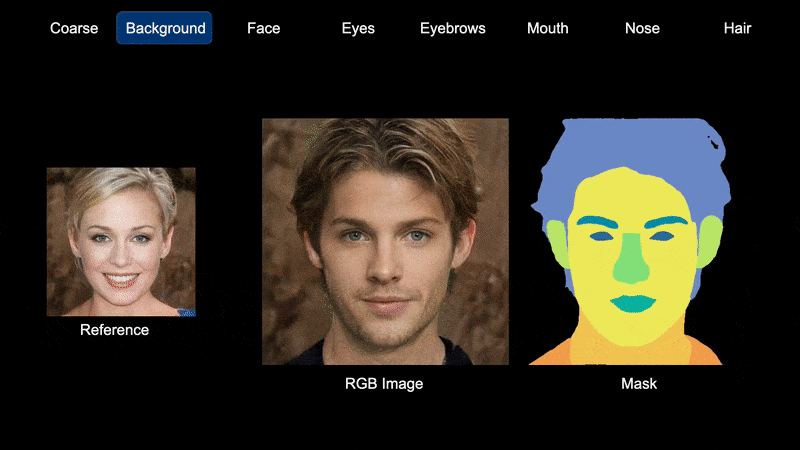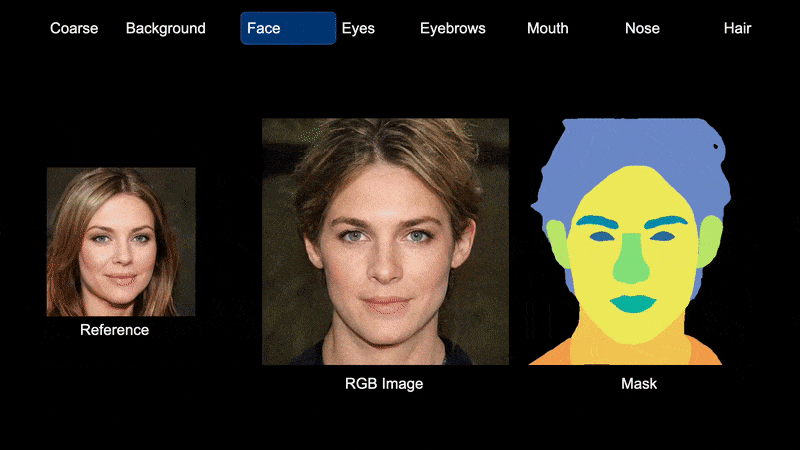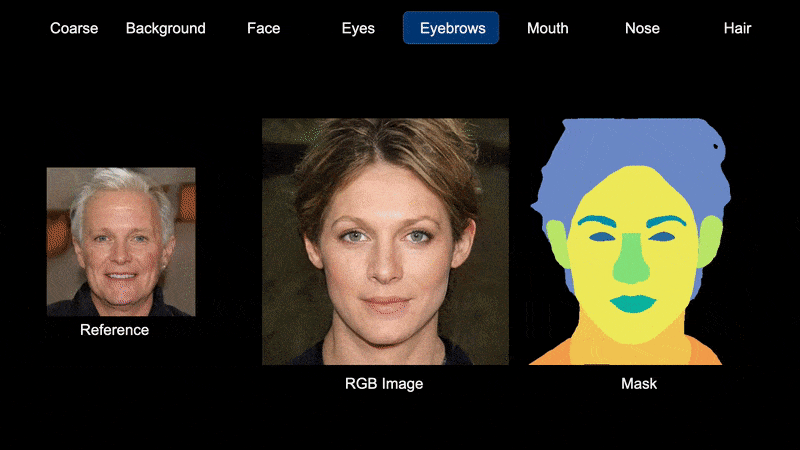
semantisk segmentering som en metode for styring af det latente rum i SemanticStyleGAN. Kilde: https://semanticstylegan.github.io/
Parametrisk vejledning
GAN-ansigts-syntese-forskningsfællesskabet er i stigende grad rettet mod at bruge ‘traditionelle’ parametrisk CGI-ansigter som en metode til at vejlede og bringe orden til de imponerende, men uregerlige latente koder i et GAN’s latente rum.
Selvom parametrisk ansigts-primitiver har været en fast del af computer-vision-forskning i over tyve år, er interessen for denne tilgang vokset, med den øgede brug af Skinned Multi-Person Linear Model (SMPL) CGI-primitiver, en tilgang, der blev grundlagt af Max Planck Institute og ILM, og siden forbedret med Sparse Trained Articulated Human Body Regressor (STAR)-rammen.

SMPL (i dette tilfælde en variant kaldet SMPL-X) kan påføre en CGI-parametrisk mesh, der er i overensstemmelse med den estimerede pose (herunder udtryk, hvis nødvendigt) af hele den menneskelige krop, der er fremhævet i et billede, og tillader nye operationer at blive udført på billedet ved hjælp af den parametrisk mesh som en volumetrisk eller perceptuel vejledning. Kilde: https://arxiv.org/pdf/1904.05866.pdf
Den mest anerkendte udvikling i denne linje har været Disneys 2019 Rendering with Style-initiativ, der kombinerede brugen af traditionelle tekstur-kort med GAN-genereret billedmateriale, i et forsøg på at skabe forbedret, ‘deepfake-stil’ animeret udgang.

Gammel møder ny i Disneys hybrid-tilgang til GAN-genererede deepfakes. Kilde: https://www.youtube.com/watch?v=TwpLqTmvqVk
Disney-tilgangen indsætter traditionelt renderede CGI-elementer i et StyleGAN2-netværk for at udfylde menneskeansigter i ‘problem-områder’, hvor tidsmæssig konsistens er et problem for video-generering – områder som hudtekstur.

Rendering with Style-workflow.
Siden parametrisk CGI-hoved, der vejleder denne proces, kan justeres og ændres efter behov, kan GAN-genereret ansigt reflektere disse ændringer, herunder ændringer af hovedpose og udtryk.
Selvom det er designet til at kombinere styringsmulighederne i CGI med den naturlige realisme af GAN-ansigter, viser resultaterne til sidst det værste af begge verdener og fejler stadig i at holde hårtekstur og selv grundlæggende træk-positionering konsistent:
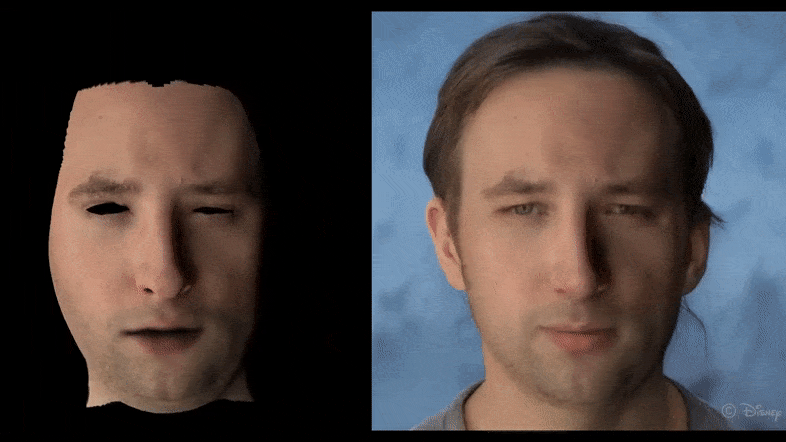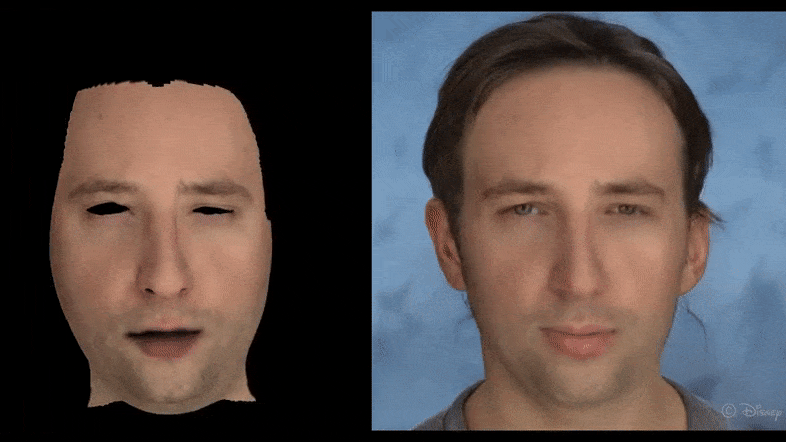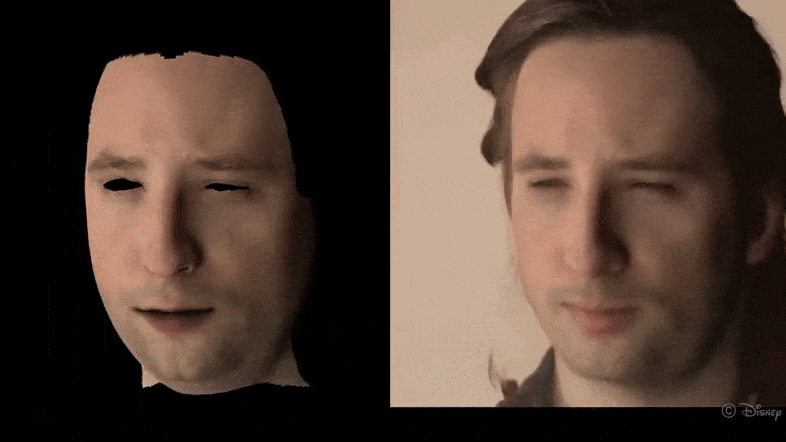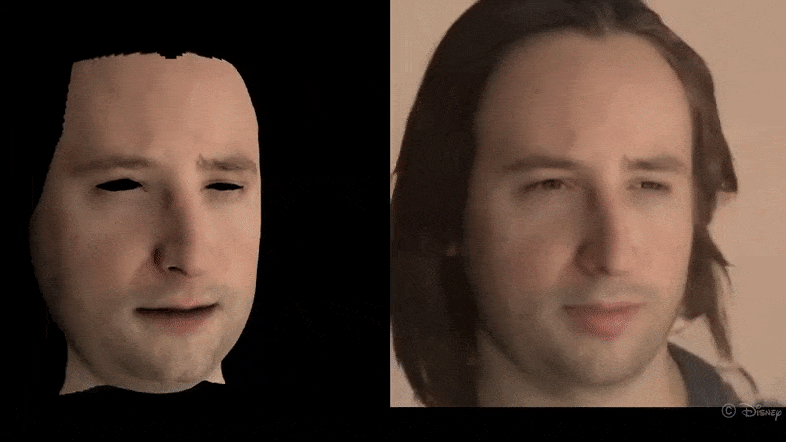
En ny type uncanny valley opstår fra Rendering with Style, selvom principperne stadig har nogen potentiale.
2020-papiret StyleRig: Rigging StyleGAN for 3D Control over Portrait Images tager en stadig mere populær tilgang, med brugen af tredimensionale formbare ansigtsmodeller (3DMMs) som proxier for ændring af egenskaber i et StyleGAN-miljø, i dette tilfælde gennem et nyt rigging-netværk kaldet RigNet:

3DMMs fungerer som proxier for latent rum-fortolkninger i StyleRig. Kilde: https://arxiv.org/pdf/2004.00121.pdf
Men som sædvanligt med disse initiativer, synes resultaterne indtil videre at være begrænset til minimale pose-manipulationer og udtryks- og følelsesændringer uden relevant vejledning.

StyleRig forbedrer niveauet af kontrol, selvom tidsmæssigt konsistent hår stadig er en uløst udfordring. Kilde: https://www.youtube.com/watch?v=eaW_P85wQ9k
Lignende output kan findes fra Mitsubishi Research’s MOST-GAN, en 2021 studie, der bruger ikke-lineære 3DMMs som en disentanglement-arkitektur, men som også kæmper for at opnå dynamisk og konsistent bevægelse.
Den seneste forskning, der forsøger at opnå styring og adskillelse af faktorer, er One-Shot Face Reenactment on Megapixels, der igen bruger 3DMM-parametrisk hoveder som en venlig interface for StyleGAN.

I MegaFR-workflowet af One-Shot Face Reenactment udfører netværket ansigtssyntese ved at kombinere et virkeligt billede, der er inverteret til en latent repræsentation med parametre taget fra en renderet 3DMM-model. Kilde: https://arxiv.org/pdf/2205.13368.pdf
OSFR tilhører en voksende klasse af GAN-ansigtsredigeringer, der søger at udvikle Photoshop/After Effects-lignende lineære redigerings-workflows, hvor brugeren kan indtaste et ønsket billede, som transformationer kan anvendes på, i stedet for at lede efter latent rum-koder, der relaterer til en identitet.
Igen repræsenterer parametrisk udtryk en overordnet og upersonlig metode til at injicere udtryk, hvilket fører til manipulationer, der virker uhyggelige på deres egen, ikke altid positive måde.

Injiceret udtryk i OSFR.
Ligesom tidligere arbejde kan OSFR udlede en positur tæt på den oprindelige fra et enkelt billede og også udføre ‘frontalization’, hvor et billede af et skævt vendt ansigt omdannes til et frontalt portræt:

Original (øverst) og udledte frontale portrætter fra en af implementeringerne af OSFR detaljeret i det nye papir.
I praksis ligner denne type inferens nogen af de fotogrammetriske principper, der ligger til grund for Neural Radiance Fields (NeRF), bortset fra at geometrien her skal defineres af et enkelt billede, i stedet for de 3-4 synspunkter, der tillader NeRF at fortolke de manglende mellemliggende positurer og skabe udforskelige neurale 3D-scener med mennesker.
(Dog er NeRF heller ikke Alt, du behøver ™, da det har en næsten fuldstændig anden sæt udfordringer i forhold til GANs, når det kommer til at producere ansigtsvideo-syntese)
Har GAN en plads i ansigtsvideo-syntese?
At opnå dynamiske udtryk og positurer uden for træningsfordelingen fra et enkelt kilde-billede synes at være en alkemisk besættelse i GAN-ansigts-syntese-forskning lige nu, primært fordi GANs er den eneste metode, der i øjeblikket kan producere ret højopløselige og relativt høj-fidelitets neurale ansigter: selvom autoencoder-deepfake-rammer kan træne på en mængde virkelige pose og udtryk, må de operere på VRAM-begrænsede input/output-opløsninger og kræver en ‘host’; mens NeRF er lignende begrænset og – i modsætning til de to andre tilgange – har ingen etablerede metoder til at ændre ansigtsudtryk og lider af begrænset redigérbarhed i det hele taget.
Det synes, at den eneste vej frem for et præcist CGI/GAN-ansigts-syntese-system er for et nyt initiativ at finde en måde at samle en multi-billede-identitetsenhed inden for det latente rum, hvor en latent kode for en persons identitet ikke behøver at rejse hele vejen over det latente rum for at udnytte uvedkommende positurparametre, men kan henvise til sine egne relaterede (virkelige) billeder som referencer for transformationer.
Selv i et sådant tilfælde, eller selv hvis et helt StyleGAN-netværk blev trænet på et enkelt-identitets ansigts-sæt (ligesom trænings-sættene, som autoencodere bruger), ville den manglende semantiske logik sandsynligvis stadig behøve at blive leveret af hjælpeteknologier såsom semantisk segmentering eller parametrisk 3DMM-ansigter, der i sådant tilfælde ville have mere materiale at arbejde med.


