AI-modeller og platforme
Kodindlejring: En Omfattende Guide

 Føj Unite.AI til dine foretrukne kilder på Google

Kodindlejring er en transformerende måde at repræsentere kodefragmenter som tætte vektorer i et kontinuert rum. Disse indlejringer fanger de semantiske og funktionelle relationer mellem kodefragmenter, hvilket muliggør kraftfulde anvendelser i AI-assisteret programmering. Ligesom ordindlejring i naturlig sprogbehandling (NLP) placerer kodeindlejring lignende kodefragmenter tæt sammen i vektorrummet, hvilket giver maskinerne mulighed for at forstå og manipulere kode mere effektivt.
Hvad er Kodindlejring?
Kodindlejring konverterer komplekse kodestrukturer til numeriske vektorer, der fanger mening og funktionalitet af koden. I modsætning til traditionelle metoder, der behandler kode som sekvenser af karakterer, fanger indlejringerne de semantiske relationer mellem dele af koden. Dette er afgørende for forskellige AI-drevne software-ingeniørtasks, såsom kode-søgning, afslutning, fejlfinding og mere.
For eksempel, overvej disse to Python-funktioner:
def add_numbers(a, b):
return a + b
<p>def sum_two_values(x, y):
result = x + y
return result</p>
Disse funktioner ser syntaktisk forskellige ud, men udfører den samme operation. En god kodeindlejring ville repræsentere disse to funktioner med lignende vektorer, der fanger deres funktionelle lighed trods deres tekstlige forskelle.

Vektor-indlejring
Hvordan skabes Kodindlejring?
Der er forskellige teknikker til at skabe kodeindlejring. En almindelig tilgang indebærer brug af neurale netværk til at lære disse repræsentationer fra en stor dataset af kode. Netværket analyserer kodestrukturen, herunder tokens (nøgleord, identifikatorer), syntaks (hvordan koden er struktureret) og muligvis kommentarer for at lære relationerne mellem forskellige kodefragmenter.
Lad os bryde processen ned:
- Kode som en Sekvens: Først behandles kodefragmenter som sekvenser af tokens (variable, nøgleord, operatorer).
- Neuralt Netværkstræning: Et neuralt netværk behandler disse sekvenser og lærer at tilknytte dem faste vektorrepræsentationer. Netværket tager hensyn til faktorer som syntaks, semantik og relationer mellem kodeelementer.
- Fangning af Ligheder: Træningen sigter mod at placere lignende kodefragmenter (med lignende funktionalitet) tæt sammen i vektorrummet. Dette giver mulighed for opgaver som at finde lignende kode eller sammenligne funktionalitet.
Her er et forenklet Python-eksempel på, hvordan du kan forarbejde kode til indlejring:
import ast

<p>def tokenize_code(code_string):
tree = ast.parse(code_string)
tokens = []
for node in ast.walk(tree):
if isinstance(node, ast.Name):
tokens.append(node.id)
elif isinstance(node, ast.Str):
tokens.append('STRING')
elif isinstance(node, ast.Num):
tokens.append('NUMBER')
# Tilføj flere nodetyper efter behov
return tokens</p>

<p># Eksempelbrug
code = """
def greet(name):
print("Hej, " + name + "!")
"""

<p>tokens = tokenize_code(code)
print(tokens)
# Output: ['def', 'greet', 'name', 'print', 'STRING', 'name', 'STRING']</p>
Denne tokeniserede repræsentation kan derefter indføres i et neuralt netværk til indlejring.
Eksisterende Tilgange til Kodindlejring
Eksisterende metoder til kodeindlejring kan klassificeres i tre hovedkategorier:
Token-baserede Metoder
Token-baserede metoder behandler kode som en sekvens af leksikale tokens. Teknikker som Term Frequency-Inverse Document Frequency (TF-IDF) og dybe læringsmodeller som CodeBERT falder i denne kategori.
Træ-baserede Metoder
Træ-baserede metoder parser kode til abstrakte syntaks-træer (AST) eller andre træ-strukturer, der fanger syntaks og semantik af koden. Eksempler inkluderer træ-baserede neurale netværk og modeller som code2vec og ASTNN.
Graf-baserede Metoder
Graf-baserede metoder konstruerer grafer fra kode, såsom kontrol-flow-grafer (CFG) og data-flow-grafer (DFG), for at repræsentere den dynamiske adfærd og afhængigheder af koden. GraphCodeBERT er et bemærkelsesværdigt eksempel.
TransformCode: Et Rammeværk for Kodindlejring
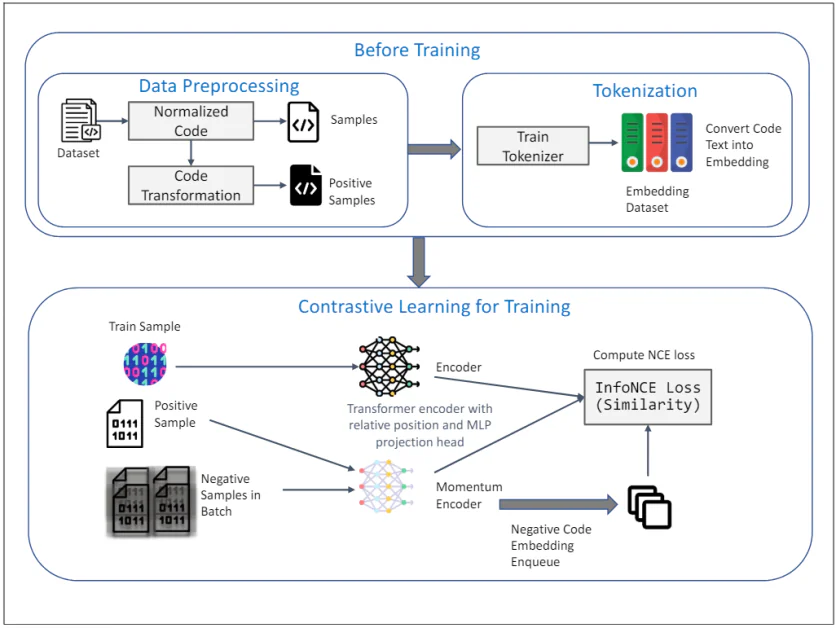
TransformCode: Usuperviseret læring af kodeindlejring
TransformCode er et rammeværk, der adresserer begrænsningerne af eksisterende metoder ved at lære kodeindlejring i en kontrastiv læringsmåde. Det er encoder-agnostisk og sprog-agnostisk, hvilket betyder, at det kan udnytte enhver encoder-model og håndtere ethvert programmeringssprog.
Diagrammet ovenfor illustrerer rammeværket for TransformCode til usuperviseret læring af kodeindlejring ved hjælp af kontrastiv læring. Det består af to hovedfaser: Før Træning og Kontrastiv Læring til Træning. Her er en detaljeret forklaring af hver komponent:
Før Træning
1. Dataforarbejdning:
- Dataset: Den indledende input er et dataset, der indeholder kodefragmenter.
- Normaliseret Kode: Kodefragmenterne undergår normalisering for at fjerne kommentarer og omdøbe variable til en standardformat. Dette hjælper med at reducere indflydelsen af variabelnavne på læringen og forbedrer modellens generaliserbarhed.
- Kode-transformation: Den normaliserede kode omformes derefter ved hjælp af forskellige syntaktiske og semantiske transformationer for at generere positive eksempler. Disse transformationer sikrer, at den semantiske betydning af koden forbliver uændret, hvilket giver diverse og robuste eksempler til kontrastiv læring.
2. Tokenisering:
- Træn Tokenizer: En tokenizer trænes på kodedatasettet for at konvertere kode-tekst til indlejring. Dette indebærer at bryde koden ned i mindre enheder, såsom tokens, der kan behandles af modellen.
- Indlejring-dataset: Den trænede tokenizer bruges til at konvertere det hele kodedataset til indlejring, der fungerer som input for den kontrastive læringsfase.
Kontrastiv Læring til Træning
3. Træningsprocessen:
- Træn-eksempel: Et eksempel fra træningsdatasettet vælges som forespørgselskoderepræsentationen.
- Positivt Eksempel: Det positive eksempel er den transformerende version af forespørgselskoden, der er erhvervet under dataforarbejdningen.
- Negative Eksempler i Batch: Negative eksempler er alle andre kodeeksempler i den aktuelle mini-batch, der er forskellige fra det positive eksempel.
4. Encoder og Momentum-encoder:
- Transformer-encoder med Relativ Position og MLP-projektionshoved: Såvel forespørgsels- som positive eksempler indføres i en Transformer-encoder. Encoderen inkorporerer relativ positionskodning for at fange syntaks og relationer mellem tokens i koden. En MLP (Multi-Layer Perceptron)-projektionshoved bruges til at afbilde de encodede repræsentationer til et lavere-dimensionalt rum, hvor det kontrastive læringsmål anvendes.
- Momentum-encoder: En momentum-encoder bruges også, der opdateres ved en flydende gennemsnit af forespørgsels-encodernes parametre. Dette hjælper med at opretholde konsistensen og diversiteten af repræsentationerne, og forhindrer kollapsen af det kontrastive tab.
5. Kontrastiv Læringsmål:
- Beregn InfoNCE-tab (Lighed): InfoNCE (Noise Contrastive Estimation)-taben beregnes for at maksimere ligheden mellem forespørgsels- og positive eksempler, mens den minimerer ligheden mellem forespørgsels- og negative eksempler. Dette mål sikrer, at de lærede indlejring er diskriminerende og robuste, og fanger den semantiske lighed af kodefragmenterne.
Hele rammeværket udnytter styrken af kontrastiv læring til at lære meningsfulde og robuste kodeindlejring fra uannoteret data. Brugen af AST-transformationer og en momentum-encoder forbedrer yderligere kvaliteten og effektiviteten af de lærede repræsentationer, hvilket gør TransformCode til et kraftfuldt værktøj til forskellige software-ingeniørtasks.
Nøglefunktioner af TransformCode
- Fleksibilitet og Tilpasningsevne: Kan udvides til forskellige downstream-opgaver, der kræver kode-repræsentation.
- Effektivitet og Skalerbarhed: Kræver ikke en stor model eller omfattende træningsdata, og kan håndtere ethvert programmeringssprog.
- Usuperviseret og Superviseret Læring: Kan anvendes til både usuperviseret og superviseret læring ved at inkorporere opgave-specifikke mærker eller mål.
- Justerbare Parametre: Antallet af encoder-parametre kan justeres baseret på tilgængelige beregningsressourcer.
TransformCode introducerer en data-forstærkningsteknik kaldet AST-transformation, der anvender syntaktiske og semantiske transformationer til de originale kodefragmenter. Dette genererer diverse og robuste eksempler til kontrastiv læring.
Anvendelser af Kodindlejring
Kodindlejring har revolutioneret forskellige aspekter af software-ingeniørarbejde ved at transformere kode fra en tekstformat til en numerisk repræsentation, der kan bruges af maskinelæringsmodeller. Her er nogle nøgleanvendelser:
Forbedret Kode-søgning
Traditionelt afhang kode-søgning af nøgleords-matching, der ofte resulterede i irrelevante resultater. Kodindlejring muliggør semantisk søgning, hvor kodefragmenter rangeres efter deres lighed i funktionalitet, selvom de bruger forskellige nøgleord. Dette forbedrer betydeligt nøjagtigheden og effektiviteten af at finde relevant kode inden for store kodebasers.
Smartere Kode-afslutning
Kode-afslutningsværktøjer foreslår relevante kodefragmenter baseret på den aktuelle kontekst. Ved at udnytte kodeindlejring kan disse værktøjer give mere præcise og nyttige forslag ved at forstå den semantiske betydning af koden, der skrives. Dette oversætter sig til hurtigere og mere produktive kodningsoplevelser.
Automatiseret Kode-korrektion og Fejl-detection
Kodindlejring kan bruges til at identificere mønstre, der ofte indikerer fejl eller ineffektiviteter i koden. Ved at analysere ligheden mellem kodefragmenter og kendte fejl-mønstre kan disse systemer automatisk foreslå rettelser eller højligte områder, der måske kræver yderligere inspektion.
Forbedret Kode-sammenfattelse og Dokument-generering
Store kodebasers mangler ofte ordentlig dokumentation, hvilket gør det svært for nye udviklere at forstå deres funktionsmåde. Kodindlejring kan skabe korte sammenfattelser, der fanger essensen af kodens funktionalitet. Dette forbedrer ikke kun kode-maintainability, men også vidensoverførsel inden for udviklingsteams.
Forbedret Kode-gennemgang
Kode-gennemgang er afgørende for at opretholde kodekvalitet. Kodindlejring kan hjælpe gennemgangere med at højligte potentielle problemer og foreslå forbedringer. Desuden kan de faciliterer sammenligninger mellem forskellige kodeversioner, hvilket gør gennemgangsprocessen mere effektiv.
Cross-Lingual Kode-behandling
Verden af software-udvikling er ikke begrænset til ét programmeringssprog. Kodindlejring har potentiale til at faciliterer cross-lingual kode-behandlingsopgaver. Ved at fange de semantiske relationer mellem kode skrevet i forskellige sprog kan disse teknikker muliggøre opgaver som kode-søgning og -analyse på tværs af programmeringssprog.