
Tankeledere
AI-skrevet kode har ændret, hvad SAST skal fange

 Føj Unite.AI til dine foretrukne kilder på Google
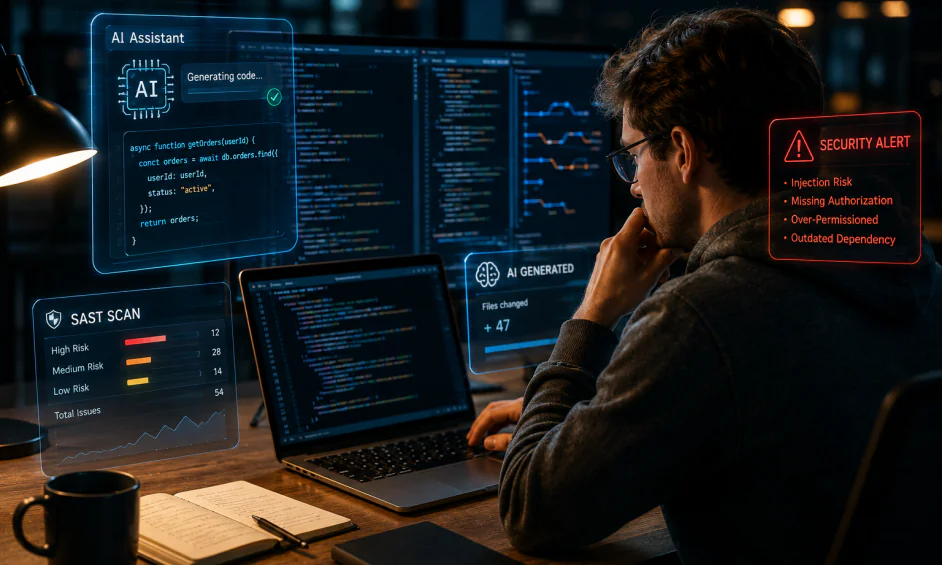
At se en AI-kodningsassistent producere en fungerende funktion på få sekunder kan føles som et gennembrud. Koden compilerer. Testene passerer. Pull-forespørgslen ser ren ud. For udviklingsteams under pres for at levere hurtigere, føles det som fremskridt.
Men funktionsdygtig kode og sikker kode er ikke det samme.
AI-genereret kode har ændret formen på software-risiko. Problemet er ikke blot, at store sprogmodeller skriver “dårlig” kode. I mange tilfælde skriver de kode, der ser poleret ud, følger en velkendt ramme-mønster og løser den anmodede opgave. Problemet er mere subtilt: Koden kan være funktionelt korrekt, mens den stadig er usikker, forældet, over-tilgivet eller kontekstligt forkert.
Dette forskel er vigtig, fordi statisk applikations-sikkerhedstest, eller SAST, var bygget til en verden, hvor udviklere skrev kode i menneske-tempo, og sikkerhedsteams gennemgik forudsigelige mønstre af risiko. AI har ændret begge sider af denne ligning. Kode-volumen stiger, commits bliver mindre, og usikre mønstre kan nu genereres i stor skala.
Resultatet er et nyt spørgsmål for software-team: Hvad skal SAST fange, når forfatteren af koden ikke nødvendigvis er menneskelig?
Funktionerende kode er ikke længere et stærkt signal
I årevis har software-team brugt en omtrentlig hierarki af tillid. Hvis koden compilerer, passerer testene og overlever peer-review, bevæger den sig nærmere produktion. Sikkerhedsskanning tilføjede endnu en lag, men funktionalitet forblev den første port.
AI-kodningsassistenter forstyrer denne hierarki, fordi de er særligt gode til at producere kode, der ser fuldstændig ud. De kan slutte boilerplate, tilslutte API’er, generere fejlhåndtering og matche stil med en eksisterende repository. Dette gør dem nyttige, men det gør også deres fejl sværere at spotte.
En menneskelig reviewer kan skimme en AI-skrevet funktion og tænke: “Dette ser normalt ud.” Det er netop risikoen. Mange AI-genererede sårbarheder er ikke eksotiske. De er velkendte problemer som indsprøjtningssvagheder, svag validering, usikre standarder, usikker deserialisering, log-problemer og forældede afhængighedsvalg.
Seneste forskning har gjort denne spænding sværere at ignorere. Veracodes Forår 2026 GenAI Code Security Update fandt for eksempel, at AI-kodningsmodeller var blevet langt stærkere til at producere syntaktisk korrekt kode end sikker kode. Med andre ord, AI bliver meget god til at skrive software, der fungerer, men det betyder ikke, at det bliver lige så godt til at skrive software, der kan betrodes.
Udgangen kan se produktionssikker ud, men den underliggende risiko kan være helt anderledes.
Den gamle SAST-model var bygget til menneskelige flaskeshals
Traditionel SAST har altid haft en svær opgave. Den scanner kildekode, mapper mønstre til kendte svagheder og alarmerer team før sårbar kode sendes. I en konventionel udviklingscyklus skaber det allerede friktion: for mange alarmer, for mange falske positiver og ikke nok tid til at afhjælpe alt.
AI gør dette sværere ved at fjerne en af de skjulte begrænsninger i software-udvikling: menneske-tempo.
Når en AI-assistent kan generere en tjeneste, testfil, API-integration og konfigurations-udsnit i en session, kan sikkerheds-gennemgang ikke stole på de samme antagelser. Risikoen er ikke en enkelt uforsigtig linje kode. Det er multiplikationen af plausibel kode på dusinvis af filer, hver med små beslutninger, som modellen har truffet på vegne af teamet.
Dette er, hvor moderne SAST-værktøjer behøver at udvikle sig. De kan ikke blot scanne efter kendte sårbarheds-signaturer efter en pull-anmodning er næsten fuldført. De behøver at operere tættere på udvikler-arbejdsgangen, forstå AI-assisterede ændringsmønstre og hjælpe team med at skille harmløs automatisering fra risikabel automatisering.
AI introducerer sikkerheds-gæld i maskine-tempo
Teknisk gæld er ikke ny. Sikkerheds-gæld er den farligere fætter: den akkumulerer, når sårbarheder, svage antagelser og risikable genveje forbliver i kodebasen, fordi de ikke er presserende nok at afhjælpe i dag.
AI kan accelerere denne proces.
En udvikler kan bede en assistent om at “tilføje godkendelse”, “rense denne indtastning” eller “tilslutte denne slutpunkt til databasen”. Modellen vil normalt producere et svar. Men hvis prompten ikke indeholder de rigtige sikkerheds-begrænsninger, kan svaret måske afhænge af forældede praksisser, ufuldstændig validering eller usikre standarder. Værre, det kan være godt nok til at passere en casual gennemgang.
Der er flere AI-specifikke mønstre, som SAST nu behøver at genkende:
- Sikkerhedslignende boilerplate: AI producerer ofte kode, der ligner bedste praksis, men mangler en vigtig kontrol, som f.eks. godkendelseskontrol eller output-kodning.
- Forældede afhængighedsantagelser: En model kan foreslå biblioteker, versioner eller API’er baseret på mønstre, der var almindelige i dens træningsdata, men ikke længere anbefales.
- Kontekstfrie rettelser: AI kan lave den lokale symptom uden at forstå den bredere applikationsflow, hvilket skaber sikkerheds-gapper andre steder.
- Gentagne sårbare skabeloner: Hvis samme prompt producerer samme fejlfulde mønster på tværs af multiple repositories, kan en enkelt svaghed stille og roligt sprede sig gennem en organisation.
Dette handler ikke blot om at finde dårlig kode. Det handler om at registrere, når kode blev produceret uden tilstrækkelig kontekst.
SAST behøver at forstå intention, ikke blot syntaks
Næste generation af SAST behøver at gå ud over simpel mønster-matching. Kendte sårbarheds-mønstre er stadig vigtige, og mange grundlæggende fejl skal fanges automatisk. Men AI-skrevet kode sætter standarden højere, fordi syntaks alene sjældent fortæller hele historien.
Overvej en slutpunkt, der henter kundeoptegnelser. Koden kan bruge parameteriserede forespørgsler, håndtere fejl korrekt og passere standard-injektionskontrol. Men gør den godkendelses-adskillelse? Gør den validerer, om den nuværende bruger har tilladelse til at få adgang til den anmodede optegnelse? Gør den logge følsomme data?
Dette spørgsmål rejser også en privatlivsspørgsmål: Hvis AI-genereret logik ændrer, hvad applikationen gemmer, logger eller afslører, behøver team at forstå dens app-data-indsamling som en del af sikkerheds-gennemgangen.
Dette er ikke altid syntaks-problemer. Det er intention-problemer.
SAST behøver mere bevidsthed om forretningslogik, data-flow, ramme-konventioner og forholdet mellem en ændring og resten af applikationen. Målet er ikke at gøre SAST “AI-drevet” til marketing-formål. Målet er at gøre det kontekst-bevidst nok til at fange den type fejl, som AI er sandsynlig at begå.
Udviklere behøver stadig at lære sikkerhed, blot på en anden måde
Bedre værktøjer vil hjælpe, men de vil ikke fjerne menneskelig ansvar. AI-kodningsassistenter gør udviklere mere produktive, men de gør det også lettere for team at acceptere kode, de ikke fuldstændigt forstår.
Dette skaber en træningsudfordring. Traditionel årlig sikkerhedstræning er for langsom og for løsrevet fra daglig arbejde. Udviklere behøver korte, praktiske lektioner leveret nær det øjeblik, de træffer beslutninger. Dette er, hvor microlearning bliver relevant: små, fokuserede læringsøjeblikke kan forstærke sikker kodningsskikke uden at trække ingeniører ud af deres arbejdsgang i timer.
Den bedste sikkerhedsuddannelse i AI-kodningstiden vil se mindre ud som en klasse og mere som en vel-timed forklaring inde i en pull-anmodning, en IDE-advarsel, der underviser i stedet for at genere, eller en kort afhjælpningsnote, der forklarer, hvorfor en AI-genereret mønster er risikabelt.
Gennemgangsprocessen må ændre sig
Kode-gennemgang brugte at besvare velkendte spørgsmål: Er koden læselig? Løser den problemet? Ødelægger den noget?
AI-skrevet kode tilføjer nye spørgsmål. Var prompten sikkerheds-bevidst? Introducerede modellen en afhængighed? Kopierede den et mønster fra andre steder i repository uden at forstå, hvorfor mønsteret fandtes? Validerede udvikleren logikken eller kun udgangen?
Dette betyder ikke, at hver AI-assisteret commit behøver en digital forensisk undersøgelse. Men team behøver en let måde at identificere høj-risiko AI-genererede ændringer på. Godkendelse, autorisation, kryptering, betalingsflow, fil-overførsel, database-adgang, logging og infrastruktur-konfiguration fortjener mere skærpede blikke end UI-kopiering eller test-skeletter.
Bottom Line
AI gør ikke SAST irrelevant. Det gør SAST mere vigtigt.
Som kode-generering bliver hurtigere og mere dybt integreret i udviklingsmiljøer, holder den gamle antagelse, at usikker kode kommer langsomt gennem menneskehænder, ikke længere. AI kan generere nyttig software, men det kan også skala svage mønstre, forældede antagelser og kontekst-frie rettelser hurtigere, end traditionelle gennemgangsprocesser kan absorbere.
Vinderne vil ikke være team, der forbyder AI-kodningsværktøjer. Vinderne vil være team, der genopbygger deres sikkerheds-arbejdsgange omkring den nye virkelighed: Kode kan genereres øjeblikkeligt, men tillid skal stadig tjenes.
SAST skal nu fange mere end blot syntaks-fejl. Det skal fange manglende intention, usikker kontekst, gentagne AI-mønstre og sikkerheds-gæld, før det akkumulerer.


