
Andersons vinkel
En Maskinlæringsmodel Til At OmSkrive En Artikel, Mens Du Læser Den

 Føj Unite.AI til dine foretrukne kilder på Google
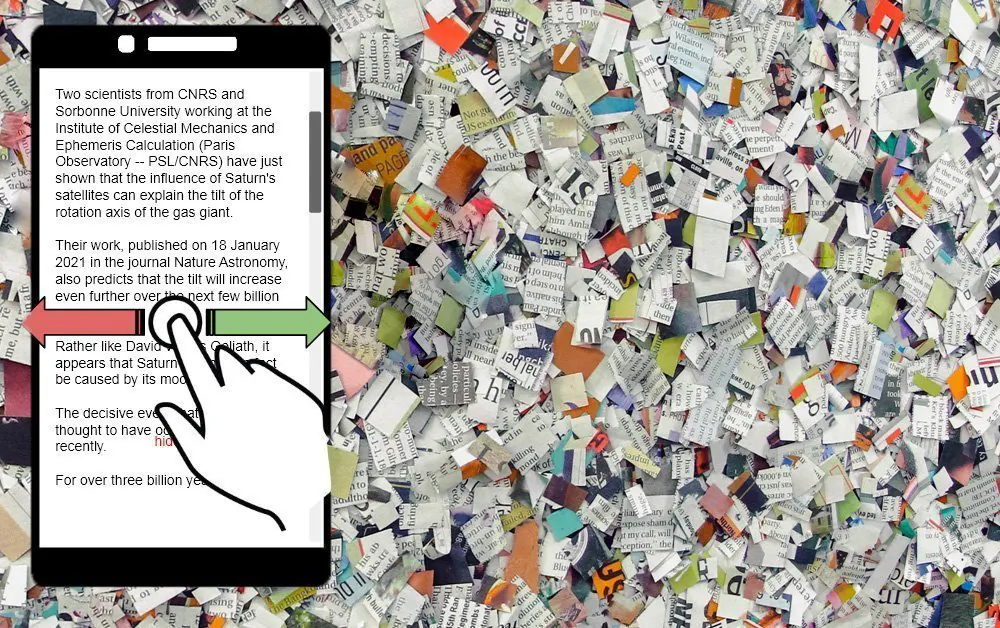
Nyt forskning fra Canada foreslår en metode til automatisk at omskrive en artikel, mens du læser den, baseret på Tinder-lignende ‘swiping’ eller på passiv observation af læserens interaktion med de forskellige typer af indhold, som artiklen indeholder.
Systemet, med titlen Hone As You Read (HARE), præsenteres i en rapport fra Western University i Ontario, Canada, med tilhørende Python-kode på GitHub.
Det centrale idé bag projektet er, at en artikel kan indeholde forskellige typer af indhold, der udvikler sig (ligesom denne) fra overskriften ned til yderligere detaljer. Senere dele af en artikel kan indeholde forskellige typer af støtte materiale, brugs eksempler, eller hypoteser eller formodninger om nyhedens konsekvenser.
Under HARE, hvis du ikke kan lide den type materiale, kan du stemme det væk på en paragraf-for-paragraf-basis, mens systemet lærer dine præferencer, således at når du ruller ned, er indhold, der ligner det materiale, du ‘nedstemte’, allerede blevet fjernet eller omskrevet. Hvis du ikke ønsker at deltage aktivt i at træne systemet, kan HARE slutte dine valg ud fra din passive interaktion med dokumentet.
Tinder-Style Afstemning For Misligende Sætninger
I billedet nedenfor ser vi tre mulige typer af indledt kategorisering for HARE, baseret på brugerens eksplisitte eller implicit adfærd. I det første tilfælde (venstre), stemmer brugeren aktivt ’til venstre’ (eller højre), i en Tinder-lignende afstemningsgestus, der udtrykker godkendelse eller misfornøjelse med indholdet af paragraffen eller sætningen, eller i dens stil, kompleksitet eller tone.

Kilde: https://arxiv.org/pdf/2105.02923.pdf
I det andet tilfælde (midten), bruger systemet opholds tid som en målestok for brugerens interesse, baseret på positionering og varighed af rulle pause.
I det tredje tilfælde (højre), bruger HARE smartphone-kameraet til at estimere banen og opholdstiden for brugerens blik på tværs af paragrafferne i det synlige dokument.
Forskerne hævder, at øget opholdstid på en given paragraf kan indikere øget bruger interesse, selvom dette logisk ikke behøver at være tilfældet, hvor brugeren forsøger at assimilere tekst, der kan være kompliceret eller bare dårligt skrevet.

Brugerfeedback redigerer, omskriver eller sletter helt usete dele af artiklen.
Forbehandling Af Indhold Til Brugerens Præferencer
Rapporten omhandler brugerens oplevelse af HARE på en per-artikel-basis, men det er tydeligt, at brugerens historiske interaktion med dokumenter tillader tilpasse af fremtidige læseoplevelser, ved at konsekvent genkende typer af indhold og anvende skabeloner af brugerpræferencer til nye artikler, således at behovet for interaktion mindskes, når brugeren ser mindre og mindre ‘uønsket’ indhold.
HARE karakteriseres som en sammenfatningsalgoritme, der tillader, at usete indhold længere nede på siden kan omskrives i stil eller koncision, før brugeren når dertil; men rapporten gør klart, at det også kan forhindre, at indhold fjernes på basis af brugerfeedback.
Til testformål brugte systemet en korpus af 11.222 artikler fra Storbritanniens Daily Mail avis, og blev evaluueret via en testudgivelse på Telegram-chatappen. Artikler med færre end ti paragraffer blev afvist til testformål.

Telegram HARE-appen i en testfase med brugere.
Forskerne anvender K-Means clustering på SBERT sætningsembeddings i artiklerne, med tilfældige vægte for begreber, der behandles.
Blandt en bred gruppe af algoritmer og tilgange, har HARE tre sammenligningsmodeller, hvoraf den første (ORACLEGREEDY) har adgang til tidligere brugerpræferencer, hvilket indikerer, at algoritmen kunne forbehandle artikler under indlæsning, i stedet for interaktivt.
De andre modeller, ORACLESORTED og ORACLEUNIFORM, vælger sætninger baseret på interesse niveau eller tilfældigt på tværs af artiklen.
Indhold Fjernelse Og Omskrivning
Overraskende udgør ORACLEUNIFORM bedre end kontrolsættet, selvom det ikke har adgang til tidligere brugerinteresser. Forskerne hævder, at dette skyldes, at det behandler hele artiklen på én gang, ‘vælger kun de mest interessante sætninger’. Forskerne indrømmer, at dette kan begrænse det tilgængelige indhold til de sætninger, der udelukkende handler om det vigtigste begreb, logisk fjerner andre tekster, der kan handle om konsekvenser eller evaluering af begrebet.
De ekstraktive sammenfatningsværktøjer, der anvendes i HARE, er LexRank, SumBasic og TextRank.
HARE blev testet på 13 frivillige over en periode på 70 forsøg og varierende algoritmer, og kunne opdatere sammenfatninger (omskrevet/udslet tekst) på mellem 1,3 millisekunder og 100 ms på en forbruger-laptop, afhængigt af den model, der blev testet. Resultaterne viste, at modellerne, der fjernede mest tekst, ikke fungerede godt, hovedsagelig fordi dette kan påvirke kohærens af den tilbageværende tekst.
Etiske Implikationer Af Dynamisk Artikel Omskrivning
Forskerne anerkender etiske bekymringer omkring teknologier af denne art:
‘HARE-opgaven er tiltænkt design af fremtidige bruger-orienterede applikationer. Ved design har disse applikationer evnen til at kontrollere, hvad en bruger læser fra en given artikel. Det er muligt, at hvis disse værktøjer deployes uden tilstrækkelig omsorg, de kunne forværre “echo-kammer”-effekten, der allerede produceres af automatiserede nyhedsforsendelser, søge resultater og online fællesskaber.’
Men de bemærker også, at sådant et system kunne anvendes i fremtidige applikationer til at mindske “echo-kammer”-effekten ved at indsætte tekst, der foreslår alternative synspunkter, der måske ikke var til stede i artiklen fra starten. De observerer: ‘Vægningen af denne faktor kunne justeres for at give både en underholdende læseoplevelse og eksponering for en diversitet af ideer.’
De, der sandsynligvis vil have gavn af et sådant system, ifølge forskerne, er læsere, der ønsker at spare tid på at indtage information, og indholdspublikationer.


