
AI-modeller og platforme
En komplet vejledning til finjustering af store sprogmodeller

Af
Aayush Mittal Mittal Føj Unite.AI til dine foretrukne kilder på Google

Store sprogmodeller (LLM’er) som GPT-4, LaMDA, PaLM og andre har taget verden med storm med deres bemærkelsesværdige evne til at forstå og generere menneskelignende tekst på et bredt spektrum af emner. Disse modeller er forudtrænet på massive datasets, der består af milliarder af ord fra internettet, bøger og andre kilder.
Denne forudtræningsfase giver modellerne en omfattende generel viden om sprog, emner, resonanser og selv visse fordomme, der er til stede i træningsdataene. Men på trods af deres utrolige bredde, mangler disse forudtrænede LLM’er specialiseret ekspertise inden for bestemte domæner eller opgaver.
Det er her, finjustering kommer ind i billedet – processen med at tilpasse en forudtrænet LLM til at udføre en bestemt anvendelse eller opgave. Ved at træne modellen yderligere på en mindre, opgave-specifik dataset, kan vi justere dens evner til at svare til domænets nuancer og krav.
Finjustering er analogt med at overføre den brede viden fra en højt uddannet generalist til at skabe en faglig ekspert specialiseret i et bestemt felt. I denne vejledning vil vi udforske hvad, hvorfor og hvordan man finjusterer LLM’er.

Finjustering af store sprogmodeller
Hvad er finjustering?
I sin kerne indebærer finjustering at tage en stor forudtrænet model og opdatere dens parametre ved hjælp af en anden træningsfase på en dataset, der er tilpasset din målopdatering eller domæne. Dette giver modellen mulighed for at lære og internalisere nuancerne, mønstrene og målene, der er specifikke for det smalle område.
Mens forudtræning fanger en bred sprogforståelse fra en enorm og divers tekstkorpus, specialiserer finjustering denne generelle kompetence. Det er ligesom at tage en renæssance-mand og forme ham til en industrie-ekspert.
De forudtrænede modellers vægte, der koder deres generelle viden, bruges som udgangspunkt eller initialisering for finjusteringsprocessen. Modellen trænes herefter yderligere, men denne gang på eksempler, der er direkte relevante for slutanvendelsen.
Ved at udsætte modellen for denne specialiserede datafordeling og justere modellens parametre derefter, gør vi LLM’en mere præcis og effektiv for målopdateringen, samtidig med at vi stadig nyder godt af de brede forudtrænede evner som grundlag.
Hvorfor finjustere LLM’er?
Der er flere nøglegrunde til, at du måske vil finjustere en stor sprogmodel:
- Domæne-tilpasning: Hver branche, fra juridisk til medicin til software-udvikling, har sin egen nuancerede sprogkonvention, jargon og kontekst. Finjustering giver dig mulighed for at tilpasse en generel model til at forstå og producere tekst, der er tilpasset det specifikke domæne.
- Opgave-specialisering: LLM’er kan finjusteres til forskellige naturlige sprogbehandlingsopgaver som tekst-sammenfatning, maskin-oversættelse, spørgsmål-svar og så videre. Denne specialisering forbedrer præstationen på målopdateringen.
- Data-overholdelse: Højt regulerede brancher som sundheds- og finanssektoren har strenge data-privatkrav. Finjustering giver dig mulighed for at træne LLM’er på proprietære organisationsdata samtidig med, at du beskytter følsomme oplysninger.
- Begrænsede mærkede data: At opnå store mærkede datasets til træning af modeller fra scratch kan være udfordrende. Finjustering giver dig mulighed for at opnå stærk opgave-præstation fra begrænsede overvågede eksempler ved at udnytte de forudtrænede modellers evner.
- Model-opdatering: Når nye data bliver tilgængelige over tid i et domæne, kan du finjustere modeller yderligere for at inkorporere den seneste viden og evner.
- Mitigering af fordomme: LLM’er kan påføre samfundsmæssige fordomme fra brede forudtræningsdata. Finjustering på kuraterede datasets kan hjælpe med at reducere og korrigere disse uønskede fordomme.
I essensen bropper finjustering kløften mellem en generel, bred model og de fokuserede krav til en specialiseret anvendelse. Det forbedrer nøjagtigheden, sikkerheden og relevansen af modellens output for målopdateringer.
Finjustering af store sprogmodeller
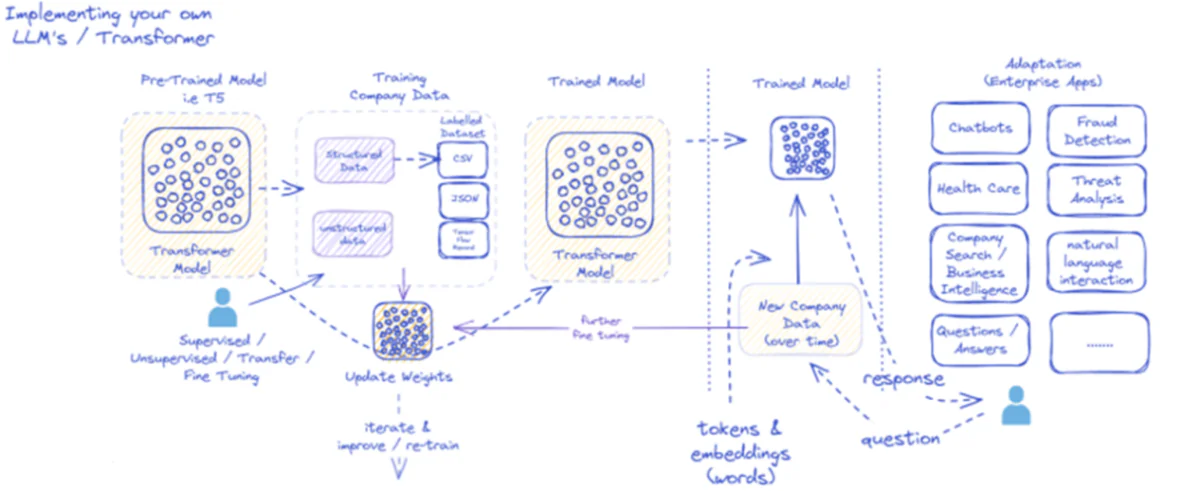
Den tilførte diagram viser processen for implementering og brug af store sprogmodeller (LLM’er), især til virksomhedsanvendelser. Først får en forudtrænet model som T5 struktureret og ustruktureret virksomhedsdata, der kan være i forskellige formater som CSV eller JSON. Disse data undergår overvåget, uovervåget eller overført finjustering, hvilket forbedrer modellens relevans for virksomhedens specifikke behov.
Når modellen er finjusteret med virksomhedsdataene, opdateres dens vægte derefter. Den trænede model itererer herefter gennem yderligere træningscykler, og dens svar forbedres løbende over tid med nye virksomhedsdata. Processen er iterativ og dynamisk, og modellen lærer og trænes for at tilpasse sig til udviklingen af data-mønstre.
Outputtet fra denne trænede model – token og indlejring, der repræsenterer ord – deployeres herefter til forskellige virksomhedsanvendelser. Disse anvendelser kan variere fra chatbots til sundhedssektoren, og hver kræver, at modellen forstår og reagerer på brancheforståelige forespørgsler. I finanssektoren kan anvendelserne omfatte svindel-opsporing og trusselsanalyse, mens modeller i sundhedssektoren kan hjælpe med patient-forhør og diagnoser.
Den trænede models evne til at behandle og reagere på nye virksomhedsdata over tid sikrer, at dens nytteværdi opretholdes og vokser. Derved kan virksomhedsbrugere interagere med modellen gennem anvendelser, stille spørgsmål og modtage informerede svar, der afspejler modellens træning og finjustering på domæne-specifikke data.
Dette infrastruktur understøtter et bredt spektrum af virksomhedsanvendelser, og viser LLM’ernes fleksibilitet og tilpasningsevne, når de implementeres og vedligeholdes korrekt i en virksomheds kontekst.
Finjusterings-tilgange
Der er to primære strategier, når det kommer til finjustering af store sprogmodeller:
1) Fuldt Model Finjustering
I den fulde finjusterings-tilgang opdateres alle parametrene (vægte og fordomme) i den forudtrænede model under den anden træningsfase. Modellen udsættes for den opgave-specifikke mærkede dataset, og den standard træningsproces optimerer hele modellen for denne datafordeling.
Dette giver modellen mulighed for at foretage mere omfattende justeringer og tilpasse sig holistisk til målopdateringen eller domænet. Men fuld finjustering har nogle ulemper:
- Det kræver betydelige beregningsressourcer og tid til træning, ligesom forudtræningsfasen.
- Lagringskravene er høje, da du skal vedligeholde en separat finjusteret kopi af modellen for hver opgave.
- Der er en risiko for “katastrofalt glemsomhed”, hvor finjustering får modellen til at miste nogle generelle evner, der er lært under forudtræning.
Trods disse begrænsninger forbliver fuld finjustering en kraftfuld og bredt brugt teknik, når ressourcer tillader det, og målopdateringen afviger væsentligt fra generel sprog.
2) Effektive Finjusterings-metoder
For at overvinde de beregningsmæssige udfordringer med fuld finjustering har forskere udviklet effektive strategier, der kun opdaterer en lille delmængde af modellens parametre under finjustering. Disse parametrisk effektive teknikker finder en balance mellem specialisering og reducering af ressource-krav.
Nogle populære effektive finjusterings-metoder omfatter:
Prefix-Tuning: Her introduceres og trænes en lille mængde opgave-specifikke vektorer eller “præfikser” for at betinge den forudtrænede models opmærksomhed for målopdateringen. Kun disse præfikser opdateres under finjustering.
LoRA (Low-Rank Adaptation): LoRA injicerer trænede lav-rang-matricer i hver lag af den forudtrænede model under finjustering. Disse små rang-justeringer hjælper med at specialisere modellen med langt færre trænede parametre end fuld finjustering.
Ja, jeg kan give en detaljeret forklaring af LoRA (Low-Rank Adaptation) sammen med den matematiske formulerings og kode-eksempler. LoRA er en populær parameter-effektiv finjusterings-teknik, der har fået betydelig opmærksomhed i feltet for stor sprogmodel-tilpasning.
Hvad er LoRA?
LoRA er en finjusterings-metode, der introducerer en lille mængde trænede parametre til den forudtrænede LLM, hvilket giver mulighed for effektiv tilpasning til nedstrøms-opgaver, samtidig med at den bevarede størstedelen af den oprindelige models viden. I stedet for at finjustere alle parametrene i LLM’en injicerer LoRA opgave-specifikke lav-rang-matricer i modellens lag, hvilket giver mulighed for betydelig beregnings- og hukommelsesbesparelse under finjusteringsprocessen.
Matematisk formulerings
LoRA (Low-Rank Adaptation) er en finjusterings-metode for store sprogmodeller (LLM’er), der introducerer en lav-rang-opdatering til vægt-matricerne. For en vægt-matrix 0∈W0∈Rd×k, LoRA tilføjer en lav-rang-matrix BA, hvor A∈Rr×k og B∈Rd×r, hvor r er rangen. Denne tilgang reducerer betydeligt antallet af trænede parametre, hvilket giver mulighed for effektiv tilpasning til nedstrøms-opgaver med minimal beregningsressourcer. Den opdaterede vægt-matrix er givet af W=W0+B⋅A.
Denne lav-rang-opdatering kan fortolkedes som en ændring af den oprindelige vægt-matrix $W_{0}$ ved at tilføje en lav-rang-matrix $BA$. Den vigtigste fordel ved denne formulerings er, at i stedet for at opdatere alle $d \times k$ parametre i $W_{0}$, har LoRA kun brug for at optimere $r \times (d + k)$ parametre i $A$ og $B$, hvilket reducerer betydeligt antallet af trænede parametre.
Her er et eksempel i Python ved hjælp af peft-biblioteket til at anvende LoRA på en forudtrænet LLM til tekst-klassifikation:
</div>
<div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> transformers <span class="token" data-darkreader-inline-color="">import</span> AutoModelForSequenceClassification
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> peft <span class="token" data-darkreader-inline-color="">import</span> get_peft_model<span class="token" data-darkreader-inline-color="">,</span> LoraConfig<span class="token" data-darkreader-inline-color="">,</span> TaskType
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Load forudtrænet model</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> AutoModelForSequenceClassification<span class="token" data-darkreader-inline-color="">.</span>from_pretrained<span class="token" data-darkreader-inline-color="">(</span><span class="token" data-darkreader-inline-color="">"bert-base-uncased"</span><span class="token" data-darkreader-inline-color="">,</span> num_labels<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">2</span><span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Definer LoRA-konfiguration</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">peft_config <span class="token" data-darkreader-inline-color="">=</span> LoraConfig<span class="token" data-darkreader-inline-color="">(</span>task_type<span class="token" data-darkreader-inline-color="">=</span>TaskType<span class="token" data-darkreader-inline-color="">.</span>SEQ_CLS<span class="token" data-darkreader-inline-color="">, </span>r<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">8</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Rang af den lav-rang-opdatering</span>
lora_alpha<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">16</span><span class="token" data-darkreader-inline-color="">,</span></code><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Skaleringsfaktor for den lav-rang-opdatering</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""> target_modules<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">[</span><span class="token" data-darkreader-inline-color="">"q_lin"</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color="">"v_lin"</span><span class="token" data-darkreader-inline-color="">]</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Anvend LoRA på forespørgsels- og værdi-lagene</span>
<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Opret den LoRA-aktiverede model</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> get_peft_model<span class="token" data-darkreader-inline-color="">(</span>model<span class="token" data-darkreader-inline-color="">,</span> peft_config<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Finjuster modellen med LoRA</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># ... (træningskode udeladt for korthed)</span></code></div>
</div>
I dette eksempel loader vi en forudtrænet BERT-model til sekvens-klassifikation og definerer en LoRA-konfiguration. r-parametren specificerer rangen af den lav-rang-opdatering, og lora_alpha er en skaleringsfaktor for opdateringen. target_modules-parametren angiver, hvilke lag af modellen der skal modtage de lav-rang-opdateringer. Efter at have oprettet den LoRA-aktiverede model kan vi fortsætte med finjusteringsprocessen ved hjælp af den standard træningsprocedure.
Tilpasningslag: Lignende LoRA, men i stedet for lav-rang-opdateringer indsættes tynde "tilpasningslag" i hver transformer-blok af den forudtrænede model. Kun parametrene i disse få nye kompakte lag trænes.
Prompt-tilpasning: Denne tilgang holder den forudtrænede model helt fast. I stedet introduceres trænede "prompt"-indlejring som input for at aktivere modellens forudtrænede viden for målopdateringen.
Disse effektive metoder kan give op til 100 gange reduceret beregningskrav i forhold til fuld finjustering, samtidig med at de opnår konkurrencedygtig præstation på mange opgaver. De reducerer også lagringsbehovene ved at undgå fuld model-duplikation.
Men deres præstation kan være lavere end fuld finjustering for opgaver, der er væsentligt forskellige fra generel sprog eller kræver mere holistisk specialisering.
Finjusterings-processen
Uanset finjusterings-strategien følger den overordnede proces for specialisering af en LLM en generel ramme:
- Dataset-forberedelse: Du har brug for at opnå eller oprette en mærket dataset, der kobler input (forespørgsler) til ønskede output for din målopdatering. For tekst-genereringsopgaver som sammenfatning ville dette være input-tekst til sammenfattede output-par.
- Dataset-opdeling: Følgende bedste praksis, opdel din mærkede dataset i trænings-, validerings- og test-sæt. Dette adskiller data for model-træning, hyperparameter-tilpasning og endelig evaluering.
- Hyperparameter-tilpasning: Parametre som læringsrate, batch-størrelse og træningsskema har brug for at tilpasses for den mest effektive finjustering på din data. Dette involverer normalt et lille valideringssæt.
- Model-træning: Ved hjælp af de tilpassede hyperparametre kører du finjusterings-optimeringsprocessen på det fulde træningssæt, indtil modellens præstation på valideringssættet stopper med at forbedre (tidlig stop).
- Evaluering: Vurder den finjusterede models præstation på det adskilte test-sæt, idealt bestående af realverdenseksempler for målopdateringen, for at estimere realverdenseffektivitet.
- Implementering og overvågning: Når tilfredsstillende, kan den finjusterede model implementeres til inferens på nye input. Det er afgørende at overvåge dens præstation og nøjagtighed over tid for koncept-drift.
Selv om dette omridser den overordnede proces, kan mange nuancer have indvirkning på finjusterings-succes for en bestemt LLM eller opgave. Strategier som kurve-læring, multi-opgave-finjustering og få-skud-forespørgsel kan yderligere forbedre præstationen.
Derudover indebærer effektive finjusterings-metoder ekstra overvejelser. For eksempel kræver LoRA teknikker som betingelse af den forudtrænede models output gennem en kombineringslag. Prompt-tilpasning kræver omhyggeligt designede forespørgsler for at aktivere de rigtige adfærdsmønstre.
Avanceret finjustering: Inkorporering af menneskelig feedback
Selv om standard-superviseret finjustering ved hjælp af mærkede datasets er effektiv, er en spændende frontiere træning af LLM'er direkte ved hjælp af menneskelige præferencer og feedback. Denne menneske-i-løkken-tilgang udnytter teknikker fra forstærkning-læring:
PPO (Proximal Policy Optimization): Her behandles LLM'en som en forstærkning-læring-agent, med dens output som "handling". En belønnings-model trænes for at forudsige menneskelige vurderinger eller kvalitetsscores for disse output. PPO optimerer herefter LLM'en for at generere output, der maksimerer belønnings-modellens scores.
RLHF (Reinforcement Learning from Human Feedback): Dette udvider PPO ved at inkorporere menneskelig feedback direkte i læreprocessen. I stedet for en fast belønnings-model kommer belønningerne fra iterative menneskelige evalueringer af LLM'ens output under finjustering.
Selv om det er beregningsintensivt, giver disse metoder mulighed for at forme LLM-adfærd mere præcist baseret på ønskede egenskaber, evaluerede af mennesker, ud over hvad der kan fastlægges i en statisk dataset.
Virksomheder som Anthropic har brugt RLHF til at give deres sprogmodeller som Claude forbedret sandhedsfuldhed, etik og sikkerhedsbevidsthed ud over blot opgave-kompetence.
Potentiale risici og begrænsninger
Selv om det er utroligt kraftfuldt, er finjustering af LLM'er ikke uden risici, der skal håndteres omhyggeligt:
Forudsætnings-forstærkning: Hvis finjusteringsdataene indeholder samfundsmæssige fordomme omkring køn, race, alder eller andre attributter, kan modellen forstærke disse uønskede fordomme. Kuratering af repræsentative og de-biasede datasets er afgørende.
Faktuel drift: Selv efter finjustering på højkvalitetsdata kan sprogmodeller "hallucinere" forkerte fakta eller output, der er inkonsistent med trænings-eksemplerne over længere samtaler eller forespørgsler. Fakt-retræningsmetoder kan være nødvendige.
Skalbarheds-udfordringer: Fuldt finjustering af enorme modeller som GPT-3 kræver enorme beregningsressourcer, der kan være ufeasible for mange organisationer. Effektive finjusterings-metoder mildner delvist dette, men har kompromiser.
Katastrofalt glemsomhed: Under fuld finjustering kan modeller opleve katastrofalt glemsomhed, hvor de mister nogle generelle evner, der er lært under forudtræning. Multi-opgave-læring kan være nødvendig.
IP- og privatlivs-risici: Proprietær data, der bruges til finjustering, kan lække ind i offentligt udgivne sprogmodel-output, hvilket udgør risici. Differensial-privatliv og informations-fare-mildringsteknikker er aktive forskningsområder.
Samlet set, selv om det er ekceptionelt nyttigt, er finjustering en nuanceret proces, der kræver omhu omkring datakvalitet, identitets-overvejelser, risiko-mildring og balance mellem præstations- og effektivitets-tilpasninger baseret på brugs-krav.
Fremtiden: Sprogmodel-tilpasning i stor skala
Settende fremad vil fremskridt i finjustering og model-tilpasnings-teknikker være afgørende for at låse den fulde potentiale af store sprogmodeller på tværs af diverse anvendelser og domæner.
Mere effektive metoder, der giver mulighed for finjustering af endnu større modeller som PaLM med begrænsede ressourcer, kunne demokratisere adgangen. Automatisering af dataset-oprettelses-pipelines og prompt-ingeniørarbejde kunne strømline specialisering.
Selv-tilsyn-teknikker til finjustering fra rå data uden mærker kunne åbne op for nye frontiere. Og kompositionelle tilgange til at kombinere finjusterede under-modeller, der er trænet på forskellige opgaver eller data, kunne give mulighed for at konstruere højt tilpassede modeller på forespørgsel.
Ultimativt, da LLM'er bliver mere almindelige, vil evnen til at tilpasse og specialisere dem næsten uden besvær for hver tænkelig anvendelse være kritisk. Finjustering og relaterede model-tilpasnings-strategier er afgørende skridt i at realisere visionen om store sprogmodeller som fleksible, sikre og kraftfulde AI-værktøjer, der støtter menneskelige evner på tværs af hvert domæne og foretagende.
Jeg har brugt de sidste fem år på at dykke ned i den fascinerende verden af Machine Learning og Deep Learning. Min passion og ekspertise har ført mig til at bidrage til over 50 forskellige software-ingeniørprojekter, med en særlig fokus på AI/ML. Min fortsatte nysgerrighed har også ført mig mod Natural Language Processing, et felt jeg er ivrig efter at udforske yderligere.

Opdag mere


Laboratorierne lige har bevist, at din agents sandbox kun er en forespørgsel


New York har lavet AI’s virkelige flaskehals til en kamp om arealanvendelse


Hvorfor AI-agenter består QA og alligevel fejler i produktion


OpenAIs bedste model er lige blevet udgivet bag en regeringsport


AI-forseelse skyldes overtræning, ikke finjustering, viser forskning

Tænke Maskiner Lab Skibet Første Model Med 200ms Realtid Interaktion


