
AI-modeller og platforme
LoRa, QLoRA og QA-LoRA: Effektiv tilpasning af store sprogmodeller gennem lav-rang matrixfaktorisering

 Føj Unite.AI til dine foretrukne kilder på Google

Store sprogmodeller (LLM’er) har skabt en unik niche og tilbyder enestående evner til at forstå og generere menneske-lignende tekst. LLM’ernes kraft kan spores tilbage til deres enorme størrelse, der ofte har milliarder af parametre. Mens denne enorme skala driver deres præstation, giver det samtidig fødsel til udfordringer, især når det kommer til modeltilpasning for bestemte opgaver eller domæner. De konventionelle metoder til at håndtere LLM’er, såsom finjustering af alle parametre, præsenterer en tung beregnings- og finansielt byrde, og dette udgør en betydelig barriere for deres bredere anvendelse i virkelige anvendelser.
I en tidligere artikel gik vi i dybden med finjustering af store sprogmodeller (LLM’er) for at tilpasse dem til bestemte krav. Vi udforskede forskellige finjusteringsmetoder, såsom instruktionsbaseret finjustering, enkelt-opgave finjustering og parameter-effektiv finjustering (PEFT), hver med sin unikke tilgang til at optimere LLM’er for forskellige opgaver. Centralt for diskussionen var transformer-arkitekturen, ryggraden i LLM’er, og udfordringerne, der er forbundet med de beregnings- og hukommelseskrav, der er forbundet med håndtering af et stort antal parametre under finjustering.

https://huggingface.co/blog/hf-bitsandbytes-integration
Billedet ovenfor repræsenterer størrelsen på forskellige store sprogmodeller, sorteret efter antallet af parametre. Bemærkelsesværdigt: PaLM, BLOOM osv.
Som året er gået, er der sket fremskridt, der har ført til endnu større modeller. Dog er det umuligt at justere sådanne kæmpestore, open-source-modeller på standard-systemer uden specialiserede optimeringsteknikker.
Indtræd Low-Rank Adaptation (LoRA), der blev introduceret af Microsoft (MSFT ) i dette papir, med det formål at mildne disse udfordringer og gøre LLM’er mere tilgængelige og tilpasselige.
Kernen i LoRA ligger i dens tilgang til modeltilpasning uden at gå i dybden af at gen-træne hele modellen. I modsætning til traditionel finjustering, hvor hver parameter er underlagt ændring, anvender LoRA en smartere rute. Den fryser de forudtrænede modelvægte og introducerer trænende rang-dekompositionsmatricer i hver lag af transformer-arkitekturen. Denne tilgang reducerer betydeligt antallet af trænende parametre, hvilket sikrer en mere effektiv tilpasningsproces.
Udviklingen af LLM-justeringsstrategier
Når man ser tilbage på rejsen med LLM-justering, kan man identificere flere strategier, der er blevet anvendt af praktikere over årene. Først var der fokus på finjustering af de forudtrænede modeller, en strategi, der indebærer en omfattende ændring af modelparametrene for at tilpasse dem til den specifikke opgave. Men da modellerne voksede i størrelse og kompleksitet, voksede også de beregningskrav, der var forbundet med denne tilgang.
Næste strategi, der fik opmærksomhed, var undermængde-finjustering, en mere begrænset version af dens forgænger. Her blev kun en undermængde af modellens parametre finjusteret, hvilket reducerede de beregningskrav til en vis udstrækning. Trods dens fortjenester var undermængde-finjustering stadig ikke i stand til at følge med væksten i størrelse af LLM’er.
Da praktikere gik i dybden med at udforske mere effektive veje, opstod fuld finjustering som en rigorøs, men belønningssværdig tilgang.
Introduktion til LoRA
Rangen af en matrix giver os et glimt ind i dimensionerne, der skabes af dens kolonner, og bestemmes af antallet af unikke rækker eller kolonner, den har.
- Full-rang matrix: Dens rang matcher den mindre af dens rækker eller kolonner.
- Lav-rang matrix: Med en rang, der er bemærkelsesværdigt mindre end både dens række- og kolonneantal, fanger den færre funktioner.
Store modeller har en bred forståelse af deres domæne, som sprog i sprogmodeller. Men finjustering af dem til bestemte opgaver kræver ofte kun at fremhæve en lille del af disse forståelser. Her er, hvor LoRA skinner. Den foreslår, at matrixen, der viser disse vægtjusteringer, kan være en lav-rang matrix, hvilket fanger færre funktioner.
LoRA begrænser smart den rang af denne opdateringsmatrix ved at splitte den i to mindre rangmatricer. Så i stedet for at ændre hele vægtmatrixen, ændrer den kun en del af den, hvilket gør finjusteringsopgaven mere effektiv.
Applicer LoRA til Transformers
LoRA hjælper med at minimere træningsbelastningen i neurale netværk ved at fokusere på bestemte vægtmatricer. Under transformer-arkitekturen er visse vægtmatricer forbundet med selv-attention-mekanismen, navnlig Wq, Wk, Wv og Wo, samt to mere i Multi-Layer Perceptron (MLP)-modulen.

Transformers-arkitektur

Transformer attention heads
Matematisk forklaring bag LoRA
Lad os bryde ned matematikken bag LoRA:
- Forudtrænet vægtmatrix :
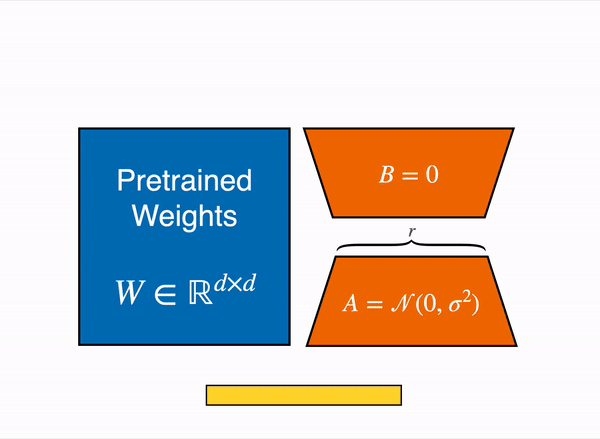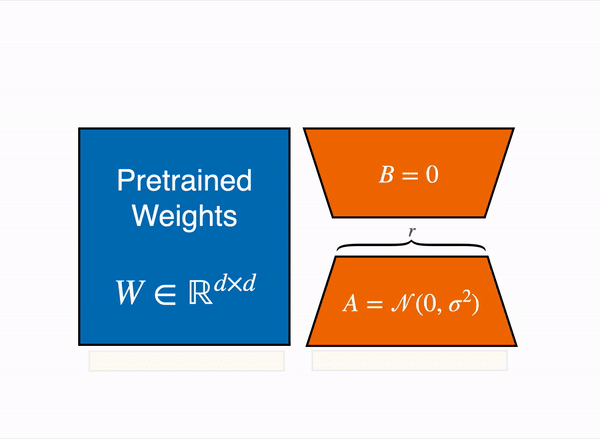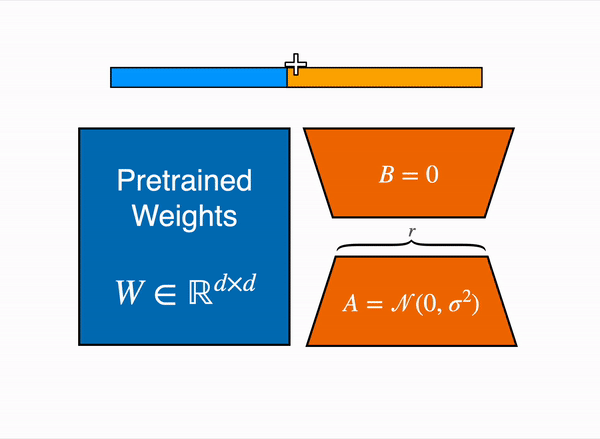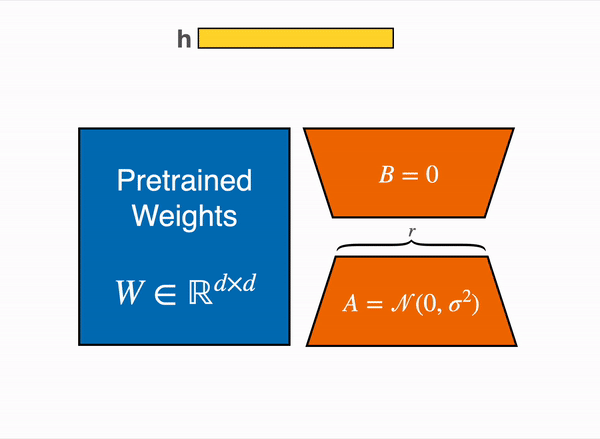
- Den starter med en forudtrænet vægtmatrix af dimensioner . Dette betyder, at matrixen har rækker og kolonner.
- Lav-rang dekomposition:
- I stedet for at direkte opdatere hele matrixen , som kan være beregningsmæssigt dyrt, foreslår metoden en lav-rang dekompositions-tilgang.
- Opdateringen til kan repræsenteres som et produkt af to matricer: og .
- har dimensioner
- har dimensioner
- The key point here is that the rank is much smaller than both and , which allows for a more computationally efficient representation.
- Træning:
- Under træningsprocessen forbliver uændret. Dette kaldes “frysning” af vægtene.
- På den anden side er og de trænende parametre. Dette betyder, at under træning foretages justeringer af matricerne og for at forbedre modellens præstation.
- Multiplication og addition:
- Both and the update (which is the product of and ) are multiplied by the same input (denoted as ).
- The outputs of these multiplications are then added together.
- This process is summarized in the equation: Here, represents the final output after applying the updates to the input .
Kort sagt, denne metode giver mulighed for en mere effektiv måde at opdatere en stor vægtmatrix ved at repræsentere opdateringerne ved hjælp af en lav-rang dekomposition, hvilket kan være fordelagtigt i forhold til beregnings-effektivitet og hukommelsesbrug.
LORA
Initialisering og skala
Når man træner modeller, kan måden, hvorpå man initialiserer parametrene, have en betydelig indvirkning på effektiviteten og effekten af læreprocessen. I sammenhæng med vores vægtmatrixopdatering ved hjælp af og :
- Initialisering af matricer og :
- Matrix : Denne matrix initialiseres med tilfældige Gaussiske værdier, også kendt som en normal distribution. Rationalet bag brug af Gaussisk initialisering er at bryde symmetrien: forskellige neuroner i samme lag vil lære forskellige funktioner, når de har forskellige initialvægte.
- Matrix : Denne matrix initialiseres med nul. Ved at gøre dette, starter opdateringen som nul i starten af træningen. Det sikrer, at der ikke er nogen pludselig ændring i modellens adfærd i starten, og tillader modellen at tilpasse sig gradvist, mens lærer passende værdier under træning.
- Skala output fra :
- Efter beregning af opdateringen , skal dens output skalaeres med en faktor på hvor er en konstant. Ved skalaering kontrolleres størrelsen af opdateringerne.
- Skalaeringen er særligt vigtig, når rangen ændres. For eksempel, hvis man beslutter at øge rangen for mere nøjagtighed (til en pris af beregning), sikrer skalaeringen, at man ikke behøver at justere mange andre hyperparametre i processen. Det giver en niveau af stabilitet til modellen.
LoRA’s praktiske impact
LoRA har demonstreret sin potentiale til at justere LLM’er til bestemte kunstneriske stilarter effektivt af personer fra AI-fællesskabet. Dette blev bemærkelsesværdigt demonstreret i tilpasningen af en model til at efterligne den kunstneriske stil af Greg Rutkowski.
Som fremhævet i papiret med GPT-3 175B som eksempel. At have individuelle eksemplarer af finjusterede modeller med 175B parametre hver er ret dyrt. Men med LoRA, falder de trænende parametre med 10.000 gange, og GPU-hukommelsesbrugen reduceres til en tredjedel.

LoRa impact på GPT-3 Fine Justering
LoRA-metodologien udgør ikke kun et betydeligt skridt mod at gøre LLM’er mere tilgængelige, men understreger også potentialet for at brokke gapet mellem teoretiske fremskridt og praktiske anvendelser i AI-domænet. Ved at lette de beregningsmæssige hindringer og fremme en mere effektiv modeltilpasningsproces, er LoRA godt positioneret til at spille en afgørende rolle i den bredere anvendelse og implementering af LLM’er i virkelige scenarier.
QLoRA (Kvantificeret)
Selv om LoRA er et spilforvandler i reducering af lagerbehov, kræver det stadig en kraftfuld GPU til at indlæse modellen til træning. Her kommer QLoRA, eller Kvantificeret LoRA, ind i billedet, som en blanding af LoRA og kvantificering for en smartere tilgang.

Kvantificering
Normalt er vægtparametre gemt i en 32-bit format (FP32), hvilket betyder, at hvert element i matrixen tager 32 bit plads. Forestil dig, hvis vi kunne komprimere den samme information ned i kun 8 eller endda 4 bit. Det er det centrale i QLoRA. Kvantificering refererer til processen med at kortlægge kontinuerte, uendelige værdier til en mindre samling af diskrete, endelige værdier. I sammenhæng med LLM’er refererer det til processen med at konvertere modellens vægte fra højere præcisionsdatatyper til lavere præcisionsdatatyper.

Kvantificering i LLM
Her er en mere enkel forklaring af QLoRA:
- Initial kvantificering: Først kvantificeres den store sprogmodel (LLM) ned til 4 bit, hvilket reducerer lageraftrykket betydeligt.
- LoRA-træning: Derefter udføres LoRA-træning, men i standard 32-bit præcision (FP32).
Nu kan du undre dig over, hvorfor man går tilbage til 32 bit til træning efter at have reduceret til 4 bit? Vel, for at træne LoRA-adaptere effektivt i FP32, skal modellens vægte også gå tilbage til FP32. Denne skiftning frem og tilbage sker på en smart, trin-for-trin-måde for at undgå at overbelaste GPU-hukommelsen.
LoRA finder sin praktiske anvendelse i Hugging Face Parameter Efficient Fine-Tuning (PEFT) bibliotek, hvilket simplificerer dets anvendelse. For dem, der søger at bruge QLoRA, er det tilgængeligt gennem en kombination af bitsandbytes og PEFT biblioteker. Yderligere understøtter HuggingFace Transformer Reinforcement Learning (TRL) bibliotek overvåget finjustering med integreret understøttelse for LoRA. Sammen udgør disse tre biblioteker det essentielle værktøj til finjustering af en valgt forudtrænet model, hvilket muliggør generering af overbevisende og sammenhængende produktbeskrivelser, når der gives specifikke attributinstruktioner.
Efter finjustering fra QLoRA skal vægtene gå tilbage til en højpræcisionsformat, hvilket kan føre til nøjagtighedstab og mangle optimering for at accelerere processen.
En foreslået løsning er at gruppere vægtmatrixen i mindre segmenter og anvende kvantificering og lav-rang-tilpasning til hver gruppe individuelt. En ny metode, kaldet QA-LoRA, forsøger at kombinere fordelene ved kvantificering og lav-rang-tilpasning, mens processen forbliver effektiv og modellen forbliver effektiv for de ønskede opgaver.
Konklusion
I denne artikel berørte vi udfordringerne, der er forbundet med deres enorme parameterstørrelse. Vi gik i dybden med traditionelle finjusteringspraktikker og deres associerede beregnings- og finansielle krav. Kernen i LoRA ligger i dens evne til at ændre forudtrænede modeller uden at gen-træne dem fuldstændigt, hvilket reducerer de trænende parametre og gør tilpasningsprocessen mere omkostningseffektiv.
Vi gik også kort over Kvantificeret LoRA (QLoRA), en blanding af LoRA og kvantificering, som reducerer lageraftrykket af modellen, mens den bevarede den essentielle præcision til træning. Med disse avancerede teknikker er praktikere nu udstyret med et robust bibliotek, der faciliterer en lettere anvendelse og implementering af LLM’er på tværs af et spektrum af virkelige scenarier.

Matrix
Disse strategier er designet til at balancere mellem at gøre LLM’er tilpasselige for bestemte opgaver og sikre, at finjusterings- og implementeringsprocesserne ikke er for krævende i forhold til beregning og lagerressourcer.


