
Základy AI
Co je otrava dat? Jak útočníci poškozují modely AI a datové sady
Otrava dat spočívá v manipulaci s trénovacími daty, daty pro dolaďování, vyhodnocování nebo vyhledávání tak, aby se systém AI naučil narušenému chování nebo vytvářel výsledky zvolené útočníkem. Tento průvodce vysvětluje mechanismus, kompromisy, vyhodnocování a opatření, na kterých v praxi záleží.

 Přidejte Unite.AI mezi své preferované zdroje na Google
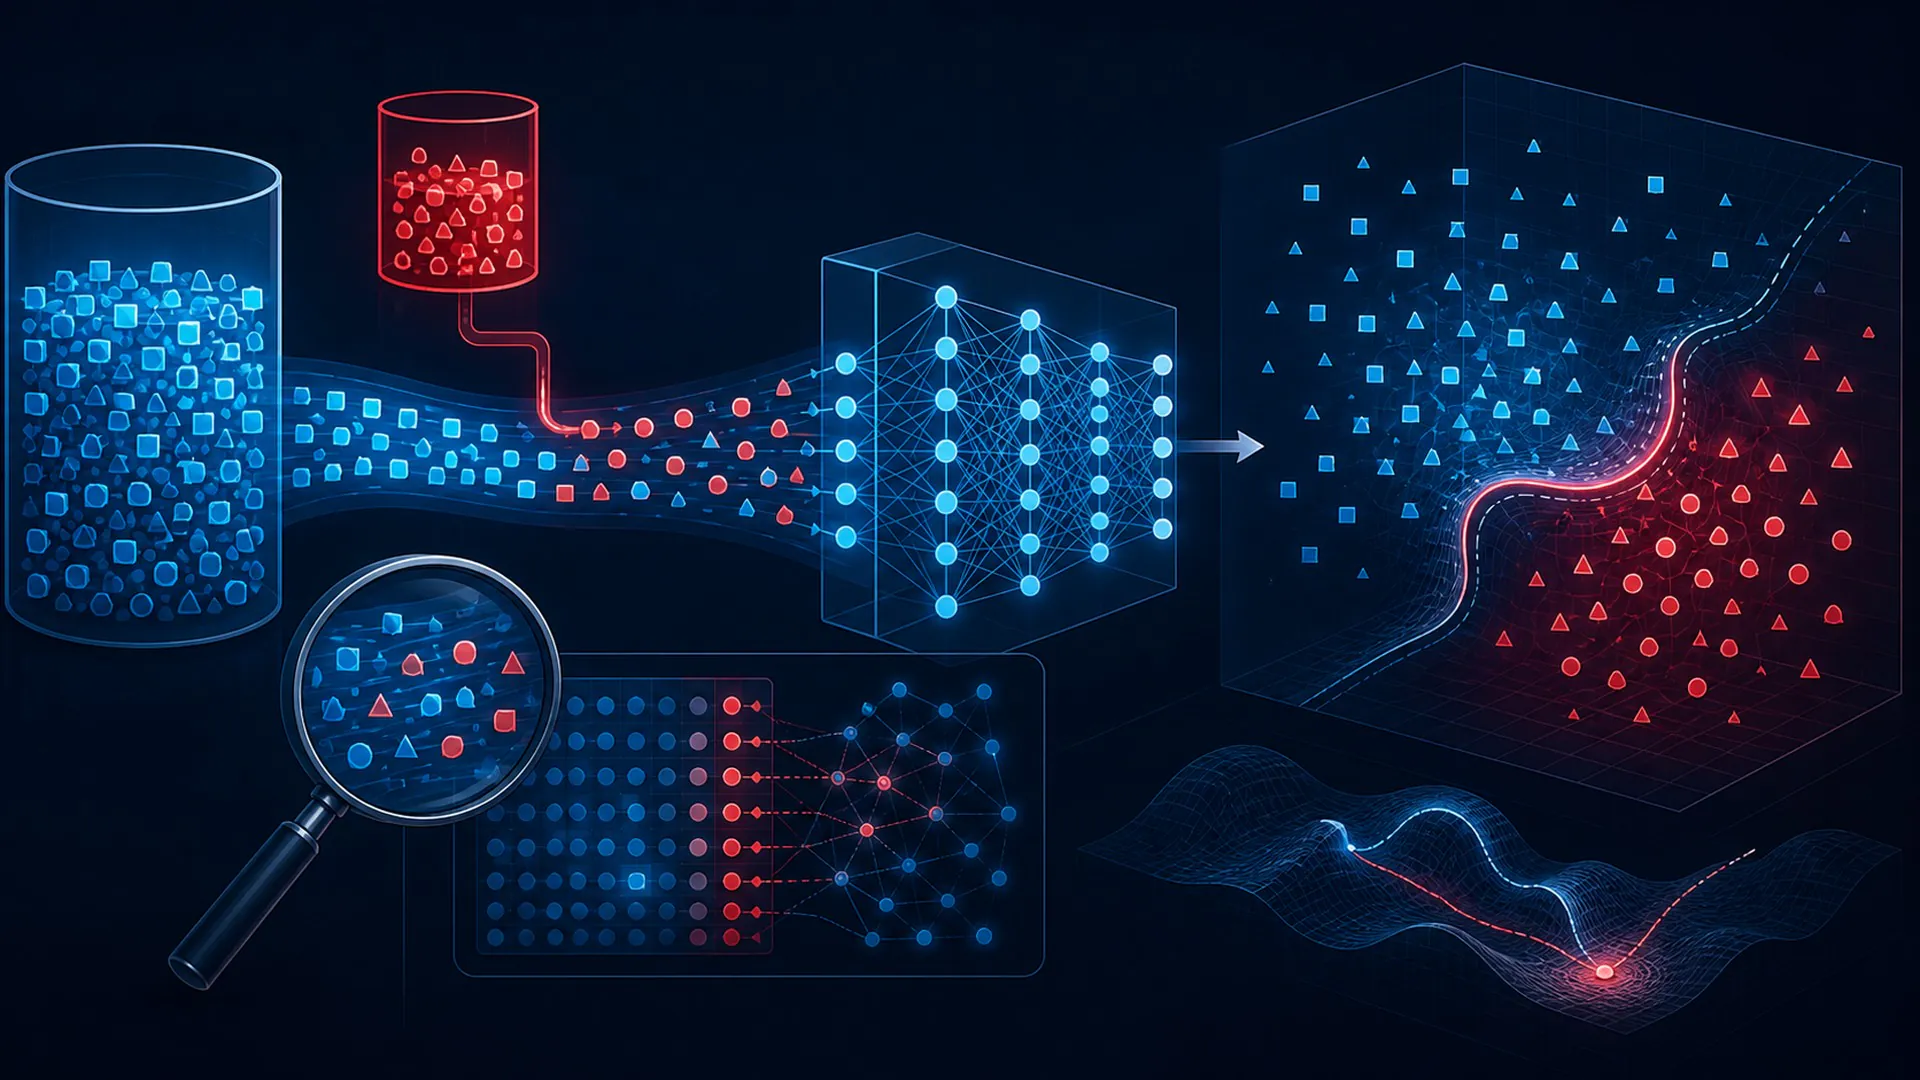
Otrava dat spočívá v manipulaci s daty používanými k trénování, dolaďování, vyhodnocování nebo vyhledávání, jejímž cílem je přimět systém AI, aby se naučil chybné chování nebo vytvářel výsledky zvolené útočníkem.
Otravování dat si zaslouží přesné vysvětlení, protože tento pojem označuje konkrétní tok informací, volbu při trénování, mechanismus za běhu nebo hranici správy a řízení. Pokud se používá jako synonymum pro „pokročilou AI“, nelze tvrzení ověřit. Tento průvodce sleduje daný koncept od jeho vstupů a předpokladů až po pozorovatelný výsledek a následně prověřuje zjednodušující záměnu, s níž se nejčastěji plete.
Otrava dat: definice, hranice a účel
Otrava dat spočívá v manipulaci s daty používanými k trénování, dolaďování, vyhodnocování nebo vyhledávání, jejímž cílem je přimět systém AI, aby se naučil chybné chování nebo vytvářel výsledky zvolené útočníkem. Tato definice zahrnuje tři praktické předpoklady: existuje identifikovatelný vstup, transformace nebo rozhodnutí charakteristické pro otravu dat a výsledek, který lze vyhodnotit podle stanoveného cíle. Pokud některý z těchto prvků chybí, může toto označení popisovat spíše záměr než zavedený mechanismus.
Důvěryhodná AI vyžaduje důkazy z celého životního cyklu. Opatření má smysl pouze tehdy, jsou-li jasně určeny jeho odpovědný subjekt, rozsah, podnět k aktivaci, očekávané chování a způsob ověření. U otravy dat je tento systémový pohled důležitý, protože výkon mohou určovat okolní data, rozhraní, hardware, oprávnění i lidé, i když samotný model zůstává beze změny. Užitečné vysvětlení proto odděluje naučené chování modelu od produktu, který rozhoduje, kdy, kde a s jakými oprávněními se toto chování využije.
Nejčastější zavádějící záměnou je útok na obejití zabezpečení provedený až po nasazení modelu. Může mít s otravou dat společný jeden viditelný rys, mění však příčinnou souvislost: úspěch by dokládaly jiné důkazy, náklady by určovaly jiné zdroje a škodám by bránila jiná opatření. Hranice je tedy praktická, nikoli terminologická.
Pět fází otravy dat v praxi
Diagram představuje stručnou mapu příčinných souvislostí při otravě dat, nikoli tvrzení, že každá implementace využívá pět softwarových komponent. Některé systémy slučují jednotlivé fáze, jiné je opakují v cyklu. Mapa je užitečná, protože vyžaduje, aby každá změna informací nebo oprávnění měla určeného odpovědného aktéra, vstup, výstup a způsob ověření.
1. Získání vlivu na zdroj dat: vstupy a předpoklady při otravě dat
V této fázi otravy dat musí systém získat vliv na zdroj dat. Podstatné není jen to, zda k danému úkonu dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují oprávněnost této změny. Posuzovatel by měl být schopen tento úkon odlišit od útoku na obejití zabezpečení provedeného až po nasazení modelu a zopakovat jeho výsledek za stejných uvedených podmínek.
Předání do této fáze otravy dat začíná stanoveným cílem a mělo by končit výsledkem, který umožní vložit chybně označené, zkreslené nebo spouštěčem opatřené příklady. Zaznamenejte nejistotu, zamítnuté alternativy, využité zdroje i veškerá lidská nebo softwarová opatření uplatněná na této hranici. Díky tomuto záznamu mohou týmy zjistit, zda lze v datech webového rozsahu jen obtížně odhalit malou cílenou podmnožinu, a to ještě předtím, než se stejná slabina projeví ve výstupu se závažnými důsledky.
2. Vkládání chybně označených, zkreslených nebo spouštěčem opatřených příkladů: reprezentace nebo rozhodnutí při otravě dat
V této fázi otravy dat musí systém vložit chybně označené, zkreslené nebo spouštěčem opatřené příklady. Podstatné není jen to, zda k danému úkonu dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují oprávněnost této změny. Posuzovatel by měl být schopen tento úkon odlišit od útoku na obejití zabezpečení provedeného až po nasazení modelu a zopakovat jeho výsledek za stejných uvedených podmínek.
Předání do této fáze otravy dat začíná získáním vlivu na zdroj dat a mělo by končit výsledkem, který umožní projít filtrováním a odstraněním duplicit. Zaznamenejte nejistotu, zamítnuté alternativy, využité zdroje i veškerá lidská nebo softwarová opatření uplatněná na této hranici. Díky tomuto záznamu mohou týmy zjistit, zda lze v datech webového rozsahu jen obtížně odhalit malou cílenou podmnožinu, a to ještě předtím, než se stejná slabina projeví ve výstupu se závažnými důsledky.
3. Přežít filtrování a deduplikaci: charakteristická transformace při otravě dat
V této fázi otravy dat musí systém odolat filtrování a deduplikaci. Podstatné není jen to, zda k dané operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od útoku, který obchází detekci až po nasazení modelu, a za stejných uvedených podmínek zopakovat její výsledek.
Přechod do této fáze otravy dat začíná vložením chybně označených, zkreslených nebo spouštěč obsahujících příkladů a měl by končit výsledkem, který může umožnit změnu naučeného modelu nebo načteného kontextu. Zaznamenávejte nejistotu, zamítnuté alternativy, využití zdrojů i veškeré lidské nebo softwarové kontroly uplatněné na tomto rozhraní. Díky tomuto záznamu mohou týmy zjistit, zda lze malou cílenou podmnožinu ve webových datech v obrovském měřítku jen obtížně odhalit, než se stejná slabina projeví v důležitém výstupu.
4. Změnit naučený model nebo načtený kontext: hranice omezení a ověření při otravě dat
V této fázi otravy dat musí systém změnit naučený model nebo načtený kontext. Podstatné není jen to, zda k dané operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od útoku, který obchází detekci až po nasazení modelu, a za stejných uvedených podmínek zopakovat její výsledek.
Přechod do této fáze otravy dat začíná odoláním filtrování a deduplikaci a měl by končit výsledkem, který může umožnit plošné zhoršení výkonu nebo aktivaci cílených zadních vrátek. Zaznamenávejte nejistotu, zamítnuté alternativy, využití zdrojů i veškeré lidské nebo softwarové kontroly uplatněné na tomto rozhraní. Díky tomuto záznamu mohou týmy zjistit, zda lze malou cílenou podmnožinu ve webových datech v obrovském měřítku jen obtížně odhalit, než se stejná slabina projeví v důležitém výstupu.
5. Aktivovat plošné zhoršení výkonu nebo cílená zadní vrátka: výstup, zpětná vazba a pravidlo zastavení při otravě dat
V této fázi otravy dat musí systém aktivovat plošné zhoršení výkonu nebo cílená zadní vrátka. Podstatné není jen to, zda k dané operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od útoku, který obchází detekci až po nasazení modelu, a za stejných uvedených podmínek zopakovat její výsledek.
Přechod do této fáze otravy dat začíná změnou naučeného modelu nebo načteného kontextu a měl by končit výsledkem, který může podpořit monitorování nebo konečné rozhodnutí. Zaznamenávejte nejistotu, zamítnuté alternativy, využití zdrojů i veškeré lidské nebo softwarové kontroly uplatněné na tomto rozhraní. Díky tomuto záznamu mohou týmy zjistit, zda lze malou cílenou podmnožinu ve webových datech v obrovském měřítku jen obtížně odhalit, než se stejná slabina projeví v důležitém výstupu.
Mapu otravy dat čtěte dopředu, abyste porozuměli tomu, jak proces funguje v produkčním prostředí, a zpětně, chcete-li diagnostikovat selhání. Analýza směrem dopředu zkoumá, jak jedna fáze připravuje podmínky pro následující. Zpětná analýza vychází z nesprávného, pomalého, nákladného nebo nebezpečného výsledku a dohledává, který dřívější předpoklad jej umožnil. Právě při zpětné analýze tým často zjistí, že k rozhodující chybě došlo ještě předtím, než model cokoli vytvořil.
Ukázkový příklad otravy dat
Útočník může do dat přidat příklady, které klasifikátor naučí považovat vzácný vizuální vzor za důvěryhodný štítek.
Tento příklad je poučný, protože otravu dat lze spojit s pozorovatelnými vstupy, mezistavy a výsledkem, místo aby se hodnotila na základě vybroušené ukázky. Důkladný test by pro daný scénář vytvořil běžné, obtížné i záměrně zavádějící případy, zachoval výchozí stav bez dané techniky a zaznamenal jak průměrnou výkonnost, tak závažnost jednotlivých selhání.
Změňte v příkladu otravy dat jeden předpoklad a analýzu zopakujte. Odeberte nezbytný vstup, přidejte protichůdný signál, omezte výpočetní kapacitu, změňte skupinu uživatelů nebo systém přinuťte zdržet se odpovědi. Mechanismus, který uspěje jen při jedné pečlivě připravené ukázce, neprokázal, že se uplatní i v provozním prostředí.
Otrava dat a její nejčastější zkratka
Otrava dat se často redukuje na útok, který obchází detekci až po nasazení modelu. Tím se stírá právě ta hranice, která tento pojem vymezuje. Kupující pak mohou srovnávat nesrovnatelné produkty, výzkumníci přeceňovat, co jejich experiment dokládá, a provozovatelé po nasazení sledovat nesprávný signál.
| Hledisko | Praktická odpověď |
|---|---|
| Definice | Otrava dat spočívá v manipulaci s trénovacími, dolaďovacími, vyhodnocovacími nebo vyhledávacími daty tak, aby se systém umělé inteligence naučil chybnému chování nebo vytvářel výsledky zvolené útočníkem. |
| Záměna | útok založený na obcházení detekce, který se uplatňuje až po nasazení modelu. |
| Riziko | malá cílená podmnožina může být v datech webového rozsahu obtížně odhalitelná. |
Srovnání by mělo také určit jednotku analýzy. Studie o otravě dat se může zaměřovat na samostatný model nebo algoritmus, zatímco nasazená služba zahrnuje také vyhledávání, směrování, ukládání do mezipaměti, zásady, identitu, uživatelská rozhraní a monitorování. Dva produkty mohou používat stejný zastřešující termín, a přitom implementovat různé části tohoto souboru komponent. Ptejte se, která komponenta provádí klíčovou transformaci a které další komponenty jsou nezbytné pro uváděný výsledek.
Proč je otrava dat v současných systémech umělé inteligence důležitá
Otrava dat je dnes důležitá, protože systémy umělé inteligence získávají větší kontextová okna, více modalit, více výpočetních prostředků za běhu, širší přístup k nástrojům a hlubší napojení na rozhodování organizací. Za těchto podmínek může to, co se dříve jevilo jako podružný výzkumný detail, rozhodovat o latenci, bezpečnosti, přístupnosti, dopadu na životní prostředí, kvalitě produktu nebo právní odpovědnosti.
Podstatné není, zda otrava dat dokáže přinést jeden působivý výsledek. Důležité je, zda tato technika zlepšuje výsledek, na němž záleží, v reprezentativních podmínkách a účinněji než jednodušší výchozí řešení. Namísto převedení všech výsledků na jediný průměr uvádějte rozložení výsledků, kategorie selhání, latenci v krajních případech, spotřebu zdrojů a dotčené podskupiny.
Sledujte technické metriky i dopady na lidi. Dokumentujte nejistotu, zachovávejte informace o původu a návaznosti dat, umožněte eskalaci a navrhněte postup obnovy ještě před vystavením systému proměnlivým podmínkám reálného světa. Uplatní-li se tento přístup konkrétně na otravu dat, budou získané poznatky přenositelné: jiný tým může posoudit, zda deklarované zlepšení pravděpodobně obstojí i při použití jiného modelu, jazyka, hardwarové platformy, datové sady, uživatelské populace nebo míry tolerance rizika.
Přínosy, které může otrava dat přinést
Nejsilnějším důvodem k použití otravy dat je možnost přímo řešit problém, na který je zaměřena. V závislosti na konkrétní implementaci se přínos může projevit lepším ukotvením, věrnější reprezentací, lepší schopností zobecňovat, nižší latencí, menším přesunem dat v paměti, jasnější odpovědností nebo bezpečnějším rozhraním mezi návrhem modelu a skutečnou akcí.
Přínosy je třeba vyjádřit prostřednictvím rozhodovacích kritérií a měření. „Vyšší inteligence“ není pro otravu dat kritériem přijatelnosti. Užitečný cíl může například stanovit míru chybovosti u obtížných případů, schopnost obnovy při protichůdných důkazech, náklady při určitém percentilu provozu, čas potřebný k lidské kontrole, kalibraci nebo procentní podíl akcí udržených v rámci stanoveného limitu oprávnění.
Selhání, které definuje otravu dat
Zásadním omezením je, že malou cílenou podmnožinu může být v datech webového rozsahu obtížné odhalit. Toto selhání nelze považovat za dodatečnou poznámku, kterou stačí uvést po dokončení vývoje. Od samého počátku by mělo ovlivňovat sběr dat, architekturu, oprávnění, vyhodnocování, podmínky pro uvedení do provozu i monitorování při otravě dat.
Kontrolní opatření proti otravě dat jsou užitečná pouze tehdy, pokud zasáhnou dříve, než nastanou nákladné nebo nevratné důsledky. Určete nejčasnější pozorovatelný předzvěstný signál selhání, stanovte práh nebo pravidlo, určete odpovědnou osobu a otestujte obnovu. V závislosti na konkrétním použití může obnova znamenat odmítnutí odpovědi, přechod na jednodušší systém, vyžádání dalších důkazů, eskalaci případu k člověku, návrat k předchozí verzi modelu nebo úplné zastavení akce.
Plán vyhodnocování otravy dat
Vyhodnocování otravy dat začněte tím, že sepíšete, jaké rozhodnutí mají důkazy podpořit. Vymezte provozní populaci, důsledky chybného výsledku, informace skutečně dostupné v okamžiku rozhodování a nejjednodušší věrohodnou alternativu. Zabráníte tak tomu, aby se měřítkem úspěchu stal benchmark jen proto, že se snadno spouští.
Pro kontrolované srovnání použijte nedotčenou testovací sadu a poté otravu dat ověřte v postupně zaváděném provozním prostředí. Offline vyhodnocení umožňuje porovnávat jednotlivé varianty; režim stínového provozu, kanárková nasazení, limity četnosti nebo schvalovací brány odhalí, jak skutečný provoz, zpětnovazební smyčky a lidé mění chování. Fáze nasazení by měla mít výslovně stanovenou podmínku zastavení, místo aby se předpokládalo, že každé zlepšení opravňuje k plnému zavedení.
Verzujte vstupy potřebné k reprodukci otravy dat: zdrojová data, předzpracování, tokenizer nebo kodér, váhy modelu, konfiguraci, prompt nebo zásady, index pro vyhledávání, vyhodnocovací sadu, předpoklady týkající se hardwaru a obslužný kód, pokud se používají. Bez sledování původu dat tým nedokáže určit, zda změněný výsledek způsobil použitý postup, prostředí, nebo nepozorovaná úprava datového toku.
Nakonec se zeptejte, jaké zjištění by vyvrátilo tvrzení, že otrava dat přináší užitek. Pokud žádný výsledek nemůže změnit rozhodnutí o zavedení, jde při vyhodnocování o marketing. Předem stanovené prahové hodnoty přijatelnosti a zachovaná potvrzovací sada promění toto úsilí v důkazy.
Otázky, které si položit před zavedením otravy dat
- Cíl: Jaké měřitelné úzké místo má otrava dat vyřešit?
- Mechanismus: Ve které z pěti fází probíhá charakteristická transformace?
- Srovnávací základ: Jak si vede ve srovnání s útokem na obcházení provedeným až po nasazení modelu nebo s jinou jednodušší alternativou?
- Důkazy: Které běžné, náročné, adversariální případy a případy z jednotlivých podskupin byly testovány?
- Provoz: Jaké náklady na latenci, paměť, výpočetní výkon, energii, údržbu a kontrolu se projeví ve velkém měřítku?
- Riziko: Jak tým zjistí, že malou cílenou podmnožinu lze ve webových datech obrovského rozsahu jen obtížně odhalit?
- Obnova: Dokáže systém před vznikem škody odmítnout odpovědět, přejít na záložní řešení, vrátit změny nebo předat případ k eskalaci?
Základní zdroje ke studiu otravy dat
Mezi důvěryhodné výchozí zdroje k části ekosystému AI související s otravou dat patří Rámec řízení rizik AI od NIST, specifikace C2PA a Rámec ochrany soukromí od NIST. Prostudujte je spolu s dokumentací ke konkrétnímu modelu, datové sadě, hardwaru a příslušné jurisdikci. Obecný zdroj může definovat mechanismus, ale vhodnost konkrétní implementace mohou potvrdit pouze důkazy z jejího nasazení.
Co si zapamatovat o otravě dat
Otrava dat je přesně vymezený mechanismus fungující v rámci širšího sociotechnického systému. Její přínos spočívá ve zlepšení konkrétního výsledku za výslovně stanovených podmínek, nikoli v samotném označení. Schéma pěti fází zviditelňuje tok informací, srovnání ukazuje, o co nejde, a kontrolní postup objasňuje, kde může odpovědný provozovatel zasáhnout.
Praktické pravidlo pro otravu dat zní: vymezte cíl, porovnejte výsledek s věrohodným srovnávacím základem, otestujte nejzávažnější způsob selhání a uchovejte důkazy potřebné ke sledování změn. S těmito prvky se z tohoto konceptu stává technické a správní rozhodnutí, které lze vyhodnotit. Bez nich zůstává jen slibně znějícím názvem spojeným s neznámým provozním rizikem.



