
Základy AI
Co jsou modely pro vidění a jazyk (VLM)? Jak umělá inteligence propojuje obraz a slova
Modely vidění a jazyka propojují vizuální příznaky s jazykem, takže systém může pomocí slov popisovat obrázky, porovnávat je, vyhledávat v nich nebo o nich uvažovat. Tento průvodce vysvětluje mechanismus, kompromisy, vyhodnocování a kontrolní prvky, na kterých v praxi záleží.

 Přidejte Unite.AI mezi své preferované zdroje na Google
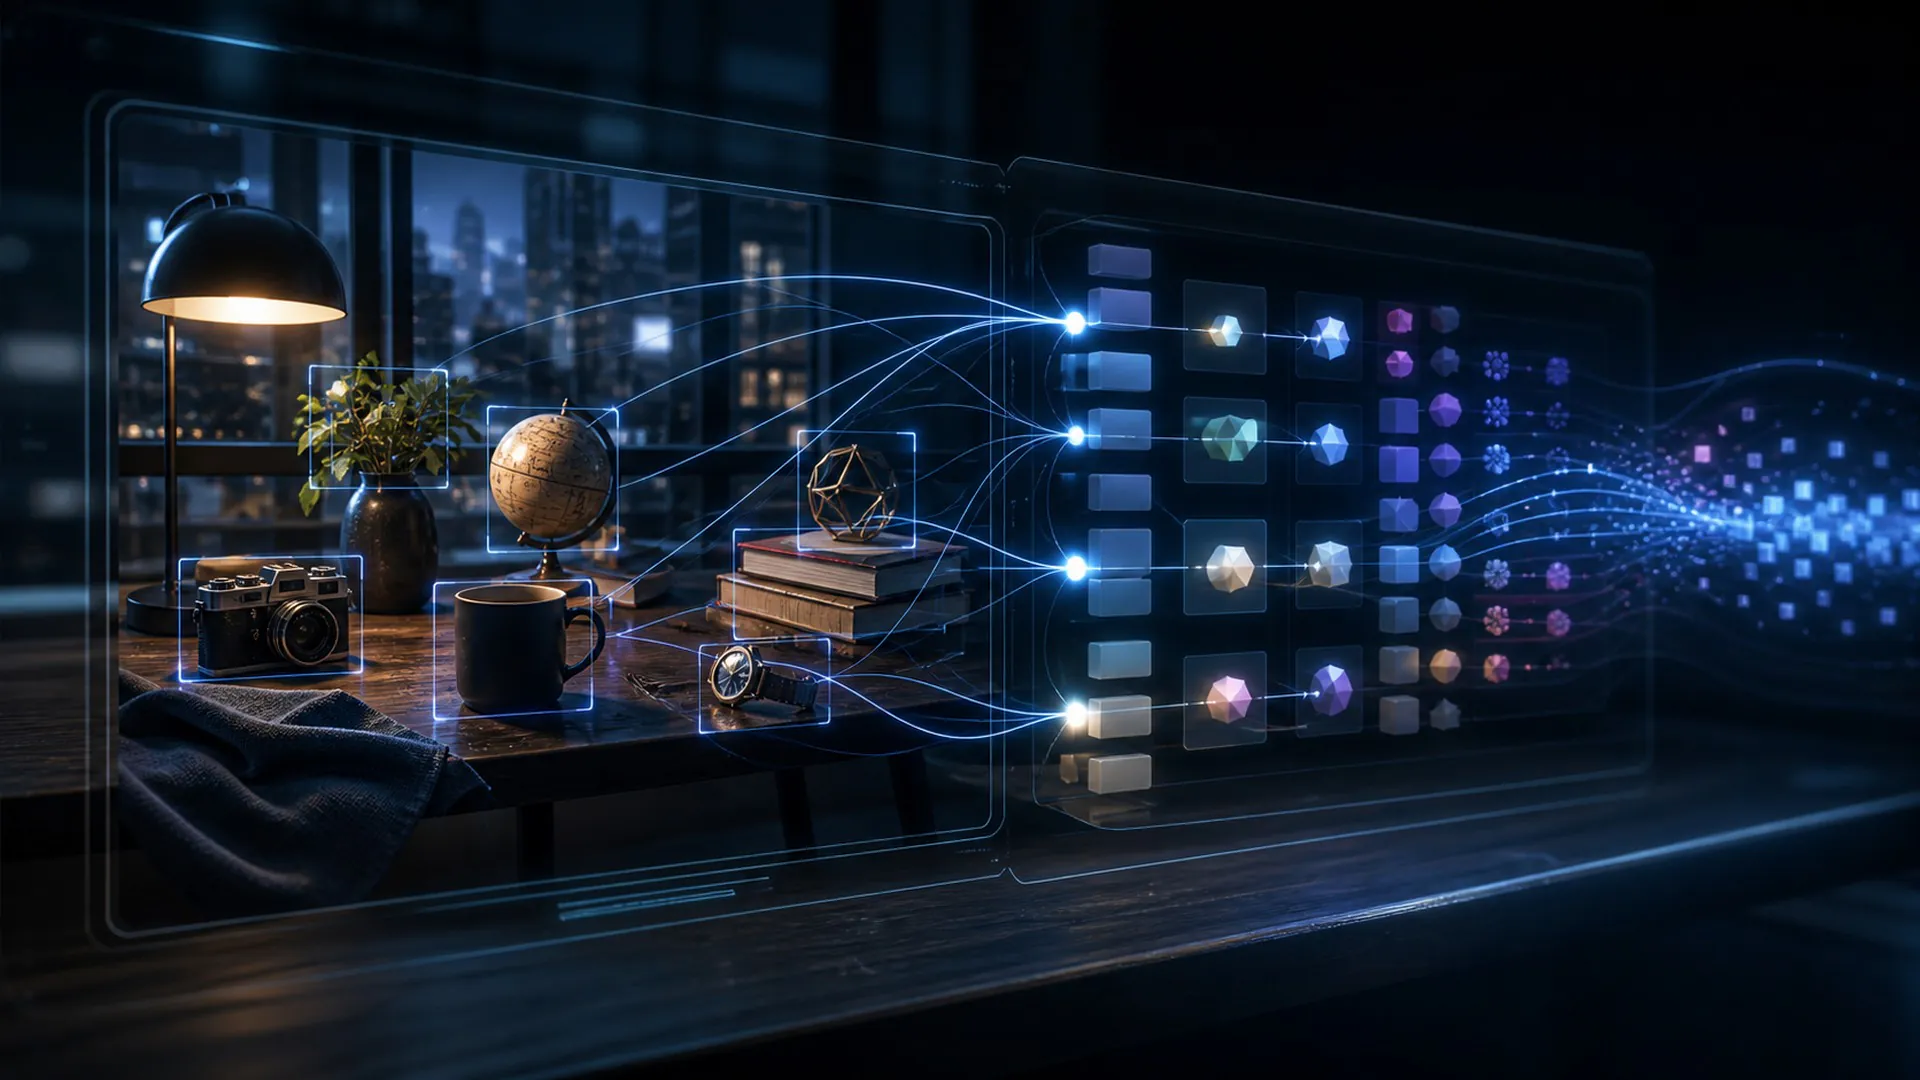
Modely pro vidění a jazyk propojují vizuální rysy s jazykem, aby systém mohl pomocí slov obrazy popisovat, porovnávat, vyhledávat v nich nebo o nich uvažovat.
Modely pro vidění a jazyk si zaslouží přesné vysvětlení, protože jejich název označuje konkrétní tok informací, způsob trénování, mechanismus fungování za běhu nebo hranici odpovědnosti. Považovat je za synonymum pro „pokročilou umělou inteligenci“ znemožňuje tvrzení ověřovat. Tento průvodce sleduje daný koncept od vstupu a předpokladů až po pozorovatelný výsledek a poté prověřuje zjednodušení, s nímž by mohl být nejspíše zaměněn.
Modely pro vidění a jazyk: definice, hranice a účel
Modely pro vidění a jazyk propojují vizuální rysy s jazykem, aby systém mohl pomocí slov obrazy popisovat, porovnávat, vyhledávat v nich nebo o nich uvažovat. Definice zahrnuje tři praktické závazky: existuje identifikovatelný vstup, transformace nebo rozhodnutí charakteristické pro modely pro vidění a jazyk a výsledek, který lze vyhodnotit vůči stanovenému cíli. Pokud některý z těchto prvků chybí, může označení popisovat spíše záměr než zavedený mechanismus.
Multimodální systémy musí sladit signály, které se liší rozlišením, načasováním, mírou šumu i nejednoznačností. Slovo se může vztahovat k malé oblasti obrazu; zvuková událost může předcházet snímku videa, který ji vysvětluje. U modelů pro vidění a jazyk je tento systémový pohled důležitý, protože výkon mohou určovat okolní data, rozhraní, hardware, oprávnění i lidé, přestože samotný model zůstává stejný. Užitečné vysvětlení proto odlišuje naučené chování modelu od produktu, který rozhoduje, kdy, kde a s jakou pravomocí se toto chování použije.
Nejbližším zavádějícím zjednodušením je počítačové vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu. S modely pro vidění a jazyk může sdílet zjevný rys, mění však příčinnou souvislost: úspěch by dokládaly jiné důkazy, náklady by určovaly jiné zdroje a škodám by předcházely jiné kontrolní mechanismy. Hranice je tedy praktická, nikoli terminologická.
Provozní mapa modelů pro vidění a jazyk v pěti fázích
Diagram představuje stručnou mapu příčin a následků u modelů pro vidění a jazyk; netvrdí, že každá implementace používá pět softwarových komponent. Některé systémy fáze slučují, jiné je opakují v cyklu. Mapa je přesto užitečná, protože vyžaduje, aby každá změna informací nebo pravomocí měla odpovědný subjekt, vstup, výstup a způsob ověření.
1. Rozdělení obrazu na vizuální tokeny nebo jeho zakódování do vizuálních tokenů: vstup a předpoklady modelů pro vidění a jazyk
V této fázi modelů pro vidění a jazyk musí systém obraz rozdělit na vizuální tokeny nebo jej do nich zakódovat. Podstatnou otázkou není jen to, zda k této operaci dochází, ale také jaké informace zpracovává, jaký stav mění a jaké důkazy potvrzují správnost této změny. Posuzovatel by měl být schopen odlišit tuto operaci od počítačového vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu, a zopakovat její výsledek za stejných stanovených podmínek.
Předání do této fáze modelů pro vidění a jazyk začíná stanoveným cílem a mělo by končit výsledkem, který umožňuje zakódovat doprovodný text. Zaznamenávejte nejistotu, zamítnuté alternativy, využití zdrojů i případné lidské nebo softwarové zásahy u této hranice. Právě díky takové stopě mohou týmy odhalit, zda plynulé popisy pojmenovávají objekty nebo vztahy, které ve skutečnosti nejsou viditelné, dříve než se stejná slabina projeví ve výstupu se závažnými důsledky.
2. Zakódování doprovodného textu: reprezentace nebo rozhodnutí v modelech pro vidění a jazyk
V této fázi modelů pro vidění a jazyk musí systém zakódovat doprovodný text. Podstatnou otázkou není jen to, zda k této operaci dochází, ale také jaké informace zpracovává, jaký stav mění a jaké důkazy potvrzují správnost této změny. Posuzovatel by měl být schopen odlišit tuto operaci od počítačového vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu, a zopakovat její výsledek za stejných stanovených podmínek.
Předání do této fáze modelů vidění a jazyka začíná rozdělením obrazu nebo jeho zakódováním do vizuálních tokenů a mělo by končit výsledkem, který umožňuje propojit obě reprezentace. Na tomto rozhraní zaznamenejte nejistotu, zamítnuté alternativy, spotřebu zdrojů i veškerou lidskou nebo softwarovou kontrolu. Právě díky tomuto záznamu mohou týmy zjistit, zda plynulé popisy pojmenovávají objekty nebo vztahy, které ve skutečnosti nejsou viditelné, ještě než se stejná slabina projeví ve výstupu se závažnými důsledky.
3. Propojení obou reprezentací: charakteristická transformace v modelech vidění a jazyka
V této fázi modelů vidění a jazyka musí systém propojit obě reprezentace. Podstatné není jen to, zda k této operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že tato změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od počítačového vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu, a zopakovat její výsledek za stejných uvedených podmínek.
Předání do této fáze modelů vidění a jazyka začíná zakódováním doprovodného textu a mělo by končit výsledkem, který umožňuje zaměřit pozornost na různé oblasti a fráze. Na tomto rozhraní zaznamenejte nejistotu, zamítnuté alternativy, spotřebu zdrojů i veškerou lidskou nebo softwarovou kontrolu. Právě díky tomuto záznamu mohou týmy zjistit, zda plynulé popisy pojmenovávají objekty nebo vztahy, které ve skutečnosti nejsou viditelné, ještě než se stejná slabina projeví ve výstupu se závažnými důsledky.
4. Zaměření pozornosti na oblasti a fráze: hranice omezení a ověřování v modelech vidění a jazyka
V této fázi modelů vidění a jazyka se systém musí zaměřovat na různé oblasti a fráze. Podstatné není jen to, zda k této operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že tato změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od počítačového vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu, a zopakovat její výsledek za stejných uvedených podmínek.
Předání do této fáze modelů vidění a jazyka začíná propojením obou reprezentací a mělo by končit výsledkem, který umožňuje dekódovat odpověď nebo akci opřenou o vizuální podklady. Na tomto rozhraní zaznamenejte nejistotu, zamítnuté alternativy, spotřebu zdrojů i veškerou lidskou nebo softwarovou kontrolu. Právě díky tomuto záznamu mohou týmy zjistit, zda plynulé popisy pojmenovávají objekty nebo vztahy, které ve skutečnosti nejsou viditelné, ještě než se stejná slabina projeví ve výstupu se závažnými důsledky.
5. Dekódování odpovědi nebo akce opřené o vizuální podklady: výstup, zpětná vazba a pravidlo ukončení v modelech vidění a jazyka
V této fázi modelů vidění a jazyka musí systém dekódovat odpověď nebo akci opřenou o vizuální podklady. Podstatné není jen to, zda k této operaci dochází, ale také jaké informace využívá, jaký stav mění a jaké důkazy potvrzují, že tato změna byla platná. Posuzovatel by měl být schopen odlišit tuto operaci od počítačového vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu, a zopakovat její výsledek za stejných uvedených podmínek.
Předání do této fáze modelů vidění a jazyka začíná zaměřením pozornosti na různé oblasti a fráze a mělo by končit výsledkem, který umožňuje provádět monitorování nebo přijmout konečné rozhodnutí. Na tomto rozhraní zaznamenejte nejistotu, zamítnuté alternativy, spotřebu zdrojů i veškerou lidskou nebo softwarovou kontrolu. Právě díky tomuto záznamu mohou týmy zjistit, zda plynulé popisy pojmenovávají objekty nebo vztahy, které ve skutečnosti nejsou viditelné, ještě než se stejná slabina projeví ve výstupu se závažnými důsledky.
Mapu modelů vidění a jazyka čtěte dopředu, chcete-li porozumět fungování v produkčním prostředí, a zpětně, chcete-li diagnostikovat chybu. Analýza dopředu sleduje, jak jedna fáze poskytuje vstupy následující fázi. Analýza zpětně vychází z nesprávného, pomalého, nákladného nebo nebezpečného výsledku a sleduje, který dřívější předpoklad k němu vedl. Právě při zpětném postupu tým často zjistí, že rozhodující chyba nastala ještě předtím, než model cokoli vytvořil.
Ukázkový příklad modelů vidění a jazyka
Model vidění a jazyka může prozkoumat snímek obrazovky s řídicím panelem a vysvětlit, který graf podporuje písemné tvrzení.
Tento příklad je poučný, protože modely vidění a jazyka lze posuzovat na základě pozorovatelných vstupů, mezistavů a výsledků, nikoli jen podle působivé ukázky. Důkladný test by pro daný scénář připravil běžné, obtížné i záměrně zavádějící případy, zachoval výchozí srovnávací variantu bez dané techniky a zaznamenával jak průměrný výkon, tak závažnost jednotlivých selhání.
Změňte jeden předpoklad v příkladu s modelem vidění a jazyka a analýzu zopakujte. Odeberte nezbytný vstup, přidejte protichůdný signál, omezte výpočetní výkon, změňte populaci uživatelů nebo systém přimějte, aby se zdržel odpovědi. Mechanismus, který uspěje jen v jediné pečlivě připravené ukázce, zatím neprokázal, že se dokáže zobecnit na provozní prostředí.
Modely vidění a jazyka vs. jejich nejběžnější zkratka
Modely vidění a jazyka se často redukují na počítačové vidění, které předpovídá pevně daný štítek bez otevřeného jazykového výstupu. Takové zjednodušení odstraňuje právě tu hranici, která tento pojem vymezuje. Může vést kupující ke srovnávání produktů, které nejsou srovnatelné, výzkumníky k přeceňování toho, co experiment prokazuje, a provozovatele ke sledování nesprávného signálu po nasazení.
| Hledisko | Praktická odpověď |
|---|---|
| Definice | Vizuálně-jazykové modely propojují vizuální příznaky s jazykem, takže systém může obrázky popisovat, porovnávat, vyhledávat v nich nebo o nich uvažovat pomocí slov. |
| Častý omyl | počítačové vidění, které předpovídá pevně stanovený štítek bez možnosti vytvářet otevřené jazykové výstupy. |
| Riziko | plynulé popisy mohou označovat objekty nebo vztahy, které ve skutečnosti nejsou viditelné. |
Srovnání by mělo také určit jednotku analýzy. Studie vizuálně-jazykových modelů se může zaměřovat na samostatný model nebo algoritmus, zatímco nasazená služba přidává vyhledávání, směrování, ukládání do mezipaměti, zásady, identitu, uživatelská rozhraní a monitorování. Dva produkty mohou používat stejný zastřešující termín, a přitom implementovat různé části tohoto souboru komponent. Zjistěte, která komponenta provádí určující transformaci a které další komponenty jsou nezbytné k dosažení uváděného výsledku.
Proč jsou vizuálně-jazykové modely důležité v současných systémech AI
Vizuálně-jazykové modely jsou dnes důležité, protože systémy AI dostávají větší kontexty, pracují s více modalitami, mají k dispozici více výpočetního výkonu za běhu, širší přístup k nástrojům a jsou těsněji propojené s rozhodováním v organizacích. Za těchto podmínek může něco, co dříve vypadalo jako výzkumný detail, rozhodovat o latenci, zabezpečení, přístupnosti, dopadu na životní prostředí, kvalitě produktu nebo právní odpovědnosti.
Rozhodující není, zda vizuálně-jazykové modely dokážou podat jeden působivý výkon. Podstatné je, zda daná technika zlepšuje důležitý výsledek v reprezentativních podmínkách a zda to dokáže účinněji než jednodušší výchozí metoda. Namísto sloučení všech výsledků do jediného průměru uvádějte rozdělení hodnot, kategorie selhání, latenci v koncových částech rozdělení, spotřebu zdrojů a skupiny, jichž se dopady týkají.
Při vyhodnocování je třeba izolovat jednotlivé modality, testovat rozporné vstupy a ověřovat ukotvení v čase či prostoru. Plynulá odpověď napříč modalitami nedokazuje, že model věnoval pozornost správnému signálu. Uplatnění tohoto přístupu konkrétně na vizuálně-jazykové modely zajišťuje přenositelnost důkazů: jiný tým může posoudit, zda lze očekávat, že deklarované zlepšení přetrvá i při použití jiného modelu, jazyka, hardwarové platformy, datové sady, uživatelské populace nebo míry tolerance rizika.
Jaké přínosy mohou vizuálně-jazykové modely přinést
Nejsilnějším důvodem pro použití vizuálně-jazykových modelů je, že mohou přímo řešit problém, k jehož odstranění jsou určeny. V závislosti na konkrétní implementaci se přínos může projevit přesnějším ukotvením, věrnější reprezentací, lepší schopností zobecňovat, nižší latencí, menším přesunem dat v paměti, jasnější odpovědností nebo bezpečnějším oddělením návrhu modelu od skutečného úkonu.
Přínosy je třeba vyjadřovat prostřednictvím rozhodnutí a měřitelných ukazatelů. „Vyšší inteligence“ není pro vizuálně-jazykové modely kritériem přijatelnosti. Užitečný cíl může například stanovit chybovost u obtížných případů, schopnost napravit výsledek po předložení rozporných důkazů, náklady při určitém percentilu provozu, dobu potřebnou k lidské kontrole, kalibraci nebo procentní podíl úkonů, které zůstávají v rámci stanoveného limitu pravomocí.
Selhání, které definuje vizuálně-jazykové modely
Zásadním omezením je, že plynulé popisy mohou označovat objekty nebo vztahy, které ve skutečnosti nejsou viditelné. Toto selhání nelze považovat za dodatečnou poznámku, kterou stačí uvést po dokončení vývoje. Od samého začátku by mělo ovlivňovat sběr dat, architekturu, oprávnění, vyhodnocování, podmínky pro uvedení do provozu i monitorování vizuálně-jazykových modelů.
Kontrolní prvek pro modely vidění a jazyka je užitečný pouze tehdy, pokud zasáhne dříve, než dojde k nákladnému nebo nevratnému důsledku. Určete nejčasnější pozorovatelný příznak selhání, stanovte práh nebo pravidlo, určete odpovědnou osobu a otestujte obnovu. Podle konkrétního použití může obnova znamenat zdržet se odpovědi, přejít na jednodušší systém, vyžádat si další důkazy, předat případ člověku, vrátit model do předchozího stavu nebo danou akci zcela zastavit.
Plán vyhodnocování modelů vidění a jazyka
Vyhodnocování modelů vidění a jazyka začněte tím, že písemně formulujete rozhodnutí, které mají důkazy podpořit. Určete populaci, v níž bude systém fungovat, důsledky nesprávného výsledku, informace skutečně dostupné v okamžiku rozhodování a nejjednodušší věrohodnou alternativu. Předejdete tak tomu, aby se cílem stal benchmark jen proto, že se snadno provádí.
Pro řízená srovnání použijte nedotčenou testovací sadu a poté modely vidění a jazyka ověřte v postupně zaváděném provozním prostředí. Offline vyhodnocení umožňuje porovnávat varianty; režim stínového provozu, kanárkové testy, limity četnosti nebo schvalovací brány ukazují, jak skutečný provoz, zpětnovazební smyčky a lidé mění chování. Fáze nasazení by měla mít jasně stanovenou podmínku zastavení, místo aby se předpokládalo, že každé zlepšení si zaslouží plné zavedení.
Pro možnost reprodukovat výsledky modelů vidění a jazyka verzujte potřebné vstupy: zdrojová data, předzpracování, tokenizér nebo kodér, váhy modelu, konfiguraci, prompt nebo pravidla, index pro vyhledávání, evaluační sadu, předpoklady týkající se hardwaru a obslužný kód, je-li to relevantní. Bez přehledu o původu a návaznosti jednotlivých verzí tým nedokáže určit, zda změnu výsledku způsobila daná technika, prostředí, nebo nepovšimnutá úprava v datovém procesu.
Nakonec se zeptejte, jaké zjištění by vyvrátilo tvrzení, že modely vidění a jazyka přinášejí užitek. Pokud by žádný výsledek nemohl zvrátit rozhodnutí o jejich nasazení, jde při vyhodnocování o marketing. Předem stanovené prahové hodnoty přijatelnosti a zachovaná potvrzovací sada promění toto úsilí v důkazy.
Otázky, které si položit před zavedením modelů vidění a jazyka
- Cíl: Které měřitelné úzké místo mají modely vidění a jazyka řešit?
- Mechanismus: Ve které z pěti fází probíhá charakteristická transformace?
- Výchozí srovnání: Jak si model vede ve srovnání s počítačovým viděním, které předpovídá pevně daný štítek bez otevřeného jazyka, nebo s jinou jednodušší alternativou?
- Důkazy: Které běžné, obtížné, adversariální a podskupinové případy byly testovány?
- Provoz: Jaké náklady na latenci, paměť, výpočetní výkon, energii, údržbu a kontrolu se projeví při větším rozsahu nasazení?
- Riziko: Jak tým zjistí, že plynulé popisy mohou pojmenovávat objekty nebo vztahy, které ve skutečnosti nejsou viditelné?
- Obnova: Může se systém zdržet odpovědi, přejít na náhradní řešení, vrátit se k předchozímu stavu nebo předat případ výše, ještě než dojde k újmě?
Základní zdroje ke studiu modelů vidění a jazyka
Mezi důvěryhodné výchozí zdroje pro část technologického stacku AI, která obklopuje modely vidění a jazyka, patří výzkumná práce o CLIP a vtělený multimodální model PaLM-E. Čtěte je spolu s dokumentací ke konkrétnímu modelu, datové sadě, hardwaru a jurisdikci. Obecný zdroj může objasnit mechanismus, ale vhodnost konkrétní implementace lze doložit pouze důkazy vztahujícími se ke konkrétnímu nasazení.
Co si zapamatovat o modelech vidění a jazyka
Modely vidění a jazyka jsou vymezeným mechanismem v rámci širšího sociotechnického systému. Jejich přínos spočívá ve zlepšení konkrétního výsledku za výslovně stanovených podmínek, nikoli v samotném označení. Mapa pěti fází znázorňuje tok informací, srovnání ukazuje, čím tento mechanismus není, a popis kontrolní cesty ukazuje, kde může odpovědný provozovatel zasáhnout.
Praktické pravidlo pro modely vidění a jazyka zní: stanovte cíl, porovnejte je s věrohodným výchozím řešením, otestujte nejdůležitější způsob selhání a uchovejte důkazy potřebné ke sledování změn. S těmito prvky se tento koncept stává technickým a správním rozhodnutím, které lze vyhodnotit. Bez nich zůstává jen slibným označením spojeným s neznámým provozním rizikem.


