Modely a platformy AI
Modelové směrovače a past feedbacku: Jak se AI učí od sebe

 Přidejte Unite.AI mezi své preferované zdroje na Google

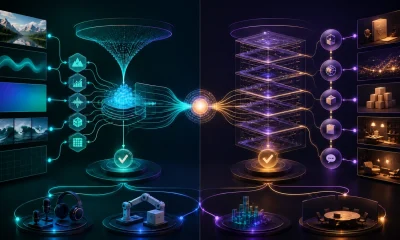
Moderní systémy AI již nejsou postaveny kolem jediného modelu, který zpracovává všechny úkoly. Místo toho spoléhají na kolekce modelů, každý navržen pro specifické účely. V centru tohoto nastavení je modelový směrovač, komponent, který interpretuje požadavek uživatele a rozhodne, který model by měl být použit. Například v systémech, jako je OpenAI’s GPT-5, směrovač může poslat jednoduchý dotaz na lehký model pro rychlost, zatímco směruje komplexní úkoly rozumného uvažování na pokročilejší model.
Směrovače nejsou jen manažeři provozu. Učí se z chování uživatelů, jako je když lidé přepínají mezi modely nebo preferují určitou odpověď. To vytváří cyklus: směrovač přiřazuje dotaz, model produkuje odpověď, reakce uživatelů poskytují zpětnou vazbu a směrovač aktualizuje svá rozhodnutí. Když tyto cykly fungují tiše na pozadí, mohou vytvořit skryté smyčky zpětné vazby. Tyto smyčky mohou zesílit předpojatost, posílit vadné vzorce nebo postupně snižovat výkon způsobem, který je obtížné zjistit.
Tento článek se zabývá tím, jak modelové směrovače fungují, jak se vytvářejí smyčky zpětné vazby a jaké rizika představují, když systémy AI pokračují ve vývoji.
Pochopení modelových směrovačů v AI
Modelový směrovač je rozhodovací vrstva v multi-modelovém systému AI. Jeho role je určit, který model nejlépe vyhovuje úkolu. Volba závisí na faktorech, jako je složitost dotazu, záměr uživatele, kontext a kompromisy mezi náklady, přesností a rychlostí.
Na rozdíl od systémů, které následují pevná pravidla, většina modelových směrovačů jsou systémy strojového učení samy o sobě. Jsou trénovány na reálných signálech a přizpůsobují se časem. Mohou se učit z chování uživatelů, jako je přepínání mezi modely, hodnocení odpovědí nebo reformulování dotazů, stejně jako z automatizovaných hodnocení, která měří kvalitu výstupu.
Tato adaptabilita činí směrovače mocnými, ale také riskantními. Zvyšují efektivitu a poskytují lepší uživatelskou zkušenost, ale stejné procesy zpětné vazby, které vylepšují jejich rozhodnutí, mohou také vytvořit posilující smyčky. Časem tyto smyčky mohou ovlivnit nejen strategie směrování, ale také to, jak se celý systém AI chová.
Jak se vytvářejí smyčky zpětné vazby
Smyčka zpětné vazby nastává, když výstup systému ovlivňuje data, ze kterých se později učí. Jednoduchým příkladem je systém doporučení: pokud kliknete na sportovní video, systém vám ukáže více sportovního obsahu, který tvaruje, co budete sledovat dále. Časem systém posiluje své vlastní vzorce. Další příklad, který ilustruje smyčku zpětné vazby, je prediktivní policie. Algoritmus může předpovídat vyšší kriminalitu v určitých čtvrtích, což může vést k více patrolám. Zvýšené patroláže odhalí více incidentů, které pak potvrzují předpověď algoritmu. Systém vypadá jako přesný, ale data jsou zkreslena jeho vlastním vlivem. Smyčky zpětné vazby mohou být přímé nebo skryté. Přímé smyčky jsou snadno rozpoznatelné, jako je systém doporučení, který se opět učí ze svých vlastních návrhů. Skryté smyčky jsou více záludné, protože vznikají, když různé části systému nepřímo ovlivňují navzájem.
Modelové směrovače mohou vytvářet podobné smyčky. Rozhodnutí směrovače tvaruje, který model produkuje odpověď. Ta odpověď tvaruje chování uživatelů, které se stává zpětnou vazbou pro směrovač. Časem směrovač může začít posilovat vzorce, které fungovaly v minulosti, místo aby konzistentně volil nejlepší model. Tyto smyčky jsou obtížné detekovat a mohou tiše tlačit systémy AI do nechtěných směrů.
Proč smyčky zpětné vazby ve směrovačích jsou riskantní
Zatímco smyčky zpětné vazby pomáhají směrovačům zlepšovat při přiřazování úkolů, také nesou rizika, která mohou zkreslit chování systému. Jedno z rizik je posílení počátečních předpojatostí. Pokud směrovač opakovaně posílá určitý typ dotazu na Model A, většina zpětné vazby bude pocházet z výstupů Modelu A. Směrovač může poté předpokládat, že Model A je vždy nejlepší, a odstranit Model B, i když by mohl někdy fungovat lépe. Tento nerovnoměrný použití se může stát sebesmyslným. Modely, které fungují dobře na směrované úkoly, přitahují více požadavků, které posilují jejich silné stránky. Méně používané modely mají méně příležitostí ke zlepšení, což vytváří nerovnováhu a snižuje rozmanitost.
Předpojatosti mohou také pocházet z modelů hodnocení, které se používají k hodnocení správnosti. Pokud “soudní” model má slepá místa, jeho předpojatosti jsou přímo předány směrovači, který se pak optimalizuje pro hodnoty soudce místo skutečných potřeb uživatelů. Chování uživatelů přidává další úroveň složitosti. Pokud směrovač tenduje k návratu certain stylů odpovědí, uživatelé mohou přizpůsobit své dotazy, aby odpovídaly těmto vzorcům, posilují je ještě více. Časem to může zúžit jak chování uživatelů, tak odpovědi systému. Směrovače mohou také naučit se spojovat certain vzorce dotazů nebo demografické údaje se specifickými modely. To může vést k systematicky odlišným zkušenostem napříč skupinami, potenciálně posilující a zesilující existující společenské předpojatosti.
Další klíčovou obavou je dlouhodobý drift. Rozhodnutí, která směrovač činí dnes, ovlivňují trénovací data, která se použijí zítra. Pokud se modely opět učí z výstupů ovlivněných směrováním, mohou se naučit preference směrovače místo nezávislých přístupů. To může udělat odpovědi napříč modely více uniformními a vložit předpojatosti, které přetrvávají časem.
Strategie pro přerušení cyklu
Snížení rizik skrytých smyček vyžaduje aktivní návrh a dohled. Školení by mělo používat rozmanité zdroje dat, ne jen kliknutí uživatelů nebo přepínání. Občasné náhodné směrování může také zabránit tomu, aby jeden model monopolizoval určitý typ úkolu. Monitorování je nezbytné. Pravidelné audity mohou odhalit, zda se směrovač odchyluje směrem k určitým vzorcům nebo zda se příliš spoléhá na jeden model. Transparentnost v rozhodnutích směrovače pomáhá výzkumníkům detekovat předpojatost brzy.
Směrovače by se také měly opět učit pravidelně s čerstvými, vyváženými daty, aby se staré předpojatosti nezakonzervovaly. Zařazení lidského dohledu, zejména v citlivých oblastech, přidává další vrstvu odpovědnosti. Lidé mohou identifikovat, kdy směrovač systematicky upřednostňuje jeden model nebo nesprávně klasifikuje určitý dotaz.
Klíč je zacházet se směrovačem jako s modelem, který je ovlivněn zpětnou vazbou, a ne jako s pevnou nebo neutrální komponentou. Rozpoznáním toho, jak směrovače samy jsou tvarovány daty, která vytvářejí, výzkumníci a vývojáři mohou navrhnout systémy, které zůstávají spravedlivé, adaptivní a spolehlivé časem.
Závěrečné shrnutí
Modelové směrovače nabízejí jasné výhody v efektivitě a adaptabilitě, ale také nesou skrytá rizika. Smyčky zpětné vazby uvnitř těchto systémů mohou tiše zesílit předpojatost, omezit rozmanitost odpovědí a uzamknout modely do úzkých vzorců chování. Když se tyto architektury stávají stále častějšími, rozpoznání a řešení těchto rizik brzy bude klíčové pro stavbu systémů AI, které zůstávají spravedlivé, spolehlivé a skutečně adaptivní.