
Modely a platformy AI
Generativní AI: Principy za ChatGPT, DALL-E, Midjourney a dalšími nástroji

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodyGenerativní modely umělé inteligence, jako je GPT-4, vytvářejí nový obsah na základě…
Zobrazit více
- Generativní modely umělé inteligence, jako je GPT-4, vytvářejí nový obsah na základě vzorců v datech, nikoli pouze predikují výstupy.
- Mechanismus pozornosti (attention mechanism) v transformerové architektuře umožňuje AI zaměřit se na relevantní části textu pro kvalitnější generování jazyka.
- Difuzní modely, například DALL-E 2, postupně přetvářejí šum na obrazy pomocí textových pokynů.
Svět umění, komunikace a našeho vnímání reality se rychle mění. Pokud se podíváme zpět na historii lidského pokroku, můžeme považovat vynález kola nebo objev elektřiny za monumentální skoky. Dnes se děje nová revoluce – most mezi lidskou kreativitou a strojovým počítáním. To je Generativní AI.
Generativní modely rozostřily hranici mezi lidmi a stroji. S příchodem modelů jako GPT-4, které využívají transformerové moduly, jsme se přiblížili k přirozené a kontextově bohaté generaci jazyka. Tyto pokroky pohánějí aplikace v oblasti tvorby dokumentů, systémů dialogu chatbotů a dokonce i syntetické hudby.
Nedávná rozhodnutí velkých technologických firem podtrhují jeho význam. Microsoft (MSFT ) již ukončuje svou aplikaci Cortana tento měsíc, aby se zaměřil na novější inovace Generativní AI, jako je Bing Chat. Apple (AAPL ) také věnoval významnou část své $22,6 miliardového rozpočtu na výzkum a vývoj pro Generativní AI, jak uvedl generální ředitel Tim Cook.
Nová éra modelů: Generativní vs. Diskriminativní
Příběh Generativní AI není pouze o jejích aplikacích, ale fundamentálně o jejích vnitřních principech. V ekosystému umělé inteligence existují dva modely: diskriminativní a generativní.
Diskriminativní modely jsou to, s čím se většina lidí setkává v denním životě. Tyto algoritmy berou vstupní data, jako je text nebo obrázek, a spojují je s cílovým výstupem, jako je překlad slova nebo lékařská diagnóza. Jsou to o mapování a předpovídání.
Generativní modely, na druhé straně, jsou tvůrci. Nejenom interpretují nebo předpovídají, ale generují nové, složité výstupy z vektorů čísel, které často nejsou ani spojeny s reálnými hodnotami.

Technologie za Generativními modely
Generativní modely vděčí za svou existenci hlubokým neuronovým sítím, sofistikovaným strukturám navrženým k napodobení funkcionality lidského mozku. Zachycením a zpracováním mnohostranných variací v datech tyto sítě slouží jako páteř mnoha generativních modelů.
Jak tyto generativní modely vznikají? Obvykle jsou postaveny s hlubokými neuronovými sítěmi, optimalizovanými pro zachycení mnohostranných variací v datech. Příkladem je generativní adversariální síť (GAN), kde dvě neuronové sítě, generátor a diskriminátor, soutěží a učí se od sebe v jedinečném učitelském-studentském vztahu. Od maleb až po style transfer, od hudby až po hraní her, tyto modely se vyvíjejí a rozšiřují způsoby, které byly dříve nepředstavitelné.
To se nezastaví u GAN. Variační autoenkodéry (VAE), jsou další klíčovou součástí generativních modelů. VAE vynikají svou schopností vytvářet fotorealistické obrázky ze zdánlivě náhodných čísel. Jak? Zpracováním těchto čísel prostřednictvím latentního vektoru se rodí umění, které odráží složitosti lidské estetiky.
Typy Generativní AI: Text na Text, Text na Obrázek
Transforméry a LLM
Článek “Attention Is All You Need” od Google (GOOGL ) Brain označuje posun v tom, jak přemýšlíme o textovém modelování. Místo složitých a sekvenčních architektur, jako jsou rekurentní neuronové sítě (RNN) nebo konvoluční neuronové sítě (CNN), model Transforméru zavedl koncept pozornosti, který znamená zaměřit se na různé části vstupního textu v závislosti na kontextu. Jednou z hlavních výhod byla snadnost paralelizace. Na rozdíl od RNN, které zpracovávají text sekvenčně, což je činí obtížnějšími pro škálování, Transforméry mohou zpracovávat části textu současně, což činí trénink rychlejší a efektivnější na velkých datech.

V dlouhém textu ne každé slovo nebo věta, kterou čtete, má stejnou důležitost. Některé části vyžadují více pozornosti na základě kontextu. To je to, co mechanismus pozornosti napodobuje.
Chcete-li pochopit to, přemýšlejte o větě: “Unite AI Publish AI a Robotics news.” Předpovídání dalšího slova vyžaduje porozumění tomu, co je nejdůležitější v předchozím kontextu. Termín ‘Robotics’ by mohl naznačit, že další slovo by mohlo být spojeno s konkrétním pokrokem nebo událostí v oblasti robotiky, zatímco ‘Publish’ by mohlo naznačit, že následující kontext by mohl být o nedávném publikování nebo článku.
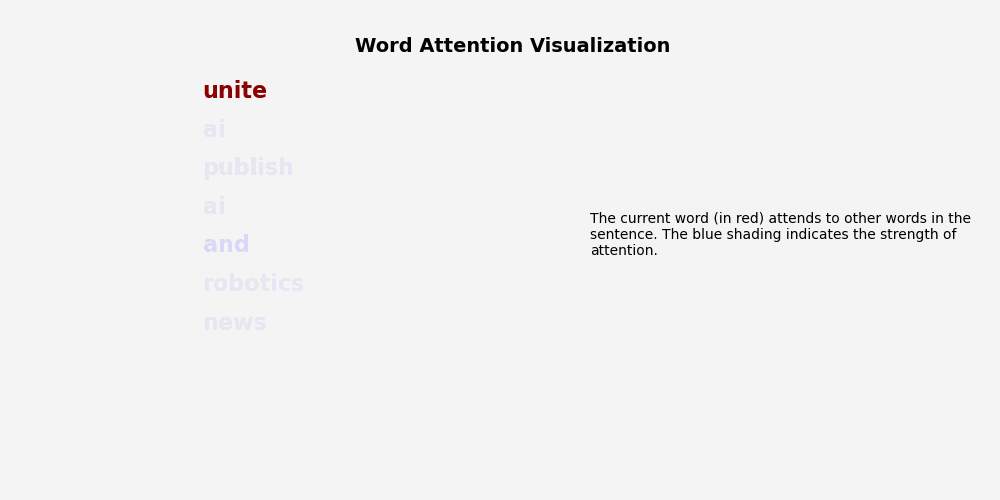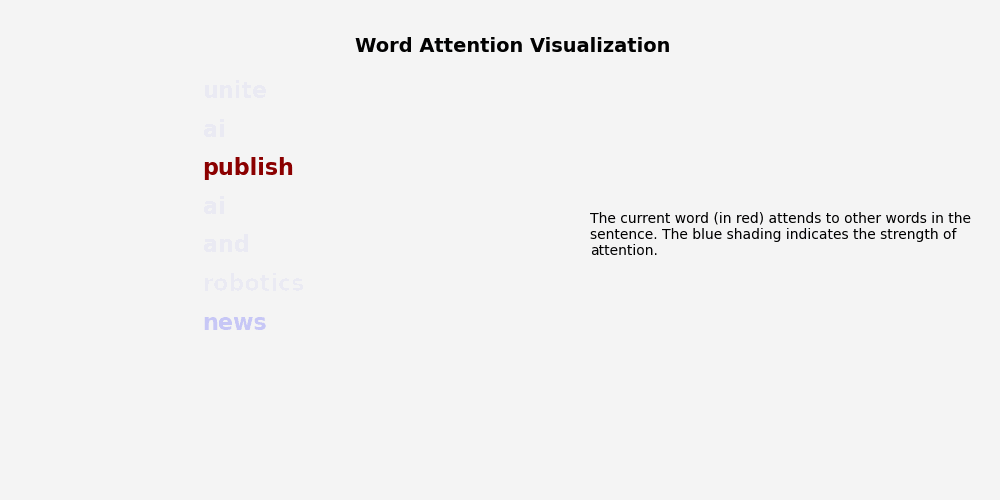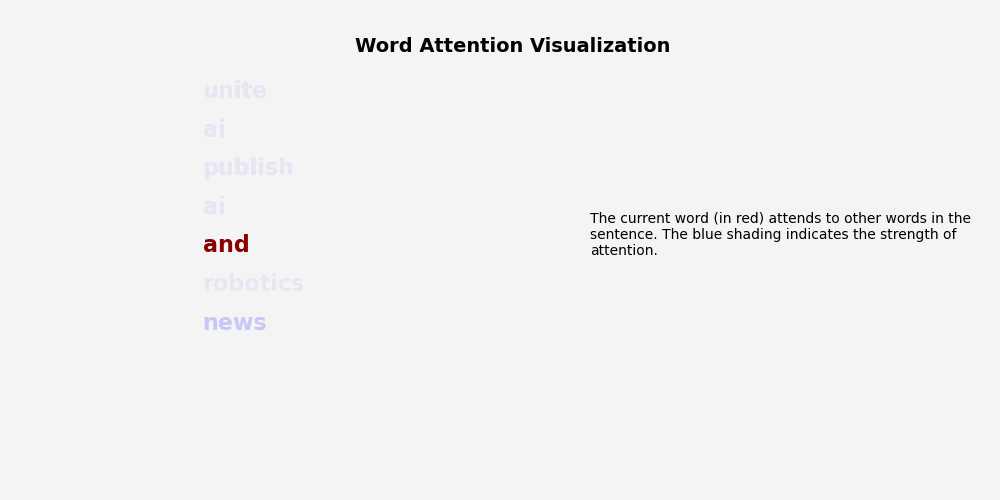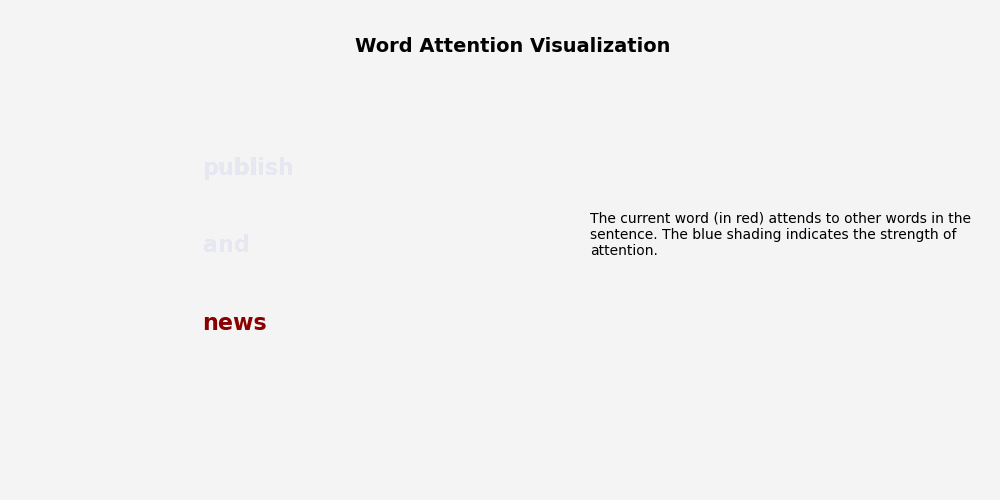
- Ilustrace mechanismu pozornosti
Mechanismy pozornosti v Transformérech jsou navrženy pro dosažení tohoto selektivního zaměření. Hodnotí důležitost různých částí vstupního textu a rozhodují, kam se “dívat”, když generují odpověď. To je odchod od starších architektur, jako jsou RNN, které se snažily vtěsnat esenci všech vstupních textů do jediného “stavu” nebo “paměti”.
Práce pozornosti lze přirovnat k systému vyhledávání podle klíčů a hodnot. Při pokusu o předpověď dalšího slova ve větě nabízí každé předchozí slovo “klíč”, který naznačuje jeho potenciální relevanci, a na základě toho, jak dobře tyto klíče odpovídají aktuálnímu kontextu (nebo dotazu), přispívají “hodnotou” nebo váhou k předpovědi.
Tyto pokročilé modely hlubokého učení se snadno integrovaly do různých aplikací, od vylepšení vyhledávacího engine Google s BERT až po GitHubův Copilot, který využívá schopnosti velké jazykové modely (LLM) pro převod jednoduchých kódových úryvků na plně funkční zdrojové kódy.
velké jazykové modely (LLM) jako GPT-4, Bard a LLaMA jsou obrovské konstrukce navržené pro rozluštění a generování lidského jazyka, kódu a dalšího. Jejich obrovská velikost, sahající od miliard do bilionů parametrů, je jednou z definujících vlastností. Tyto LLM jsou krmeny velkými množstvími textových dat, což jim umožňuje pochopit jemnosti lidského jazyka. Zajímavá vlastnost těchto modelů je jejich schopnost “few-shot” učení. Na rozdíl od konvenčních modelů, které potřebují velké množství specifických trénovacích dat, LLM mohou generalizovat z velmi omezeného počtu příkladů (nebo “shotů”)
Stav velké jazykové modely (LLM) k polovině roku 2023
| Název modelu | Vývojář | Parametry | Dostupnost a přístup | Významné vlastnosti a poznámky |
| GPT-4 | OpenAI | Počet nebyl zveřejněn; původní článek uvádí nepotvrzený odhad 1,5 bilionu | Není open source, přístup pouze přes API | Vynikající výkony v různých úkolech, může zpracovávat obrázky a text, maximální délka vstupu 32 768 tokenů |
| GPT-3 | OpenAI | 175 miliard | Není open source, přístup pouze přes API | Prokázal schopnosti few-shot a zero-shot učení. Provádí dokončování textu v přirozeném jazyce. |
| BLOOM | BigScience | 176 miliard | Model ke stažení, dostupné API | Multijazykový LLM vyvinutý globální spoluprací. Podporuje 13 programovacích jazyků. |
| LaMDA | 173 miliard | Není open source, bez API či možnosti stažení | Trénován na dialogu, může se naučit mluvit o téměř čemkoli | |
| MT-NLG | Nvidia /Microsoft | 530 miliard | Přístup přes API po podání žádosti | Využívá architekturu Megatron pro různé úkoly NLP. |
| LLaMA | Meta AI | 7 až 65 miliard | Model ke stažení po podání žádosti | Určen k demokratizaci AI tím, že nabízí přístup těm, kteří jsou ve výzkumu, vládě a akademii. |
Jak se používají LLM?
LLM lze použít několika způsoby, včetně:
- Přímé využití: Použití předtrénovaného LLM pro generování textu nebo zpracování. Například použití GPT-4 pro napsání blogového příspěvku bez dalšího jemného ladění.
- Jemné ladění: Adaptace předtrénovaného LLM pro konkrétní úkol, metoda známá jako transfer learning. Příklad by mohl být přizpůsobení T5 pro generování souhrnů pro dokumenty v konkrétním odvětví.
- Vyhledávání informací: Použití LLM, jako jsou BERT nebo GPT, jako součást větších architektur pro vývoj systémů, které mohou načíst a kategorizovat informace.

- Architektura jemného ladění ChatGPT
Multi-head pozornost: Proč jeden, když můžete mít mnoho?
Nicméně, spoléhat se na jediný mechanismus pozornosti může být omezené. Různá slova nebo sekvence v textu mohou mít různé typy relevance nebo asociací. To je místo, kde multi-head pozornost přichází. Místo jednoho souboru pozornostních vah, multi-head pozornost využívá více souborů, což umožňuje modelu zachytit bohatší variabilitu vztahů ve vstupním textu. Každá pozornostní “hlava” může se zaměřit na různé části nebo aspekty vstupu, a jejich kombinované znalosti se používají pro konečnou předpověď.
ChatGPT: Nejoblíbenější nástroj Generativní AI
Začněme s GPT, jehož počátek byl v roce 2018, model byl postaven na základě 12 vrstev, 12 pozornostních hlav a 120 milionů parametrů, primárně trénován na datasetu BookCorpus. To byl působivý začátek, nabízející pohled do budoucnosti jazykových modelů.
GPT-2, odhalený v roce 2019, pochlubil se čtyřnásobným zvýšením vrstev a pozornostních hlav. Značně, jeho počet parametrů vyskočil na 1,5 miliardy. Tato vylepšená verze byla odvozena z tréninku na WebText, datasetu obohaceném o 40GB textu z různých odkazů na Reddit.
GPT-3, spuštěný v květnu 2020, měl 96 vrstev, 96 pozornostních hlav a masivní počet parametrů 175 miliard. Co odlišovalo GPT-3, byla jeho rozmanitá trénovací data, zahrnující CommonCrawl, WebText, anglickou Wikipedii, sbírky knih a další, kombinující se na celkových 570 GB.
Podrobnosti o fungování ChatGPT zůstávají pečlivě střeženým tajemstvím. Nicméně, proces nazvaný “reinforcement learning from human feedback” (RLHF) je známý jako zásadní. Pocházející z dřívějšího projektu ChatGPT, tato technika byla zásadní při vylepšení modelu GPT-3.5, aby byl více v souladu s písemnými instrukcemi.
Trénink ChatGPT sestává z trojúrovňového přístupu:
- Jemné ladění s učitelem: Zahrnuje vytváření lidsky psaných konverzačních vstupů a výstupů pro jemné ladění podkladového modelu GPT-3.5.
- Modelování odměn: Lidé hodnotí různé výstupy modelu na základě kvality, což pomáhá trénovat model odměn, který skóruje každý výstup s ohledem na kontext konverzace.
- Učení s posilováním: Konverzační kontext slouží jako pozadí, kde podkladový model navrhuje odpověď. Tato odpověď je hodnocena modelem odměn, a proces je optimalizován pomocí algoritmu nazvaného proximální policy optimization (PPO).
Pro ty, kteří se teprve seznamují s ChatGPT, komplexní začínající průvodce je k dispozici zde. Pokud máte zájem o hlubší prozkoumání prompt engineeringu s ChatGPT, máme také pokročilý průvodce, který osvětlí nejnovější a nejmodernější techniky promptů, dostupné na ‘ChatGPT & Advanced Prompt Engineering: Řídící AI evoluci‘.
Difuze a multimodální modely
Zatímco modely jako VAE a GAN generují své výstupy prostřednictvím jediného průchodu, a proto jsou uzamčeny ve svém výstupu, difuzní modely zavedly koncept “iterativního zpřesňování“. Touto metodou se vrací, opravují chyby z předchozích kroků, a postupně produkují více vyvinutý výsledek.
Centrální pro difuzní modely je umění “poškozování” a “zpřesňování”. Během fáze trénování je typický obrázek postupně znehodnocován přidáním různých úrovní šumu. Tato šumová verze je pak podána modelu, který se snaží “odšumovat” nebo „obnovit“ ji. Prostřednictvím více kol tohoto procesu se model stává způsobilým k obnově, chápající jak jemné, tak významné odchylky.

- Obrázek vygenerovaný z Midjourney
Proces generování nových obrázků po tréninku je fascinující. Začínající s zcela náhodným vstupem, je průběžně zpřesňován pomocí předpovědí modelu. Cílem je dosáhnout čistého obrázku s minimálním počtem kroků. Řízení míry znehodnocení se provádí prostřednictvím “šumového plánu”, mechanismu, který řídí, kolik šumu se aplikuje v různých fázích. Plánovač, jako je vidět v knihovnách jako “diffusers“, určuje povahu těchto šumových verzí na základě etablovaných algoritmů.
Zásadním architektonickým základem pro mnoho difuzních modelů je UNet—konvoluční neuronová síť přizpůsobená pro úkoly vyžadující výstupy, které odrážejí prostorové rozměry vstupů. Je to směs downsampling a upsampling vrstev, intrikátně propojených pro uchování dat s vysokým rozlišením, což je zásadní pro výstupy související s obrázky.
Při podrobnějším pohledu na oblast generativních modelů DALL-E 2 vyniká jako zářný příklad fúze textových a vizuálních AI schopností. Využívá trojúrovňovou strukturu:
DALL-E 2 má třídílnou architekturu:
- Textový encoder: Transformuje textový prompt do konceptuálního embeddingu v latentním prostoru. Tento model nezačíná od nuly. Spoléhá na OpenAI’s Contrastive Language–Image Pre-training (CLIP) dataset jako svou základnu. CLIP slouží jako most mezi vizuálními a textovými daty tím, že učí vizuální koncepty pomocí přirozeného jazyka. Prostřednictvím mechanismu kontrastivního učení identifikuje a páruje obrázky se svými odpovídajícími textovými popisy.
- Prior: Textový embedding odvozené z encoderu je poté převedeno do obrazového embeddingu. DALL-E 2 testoval jak autoregresivní, tak difuzní metody pro tuto úlohu, s difuzními metodami ukazujícími lepší výsledky. Autoregresivní modely, jako je vidět u Transformérů a PixelCNN, generují výstupy v sekvencích. Na druhé straně, difuzní modely, jako ten použitý v DALL-E 2, transformují náhodný šum do předpovězených obrazových embeddingů s pomocí textových embeddingů.
- Decoder: Klimax procesu, tato část generuje konečný vizuální výstup na základě textového promptu a obrazového embeddingu z předchozí fáze. Dekodér DALL-E 2 vděčí za svou architekturu jinému modelu, GLIDE, který může také produkovat realistické obrázky z textových podnětů.

- Zjednodušená architektura modelu DALL-E
Uživatelé Pythonu, kteří mají zájem o Langchain, by měli zkontrolovat náš podrobný tutoriál, který pokrývá vše od základů až po pokročilé techniky.
Aplikace Generativní AI
Textové domény
Začněme s textem, Generativní AI byla fundamentálně změněna chatboty, jako je ChatGPT. Spoléhající se silně na zpracování přirozeného jazyka (NLP) a velké jazykové modely (LLM), tyto entity jsou schopné provádět úkoly sahající od generování kódu a překladů jazyka až po souhrny a analýzu sentimentu. ChatGPT, například, viděl široké přijetí, stává se základem pro miliony. To je dále posíleno konverzačními AI platformami, založenými na LLM, jako je GPT-4, PaLM, a BLOOM, které snadno produkují text, pomáhají při programování a dokonce nabízejí matematické odůvodnění.
Z komerčního hlediska se tyto modely stávají nepostradatelnými. Společnosti je využívají pro řadu operací, včetně řízení rizik, optimalizace zásob a předpovědi poptávky. Některé pozoruhodné příklady zahrnují Bing AI, BARD společnosti Google a ChatGPT API.
Umění
Svět obrázků prošel dramatickými změnami s Generativní AI, zejména od zavedení DALL-E 2 v roce 2022. Tato technologie, která může generovat obrázky z textových podnětů, má jak umělecké, tak profesionální důsledky. Například, midjourney využil tuto technologii k produkci realistických obrázků. Tento nedávný příspěvek demystifikuje Midjourney v podrobném průvodci, vysvětlujícím jak platformu, tak jemnosti prompt engineeringu. Kromě toho, platformy jako Alpaca AI a Photoroom AI využívají Generativní AI pro pokročilé funkce editace obrázků, jako je odstranění pozadí, odstranění objektů a dokonce i obnova obličeje.
Produkce videa
Produkce videa, ačkoli stále v rané fázi v oblasti Generativní AI, ukazuje slibné pokroky. Platformy jako Imagen Video, Meta Make A Video a Runway Gen-2 tlačí hranice toho, co je možné, i když skutečně realistické výstupy jsou stále na obzoru. Tyto modely nabízejí značnou utilitu pro tvorbu digitálních lidských videí, s aplikacemi jako Synthesia a SuperCreator, které vedou nápor. Značně, Tavus AI nabízí jedinečnou prodejní nabídku tím, že personalizuje videa pro jednotlivé členy publika, což je požehnáním pro podniky.
Vytvoření kódu
Kódování, nezbytná součást našeho digitálního světa, nebylo ponecháno nedotčeno Generativní AI. Ačkoli ChatGPT je oblíbeným nástrojem, několik dalších AI aplikací bylo vyvinuto pro účely kódování. Tyto platformy, jako je GitHub Copilot, Alphacode a CodeComplete, slouží jako asistenti pro kódování a mohou dokonce produkovat kód z textových podnětů. Co je fascinující, je adaptabilita těchto nástrojů. Codex, hnací síla za GitHub Copilot, může být přizpůsoben individuálnímu stylu kódování, podtrhující potenciál personalizace Generativní AI.
Závěr
Kombinace lidské kreativity a strojového počítání se vyvinula do nepostradatelného nástroje, s platformami jako ChatGPT a DALL-E 2, které tlačí hranice toho, co je možné. Od tvorby textového obsahu až po sochaření vizuálních mistrovských děl, jejich aplikace jsou rozsáhlé a různé.
Jako u každé technologie, etické důsledky jsou zásadní. Zatímco Generativní AI slibuje neomezenou kreativitu, je důležité ji využívat zodpovědně, být si vědomi potenciálních zkreslení a síly datové manipulace.
S nástroji, jako je ChatGPT, se stávají stále dostupnějšími, je nyní ideální čas prozkoumat a experimentovat. Bez ohledu na to, zda jste umělec, kódér nebo technický nadšenec, oblast Generativní AI je plná možností čekajících na prozkoumání. Revoluce není na obzoru; je tady a teď. Takže, ponořte se!


