
Modely a platformy AI
Úplný průvodce Gemmou 2: Nový otevřený velký jazykový model od Googlu

 Přidejte Unite.AI mezi své preferované zdroje na Google
Gemma 2 staví na svém předchůdci a nabízí vylepšené výkony a efektivitu, spolu s řadou inovativních funkcí, které z něj činí atraktivní volbu pro výzkum i praktické aplikace. To, co odlišuje Gemmu 2, je její schopnost poskytovat výkon srovnatelný s mnohem většími proprietárními modely, ale v balíčku, který je navržen pro širší dostupnost a použití na skromnějších hardwarových konfiguracích.
Když jsem se ponořil do technických specifikací a architektury Gemmy 2, byl jsem stále více ohromen genialitou jejího designu. Model zahrnuje několik pokročilých technik, včetně novátorských mechanismů pozornosti a inovativních přístupů ke stabilitě školení, které přispívají k jejím pozoruhodným schopnostem.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
V tomto komplexním průvodci prozkoumáme Gemmu 2 do hloubky, zkoumající její architekturu, klíčové funkce a praktické aplikace. Bez ohledu na to, zda jste zkušený odborník v oblasti AI nebo nadšený nováček v oboru, tento článek si klade za cíl poskytnout cenné informace o tom, jak Gemma 2 funguje a jak můžete využít její sílu ve svých vlastních projektech.
Co je Gemma 2?
Gemma 2 je nejnovějším otevřeným velkým jazykovým modelem od Googlu, navrženým tak, aby byl lehký, ale výkonný. Je postaven na stejném výzkumu a technologii, která byla použita pro vytvoření modelů Gemini od Googlu, nabízející špičkový výkon v dostupnějším balíčku. Gemma 2 je k dispozici ve dvou velikostech:
Gemma 2 9B: Model s 9 miliardami parametrů
Gemma 2 27B: Větší model s 27 miliardami parametrů
Každá velikost je k dispozici ve dvou variantách:
Základní modely: Předběžně trénované na rozsáhlém korpusu textových dat
Modely s instrukcemi (IT): Jemně vyškoleno pro lepší výkon na specifických úkolech
Přístup k modelům v Google AI Studio: Google AI Studio – Gemma 2
Přečtěte si technickou zprávu zde: Technická zpráva Gemma 2
Klíčové funkce a vylepšení
Gemma 2 představuje několik významných pokroků oproti svému předchůdci:
1. Zvýšená školicí data
Modely byly školeny na podstatně více datech:
Gemma 2 27B: Školeno na 13 bilionech tokenů
Gemma 2 9B: Školeno na 8 bilionech tokenů
Tento rozšířený datový soubor, který se skládá主要ně z webových dat (většinou anglických), kódu a matematiky, přispívá k vylepšenému výkonu a všestrannosti modelů.
2. Pozornost se skluzavým oknem
Gemma 2 implementuje novátorský přístup k mechanismům pozornosti:
Každá druhá vrstva používá pozornost se skluzavým oknem s místním kontextem 4096 tokenů
Střídající se vrstvy využívají plnou kvadratickou globální pozornost napříč celým kontextem 8192 tokenů
Tento hybridní přístup má za cíl vyvážit efektivitu se schopností zachytit dlouhodobé závislosti ve vstupu.
3. Měkké omezení
Pro zlepšení stability školení a výkonu Gemma 2 zavádí mechanismus měkkého omezení:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Použito na logitách pozornosti
attention_logits = soft_cap(attention_logits, cap=50.0)</p>

# Použito na logitech poslední vrstvy

<p>final_logits = soft_cap(final_logits, cap=30.0)
Tato technika brání logitům v růstu příliš velkých bez tvrdého omezení, zachovává více informací a stabilizuje proces školení.
- Gemma 2 9B: Model s 9 miliardami parametrů
- Gemma 2 27B: Větší model s 27 miliardami parametrů
Každá velikost je k dispozici ve dvou variantách:
- Základní modely: Předběžně trénované na rozsáhlém korpusu textových dat
- Modely s instrukcemi (IT): Jemně vyškoleno pro lepší výkon na specifických úkolech
4. Přenos znalostí
Pro model 9B Gemma 2 využívá techniky přenosu znalostí:
- Předškolící: Model 9B se učí od většího učitele během počátečního školení
- Poškolící: Obě modely 9B a 27B využívají distilaci na základě zásad pro jemné vylepšení výkonu
Tento proces pomáhá menšímu modelu lépe zachytit schopnosti větších modelů.
5. Sloučení modelů
Gemma 2 využívá novou techniku sloučení modelů zvanou Warp, která kombinuje více modelů ve třech fázích:
- Exponenciální pohyblivý průměr (EMA) během jemného vyškolování s posilováním
- Sférická lineární interpolace (SLERP) po jemném vyškolování více politik
- Lineární interpolace směrem k inicializaci (LITI) jako konečná fáze
Tento přístup má za cíl vytvořit robustnější a schopnější konečný model.
Benchmarks výkonu
Gemma 2 prokazuje působivý výkon napříč různými benchmaky:
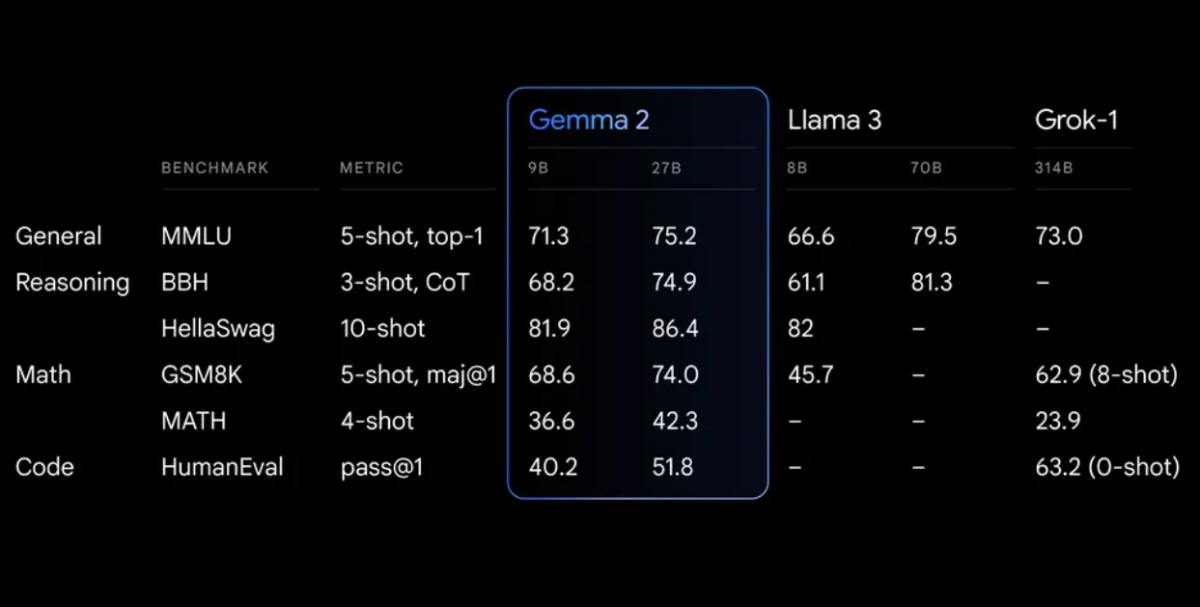
Gemma 2 na přepracované architektuře, navržené pro výjimečný výkon a efektivitu inferencí
Zahájení práce s Gemmou 2
Abyste mohli začít používat Gemmu 2 ve svých projektech, máte několik možností:
1. Google AI Studio
Pro rychlé experimenty bez hardwarových požadavků můžete přistupovat k Gemmě 2 prostřednictvím Google AI Studio.
2. Hugging Transformers
Gemma 2 je integrována s populární knihovnou Hugging Face Transformers. Zde je, jak můžete ji použít:
<div class="relative flex flex-col rounded-lg"> <div class="text-text-300 absolute pl-3 pt-2.5 text-xs"> <p>from transformers import AutoTokenizer, AutoModelForCausalLM</p> <p># Načtení modelu a tokenizéru model_name = "google/gemma-2-27b-it" # nebo "google/gemma-2-9b-it" pro menší verzi tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Příprava vstupu prompt = "Vysvětlit koncept kvantové provázanosti v jednoduchých termínech." inputs = tokenizer(prompt, return_tensors="pt")</p> <p># Generování textu outputs = model.generate(**inputs, max_length=200) response = tokenizer.decode(outputs[0], skip_special_tokens=True)</p> print(response)
3. TensorFlow/Keras
Pro uživatele TensorFlowu je Gemma 2 k dispozici prostřednictvím Kerasu:
<p>import tensorflow as tf from keras_nlp.models import GemmaCausalLM</p> <p># Načtení modelu model = GemmaCausalLM.from_preset("gemma_2b_en")</p> <p># Generování textu prompt = "Vysvětlit koncept kvantové provázanosti v jednoduchých termínech." output = model.generate(prompt, max_length=200)</p> print(output)
Pokročilé použití: Vytvoření místního RAG systému s Gemmou 2
Jednou z možných aplikací Gemmy 2 je vytvoření systému RAG (Retrieval Augmented Generation). Zde je ukázka, jak vytvořit jednoduchý, plně lokální RAG systém pomocí Gemmy 2 a Nomic embeddings.
Krok 1: Nastavení prostředí
Nejdříve zajistěte, že máte nainstalované nezbytné knihovny:
<p>pip install langchain ollama nomic chromadb</p>
Krok 2: Indexování dokumentů
Vytvořte indexer pro zpracování vašich dokumentů:
<p>import os from langchain.text_splitter import RecursiveCharacterTextSplitter from langchain.document_loaders import DirectoryLoader from langchain.vectorstores import Chroma from langchain.embeddings import HuggingFaceEmbeddings</p> <p>class Indexer: def __init__(self, directory_path): self.directory_path = directory_path self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200) self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p> <p>def load_and_split_documents(self): loader = DirectoryLoader(self.directory_path, glob="**/*.txt") documents = loader.load() return self.text_splitter.split_documents(documents)</p> <p>def create_vector_store(self, documents): return Chroma.from_documents(documents, self.embeddings, persist_directory="./chroma_db")</p> <p>def index(self): documents = self.load_and_split_documents() vector_store = self.create_vector_store(documents) vector_store.persist() return vector_store</p> <p># Použití indexer = Indexer("path/to/your/documents") vector_store = indexer.index()</p>
Krok 3: Nastavení RAG systému
Nyní vytvořte RAG systém pomocí Gemmy 2:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>
<p>class RAGSystem:
def __init__(self, vector_store):
self.vector_store = vector_store
self.llm = Ollama(model="gemma2:9b")
self.retriever = self.vector_store.as_retriever(search_kwargs={"k": 3})</p>
<p>self.template = """Použijte následující kusy kontextu k zodpovězení otázky na konci.
Pokud nevíte odpověď, prostě řekněte, že nevíte, nepokoušejte se vymyslet odpověď.</p>
{context}
<p>Otázka: {question}
Odpověď: """</p>
<p>self.qa_prompt = PromptTemplate(
template=self.template, input_variables=["context", "question"]
)</p>
<p>self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=self.retriever,
return_source_documents=True,
chain_type_kwargs={"prompt": self.qa_prompt}
)</p>
<p>def query(self, question):
return self.qa_chain({"query": question})</p>
<p># Použití
rag_system = RAGSystem(vector_store)
response = rag_system.query("Jaké je hlavní město Francie?")
print(response["result"])</p>
Tento RAG systém využívá Gemmu 2 prostřednictvím Ollamy pro jazykový model a Nomic embeddings pro načítání dokumentů. Umožňuje vám klást otázky na základě indexovaných dokumentů, poskytující odpovědi s kontextem z relevantních zdrojů.
Jemné vyškolování Gemmy 2
Pro specifické úkoly nebo domény můžete chtít jemně vyškolit Gemmu 2. Zde je základní příklad pomocí knihovny Hugging Face Transformers:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer from datasets import load_dataset <p># Načtení modelu a tokenizéru model_name = "google/gemma-2-9b-it" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Příprava datové sady dataset = load_dataset("your_dataset")</p> <p>def tokenize_function(examples): return tokenizer(examples["text"], padding="max_length", truncation=True)</p> <p>tokenized_datasets = dataset.map(tokenize_function, batched=True)</p> <p># Nastavení argumentů školení training_args = TrainingArguments( output_dir="./results", num_train_epochs=3, per_device_train_batch_size=4, per_device_eval_batch_size=4, warmup_steps=500, weight_decay=0.01, logging_dir="./logs", )</p> <p># Inicializace Traineru trainer = Trainer( model=model, args=training_args, train_dataset=tokenized_datasets["train"], eval_dataset=tokenized_datasets["test"], )</p> # Spuštění jemného vyškolování trainer.train() <p># Uložení jemně vyškolovaného modelu model.save_pretrained("./fine_tuned_gemma2") tokenizer.save_pretrained("./fine_tuned_gemma2")</p>
Pamatujte, že je třeba upravit parametry školení podle vašich specifických požadavků a výpočetních zdrojů.
Etické úvahy a omezení
Zatímco Gemma 2 nabízí působivé schopnosti, je důležité být si vědom jejího omezení a etických úvah:
- Zaujatost: Jako všechny jazykové modely, Gemma 2 může odrážet zaujatosti přítomné ve svých školicích datech. Vždy kriticky hodnotíte její výstupy.
- Faktická přesnost: Přestože je velmi schopný, Gemma 2 může někdy generovat nesprávné nebo nekonzistentní informace. Ověřte důležité skutečnosti z důvěryhodných zdrojů.
- Délka kontextu: Gemma 2 má délku kontextu 8192 tokenů. Pro delší dokumenty nebo konverzace můžete potřebovat implementovat strategie pro efektivní řízení kontextu.
- Výpočetní zdroje: Zvláště pro model 27B mohou být vyžadovány značné výpočetní zdroje pro efektivní inferenci a jemné vyškolování.
- Zodpovědné použití: Dodržujte zásady zodpovědného AI od Googlu a zajistěte, aby vaše použití Gemmy 2 bylo v souladu s etickými principy AI.
Závěr
Gemma 2 nabízí pokročilé funkce, jako je pozornost se skluzavým oknem, měkké omezení a novátorské techniky sloučení modelů, které z ní činí mocný nástroj pro širokou škálu úkolů zpracování přirozeného jazyka.
Používáním Gemmy 2 ve svých projektech, ať už prostřednictvím jednoduché inferencí, komplexních RAG systémů nebo jemně vyškolovaných modelů pro specifické domény, můžete využít sílu SOTA AI a zároveň udržet kontrolu nad svými daty a procesy.


