
To nejlepší
10 nejlepších nástrojů AI pro extrakci dat z webu (listopad 2026)

 Přidejte Unite.AI mezi své preferované zdroje na Google
Unite.AI může získat odměnu za použití odkazů na recenzované produkty. Naše redakční hodnocení to neovlivňuje. Přečtěte si informace o affiliate spolupráci.
Klíčové bodyPřizpůsobte nástroj pro scraping konkrétnímu úkolu po načtení stránky, místo abyste…
Zobrazit více
- Přizpůsobte nástroj pro scraping konkrétnímu úkolu po načtení stránky, místo abyste veškeré shromažďování dat považovali za jediný problém.
- Přiřaďte vlastnictví pracovního postupu lidem, kteří rozumí jak zdrojovým webům, tak požadovanému výstupu.
- Plánujte rozpočet na základě použitelných záznamů, nikoli podle uváděných počtů požadavků, protože vykreslování a proxy celkové součty nafukují.
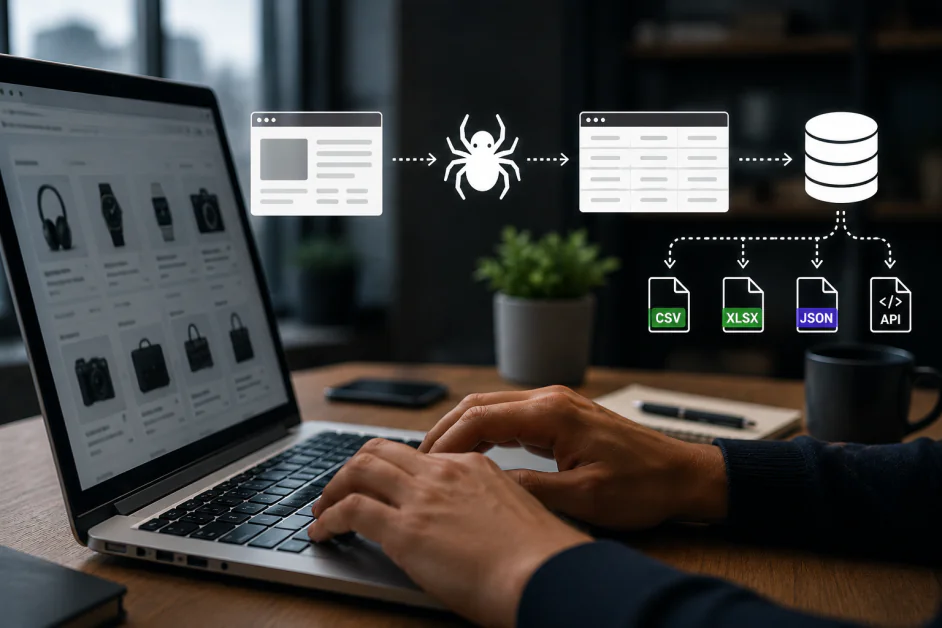
Nejlepší nástroj AI pro extrakci dat z webu závisí na tom, co chcete dělat po načtení stránky. Výzkumný asistent potřebuje přehledně uspořádaný obsah a odkazy na zdroje. Systém pro analýzu trhu potřebuje konzistentní záznamy ve velkém měřítku. Interaktivní agent může potřebovat prohlížeč, který dokáže projít několika kroky a udržet relaci aktivní.
Tento průvodce představuje deset nástrojů pro různé účely, včetně podnikových platforem pro sběr dat, rozhraní API pro obsah, nástrojů pro extrakci dat bez programování, služeb se search daty a spravovaných prohlížečů. Hodnotíme, jak jednotlivé produkty shromažďují informace, kdo může udržovat daný proces a jaké kompromisy jsou důležité, když se z prototypu stane pravidelně opakovaný proces.
Náš tým každé řešení v tomto průvodci nezávisle posoudil a zhodnotil jeho možnosti, praktické přednosti, omezení a vhodnost pro případy použití, které zohledňujeme v našem žebříčku.
Srovnání nejlepších nástrojů AI pro extrakci dat z webu
| Nástroj AI | Nejvhodnější pro | Hlavní přednosti |
|---|---|---|
| Bright Data | Podnikový sběr dat a rozmanité datové procesy | Scraper APIs, Browser API, Scraper Studio, datové sady, proxy služby |
| Firecrawl | Webový obsah pro aplikace AI | Vyhledávání, extrakce dat, mapování, procházení webu, Markdown, JSON, interakce, MCP |
| Apify | Opakovaně použitelné úlohy extrakce dat a orchestraci v cloudu | Actors, Crawlee, plánování, úložiště, proxy služby, API, MCP |
| Browse AI | Sběr dat bez programování a sledování změn | Nastavení s pomocí AI, roboti, upozornění, plánování, integrace |
| SearchAPI | Strukturované výsledky vyhledávání a lokalizovaný průzkum | Google, Mapy, nakupování, video, prostředí AI vyhledávání, JSON |
| Octoparse | Vizuální extrakce dat s opakovatelným spouštěním v cloudu | Šablony, AI Assistant, automatická detekce, cloudové běhy, exporty |
| Browserless | Spravované prohlížeče pro Puppeteer a Playwright | Hostované prohlížeče, trvalé relace, REST API, MCP |
| ScrapingBee | Spravovaná extrakce dat prostřednictvím aplikačního API | Extrakce pomocí AI, CSS/XPath, Markdown, scénáře JS, MCP |
| Oxylabs | Spravované získávání dat z náročných veřejných webů | Web API /Scrape, vykreslování, strukturovaný výstup, MCP |
| Diffbot | Automatická extrakce dat a analýza entit | Extrakce, standardní schémata, procházení webu, Knowledge Graph |
Jak vybrat nástroj AI pro extrakci dat z webu
Vyberte nástroj podle typu práce
Pro znalostní bázi AI upřednostněte přehledně uspořádaný text, strukturovaný výstup a zachování URL zdrojů. Při opakovaném průzkumu trhu může být vizuální robot a upozornění na změny důležitější než programové rozhraní. U interaktivního agenta se zaměřte na zachování relace a ovládání prohlížeče. Rozhraní API pro výsledky vyhledávání řeší jiný problém: poskytují data z vyhledávání, zatímco sběr obsahu z odkazovaných stránek je samostatný krok.
Rozhodněte, kdo bude proces spravovat
Platforma bez nutnosti programování umožňuje analytikovi přímo upravovat kroky extrakce. Rozhraní API poskytuje vývojářům přehledné rozhraní pro integraci sběru dat do aplikace. Cloudová platforma pro spouštění úloh přidává plánování a úložiště, zatímco spravovaný prohlížeč ponechává větší část automatizační logiky vašemu týmu. Správná volba svěří údržbu lidem, kteří rozumějí jak zdrojovým webovým stránkám, tak požadovanému výstupu.
Plánujte rozpočet podle užitečných záznamů, ne podle počtu požadavků uváděného v titulku
Porovnejte cenu dokončené úlohy s ohledem na pole, která potřebujete. Celkové náklady mohou ovlivnit vykreslování, prémiové proxy služby, délka používání prohlížeče, extrakce pomocí AI, úložiště i opakované pokusy. Bezplatný kredit, jednotka prohlížeče a požadavek na vyhledávání jsou různé měrné jednotky. Při opakované práci sledujte vedle úspěšných odpovědí také úplnost, duplicity, aktuálnost a náklady na každý použitelný záznam.
10 nejlepších nástrojů AI pro extrakci dat z webu
1. Bright Data
Bright Data je naše celkové doporučení pro organizace, které potřebují získávat webová data různými způsoby na jediné platformě. Jeho nabídka zahrnuje hotová rozhraní Scraper APIs, předem shromážděné datové sady, Scraper Studio, Web Unlocker a proxy služby. Tým zaměřený například na analýzu e-commerce může využívat strukturované datové kanály pro známé maloobchodníky a současně vytvářet vlastní řešení pro sběr dat ze specializovaného tržiště. Díky této šíři možností se platforma hodí zejména v situacích, kdy datový program zahrnuje více než jeden web nebo oddělení.
Pro interaktivní stránky poskytuje Browser API prohlížeče, které mohou vývojáři ovládat pomocí Puppeteer, Playwright nebo Selenium. Kombinuje běh prohlížeče se správou proxy a řešením CAPTCHA, zatímco podpora Chrome DevTools pomáhá technikům prozkoumat problematickou relaci. To se hodí, když pracovní postup vyžaduje navigaci nebo interakci se stránkou, než se požadované informace zpřístupní, a nestačí jen stáhnout existující datovou sadu.
Hlavním kompromisem je výběr produktů a řízení nákladů. Provoz prohlížeče, výsledky scrapingu a nákup datových sad představují různé typy využití, takže jediná uváděná cena nemůže popsat celou platformu. Bright Data se hodí pro týmy, které mají někoho zodpovědného za kvalitu sběru, pokrytí cílových zdrojů a výdaje. Projekt s úzce vymezeným rozsahem může být rychleji nasazen do produkce s jednodušším extrakčním API.
Výhody a nevýhody
- Široké možnosti sběru dat v rámci jedné platformy
- Hostované prohlížeče podporují zavedené automatizační knihovny
- Předpřipravená API a datové sady urychlují nastavení
- Různé produkty vyžadují samostatné plánování nákladů
- Vlastní datové procesy stále vyžadují technický dohled
2. Firecrawl
Firecrawl doporučujeme vývojářům, kteří chtějí převádět webový obsah na užitečný kontext pro aplikace s umělou inteligencí. Jeho nástroje pro vyhledávání, extrakci, mapování a procházení pokrývají celý postup od nalezení stránky až po sběr dat z webu; Markdown a strukturovaný JSON omezují nutnost následného čištění získaných dat. Výzkumný asistent nebo produkt znalostní báze se tak může více věnovat odpovídání na otázky a méně odstraňování navigačních nabídek z nezpracovaného HTML.
Aktuální nabídka Interact rozšiřuje platformu o práci s prohlížečem v reálném čase. Agenti mohou popisovat akce v přirozeném jazyce nebo spouštět kód prohlížeče, uchovávat stav mezi jednotlivými voláními a znovu používat ověřené profily. To je významné rozšíření pro stránky, které před extrakcí vyžadují klikání, použití filtrů nebo přihlášení. Přístup přes MCP a příkazový řádek navíc umožňuje prakticky využívat Firecrawl při vývoji agentů, nejen jako běžné aplikační API.
Firecrawl se nejlépe hodí, když je bezprostředním problémem získávání obsahu a aplikace už zajišťuje jeho ukládání a vyhledávání. Týmy musí stále vymezit rozsah procházení, uchovávat zdrojové URL a rozlišovat mezi chybějícím a prázdným polem. Jeho open-source kód nabízí další možnost nasazení, týmy by však měly posoudit konkrétní funkce a provozní požadavky zvoleného způsobu nasazení a nepředpokládat, že hostované a samostatně spravované verze jsou totožné.
Výhody a nevýhody
- Markdown a JSON se hodí pro datové procesy s umělou inteligencí
- Interact podporuje úlohy v prohlížeči se zachováním stavu
- Přístup přes API, MCP a CLI
- Získaný obsah je stále potřeba ověřit
- Samostatně spravované nasazení vyžaduje provozní práci
3. Apify
Apify je zde nejlepší volbou pro týmy, které chtějí používat opakovaně využitelné nástroje pro scraping a mít platformu, na které s nimi mohou pracovat. Jeho tržiště nabízí Actors: připravené programy, které přijímají vstupy, běží v cloudu a vracejí výsledky. Existující Actors mohou urychlit běžné úlohy sběru dat, zatímco vlastní Actors umožňují vývojářům zachovat vlastní logiku extrakce. Apify tak představuje užitečný most mezi experimentem a opakovatelnou produkční úlohou.
Platforma zajišťuje také důležité provozní funkce, včetně plánování, ukládání výsledků, přístupu k proxy, monitorování a integrací. Vývojáři mohou pracovat také s Crawlee, open-source knihovnou pro procházení webu a automatizaci prohlížeče. Server MCP od Apify zpřístupňuje Actors agentům s umělou inteligencí, takže stejný připravený nástroj může sloužit aplikaci, plánovanému datovému procesu nebo asistentovi, aniž by bylo nutné pro každé rozhraní vytvářet samostatnou implementaci scraperu.
Výběru Actoru je třeba věnovat stejně pozornosti jako výběru platformy. Různí vydavatelé mohou nabízet odlišné ceny, úroveň údržby, možnosti zadávání vstupů i kvalitu výstupů. Úspěšné spuštění také samo o sobě nedokazuje, že byly shromážděny všechny očekávané záznamy. Apify je nejpřínosnější, když někdo odpovídá za schéma úlohy, sleduje změny a plánuje náklady na zvolený Actor i infrastrukturu; při ruční extrakci dat z jediné stránky je taková míra orchestrace zřídkakdy potřeba.
Výhody a nevýhody
- Předpřipravené i vlastní Actors využívají stejnou platformu
- Plánování, ukládání a monitorování umožňují opakovaně spouštět úlohy
- MCP zapojuje Actors do pracovních postupů agentů
- Údržba a kvalita Actorů se liší
- S výdaji na používání a Actors je třeba počítat v rozpočtu
4. Browse AI
Browse AI doporučujeme firemním uživatelům, kteří potřebují pravidelně získávat data z webu, aniž by museli vytvářet softwarový projekt. Aktuální nastavení dokáže načíst zadanou stránku, navrhnout strukturu dat a umožnit uživateli pole zkontrolovat nebo upravit. Pro opakovatelnou extrakci je i nadále zásadní trénování robota. Jde o praktický přístup pro provozní a marketingové týmy, které shromažďují nabídky produktů, záznamy v adresářích nebo informace o konkurenci do známých tabulek.
Monitorování je jednou z hlavních předností. Roboti mohou stránky kontrolovat podle plánu, rozpoznávat nové položky nebo změny a zasílat upozornění s vysvětlením, co se změnilo. Pracovní postupy mohou propojit sběr dat napříč stránkami a integrace přes API, webhooky a tabulky pomáhají předávat výsledky do nástrojů, které tým už používá. Sledování cen se tak může stát průběžným firemním procesem namísto řady ručních kontrol v prohlížeči.
Snadné používání však neodstraňuje potřebu jasně definovat data. Uživatelé by měli rozhodnout, které změny si zaslouží upozornění, a ověřit, zda stránkování, přihlašovací kroky a prázdné výsledky fungují správně. I rozsáhlé změny webu mohou stále vyžadovat zásah. Browse AI se nejlépe hodí tam, kde firemní tým může kontrolovat extrahované řádky a udržovat robota; vývojáři, kteří potřebují přesně verzovanou logiku prohlížeče, mohou dát přednost službě založené na kódu.
Výhody a nevýhody
- Nastavení polí s pomocí AI snižuje vstupní bariéru
- Plánované monitorování upozorňuje na významné změny
- Propojení s tabulkami, API a webhooky
- Výrazné změny webu mohou vyžadovat opětovné natrénování
- Složitá logika vyžaduje pečlivý návrh pracovního postupu
5. SearchAPI
SearchAPI doporučujeme jako specializované řešení pro získávání výsledků vyhledávání ve strukturované podobě. Jeho API pro Google může vracet odkazy na výsledky a funkce vyhledávání ve formátu JSON, takže není nutné udržovat analyzátor pro stránku s výsledky, která se průběžně mění. Širší katalog zahrnuje zdroje, jako jsou Mapy, nákupy, zprávy, videa a podporované vyhledávací služby s AI. Hodí se zejména tehdy, když jsou samotné vyhledávání a viditelnost ve výsledcích tím, co se má získávat, nikoli jen mezikrokem před procházením dalšího webu.
Důležitou součástí vhodnosti tohoto řešení je lokalizace. Parametry polohy, země, jazyka a zařízení umožňují týmům zkoumat trh v přesně určeném kontextu vyhledávání. SEO aplikace může sledovat dotaz v jednom městě, zatímco výzkumný asistent může vyhledávat relevantní zdroje a uchovávat vrácené odkazy pro pozdější použití. Dokumentace pro jednotlivé vyhledávače je důležitá, protože dostupné parametry a pole výsledků se u různých vyhledávacích produktů liší.
SearchAPI je třeba vybírat podle vyhledávačů a polí, které daný pracovní postup skutečně potřebuje. Výsledek vyhledávání neobsahuje celý obsah odkazované stránky a rozšířené podoby výsledků se neřídí jednotným schématem. Týmy by měly počítat s objemem požadavků, ověřit požadovanou propustnost a vhodně ošetřit chybějící části výsledků. Pro extrakci dat z libovolných webů nebo práci v interaktivní relaci prohlížeče je lepší začít s jiným nástrojem z tohoto průvodce.
Výhody a nevýhody
- Strukturované výsledky odstraňují nutnost udržovat analyzátor stránek s výsledky vyhledávání
- Široký katalog vyhledávačů a souvisejících služeb
- Podrobné možnosti nastavení lokalizace
- Výsledky vyhledávání nenahrazují extrakci dat z cílové stránky
- Pole a parametry se liší podle vyhledávače
6. Octoparse
Octoparse představuje svého AI Copilota a automatizaci s člověkem v procesu. Video: Octoparse.
Octoparse se hodí analytikům, kteří chtějí vizuálně navrhnout extraktor dat a poté jej opakovaně spouštět. Jeho současná platforma nabízí připravené šablony, nastavení pomocí funkce AI Assistant a automatickou detekci stránek v desktopové aplikaci. Uživatelé mohou výsledný úkol upravovat, místo aby začínali s kódem prohlížeče. Tato flexibilita je užitečná při sběru údajů z katalogů produktů, adresářů nebo nabídek, kde je pořadí stránek stejně důležité jako pole na každé z nich.
Spouštění v cloudu mění připravený úkol na opakovaný sběr dat, aniž by bylo nutné nechat zapnutý osobní počítač. Plánování, paralelní zpracování, rotace IP adres a možnosti exportu pomáhají zvládnout rozsáhlejší úlohy, které přesahují možnosti prototypu v desktopové aplikaci. Vizuální přístup je obzvlášť atraktivní pro týmy, které rozumějí zdrojovým webům a požadavkům na data, ale nechtějí udržovat vlastní službu pro automatizaci prohlížeče.
Octoparse vyžaduje pečlivý návrh úkolů. Stránkování, nekonečné posouvání, kroky ve formulářích a duplicitní záznamy mohou změnit význam běhu, který se zdánlivě podařil. Kapacita cloudového tarifu a jeho funkce by měly odpovídat plánované četnosti a objemu. Doporučujeme jej týmům, které chtějí mít nad kroky extrakce větší kontrolu, než nabízí rychlý nástroj na jedno kliknutí, a mají určeného správce, který může úkol upravit, když se zdrojové stránky změní.
Výhody a nevýhody
- Šablony a podpora AI usnadňují nastavení
- Vizuální úpravy umožňují vytvářet podrobné úlohy pro extrakci dat
- Spouštění v cloudu umožňuje plánovaný sběr dat
- Složité weby vyžadují zpřesnění úloh
- Cloudové funkce závisí na zvoleném tarifu
7. Browserless
Browserless doporučujeme vývojářům, kteří chtějí ovládat prohlížeč a jeho hosting i škálování svěřit spravované službě. Existující skripty pro Puppeteer nebo Playwright lze připojit ke vzdáleným prohlížečům, což je výhodné pro projekty, které už mají funkční automatizační kód. Hodí se to zejména tehdy, když sběr dat zahrnuje několik interakcí, rozhraní intenzivně využívající JavaScript nebo relaci, která musí přetrvat déle než jediný jednoduchý požadavek.
Služba nabízí také rozhraní REST API pro scraping, snímky obrazovky, soubory PDF a vlastní funkce prohlížeče. Její hostovaný server MCP zpřístupňuje nástroje prohlížeče agentům AI, zatímco funkce relací a ověřené profily podporují pracovní postupy, které vyžadují kontinuitu. Browserless se proto hodí jak vývojářům vytvářejícím vlastní nástroje pro sběr dat, tak agentům, kteří potřebují procházet web a shromažďovat informace prostřednictvím skutečného prohlížeče.
Při výběru je zásadní zvážit, jak se účtuje používání prohlížeče. Bezplatný tarif nyní zahrnuje 1 000 jednotek měsíčně a dva souběžně spuštěné prohlížeče, nikoli 1 000 zaručených scrapingových úloh. Čas strávený v prohlížeči spotřebovává jednotky; za provoz přes proxy a úspěšné řešení CAPTCHA se účtují další poplatky. Limity relací se liší podle tarifu. Týmy nadále odpovídají za logiku extrakce i kontrolu výstupů, takže Browserless je nejzajímavější tam, kde je důležitější ovládání prohlížeče než vizuální nástroj pro tvorbu automatizací.
Výhody a nevýhody
- Zachovává zavedené pracovní postupy s Puppeteer a Playwright
- Rozhraní REST API umožňuje scraping i export stránek
- Funkce relací a MCP se hodí pro interaktivní agenty
- Čas strávený v prohlížeči a doplňky ovlivňují spotřebu jednotek
- Vlastní extrakce stále vyžaduje aplikační logiku
8. ScrapingBee
ScrapingBee je skvělá volba pro vývojáře, kteří místo přímého ovládání dlouho běžícího prohlížeče chtějí spravovaný požadavek pro scraping. Jeho API spojuje načítání stránek a vykreslování JavaScriptu se správou proxy; extrakci lze provádět pomocí pravidel CSS nebo XPath, případně pokynů v přirozeném jazyce pro AI. Tato kombinace se hodí, když projekt potřebuje strukturované záznamy z několika webů, ale nechce provozovat vlastní flotilu prohlížečů.
Scénáře JavaScriptu mohou před sběrem dat klikat, posouvat stránku, zadávat text nebo čekat. Výstup ve formátu Markdown podporuje pracovní postupy s obsahem pro AI a snímky obrazovky pomáhají zachytit vykreslenou stránku. Současný produkt nabízí také specializovaná rozhraní API pro vybrané cíle a přístup přes CLI i MCP. Vývojář může pro stabilní pole použít explicitní pravidla extrakce a tam, kde je struktura stránky nebo otázka méně předvídatelná, extrakci pomocí přirozeného jazyka.
Praktický rozdíl oproti platformě s hostovaným prohlížečem spočívá v tom, že ScrapingBee se zaměřuje na požadavek a vrácený výsledek, zatímco širší úlohu řídí vlastní aplikace. Pro koordinaci více stránek, odstraňování duplicit, plánování aktualizací a ověřování záznamů je stále potřeba vlastní řešení. Spotřeba kreditů se navíc mění podle použitých funkcí, včetně vykreslování a možností proxy. Doporučujeme jej aplikačním týmům, které oceňují jednoduché rozhraní HTTP a chtějí orchestraci datového toku ponechat ve vlastním kódu.
Výhody a nevýhody
- Pravidla pro výběr prvků a extrakce pomocí AI nabízejí flexibilitu
- Vykreslování a scénáře zvládají interaktivní stránky
- Markdown, CLI a podpora MCP usnadňují pracovní postupy s AI
- Pokročilé možnosti požadavků zvyšují spotřebu kreditů
- Úlohy zahrnující více stránek stále vyžadují orchestraci
9. Oxylabs
Oxylabs je skvělou volbou pro týmy, které chtějí spravovaný přístup k obtížně dostupným veřejným webům a možnost rozšířit sběr dat do většího objemu. Jeho současné rozhraní Web API zahrnuje službu /Scrape pro získávání a strukturování webových dat; vykreslování JavaScriptu a správu přístupu má integrované přímo v platformě. Nabídka produktů zahrnuje také /Search a infrastrukturu prohlížeče, takže týmy mohou volit různé přístupy podle toho, zda úloha začíná vyhledáváním, extrakcí, nebo interakcí.
Možnosti přizpůsobené konkrétním cílům pomáhají získávat užitečná pole z běžných zdrojů vyhledávání a e-commerce, zatímco propojení s agenty přes MCP a Agent Skills začleňují sběr dat do pracovních postupů s AI. Oxylabs nadále zveřejňuje také samostatnou dokumentaci ke svému rozhraní Classic Web Scraper API. Tento rozdíl je důležitý pro stávající integrace: tým, který udržuje integraci s Classic API, by měl používat příslušnou dokumentaci a neměl by předpokládat, že příklad pro novější Web API lze použít zaměnitelně.
Oxylabs dává největší smysl v případech, kdy obtížnost cílových webů, objem zpracování nebo náklady na údržbu infrastruktury pro přístup odůvodňují použití spravované platformy. Aplikace musí i nadále určit požadované schéma, dobu aktuálnosti dat a způsob zpracování neúplných záznamů. Před zavedením do provozu slaďte zvolenou generaci API, možnosti pro cílové weby a model účtování se skutečnými potřebami úlohy. Pro menší ruční extrakci může být přímočařejší volbou vizuální nástroj pro scraping.
Výhody a nevýhody
- Spravovaná infrastruktura pro vykreslování a přístup
- Možnosti strukturované extrakce přizpůsobené konkrétním cílům
- Aktuální Web API podporuje integraci agentů
- Klasické a aktuální API vyžadují samostatné nastavení
- Kvalitu výstupu je stále nutné ověřovat v aplikaci
10. Diffbot
Diffbot doporučujeme v případech, kdy je důležitější porozumět informacím na stránce než napodobit její rozvržení. Nástroj Extract využívá počítačové vidění a zpracování přirozeného jazyka ke klasifikaci stránek a vytváření strukturovaného výstupu JSON podle standardních schémat. Týmům, které shromažďují články nebo produkty z mnoha zdrojů, může pomoci omezit množství kódu pro zpracování dat specifického pro jednotlivé weby, potřebného k převodu stránek na vzájemně porovnatelné záznamy.
Jeho Knowledge Graph řeší související, ale odlišnou potřebu: práci s entitami, jako jsou organizace, lidé a články, které už byly sestaveny z veřejného webu. Záznamy mohou spojovat informace z více zdrojů a propojovat entity prostřednictvím smysluplných vztahů. Díky tomu se Diffbot hodí k obohacování dat, průzkumu společností a analytickým aplikacím, které potřebují kontext přesahující údaje viditelné na jediné stránce.
Nevýhodou je nutnost přizpůsobit se datovému modelu Diffbotu. Standardizovaná extrakce je užitečná, pokud typy stránek a pole odpovídají danému úkolu, neobvyklé pole nebo specializovaná interakce si však mohou vyžádat jiný přístup. Týmy by měly rozlišovat mezi extrakcí dat z vybraných adres URL a dotazováním do existujícího znalostního grafu a následně posoudit pokrytí i aktuálnost zdrojů. Diffbot je vhodnější pro technické týmy, které vytvářejí informační produkty s normalizovanými daty, než pro uživatele, kteří potřebují jen zkopírovat několik řádků do tabulky.
Výhody a nevýhody
- Automatická klasifikace omezuje práci na parserech
- Standardní schémata pomáhají sjednotit podobné stránky
- Knowledge Graph doplňuje kontext o entitách
- Standardní pole nemusí pokrýt specializované požadavky
- Extrakce dat a přístup ke grafu slouží k odlišným pracovním postupům
Často kladené otázky
Čím se nástroj pro extrakci dat z webu stává nástrojem využívajícím AI?
AI může pomáhat rozpoznávat pole, interpretovat obsah stránek, vytvářet kroky pro extrakci dat nebo ovládat akce v prohlížeči. Některé nástroje využívají AI při nastavení, jiné při každé extrakci. Služba může podporovat aplikace využívající AI také tím, že jim dodává čistý obsah, aniž by při každém požadavku používala jazykový model. Vybírejte podle toho, která funkce řeší váš problém se sběrem dat, ne podle označení.
Jaký je rozdíl mezi extrakcí dat a automatizací prohlížeče?
Extrakce dat shromažďuje informace. Automatizace prohlížeče provádí akce na stránce, například otevírá nabídky, zadává vyhledávací dotaz nebo prochází vícekrokový pracovní postup. Tyto postupy se často doplňují: automatizovaný prohlížeč zobrazí požadovaný stav stránky a následný krok extrahuje příslušná pole. Pokud takové interakce nejsou potřeba, bývá jednodušší přímý požadavek na API.
Které nástroje jsou nejvhodnější pro tým bez technických znalostí?
Pro jednoduchý pravidelný sběr dat a sledování změn doporučujeme jako první volbu Browse AI. Dobrou alternativou je Octoparse, pokud tým chce mít nad jednotlivými kroky úlohy větší vizuální kontrolu. Oba nástroje fungují nejlépe, když někdo kontroluje výsledné záznamy a ví, jak rozpoznat změny na zdrojovém webu.
Jaké údaje by měla pipeline AI nebo RAG uchovávat z extrahovaných dat?
Uchovávejte zdrojovou adresu URL, čas sběru, název stránky a text nebo strukturovaná pole potřebná pro danou aplikaci. Markdown může zachovat čitelnou strukturu dokumentu, zatímco JSON slouží k ukládání záznamů s definovanou strukturou. Odstraňujte duplicitní obsah a nemíchejte text navigace s hlavním obsahem. Uchování informací o původu usnadňuje dohledání a aktualizaci podkladů pro pozdější odpovědi.
Kdy se vyplatí používat spravovaný prohlížeč?
Spravovaný prohlížeč se hodí, když sběr dat vyžaduje spouštění JavaScriptu, několik interakcí nebo zachování relace a tým nechce sám hostovat procesy prohlížeče. Pro stávající kód Puppeteer nebo Playwright je specializovanou možností Browserless. U jediné statické stránky může jednodušší požadavek na načtení nebo extrakční API spotřebovat méně prostředků.
Odpovídá 1 000 bezplatných jednotek 1 000 extrakcím?
Ne. Každý poskytovatel stanovuje vlastní pravidla pro jednotky a kredity. Browserless účtuje připojení k prohlížeči v blocích o délce až 30 sekund; provoz přes proxy a řešení CAPTCHA navíc spotřebovávají další jednotky. Jiné služby účtují podle možností požadavku, počtu záznamů nebo výpočetního výkonu. Odhadujte náklady na celý pracovní postup, nesrovnávejte pouze různé limity bezplatných tarifů.
Lze výsledku extrakce pomocí AI důvěřovat bez kontroly?
I platná odpověď ve formátu JSON může vynechat záznam nebo nesprávně interpretovat pole. Stanovte povinná pole, ověřujte datové typy a rozsahy, namátkově kontrolujte zdrojové stránky a sledujte změny v počtu záznamů. U opakovaných úloh jsou užitečnější výslovně definované stavy chyby a prázdného výsledku než předpoklad, že každá odpověď představuje úplný soubor dat.
Závěrečné úvahy o nástrojích pro extrakci dat z webu využívajících AI
Bright Data je naší celkově nejlepší volbou pro široce zaměřený program sběru webových dat, zatímco Firecrawl je nejlepší vstupní volbou pro převod webových stránek na obsah připravený pro AI. Apify zvolte, pokud jsou pro projekt zásadní opakovaně použitelné nástroje, plánované úlohy a cloudové operace.
Pro firemní týmy usnadňuje Browse AI pravidelné monitorování a Octoparse nabízí uživatelům vizuální způsob, jak zpřesňovat složitější úlohy extrakce dat. SearchAPI je specializovanou volbou, pokud požadovaným výstupem jsou strukturovaná data z vyhledávání.
Browserless si své místo zaslouží u vývojářů, kteří chtějí spravované spouštění prohlížeče s využitím známých knihoven pro automatizaci. ScrapingBee je silnou alternativou, pokud aplikaci lépe vyhovuje spravovaný požadavek na extrakci dat. Oxylabs se hodí pro náročné získávání dat z veřejného webu, zatímco Diffbot vyniká standardizovanou extrakcí a analýzou entit.
Nejlepší dlouhodobou volbou je ta, která poskytuje potřebné informace prostřednictvím pracovního postupu, který váš tým dokáže udržovat. Způsob sběru přizpůsobte danému úkolu, zachovávejte kontext zdrojů a hodnotu posuzujte podle využitelnosti výstupů, nikoli podle počtu požadovaných stránek.




