

نماذج ومنصات الذكاء الاصطناعي
Zero123++: نموذج انتشار أساسي لتوليد صور متسقة من زوايا متعددة انطلاقًا من صورة واحدة

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةيقوم Zero123++ بتجميع ستة مناظر في صورة واحدة لضمان الاتساق ثلاثي الأبعاد عبر توليد…
عرض المزيد
- يقوم Zero123++ بتجميع ستة مناظر في صورة واحدة لضمان الاتساق ثلاثي الأبعاد عبر توليد المناظر المتعددة.
- يقدم النموذج آلية 'الانتباه المرجعي المُقَاس' للحفاظ على النسيج المحلي من صورة الإدخال المفردة.
- يستخدم النموذج جدول ضوضاء خطي لتحسين البنية العامة، متفوقاً على الجدول الخطي المقاس.
في السنوات القليلة الماضية ، شهدت أداء و كفاءة و قدرات توليد النماذج التوليدية للذكاء الاصطناعي التي تتبنى مجموعات بيانات واسعة و ممارسات توليد انتشار ثنائي الأبعاد تقدمًا سريعًا. اليوم ، تعد نماذج الذكاء الاصطناعي التوليدية قادرة بشكل كبير على توليد أشكال مختلفة من المحتوى الإعلامي ثنائي الأبعاد، وثلاثي الأبعاد إلى حد ما ، بما في ذلك النصوص و الصور و مقاطع الفيديو و الصور المتحركة و غيرها.
في هذا المقال ، سنناقش إطار العمل Zero123++ ، وهو نموذج توليدي للذكاء الاصطناعي مشروط بالصورة يهدف إلى توليد صور متعددة المناظير متسقة ثلاثيًا من صورة واحدة. لتحقيق أقصى استفادة من النماذج التوليدية المسبقة التدريب ، يطبق إطار العمل Zero123++ العديد من مخططات التدريب و التكييف لتحقيق الحد الأدنى من الجهد المبذول في الضبط الدقيق من نماذج الصور التوليدية الجاهزة. سنقوم بالغوص أعمق في هيكل و عمل و نتائج إطار العمل Zero123++ ، وتحليل قدراته على توليد صور متعددة المناظير متسقة عالية الجودة من صورة واحدة. لذا دعونا نبدأ.
Zero123 و Zero123++: مقدمة
إطار العمل Zero123++ هو نموذج توليدي للذكاء الاصطناعي مشروط بالصورة يهدف إلى توليد صور متعددة المناظير متسقة ثلاثيًا من صورة واحدة. إطار العمل Zero123++ هو استمرار لإطار العمل Zero123 أو Zero-1-to-3 الذي يعتمد على تقنية توليد صور من زوايا رؤية جديدة دون تدريب إضافي على أمثلة جديدة (zero-shot)، ضمن حلول مفتوحة المصدر لتحويل صورة واحدة إلى تمثيل ثلاثي الأبعاد. على الرغم من أن إطار العمل Zero123++ يوفر أداء واعدًا ، إلا أن الصور التي يتم توليدها بواسطة الإطار تتضمن تناقضات هندسية واضحة ، وهو السبب الرئيسي لاستمرار الفجوة بين المشاهد ثلاثية الأبعاد و الصور متعددة المناظير.
يعمل إطار العمل Zero-1-to-3 كأساس لعدة إطارات أخرى ، بما في ذلك SyncDreamer و One-2-3-45 و Consistent123 وغيرها ، والتي تضيف طبقات إضافية إلى إطار العمل Zero123 لتحقيق نتائج أكثر اتساقًا عند توليد الصور ثلاثية الأبعاد. تتبع إطارات أخرى مثل ProlificDreamer و DreamFusion و DreamGaussian نهجًا قائمًا على التحسين لتحقيق الصور ثلاثية الأبعاد عن طريق استخلاص صورة ثلاثية الأبعاد من عدة نماذج غير متسقة. على الرغم من فعالية هذه التقنيات وتوليدها لصور ثلاثية الأبعاد مرضية ، يمكن تحسين النتائج من خلال تنفيذ نموذج انتشار أساسي قادر على توليد صور متعددة المناظير بشكل متسق. وبالتالي ، يعتمد إطار العمل Zero123++ على إطار العمل Zero-1-to-3 و يضبط نموذج انتشار متعددة المناظير جديد من Stable Diffusion.
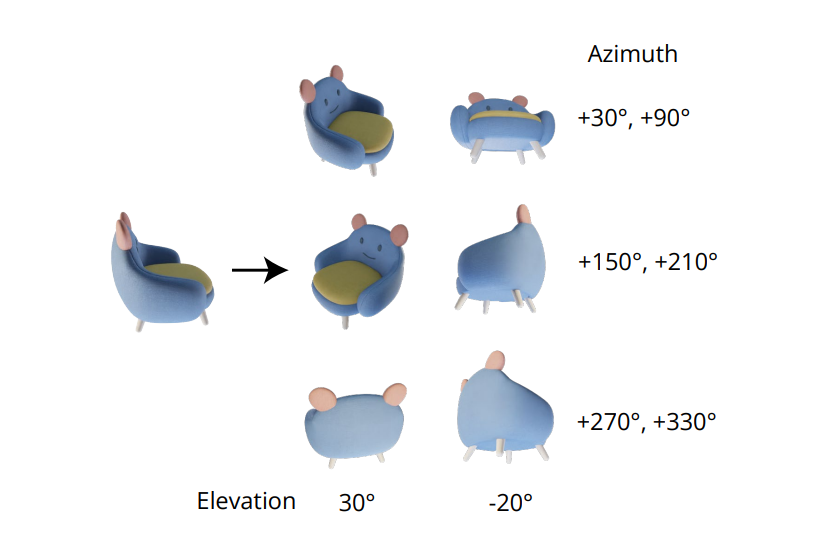
في إطار العمل Zero-1-to-3 ، يتم توليد كل منظر جديد بشكل مستقل ، وهذا النهج يؤدي إلى عدم الاتساق بين المناظير التي يتم توليدها لأن نماذج الانتشار لها طبيعة عينة. لمعالجة هذه القضية ، يعتمد إطار العمل Zero123++ على نهج ترتيب الصور في شبكة ، حيث يتم وضع الكائن في ست مناظير في صورة واحدة ، وضمان التمثيل الصحيح للتوزيع المشترك لصور الكائن متعددة المناظير.
تحدي رئيسي آخر يواجهه المطورون الذين يعملون على إطار العمل Zero-1-to-3 هو أن الإطار لا يستغل القدرات التي تقدمها Stable Diffusion بشكل كافٍ ، مما يؤدي إلى عدم كفاءة و تكاليف إضافية. هناك سببان رئيسيان لعدم قدرة إطار العمل Zero-1-to-3 لتحقيق أقصى استفادة من القدرات التي تقدمها Stable Diffusion
- عند التدريب مع التكييف بالصورة ، لا يدمج إطار العمل Zero-1-to-3 آليات التكييف المحلية أو العالمية التي تقدمها Stable Diffusion بشكل فعال.
- خلال التدريب ، يستخدم إطار العمل Zero-1-to-3 دقة مخفضة ، وهو نهج يتم فيه تقليل دقة الإخراج أقل من دقة التدريب ، مما يمكن أن يقلل من جودة توليد الصور لنماذج Stable Diffusion.
لمعالجة هذه القضايا ، يطبق إطار العمل Zero123++ مجموعة من تقنيات التكييف التي تعظم الاستفادة من الموارد التي تقدمها Stable Diffusion ، و الحفاظ على جودة توليد الصور لنماذج Stable Diffusion.
تحسين التكييف و الاتساق
في محاولة لتحسين التكييف بالصورة و الاتساق بين الصور متعددة المناظير ، نفذ إطار العمل Zero123++ تقنيات مختلفة ، مع الهدف الرئيسي المتمثل في إعادة استخدام التقنيات السابقة من نموذج Stable Diffusion المسبق التدريب.
توليد متعددة المناظير
الجودة الأساسية لتوليد صور متعددة المناظير متسقة تكمن في نمذجة التوزيع المشترك لصور متعددة بشكل صحيح. في إطار العمل Zero-1-to-3 ، يتم تجاهل العلاقة بين صور متعددة المناظير لأن الإطار ينمذج التوزيع الهامشي الشرطي بشكل مستقل و منفصل لكل صورة. ومع ذلك ، في إطار العمل Zero123++ ، اختار المطورون نهج ترتيب الصور في شبكة ، الذي يجمع ست صور في إطار واحد / صورة لتوليد صور متعددة المناظير بشكل متسق ، والعملية موضحة في الصورة التالية.

علاوة على ذلك ، لاحظ أن اتجاهات الكائن تميل إلى إزالة الغموض عند تدريب النموذج على مواقف الكاميرا ، ولمنع هذا الغموض ، يتدرب إطار العمل Zero-1-to-3 على مواقف الكاميرا مع زوايا الارتفاع و الأزيموتات النسبية للإدخال. لتنفيذ هذا النهج ، من الضروري معرفة زاوية الارتفاع لمنظر الإدخال التي يتم استخدامها بعد ذلك لتحديد الوضع النسبي بين زاوية الرؤية الجديدة وزاوية الإدخال. ولتحديد زاوية الارتفاع، تضيف هذه الأطر غالبًا وحدة لتقديرها، لكن ذلك قد يضيف أخطاء إلى مسار المعالجة.
جدول الضوضاء
الجدول الخطي المُحجَّم ، الجدول الأصلي للضوضاء لنموذج Stable Diffusion ، يركز بشكل رئيسي على التفاصيل المحلية ، ولكن كما يمكن رؤيته في الصورة التالية ، لديه عدد قليل من الخطوات مع نسبة إشارة إلى ضوضاء منخفضة.


تحدث هذه الخطوات من نسبة إشارة إلى ضوضاء منخفضة في وقت مبكر خلال مرحلة إزالة الضوضاء ، مرحلة حاسمة لتحديد الهيكل العالمي منخفض التردد. تقليل عدد الخطوات خلال مرحلة إزالة الضوضاء ، سواء أثناء الاستدلال أو التدريب ، غالبًا ما يؤدي إلى تباين هيكلي أكبر. على الرغم من أن هذا الإعداد مثالي لتوليد الصور الفردية ، إلا أنه يحد من قدرة الإطار لضمان الاتساق العالمي بين المناظير المختلفة. لمعالجة هذا العائق ، يضبط إطار العمل Zero123++ نموذج LoRA على إطار Stable Diffusion 2 ذي التنبؤ v لتنفيذ مهمة تجريبية مبسطة ، والنتائج موضحة أدناه.

مع جدول الضوضاء الخطي المُحجَّم، لا يفرط نموذج LoRA في التكيّف ، ولكن فقط يبيض الصورة قليلا. في المقابل ، عند العمل مع جدول الضوضاء الخطي ، يولد إطار LoRA صورة فارغة بنجاح بغض النظر عن الموجّه النصي المُدخل ، مما يشير إلى تأثير جدول الضوضاء على قدرة الإطار للتكيف مع متطلبات جديدة على المستوى العالمي.
انتباه مرجعي مُحجَّم للشروط المحلية
الصورة الواحدة الإدخال أو الصور المشروطة في إطار العمل Zero-1-to-3 يتم دمجها مع الإدخالات المضطربة في بعد الميزة لتكون مضطربة من أجل التكييف بالصورة.
هذا الدمج يؤدي إلى تطابق غير صحيح بين الصورة الهدف و الإدخال. لتوفير إدخال تكييف محلي مناسب ، يستخدم إطار العمل Zero123++ نهج انتباه مرجعي مُحجَّم ، وهو نهج يتم فيه تشغيل نموذج UNet لإزالة الضوضاء على صورة مرجعية إضافية ، متبوعًا بضم مصفوفات القيم ومفاتيح الانتباه الذاتي من الصورة المرجعية إلى طبقات الانتباه عندما يتم إزالة ضوضاء الإدخال ، والعملية موضحة في الشكل التالي.

نهج انتباه المرجع يمكنه توجيه نموذج الانتشار ل توليد صور تشترك في النسيج مع صورة المرجع و المحتوى الدلالي بدون أي الضبط الدقيق. مع الضبط الدقيق ، يوفر نهج انتباه المرجع نتائج متفوقة مع التمثيل الكامن بعد تحجيمه.

تكييف عالمي: FlexDiffuse
في النهج الأصلي لنموذج Stable Diffusion ، تكون متضمنات النص هي المصدر الوحيد للمتضمنات العالمية ، و يستخدم النهج إطار CLIP كمشفر نصي لتطبيق الانتباه المتقاطع بين تضمينات النص والتمثيلات الكامنة للنموذج (يسمي الأصل ذلك cross-examinations، والمقصود في هذا السياق هو الانتباه). وبالتالي ، يمكن للمطورين استخدام التوجيه بين فضاءات النص و الصور الناتجة عن CLIP لاستخدامها في تكييف الصور على المستوى العالمي.
يقترح إطار العمل Zero123++ استخدام نسخة قابلة للتدريب من آليات التوجيه الخطية لدمج التكييف العالمي في الإطار مع الحد الأدنى المطلوب من الضبط الدقيق ، والنتائج موضحة في الصورة التالية. كما يمكن رؤية أن بدون وجود تكييف عالمي ، جودة المحتوى الذي يتم توليده بواسطة الإطار جيدة للمناطق المرئية التي تتوافق مع صورة الإدخال. ومع ذلك ، يشهد جودة الصورة التي يتم توليدها بواسطة الإطار لتلك المناطق غير المرئية تدهورًا كبيرًا ، والذي يعود في الغالب إلى عدم قدرة النموذج على استنتاج الدلالات العامة للكائن.

هيكل النموذج
يتم تدريب إطار العمل Zero123++ على نموذج Stable Diffusion 2v كأساس باستخدام النهوج و التقنيات المذكورة في المقال. يتم تدريب إطار العمل Zero123++ مسبقًا على مجموعة بيانات Objaverse التي يتم تقديمها مع إضاءة HDRI عشوائية. يعتمد الإطار أيضًا على نهج جدول التدريب المرحلي المستخدم في إطار Stable Diffusion Image Variations في محاولة لتحقيق الحد الأدنى من الضبط الدقيق المطلوب و الحفاظ على قدر الإمكان من النموذج المسبق التدريب Stable Diffusion.
يمكن تقسيم عمل أو هيكل إطار العمل Zero123++ إلى مراحل أو خطوات متسلسلة. الشوط الأول يشهد إطار العمل يضبط مصفوفات KV من طبقات الانتباه المتقاطع و طبقات الانتباه الذاتي لنموذج Stable Diffusion مع AdamW بوصفه خوارزمية التحسين ، و 1000 خطوة تسخين و جدول تعلم الكوزينوس الأقصى عند 7×10⁻⁵. في الشوط الثاني ، يستخدم الإطار معدل تعلم ثابت متشدد للغاية مع 2000 خطوة إحماء ، و يستخدم نهج Min-SNR لتحقيق أقصى كفاءة خلال التدريب.
Zero123++: نتائج و مقارنة الأداء
الأداء النوعي
لتقييم أداء إطار العمل Zero123++ على أساس الجودة ، يتم مقارنته مع SyncDreamer و Zero-1-to-3-XL ، وهما من أفضل الأطر المتقدمة لتوليد المحتوى. يتم مقارنة الإطارات مع أربع صور إدخال مختلفة. الصورة الأولى هي قطط ألعاب كهربائية ، تم اخذها مباشرة من مجموعة بيانات Objaverse ، و تتميز بوجود عدم اليقين الكبير في الجزء الخلفي من الكائن. الثانية هي صورة مطفأة الحريق ، و الثالثة هي صورة كلب جالس على صاروخ ، تم توليدها بواسطة نموذج SDXL. الصورة النهائية هي توضيح أنيمي. يتم تحقيق الخطوات المطلوبة للتقييم بواسطة استخدام نهج تقدير الارتفاع لإطار العمل One-2-3-4-5 ، و تُزال الخلفية باستخدام إطار SAM. وتُظهر النتائج أن Zero123++ يولّد صورًا متسقة وعالية الجودة من زوايا متعددة، ويعمّم جيدًا على الرسومات ثنائية الأبعاد الخارجة عن توزيع التدريب والصور المولّدة بالذكاء الاصطناعي.


التحليل الكمي
من أجل مقارنة إطار العمل Zero123++ بشكل كمي مع أطر Zero-1-to-3 و Zero-1-to-3-XL المتقدمة ، يقيم المطورون درجة التشابه الإدراكي المتعلَّم لرقع الصور (LPIPS) لهذه النماذج على مجموعة البيانات التأكيديه ، وهي جزء فرعي من مجموعة بيانات Objaverse. لتقدير أداء النموذج في توليد صور متعددة المناظير ، يتم تجميع صور الحقيقة المرجعية و الصور الستة المولدة على التوالي ، ثم حساب درجة LPIPS. النتائج موضحة أدناه و كما يمكن رؤية بوضوح ، يحقق إطار العمل Zero123++ أفضل أداء على مجموعة البيانات التأكيديه.

التقييم من النص إلى متعددة المناظير
من أجل تقييم قدرة إطار العمل Zero123++ في توليد المحتوى من النص إلى متعددة المناظير ، يستخدم المطورون أولاً إطار العمل SDXL مع موجّهات نصية لتوليد صورة ، ثم يستخدمون إطار العمل Zero123++ على الصورة المولدة. النتائج موضحة في الصورة التالية ، و كما يمكن رؤية ، عند مقارنة إطار العمل Zero-1-to-3 الذي لا يمكنه ضمان توليد صور متعددة المناظير بشكل متسق ، يعود إطار العمل Zero123++ صورًا متعددة المناظير متسقة و واقعية و مفصلة للغاية عن طريق تنفيذ نهج النص إلى الصورة إلى صور متعددة المناظير.

Zero123++ Depth ControlNet
بالإضافة إلى إطار العمل Zero123++ الأساسي ، أصدر المطورون أيضًا إطار العمل Depth ControlNet Zero123++ ، وهو نسخة محكومة بالعمق من الإطار الأصلي تم بناؤه باستخدام هيكل ControlNet. يتم تقديم الصور الخطية المعيارية مع الصور RGB اللاحقة ، و يتم تدريب إطار ControlNet لتحكم في هندسة إطار العمل Zero123++ باستخدام إدراك العمق.


الختام
في هذا المقال ، ناقشنا إطار العمل Zero123++ ، وهو نموذج توليدي للذكاء الاصطناعي مشروط بالصورة يهدف إلى توليد صور متعددة المناظير متسقة ثلاثيًا من صورة واحدة. لتحقيق أقصى استفادة من النماذج التوليدية المسبقة التدريب ، يطبق إطار العمل Zero123++ العديد من مخططات التدريب و التكييف لتحقيق الحد الأدنى من الجهد المبذول في الضبط الدقيق من نماذج الصور التوليدية الجاهزة. كما ناقشنا النهوج و التحسينات المختلفة التي يطبقها إطار العمل Zero123++ لتحقيق نتائج قابلة للمقارنة و حتى تتجاوز تلك التي تحققها أحدث الأطر المتقدمة.
ومع ذلك ، على الرغم من كفاءته و قدرة توليد صور متعددة المناظير عالية الجودة بشكل متسق ، لا يزال إطار العمل Zero123++ لديه بعض مجالات البحث المحتملة ، مثل
- نموذج المرحلتين الذي قد يحل مشكلة عدم قدرة إطار العمل Zero123++ لتلبية المتطلبات العالمية للاتساق.
- مزيد من التوسعات لتحسين قدرة إطار العمل Zero123++ لتوليد صور ذات جودة أعلى.


