
زاوية Anderson
UniTune: تقنية جوجل البديلة لتحرير الصور بالشبكات العصبية

 أضف Unite.AI إلى مصادرك المفضلة على Google
النقاط الرئيسيةيقوم UniTune بضبط نموذج الانتشار بدقة على صورة واحدة لتمكين التعديلات الدقيقة المستندة…
عرض المزيد
- يقوم UniTune بضبط نموذج الانتشار بدقة على صورة واحدة لتمكين التعديلات الدقيقة المستندة إلى النص.
- على عكس DreamBooth أو Textual Inversion، يرفض UniTune كلا النهجين للحفاظ على التفاصيل بشكل أفضل.
- تحقق الطريقة فصلًا دلاليًا عاليًا، مع الحفاظ على الوجوه سليمة أثناء التحولات الجذرية للخلفية.
يبدو أن بحث جوجل يهاجم تحرير الصور القائم على النص من عدة جبهات، ويتوقع ما سيكون له من تأثير. بعد إطلاق ورقة Imagic هذا الأسبوع، اقترح عملاق البحث طريقة إضافية تعتمد على الانتشار الكامن لإجراء تعديلات بالذكاء الاصطناعي على الصور، تكون مستحيلة بوسائل أخرى، عبر أوامر نصية، وتسمى UniTune.
استنادًا إلى الأمثلة المذكورة في ورقة المشروع الجديدة، حقق UniTune درجة استثنائية من فصل الوضعية والفكرة الدلاليتين عن المحتوى الفعلي للصورة:

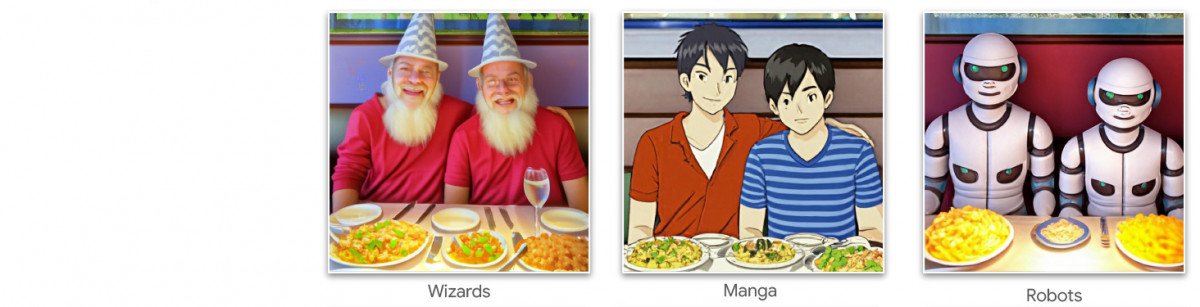

السيطرة التي تمتلكها UniTune على التكوين الدلالي ممتازة. لاحظ كيف لم تتأثر وجوه الشخصين في الصف العلوي من الصور بالتحويل الاستثنائي على بقية الصورة الأصلية (اليمين). Source: https://arxiv.org/pdf/2210.09477.pdf
كما تعلم مشجعو Stable Diffusion، يمكن أن يكون تطبيق التعديلات على أقسام محددة من الصورة دون التأثير السلبي على بقية الصورة عملية معقدة وأحيانًا مستحيلة. ومع أن التوزيعات الشائعة مثل AUTOMATIC1111 تستطيع إنشاء أقنعة للتعديلات المحلية والمحدودة، فإن العملية شاقة وكثيرًا ما يصعب التنبؤ بها.
الجواب الواضح، على الأقل لمتخصص الرؤية الحاسوبية، هو إدراج طبقة من التجزئة الدلالية تستطيع التعرف على الأشياء في الصورة وعزلها دون تدخل المستخدم. وقد ظهرت بالفعل عدة مبادرات جديدة مؤخرًا في هذا الاتجاه.
ثمة إمكانية أخرى لضبط عمليات تحرير الصور العصبية المعقدة والمتشابكة، وهي استخدام وحدة OpenAI المؤثرة للتدريب المسبق التبايني للغة والصورة (CLIP)، التي تقع في صميم نماذج الانتشار الكامن مثل DALL-E 2 وStable Diffusion. تعمل كمرشح عند استعداد نموذج تحويل النص إلى صورة لإرسال الصورة المفسرة إلى المستخدم، وكحارس ووحدة لضبط الجودة ترفض المخرجات المشوهة أو غير الملائمة. وهذا على وشك التطبيق (رابط Discord) في بوابة DreamStudio من Stability.ai القائمة على واجهة برمجة التطبيقات. لكن CLIP قد يكون السبب والحل معًا، لأنه أسهم أيضًا في طريقة تكوين الصورة، كما قد تتجاوز متطلبات العتاد ما يتاح محليًا للمستخدم النهائي، فلا يكون النهج مثاليًا.
اللغة المضغوطة
اقترح UniTune “ضبط دقيق” لنموذج انتشار موجود – في هذه الحالة، Imagen من جوجل، مع أن الباحثين يؤكدون توافق الطريقة مع معماريات الانتشار الكامن الأخرى – بحيث يتم حقن رمز فريد يمكن استدعاؤه عن طريق إدراجه في سطر الأوامر النصي.
للوهلة الأولى، يبدو هذا مثل DreamBooth من جوجل، الذي يشغل حاليًا مستخدمي Stable Diffusion ومطوريه، ويستطيع إدراج شخصيات أو أشياء جديدة في نقطة تحقق موجودة، غالبًا في أقل من ساعة، من بضعة صور أصلية فقط. أو يشبه Textual Inversion الذي ينشئ ملفات مرافقة لنقطة التحقق، تُعامل كما لو أنها دُرّبت أصلًا داخل النموذج وتستفيد من موارده الواسعة بتعديل مصنّف النص، فينتج ملف صغير مقارنة بنقاط تحقق DreamBooth التي لا تقل بعد تقليمها عن 2GB.
لكن الباحثين يؤكدون أن UniTune رفض النهجين؛ فقد أغفل Textual Inversion تفاصيل مهمة كثيرة، بينما كان DreamBooth «أسوأ أداءً وأطول وقتًا» من الحل الذي اختاروه في النهاية.
ومع ذلك، يستخدم UniTune نهج «الميتابرومبت» الدلالي المغلف نفسه في DreamBooth، فتُستدعى التغييرات المتعلمة بكلمات فريدة يختارها المدرب ولا تتعارض مع مصطلحات موجودة في نموذج عام دُرّب بمشقة. QUOTEOPEN«لإجراء التحرير، نأخذ عينات من النماذج المضبوطة دقيقًا باستخدام الموجّه “[rare_tokens] edit_prompt” (مثل “beikkpic كلبان في مطعم” أو “beikkpic مينيون”).»QUOTECLOSE
العمليات
مع أنه من المحير لماذا تظهر ورقتان شبه متطابقتين من جوجل في نفس الأسبوع، هناك على الأقل فرق واضح بين UniTune و Imagic – يستخدم الأخير أوامر لغة طبيعية غير مضغوطة لتحديد عمليات تحرير الصور، بينما UniTune يتدرب على رموز فريدة بنمط DreamBooth.
لذلك، إذا كنت تحرر مع Imagic وتريد أن تؤثر على تحويل من هذا النوع…

من ورقة UniTune – UniTune يضع نفسه ضد إطار تحرير الصور العصبي المنافس المفضل لجوجل، SDEdit. النتائج التي تم الحصول عليها من UniTune على اليمين الأقصى، بينما تظهر القناع المقدر في الصورة الثانية من اليسار.
.. في Imagic، ستدخل ‘الشخص الثالث، الجالس في الخلفية، كوحش لطيف كثيف الفرو’.
الأمر المكافئ في UniTune سيكون ‘الرجل في الخلف ك [x]’، حيث x هو الكلمة الغريبة والفريدة المرتبطة بالمفهوم المضبوط دقيقًا لشخصية وحش كثيف الفرو.
تُدخل إلى DreamBooth أو Textual Inversion صور متعددة لإنشاء تجريد بأسلوب التزييف العميق يمكن توجيهه إلى وضعيات كثيرة، بينما يُدخل UniTune وImagic صورة واحدة فقط، هي الأصل غير المعدل. ويشبه ذلك أدوات التحرير القائمة على GAN في الأعوام الأخيرة، التي تحول الصورة إلى رموز في الفضاء الكامن للشبكة ثم تنقلها إلى أجزاء أخرى منه لتعديلها، مثل إسقاط شاب داكن الشعر عبر رموز «مسن» أو «أشقر». لكن نتائج هذه الطريقة في نموذج انتشار دقيقة بصورة لافتة وأقل غموضًا بكثير عند المقارنة. 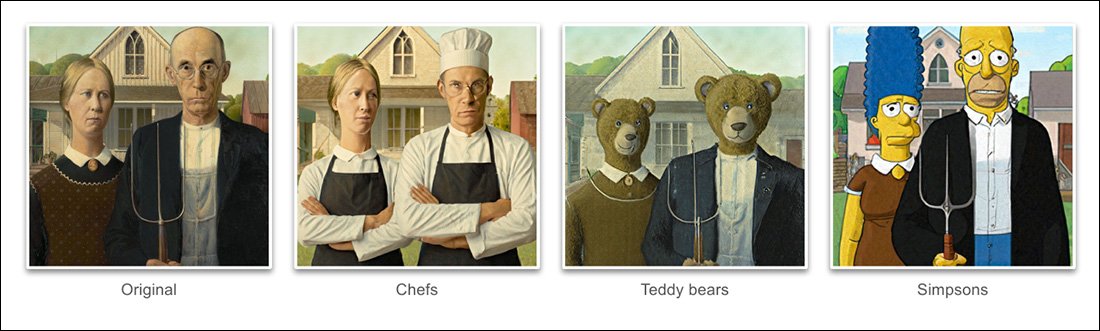
الضبط الدقيق
تتمثل طريقة UniTune في الأساس في إرسال الصورة الأصلية عبر نموذج انتشار مع مجموعة من الإرشادات حول كيفية تعديلها، باستخدام المستودعات الكبيرة من البيانات المتاحة التي تدرب عليها النموذج. ويمكن فعل ذلك الآن باستخدام وظيفة img2img في Stable Diffusion، لكن ليس دون تشويه أو تغيير أجزاء الصورة التي تفضل الاحتفاظ بها.
خلال عملية UniTune، يتم ضبط دقيق النموذج، مما يعني أن UniTune يُجبر النموذج على استئناف التدريب، مع إبقاء معظم طبقاته غير مجمدة (انظر أدناه). وفي أغلب الحالات، يخفض الضبط الدقيق قيم الخسارة العامة الإجمالية لنموذج عالي الأداء تحقق بشق الأنفس، لصالح إدراج أو تحسين جانب آخر مطلوب.
في UniTune، يبدو أن نسخة النموذج المعالجة، ولو بلغ حجمها عدة غيغابايت أو أكثر، تُعامل كقشرة جانبية مؤقتة وتُرمى بعد إنجاز غرض واحد. وهذه الأحجام من البيانات المؤقتة تصبح أزمة تخزين يومية لمستخدمي DreamBooth، إذ لا تقل نماذجهم، حتى بعد تقليمها، عن 2GB لكل موضوع. وكما في Imagic، يجري الضبط الرئيسي في المستويين الأدنى من مستويات Imagen الثلاثة (الأساس 64px، ثم 64px>256px، ثم 256px>1024px). وبخلاف Imagic، يرى الباحثون قيمة محتملة لضبط آخر مستويات الدقة الفائقة وأكبرها أيضًا، وإن لم يجربوا ذلك بعد. في مستوى 64px الأدنى، يُوجّه النموذج نحو الصورة الأساسية أثناء التدريب، وتُدخل أزواج مكررة من الصورة والنص خلال 128 تكرارًا بحجم دفعة 4، مع Adafactor كدالة خسارة بمعدل تعلم 0.0001. وحده مرمّز T5 يبقى مجمدًا خلال هذا الضبط، كما في تدريب Imagen الأولي. ثم تتكرر العملية لمستوى 64>256px بإجراء تعزيز الضوضاء نفسه المستخدم في التدريب الأصلي.
أخذ العينات
هناك العديد من طرق العينة التي يمكن استخدامها لاستخراج التغييرات التي تم إجراؤها من النموذج المضبوط دقيقًا، بما في ذلك التوجيه دون مصنّف (CFG)، وهو أيضًا ركيزة في Stable Diffusion. ويحدد CFG مدى حرية النموذج في اتباع خياله واستكشاف إمكانات التصيير، أو عند الإعدادات المنخفضة مدى التزامه ببيانات المصدر وإحداث تغييرات أقل اتساعًا أو حدة.

مثل Textual Inversion وبدرجة أقل DreamBooth، يستطيع UniTune تطبيق أنماط رسومية مميزة وتعديلات أكثر واقعية على الصور الأصلية.
كما قام الباحثون بتجربة تقنية “البدء المتأخر” من SDEdit، حيث يتم تشجيع النظام على الحفاظ على التفاصيل الأصلية عن طريق أن يكون فقط جزئيًا «ضوضاء» من البداية، مع الحفاظ على خصائصه الأساسية. استخدمها الباحثون في الطبقة الأدنى فقط (64px)، لكنهم يرون أنها قد تصبح تقنية تكميلية مفيدة لأخذ العينات مستقبلًا.
استخدم الباحثون أيضًا موجّهًا إلى موجّه كتقنية نصية إضافية لاشتراط النموذج: QUOTEOPEN«في إعداد “prompt to prompt”، وجدنا أن تقنية نسميها Prompt Guidance مفيدة خصوصًا لضبط الوفاء للأصل والقدرة التعبيرية.»QUOTECLOSEQUOTEOPEN«تشبه Prompt Guidance التوجيه دون مصنّف، لكن الأساس موجّه آخر بدلًا من النموذج غير المشروط. وهذا يوجّه النموذج نحو الفرق بين الموجّهين.»QUOTECLOSE

موجّه إلى موجّه في UniTune يعزل مناطق التغيير بفعالية.
لكن المؤلفين يقولون إن التوجيه بالموجّه لم يكن لازمًا إلا أحيانًا، حين لم يحقق CFG النتيجة المطلوبة. ومن أساليب أخذ العينات الجديدة التي ظهرت أثناء تطوير UniTune الاستيفاء، حيث تكون مناطق الصورة منفصلة بما يكفي وتكون بنية الأصل والصورة المعدلة متشابهة جدًا، فيمكن استخدام استيفاء أكثر بساطة.

قد يجعل الاستيفاء عمليات UniTune الأكثر كلفة غير ضرورية حين تكون مناطق التحويل منفصلة وواضحة الحدود.
يقترح المؤلفون أن الاستيفاء قد يعمل جيدًا جدًا مع صور أصلية كثيرة بحيث يصبح إعدادًا افتراضيًا. ويمكنه إحداث تحويلات استثنائية حين لا يلزم التعامل مع احتجابات معقدة بطرق أكثر كثافة. يمكن أن يؤدي UniTune تعديلات محلية مع أو بدون أقنعة تعديل، ويمكنه أيضًا أن يقرر بشكل وحيد حيث يضع التعديلات، مع مزيج غير عادي من القوة التفسيرية وتمثيل البيانات الإدخالية الأصلية:

في أعلى العمود الثاني، يضع UniTune «قطارًا أحمر في الخلفية» في موضع مناسب وواقعي. وتظهر الأمثلة الأخرى الحفاظ على التكامل الدلالي للصورة الأصلية حتى وسط تغييرات استثنائية في محتوى البكسلات والأساليب الأساسية.
التأخير
على الرغم من أن الجيل الأول من أي نظام جديد سيكون بطيئًا، وربما يتم تسريعه وتحسينه في النهاية من خلال المشاركة المجتمعية أو الالتزام الشركي، كلا UniTune و Imagic يؤديان بعض المناورات التعلم الآلي الكبيرة لإنشاء هذه التعديلات الرائعة، ويتساءل إلى أي مدى يمكن للمسار الموارد الكثيفة أن يُختزل للاستخدام المنزلي، بدلاً من الوصول إلى واجهة برمجة التطبيقات (على الرغم من أن الأخير قد يكون أكثر رغبة لجوجل).
في هذه اللحظة، يستغرق الوقت الكامل من الإدخال إلى النتيجة حوالي 3 دقائق على وحدة معالجة الرسومات T4، مع حوالي 30 ثانية إضافية للاستدلال (كما هو الحال مع أي روتين استدلال). يقر الباحثون بأن هذا هو تأخير عالٍ، ولا يعتبر بالتأكيد “تفاعليًا”، لكنهم يلاحظون أيضًا أن النموذج يبقى متاحًا للتعديلات الإضافية مرة واحدة بعد ضبطه دقيقًا، حتى ينتهي المستخدم من العملية، مما يقلل من وقت التعديل لكل تعديل.
نُشر لأول مرة في 21 أكتوبر 2022.


