

نماذج ومنصات الذكاء الاصطناعي
SEER: هل يمثل اختراقًا في نماذج الرؤية الحاسوبية ذات الإشراف الذاتي؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
في العقد الماضي ، شهد الذكاء الاصطناعي والتعلم الآلي تقدمًا كبيرًا. اليوم ، فهي أكثر دقة و كفاءة وقدرة من أي وقت مضى. يمكن للنماذج الحديثة من الذكاء الاصطناعي والتعلم الآلي التعرف بسهولة ودقة على الأشياء في الصور أو ملفات الفيديو. بالإضافة إلى ذلك ، يمكنها توليد نصوص وخطاب يتوافق مع الذكاء البشري.
تعتمد نماذج الذكاء الاصطناعي والتعلم الآلي اليوم بشكل كبير على التدريب على مجموعات بيانات موسومة تعلمها كيفية تفسير كتلة نصية ، أو تحديد الأشياء في صورة أو إطار فيديو ، وغيرها من المهام.
على الرغم من قدراتها ، فإن نماذج الذكاء الاصطناعي والتعلم الآلي ليست مثالية ، ويعمل العلماء على بناء نماذج قادرة على التعلم من المعلومات التي يتم تقديمها لها ، وليس بالضرورة الاعتماد على بيانات مخططة أو معلمة. هذا النهج يُعرف باسم التعلم الذاتي الإشراف ، وهو أحد أكثر الطرق فعالية لبناء نماذج التعلم الآلي والذكاء الاصطناعي التي لديها ” الحدس ” أو المعرفة الخلفية لحل المشكلات التي تتجاوز قدرات نماذج الذكاء الاصطناعي الحالية.
لقد أظهر التعلم الذاتي الإشراف نتائجه في معالجة اللغة الطبيعية ، حيث سمح للمطورين بتدريب نماذج كبيرة يمكنها العمل مع كمية هائلة من البيانات ، وأدى إلى عدة إنجازات في مجالات الاستدلال اللغوي ، والترجمة الآلية ، والإجابة على الأسئلة.
يهدف نموذج SEER من فيسبوك (META ) إلى تعظيم قدرات التعلم الذاتي الإشراف في مجال الرؤية الحاسوبية. SEER أو SElf SupERvised هو نموذج للرؤية الحاسوبية ذات الإشراف الذاتي يحتوي على أكثر من مليار معامل ، وقادر على العثور على أنماط أو تعلم حتى من مجموعة عشوائية من الصور الموجودة على الإنترنت دون تعليقات توضيحية أو وسوم مناسبة.
الحاجة إلى التعلم الذاتي الإشراف في الرؤية الحاسوبية
التعليق التوضيحي على البيانات أو وسمها هو مرحلة ما قبل المعالجة في تطوير نماذج التعلم الآلي والذكاء الاصطناعي. يتمثل عملية وسم البيانات في تحديد البيانات الخام مثل الصور أو إطارات الفيديو ، ثم إضافة علامات على البيانات لتحديد سياق البيانات للنموذج. تسمح هذه العلامات للنموذج بإجراء تنبؤات دقيقة على البيانات.
أحد أكبر العوائق التي تواجه المطورين عند العمل على نماذج الرؤية الحاسوبية هو العثور على بيانات موسومة عالية الجودة. تعتمد نماذج الرؤية الحاسوبية اليوم على هذه البيانات الموسومة لتعلم الأنماط التي تمكنها من التعرف على الأشياء في الصورة.
يعرض وسم البيانات واستخدامه في نموذج الرؤية الحاسوبية التحديات التالية:
إدارة جودة المجموعة البيانية المستمرة
من المحتمل أن يكون أكبر عائق أمام المطورين هو الحصول على مجموعة بيانات عالية الجودة بشكل مستمر ، لأن مجموعة بيانات عالية الجودة مع علامات واضحة وصور واضحة تؤدي إلى تعلم أفضل ونموذج أكثر دقة. ومع ذلك ، فإن الحصول على مجموعة بيانات عالية الجودة بشكل مستمر له تحدياته الخاصة.
إدارة القوى العاملة
غالبًا ما يأتي وسم البيانات مع مشاكل إدارة القوى العاملة ، ويرجع ذلك أساسًا إلى لأن عددًا كبيرًا من العمال مطلوب لمعالجة وتصنيف كميات كبيرة من البيانات غير المهيكلة وغير المعلّمة ، مع ضمان الجودة. لذلك ، من الضروري للمطورين أن يجدوا توازنًا بين الجودة والكمية عند وسم البيانات.
القيود المالية
من المحتمل أن يكون أكبر عائق هو القيود المالية المرافقة لوسم البيانات ، وغالبًا ما يكون تكلفة وسم البيانات نسبة كبيرة من التكلفة الإجمالية للمشروع.
كما يمكن رؤية ذلك ، فإن وسم البيانات هو عائق كبير في تطوير نماذج الرؤية الحاسوبية المتقدمة ، خاصة عند تطوير نماذج معقدة تتعامل مع كمية كبيرة من بيانات التدريب. هذا هو السبب في أن مجال الرؤية الحاسوبية تحتاج إلى التعلم الذاتي الإشراف لتطوير نماذج متقدمة وقادرة على التعامل مع مهام تتجاوز قدرات نماذج الرؤية الحاسوبية الحالية.
مع ذلك ، هناك بالفعل العديد من نماذج التعلم الذاتي الإشراف التي أدت أداء جيدًا في بيئة خاضعة للرقابة ، وخاصة على مجموعة بيانات ImageNet. على الرغم من أن هذه النماذج قد تؤدي أداء جيدًا ، إلا أنها لا تفي بالشرط الأساسي للتعلم الذاتي الإشراف في الرؤية الحاسوبية: التعلم من أي مجموعة بيانات غير محددة أو صورة عشوائية ، وليس فقط من مجموعة بيانات محددة جيدًا. عند تنفيذه بشكل مثالي ، يمكن للتعلم الذاتي الإشراف المساعدة في تطوير نماذج الرؤية الحاسوبية أكثر دقة وقدرة واقتصادية.
SEER أو SElf-supERvised Model: مقدمة
تشير الاتجاهات الحديثة في مجال الذكاء الاصطناعي والتعلم الآلي إلى أن نهجات ما قبل التدريب مثل النصف إشرافي والضعيف الإشرافي والتعلم الذاتي الإشراف يمكن أن تحسن الأداء بشكل كبير لمعظم نماذج التعلم العميق للمهام اللاحقة.
هناك عاملان رئيسيان ساهموا بشكل كبير في تحسين أداء هذه النماذج العميقة.
التدريب على مجموعات بيانات ضخمة
التدريب على مجموعات بيانات ضخمة يؤدي عادةً إلى دقة وأداء أفضل ، لأنه يخضع النموذج لمجموعة واسعة من البيانات. تسمح مجموعة البيانات الكبيرة للنموذج بفهم الأنماط في البيانات بشكل أفضل ، وينتج عن ذلك أداء أفضل في السيناريوهات الحقيقية.
من بين أفضل النماذج أداءً نماذج مثل GPT-3 و Wav2vec 2.0 ، والتي يتم تدريبها على مجموعات بيانات ضخمة. يستخدم نموذج GPT-3 لغة ما قبل التدريب مع أكثر من 300 مليار كلمة ، بينما يستخدم نموذج Wav2vec 2.0 لتعرف الكلام مجموعة بيانات مع أكثر من 53 ألف ساعة من بيانات الصوت.
نماذج ذات سعة كبيرة
النماذج التي تحتوي على عدد أكبر من المعاملات غالبًا ما تؤدي نتائج دقيقة ، لأن عدد المعاملات الأكبر يسمح للنموذج بالتركيز على الأشياء في البيانات التي هي فقط ضرورية ، بدلاً من التركيز على التداخل أو الضوضاء في البيانات.
لقد حاول المطورون في الماضي تدريب نماذج التعلم الذاتي الإشراف على بيانات غير مخططة أو غير منضبطة مع مجموعات بيانات أصغر تحتوي على بضع ملايين صورة فقط. لكن هل يمكن أن تؤدي نماذج التعلم الذاتي الإشراف نتائج دقيقة عند تدريبها على كمية كبيرة من البيانات غير المعلّمة وغير المنضبطة؟ هذا هو السؤال الذي يهدف نموذج SEER إلى الإجابة عليه.
نموذج SEER هو إطار للتعلم العميق يهدف إلى تسجيل الصور المتاحة على الإنترنت بشكل مستقل عن مجموعات بيانات مخططة أو معلمة. يسمح إطار SEER للمطورين بتدريب نماذج التعلم الآلي الكبيرة والمعقدة على بيانات عشوائية بدون إشراف ، أي أن النموذج يحلل البيانات ويتعلم الأنماط أو المعلومات بنفسه بدون أي إدخال يدوي.
الهدف النهائي لنموذج SEER هو المساعدة في تطوير استراتيجيات للتدريب قبل الإشراف التي تستخدم بيانات غير مخططة لتوفير أداء رائع في نقل التعلم. بالإضافة إلى ذلك ، يهدف نموذج SEER إلى إنشاء أنظمة يمكنها التعلم المستمر من تدفق لا نهاية له من البيانات بطريقة إشرافية ذاتية.
يتم تدريب إطار SEER على نماذج ذات سعة عالية على مليارات الصور العشوائية وغير المحددة المستخرجة من الإنترنت. لا تعتمد النماذج المدربة على هذه الصور على بيانات التعريف أو العلامات لتدريب النموذج أو تصفية البيانات. في الآونة الأخيرة ، أظهر التعلم الذاتي الإشراف إمكانات كبيرة ، حيث أدت نماذج مدربة على بيانات غير مخططة إلى نتائج أفضل عند مقارنتها بنماذج مدربة مسبقًا بموجب الإشراف للمهام اللاحقة.
إطار SEER و RegNet: ما هو الصلة؟
لتحليل نموذج SEER ، يركز على هيكل RegNet مع أكثر من 700 مليون معامل يتوافق مع هدف SEER من التعلم الذاتي الإشراف على بيانات غير مخططة لسببين رئيسيين:
- يقدمون توازنًا مثاليًا بين الأداء والكفاءة.
- هم مرنون للغاية ، ويمكنهم التكيف مع عدد من المعاملات.

إطار SEER: أعمال سابقة من مجالات مختلفة
يهدف إطار SEER إلى استكشاف حدود تدريب هيكل نماذج كبير في مجموعات بيانات غير مخططة أو غير معلمة باستخدام التعلم الذاتي الإشراف ، ويتطلع النموذج إلى الإلهام من الأعمال السابقة في المجال.
التدريب المسبق غير الخاضع للإشراف للسمات البصرية
لقد تم تطبيق التعلم الذاتي الإشراف في الرؤية الحاسوبية منذ بعض الوقت الآن باستخدام أساليب مثل المُرمِّز ، والتمييز على مستوى المثال ، أو التجميع. في الآونة الأخيرة ، أظهرت الأساليب التي تستخدم التعلم التبايني أن التدريب المسبق للنماذج باستخدام التعلم غير الخاضع للإشراف يمكن أن يؤدي إلى نتائج أفضل من النهج الإشرافي الموجه.
النقطة الرئيسية التي يمكن استخلاصها من التعلم غير الخاضع للإشراف للسمات البصرية هي أن ما دام كنت تتدرّب على بيانات منضبطة ، لا تحتاج إلى علامات مخططة. يهدف نموذج SEER إلى استكشاف ما إذا كان النموذج يمكن أن يتعلم تمثيلات دقيقة عندما يتم تدريب هيكل نماذج كبير على كمية كبيرة من الصور غير المخططة وغير المعلّمة.
تعلم السمات البصرية على نطاق واسع
استفادت النماذج السابقة من التدريب المسبق للنماذج على مجموعات بيانات كبيرة معلمة ضعيفًا أو مخططًا أو شبه مخطط على ملايين الصور المخططة. بالإضافة إلى ذلك ، أظهر تحليل النماذج أن التدريب المسبق للنموذج على مليارات الصور غالبًا ما يؤدي إلى دقة أفضل عند مقارنته بتدريب النموذج من الصفر.
علاوة على ذلك ، يعتمد التدريب على نطاق واسع عادةً على خطوات تصفية البيانات لجعل الصور تتوافق مع المفاهيم المستهدفة. تستخدم خطوات التصفية هذه إما تنبؤات من مصنّف مخطط مسبقًا أو تستخدم الهاش تاغات التي غالبًا ما تكون متوافقة مع فئات ImageNet. يعمل نموذج SEER بشكل مختلف ، لأنه يهدف إلى تعلم السمات في أي صورة عشوائية ، وبالتالي فإن بيانات التدريب لنموذج SEER لا يتم تخطيطها لتتوافق مع مجموعة محددة من السمات أو المفاهيم.
توسيع الهياكل لتعرف الصور
النماذج تنتفع عادةً من التدريب على هياكل كبيرة على بيانات ذات جودة أفضل ، مما يؤدي إلى سمات بصرية أفضل. من الضروري تدريب هياكل كبيرة عند التدريب المسبق على مجموعة بيانات كبيرة ، لأن النموذج محدود السعة قد يعجز عن تعلم الأنماط بما يكفي.
تزداد أهمية توسيع الهياكل عند استخدام التعلم التبايني في التدريب المسبق، إذ يجب على النموذج التمييز بين أمثلة مجموعة البيانات ليتعلم تمثيلات بصرية أفضل. لكن توسيع بنية نموذج التعرف على الصور لا يقتصر على تغيير العمق والعرض؛ فبناء نموذج عالي السعة وكفؤ عند التوسع يتطلب الاستفادة من الأبحاث المعمارية. ويبيّن SEER فوائد عائلة RegNet في تطبيق التعلم الذاتي الإشراف على نطاق واسع.
SEER: الأساليب والمكونات المستخدمة
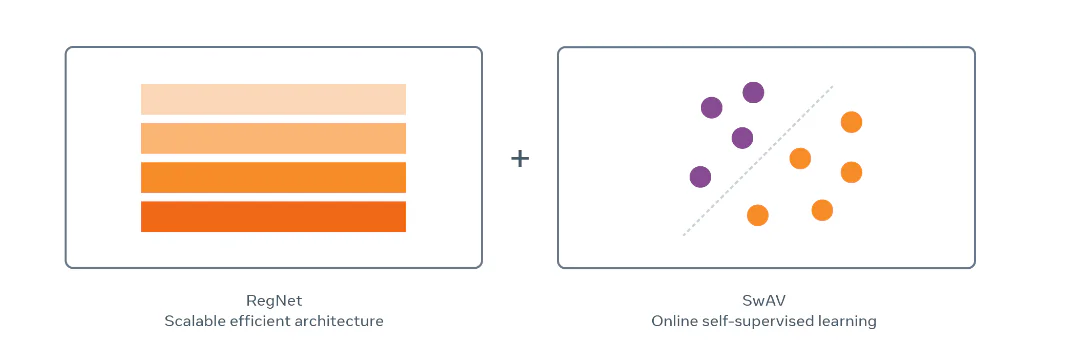
يستخدم إطار SEER مجموعة متنوعة من الأساليب والمكونات لتدريب النموذج على تعلم التمثيلات البصرية. بعض الأساليب والمكونات الرئيسية المستخدمة في إطار SEER هي: RegNet و SwAV. دعونا نناقش الأساليب والمكونات المستخدمة في إطار SEER بشكل موجز.
التدريب المسبق الذاتي الإشراف مع SwAV
يتم تدريب إطار SEER مسبقًا مع SwAV ، وهو نهج للتعلم الذاتي الإشراف عبر الإنترنت. SwAV هو نهج تجميع عبر الإنترنت يُستخدم لتدريب إطار الشبكات التلافيفية بدون علامات.
يعمل إطار SwAV عن طريق تدريب التضمين الذي ينتج تعيينات المجموعة بشكل متسق بين وجهات نظر مختلفة لنفس الصورة. ثم يتعلم النظام تمثيلات دلالية عن طريق استخراج مجموعات لا تتغير مع تعديلات البيانات.
في الممارسة ، يقارن إطار SwAV بين سمات وجهات نظر مختلفة للصورة من خلال استخدام تعييناتها المستقلة للمجموعة. إذا كانت هذه التعيينات تلتقط نفس السمات أو السمات الشبيهة ، فمن الممكن التنبؤ بتعيين صورة واحدة باستخدام تمثيل ميزة صورة أخرى.
يفترض نموذج SEER وجود K عناقيد، يرتبط كل منها بمتجه قابل للتعلم ذي d أبعاد، نرمز إليه بـ vₖ. وفي دفعة تضم B صور، تُحوّل كل صورة i إلى منظورين مختلفين xᵢ₁ وxᵢ₂، ثم تستخرج شبكة تلافيفية تمثيلات السمات من كل منظور. وتُسند كل مجموعة من السمات بصورة مستقلة إلى النماذج الأولية للعناقيد باستخدام محلّل للنقل الأمثل.
يضمن محلّل النقل الأمثل توزيع السمات بالتساوي بين العناقيد، لتجنب الحل التافه الذي يربط جميع التمثيلات بنموذج أولي واحد. ثم تُبدّل الإسنادات بين المنظورين: يُتنبأ بإسناد العنقود yᵢ₁ للمنظور xᵢ₁ باستخدام تمثيل السمات fᵢ₂ للمنظور xᵢ₂، والعكس صحيح.
بعد ذلك تُدرّب أوزان النماذج الأولية والشبكة التلافيفية لتقليل الخسارة على جميع الأمثلة. وخسارة التنبؤ بالعناقيد l هي الإنتروبيا المتقاطعة بين إسناد العنقود وتوزيع softmax الناتج من الجداء النقطي لتمثيل السمات مع النماذج الأولية.

RegNetY: عائلة نماذج كفاءة مقياس
توسيع سعة النموذج وبياناته يتطلب هياكل كفاءة ليس فقط من حيث الذاكرة ، ولكن أيضًا من حيث وقت التشغيل ، و RegNets هي عائلة من النماذج مصممة خصيصًا لهذا الغرض.
تُحدد عائلة هيكل RegNet بمساحة تصميم للشبكات التلافيفية مع 4 مراحل ، حيث تحتوي كل مرحلة على سلسلة من الكتلة المتطابقة مع الحفاظ على هيكل الكتلة الثابتة ، بشكل رئيسي كتلة عنق الزجاجة المتبقية.
يركز إطار SEER على هيكل RegNetY ويضيف وحدة الضغط والإثارة (Squeeze-and-Excitation) إلى هيكل RegNets القياسي في محاولة لتحسين أدائه. بالإضافة إلى ذلك ، يحتوي نموذج RegNetY على 5 معاملات تساعد في البحث عن مثيلات جيدة مع عدد ثابت من عمليات الفاصلة العائمة (FLOPs) ضمن موارد معقولة. ويسعى SEER إلى تحسين نتائجه بتطبيق بنية RegNetY مباشرةً على مهمة التدريب المسبق الذاتي الإشراف.
هيكل RegNetY 256GF: يركز نموذج SEER بشكل رئيسي على هيكل RegNetY 256GF في عائلة RegNetY ، ويستخدم معاملاته قاعدة التوسيع للهياكل RegNets. يتم وصف المعاملات كما يلي.

يحتوي هيكل RegNetY 256GF على 4 مراحل مع أوسع المراحل (528، 1056، 2904، 7392) وأعماق المراحل (2، 7، 17، 1) التي تصل إلى أكثر من 696 مليون معامل. عند التدريب على 512 وحدة معالجة رسومات NVIDIA V100 بسعة 32 غيغابايت ، يستغرق كل تكرار حوالي 6125 مللي ثانية ل حجم دفعة 8704 صورة. التدريب على مجموعة بيانات تضم أكثر من مليار صورة ، مع حجم دفعة 8704 صورة على أكثر من 512 جهاز ، يتطلب 114890 تكرارًا ، و يستغرق التدريب حوالي 8 أيام.
التحسين والتدريب على نطاق واسع
يقترح نموذج SEER عدة تعديلات لتدريب الأساليب الذاتية الإشرافية لتطبيق هذه الأساليب وتكيفها مع نطاق كبير. هذه الأساليب هي:
- جدول معدل التعلم.
- تقليل استهلاك الذاكرة لكل وحدة معالجة رسومات.
- تحسين سرعة التدريب.
- بيانات التدريب المسبق على نطاق واسع.
دعونا نناقشها بشكل موجز.
جدول معدل التعلم
يستكشف نموذج SEER إمكانية استخدام جدولين لمعدل التعلم: جدول معدل التعلم بجيب التمام ، و جدول معدل التعلم الثابت.
يُستخدم جدول معدل التعلم بجيب التمام لتحديد النماذج بشكل عادل ، لأنه يتكيف مع عدد التحديثات. ومع ذلك ، لا يتكيف جدول معدل التعلم بجيب التمام مع التدريب على نطاق واسع بشكل رئيسي ، لأنه يُعد الصور بشكل مختلف بناءً على وقت رؤيته أثناء التدريب ، ويستخدم التحديثات الكاملة لجدولة المواعيد.
يحافظ جدول معدل التعلم الثابت على معدل التعلم الثابت حتى يصبح الخسارة غير متناقصة ، ثم يتم قسمة معدل التعلم على 2. تظهر التحليلات أن جدول معدل التعلم الثابت يعمل بشكل أفضل ، لأنه يتيح مزيدًا من المرونة في جعل التدريب أكثر مرونة. ومع ذلك ، نظرًا لأن النموذج يتدرب فقط على مليار صورة ، يستخدم جدول معدل التعلم بجيب التمام لتدريب نموذجه الأكبر ، RegNet 256GF.
تقليل استهلاك الذاكرة لكل وحدة معالجة رسومات
يهدف النموذج أيضًا إلى تقليل استهلاك ذاكرة وحدات معالجة الرسومات أثناء التدريب من خلال استخدام الدقة المختلطة وحفظ نقاط التحقق للتدرجات.
يستخدم النموذج مكتبة NVIDIA Apex Library’s O1 Optimization level لأداء العمليات مثل التلافيف وال GEMMs بدقة 16 بت. يستخدم النموذج أيضًا تطبيق PyTorch’s Gradient Checkpointing الذي يبادل الحسابات مقابل الذاكرة.
علاوة على ذلك ، يتخلص النموذج من أي تنشيطات متوسطة يتم إجراؤها أثناء المرحلة الأمامية ، وأثناء المرحلة الخلفية ، يتم إعادة حساب هذه التنشيطات.
تحسين سرعة التدريب
يوفر استخدام الدقة المختلطة لتحسين استهلاك الذاكرة فوائد إضافية؛ فالمسرّعات تستفيد من الحجم الأصغر لتمثيل FP16 مقارنةً بـ FP32 لزيادة الإنتاجية، مما يسرّع التدريب ويخفف اختناق عرض النطاق الترددي للذاكرة.
يتم تحسين سرعة التدريب من خلال تزامن BatchNorm الطبقة عبر وحدات معالجة الرسومات لإنشاء مجموعات العملية بدلاً من استخدام التزامن العالمي الذي يأخذ عادةً وقتًا أطول.
أخيرًا ، يقوم محمل البيانات المستخدم في نموذج SEER بتحميل المزيد من دفعات التدريب ، مما يؤدي إلى كمية أكبر من البيانات التي يتم تمريرها مقارنةً بمحمل البيانات في PyTorch.
بيانات التدريب المسبق على نطاق واسع
يستخدم نموذج SEER أكثر من مليار صورة خلال التدريب المسبق ، ويفكر في محمل بيانات يختار الصور العشوائية مباشرةً من الإنترنت و Instagram.
نظرًا لأن نموذج SEER يتدرب على هذه الصور في البرية وعلى الإنترنت ، فإنه لا يطبق أي معالجة مسبقة على هذه الصور ولا يخضعها لعمليات مثل إزالة التكرارات أو تصفية الهاش تاغ.
من الجدير بالذكر أن مجموعة البيانات ليست ثابتة ، والصور في مجموعة البيانات يتم تحديثها كل ثلاثة أشهر. ومع ذلك ، لا يؤثر تحديث مجموعة البيانات على أداء النموذج.
تنفيذ نموذج SEER
يتم تدريب نموذج SEER مسبقًا على RegNetY 256GF مع SwAV باستخدام ستة اقتصاصات لكل صورة ، مع كل صورة لها دقة 2×224 + 4×96.
خلال مرحلة التدريب المسبق ، يستخدم النموذج 3 طبقات من MLP أو الشبكة العصبية متعددة الطبقات مع رؤوس الإسقاط بأبعاد 10444×8192 و 8192×8192 و 8192×256.
بدلاً من استخدام طبقات BatchNorm في الرأس ، يستخدم نموذج SEER 16 ألف بروتوتايب مع معامل الحرارة t مضبوط على 0.1. يتم تعيين معامل الانتظامة Sinkhorn إلى 0.05 ، ويتم تنفيذ 10 تكرارات من الخوارزمية.
يتم مزامنة إحصاءات BatchNorm عبر وحدات معالجة الرسومات ، ويتم إنشاء مجموعات العملية مع حجم 64 للتزامن.
علاوة على ذلك ، يستخدم النموذج محسّن LARS أو Layer-wise Adaptive Rate Scaling ، واضمحلال الأوزان 10-5 ، وحفظ نقاط تحقق التنشيطات، والدقة المختلطة بمستوى التحسين O1.
يتم تدريب النموذج باستخدام التدرج العشوائي مع حجم دفعة 8192 صورة عشوائية موزعة على 512 وحدة معالجة رسومات من NVIDIA ، مما يؤدي إلى 16 صورة لكل وحدة معالجة رسومات.
يتم زيادة معدل التعلم بشكل خطي من 0.15 إلى 9.6 خلال أول 8000 تحديث تدريبي. بعد مرحلة الإحماء ، يتبع النموذج جدول معدل التعلم بجيب التمام الذي يتناقص إلى قيمة نهائية من 0.0096.
بشكل عام ، يتدرب نموذج SEER على أكثر من مليار صورة خلال 122000 تكرار.
نتائج إطار SEER
تُدرس جودة السمات الناتجة عن التدريب المسبق الذاتي الإشراف وتُحلل باستخدام معايير تقييم ومهام لاحقة متنوعة. ويُختبر النموذج أيضًا في إعداد التعلم من أمثلة قليلة، حيث يكون الوصول إلى صور المهام اللاحقة ووسومها محدودًا.
ضبط النماذج المسبقة التدريب الكبيرة
يتم قياس جودة النماذج المسبقة التدريب على بيانات عشوائية عن طريق نقلها إلى مجموعة بيانات ImageNet لتصنيف الأشياء.
إعدادات التجارب
تُدرّب مسبقًا ست بنى من RegNet بسعات مختلفة، هي RegNetY-{8,16,32,64,128,256}GF، باستخدام SwAV على أكثر من مليار صورة عشوائية عامة من Instagram.
يتم بعد ذلك ضبط النماذج لتصنيف الصور على مجموعة بيانات ImageNet التي تستخدم أكثر من 1.28 مليون صورة تدريبية مع علامات مناسبة ، و مجموعة تحقق مع أكثر من 50 ألف صورة للتقويم.
يتم تطبيق نفس تقنيات تعديل البيانات كما في SwAV ، وضبط لمدة 35 دورة مع محسّن SGD أو التدرج العشوائي مع حجم دفعة 256 ، ومعدل تعلم 0.0125 يتم تقليله بعامل 10 بعد 30 دورة ، وزخم مقداره 0.9 ، واضمحلال الأوزان 10-4.
يتم الإبلاغ عن دقة أعلى 1 على مجموعة التحقق باستخدام الاقتصاص المركزي من 224×224.
مقارنة مع نهجات التدريب المسبق الذاتي الإشراف الأخرى
في الجدول التالي ، يتم مقارنة أكبر نموذج مسبق التدريب في RegNetY-256GF مع نماذج مسبقة التدريب الحالية التي تستخدم نهج التعلم الذاتي الإشراف.

كما يمكن رؤية ذلك ، يعود نموذج SEER إلى دقة أعلى 1 بنسبة 84.2٪ على ImageNet ، ويتفوق على SimCLRv2 ، أفضل نموذج مسبق التدريب الحالي ، بنسبة 1٪.
علاوة على ذلك ، يقارن الشكل التالي إطار SEER مع نماذج ذات سعة مختلفة.

يُدرّب SEER مسبقًا على صور عشوائية غير منتقاة، باستخدام بنية RegNet وطريقة SwAV للتعلم الذاتي الإشراف. وتُقارن نتائجه بنماذج SimCLRv2 وViT ذات البنى الشبكية المختلفة، ثم يُضبط على ImageNet وتُعرض دقة التصنيف ضمن الاختيار الأول (top-1).
تأثير سعة النموذج
لسعة النموذج تأثير كبير على أداء التدريب المسبق ، والشكل التالي يقارن ذلك مع التأثير عند التدريب من الصفر.

تتجاوز دقة top-1 للنماذج المدرّبة مسبقًا دقة النماذج المدرّبة من الصفر، وتتسع الفجوة مع زيادة عدد المعاملات. وتستفيد المجموعتان من زيادة السعة، لكن الفائدة أكبر للنماذج المدرّبة مسبقًا عند الأعداد الكبيرة من المعاملات. وقد يرجع فرط التكيّف عند التدريب من الصفر على ImageNet إلى صغر حجم مجموعة البيانات.
التعلم من عدد قليل من الأمثلة
التعلم من عدد قليل من الأمثلة يشير إلى تقييم أداء نموذج SEER في إعداد يتضمن عددًا قليلًا من الأمثلة ، أي استخدام جزء فقط من البيانات الكلية عند أداء المهام اللاحقة.
إعدادات التجارب
يفترض التقييم في نقل التعلم وصولًا محدودًا إلى الصور ووسومها معًا. وهذا يختلف عن الإعداد المعتاد للتعلم الذاتي الإشراف، حيث تتاح جميع الصور وتُقيّد الوسوم وحدها. ويستخدم إطار SEER مجموعتي بيانات للتعلم من أمثلة قليلة، هما Places205 و ImageNet.
نتائج على مجموعة بيانات Place205
الرسم التالي يظهر تأثير التدريب المسبق للنموذج على أجزاء مختلفة من مجموعة بيانات Place205.

تُقارن هذه الطريقة بالتدريب المسبق بالإشراف على ImageNet باستخدام البنية نفسها RegNetY-128GF. وتُظهر المقارنة تحسنًا ثابتًا يقارب 2.5 نقطة مئوية في دقة top-1، بصرف النظر عن نسبة بيانات Places205 المتاحة للضبط الدقيق. وقد تفسّر طبيعة بيانات التدريب هذا الفرق: فالسمات المتعلّمة من صور عشوائية في الواقع قد تلائم تصنيف المشاهد أكثر. كذلك قد يفيد عدم تجانس توزيع المفاهيم عند التدريب المسبق لمجموعة غير متوازنة مثل Places205.
نتائج على ImageNet

تُقارن طريقة SEER بطرق التدريب المسبق الذاتي الإشراف وشبه الإشرافي في إعداد التعلم من أمثلة قليلة. وتستخدم الطرق المقارنة كامل صور ImageNet البالغ عددها نحو 1.2 مليون صورة في التدريب المسبق، مع تقييد الوصول إلى الوسوم فقط، بينما يرى SEER ما بين 1 و10% من صور ImageNet. وتستفيد الطرق الأخرى من رؤية صور أكثر من التوزيع نفسه، ومع ذلك يذكر المقال أن SEER يحقق دقة top-1 تقارب 80%، أقل قليلًا من نتائج المقارنة.
تأثير سعة النموذج
الشكل التالي يناقش تأثير سعة النموذج على التعلم من عدد قليل من الأمثلة عند 1٪ و 10٪ و 100٪ من مجموعة بيانات ImageNet.

يمكن رؤية ذلك بوضوح أن زيادة سعة النموذج يمكن أن تحسن دقة النموذج عند انخفاض الوصول إلى الصور والعلامات في مجموعة البيانات.
نقل إلى معايير تقييم أخرى
من أجل تقييم نموذج SEER بشكل أكبر وتحليل أدائه ، يتم نقل السمات المسبقة التدريب إلى مهام لاحقة أخرى.
التقييم الخطي لتصنيف الصور

تُقارن سمات RegNetY-256GF المدرّب مسبقًا بطريقة SEER بسمات RegNetY-128GF المدرّب مسبقًا على ImageNet، مع الإشراف وبدونه. ولتقييم جودة السمات تُجمّد أوزان النموذج، ويُدرّب مصنّف خطي فوقها باستخدام بيانات تدريب المهمة اللاحقة. وتشمل معايير التقييم Open-Images (OpIm)، وiNaturalist (iNat)، وPlaces205 (Places)، وPascal VOC (VOC).
الكشف والتقسيم
يتم مقارنة السمات المسبقة التدريب على الكشف والتقسيم.

يُدرّب إطار SEER نموذج Mask-RCNN على معيار COCO باستخدام RegNetY-64GF وRegNetY-128GF المدرّبين مسبقًا كبنيتين أساسيتين. وفي البنيتين والمهام اللاحقة، يتفوق التدريب المسبق الذاتي الإشراف على التدريب بالإشراف بمقدار 1.5 إلى نقطتين من متوسط الدقة (AP).
مقارنة مع التدريب المسبق الضعيف الإشراف
غالبًا ما تحتوي الصور المتاحة على الإنترنت على وصف أو نص بديل أو وصفات أو موقع جغرافي يمكن أن يوفر ميزة خلال التدريب المسبق.
أظهرت الأعمال السابقة أن التنبؤ ب مجموعة مخططة من الهاش تاغات يمكن أن يحسن جودة السمات البصرية الناتجة.
لكن هذا النهج يتطلب تصفية الصور ويعمل بصورة أفضل عند توافر بيانات وصفية نصية. ويقارن الشكل التالي التدريب المسبق لبنية ResNeXt101-32dx8d على صور عشوائية بتدريب البنية نفسها على صور موسومة بالوسوم والبيانات الوصفية، ويعرض دقة top-1 في الحالتين.

يمكن رؤية ذلك بوضوح أن نموذج SEER يؤدي أداءً مشابهًا للنماذج التي تستخدم البيانات النصية خلال التدريب المسبق.
دراسات الحذف
تُجرى دراسة الاستئصال لتحليل تأثير مكوّن محدد في الأداء الكلي للنموذج، وذلك بإزالته تمامًا ثم قياس الأداء، مما يوضح للمطورين مقدار إسهامه.
تأثير هيكل النموذج
لهيكل النموذج تأثير كبير على أداء النموذج ، خاصة عند توسيع النموذج أو تعديل مواصفات بيانات التدريب المسبق.
الرسم التالي يناقش تأثير تغيير الهيكل على جودة السمات المسبقة التدريب عند تقييمها خطيًا على مجموعة بيانات ImageNet.

في البنيتين ResNeXt وResNet، تعمل السمات المستخرجة من الطبقة قبل الأخيرة بصورة أفضل في هذا الإعداد، بينما تتفوق بنية RegNet على البنى الأخرى. وبوجه عام، تحسن زيادة سعة النموذج جودة السمات، مع مكاسب لوغاريتمية في الأداء.
توسيع بيانات التدريب المسبق
هناك سببان يناقشهما المقال لتحسن جودة السمات عند التدريب على بيانات أكثر: زيادة عدد الصور الفريدة وزيادة عدد تحديثات المعاملات. ملاحظة على النص الأصلي: عنوان «المزيد من المعاملات» هنا يخلط بين عدد المعاملات وعدد تحديثاتها؛ وتتناول الدراسة الأصلية عدد التحديثات.
زيادة عدد الصور الفريدة

يقارن الشكل أثر عدد الصور الفريدة عند تدريب RegNetY-8GF وRegNetY-16GF باستخدام العدد نفسه من تحديثات التدريب. ويعادل ذلك دورة واحدة على مليار صورة أو 32 دورة على 32 مليون صورة فريدة، مع جدول لمعدل التعلم يتبع نصف موجة جيب تمام. ملاحظة على النص الأصلي: سقطت منه وحدة «مليون» بعد العدد 32، كما أن تثبيت المقارنة يتعلق بعدد التحديثات لا بتساوي عدد معاملات البنيتين.
يمكن رؤية ذلك بوضوح أن النموذج يؤدي أداءً أفضل عندما يتم تدريبه على عدد أكبر من الصور الفريدة.
المزيد من المعاملات
الرسم التالي يظهر أداء النموذج عند تدريبه على مليار صورة باستخدام هيكل RegNet-128GF.

يتحسن أداء النموذج باستمرار مع زيادة عدد تحديثات المعاملات، وفقًا للقسم 5.2 من الدراسة الأصلية. ملاحظة على النص الأصلي: المقصود هنا عدد التحديثات أثناء التدريب، وليس زيادة حجم النموذج.
الرؤية الحاسوبية الذاتية الإشراف في العالم الحقيقي
حتى الآن ، لقد ناقشنا كيف يعمل التعلم الذاتي الإشراف ونموذج SEER للرؤية الحاسوبية في النظرية.
دعونا ننظر الآن إلى كيفية عمل الرؤية الحاسوبية الذاتية الإشراف في السيناريوهات الحقيقية ، ولماذا نموذج SEER هو مستقبل الرؤية الحاسوبية الذاتية الإشراف.
نموذج SEER يتنافس مع العمل المنجز في مجال معالجة اللغة الطبيعية ، حيث يستخدم نماذج متقدمة من أحدث ما توصلت إليه التقنية تريليونات من مجموعات البيانات ومعاملات ، ومترافقة مع تريليونات من الكلمات النصية خلال التدريب المسبق للنموذج.
أداء النماذج على المهام اللاحقة يزيد عادةً مع زيادة عدد البيانات المدخلة للتدريب ، وهذا صحيح أيضًا لمهام الرؤية الحاسوبية.
لكن تطبيق التعلم الذاتي الإشراف على اللغة الطبيعية يختلف عن تطبيقه على الرؤية الحاسوبية. ففي النصوص تُقسّم المفاهيم الدلالية عادةً إلى كلمات منفصلة، بينما يجب على نموذج الصور أن يحدد وحدات البكسل التي تنتمي إلى كل مفهوم.
كذلك تختلف زوايا التصوير والمفاهيم حتى حين تتكرر الأشياء نفسها. فقد تظهر قطة ساكنة في صورة وتلعب بكرة في أخرى. لذلك يحتاج النموذج إلى رؤية عدد كبير من الصور كي يدرك الاختلافات المرتبطة بالمفهوم نفسه.
توسيع النموذج بنجاح بحيث يعمل بكفاءة مع بيانات الصور عالية الأبعاد والمعقدة يتطلب مكونين:
- شبكة عصبية تلافيفية كافية لتعلم المفاهيم البصرية من مجموعة بيانات صور كبيرة.
- خوارزمية يمكنها تعلم الأنماط من كمية كبيرة من الصور بدون علامات أو بيانات وصفية.
يهدف SEER إلى تطبيق هذين المكوّنين على الرؤية الحاسوبية والاستفادة من تقدم SwAV. ويستخدم هذا الإطار التجميع أثناء التدريب لربط الصور التي تشترك في مفاهيم بصرية متشابهة، ثم يستغل أوجه التشابه للتعرّف إلى الأنماط بصورة أفضل.
يستخدم نموذج SEER هيكل RegNet الذي يمكن أن يوسع تريليونات من المعاملات ويمكن تحسينه وفقًا لاحتياجات الذاكرة ووقت التشغيل.
علاوة على ذلك ، يقلل نموذج SEER من وقت التدريب بمقدار 6 أضعاف.
الختام: مستقبل إشرافي ذاتي
التعلم الذاتي الإشراف كان موضوعًا هامًا في مجال الذكاء الاصطناعي والتعلم الآلي لبعض الوقت الآن ، لأنه يسمح للنماذج بالتعلم مباشرةً من كمية كبيرة من البيانات المتاحة عشوائيًا على الإنترنت ، بدلاً من الاعتماد على مجموعات بيانات مخططة و معلمة بعناية.
التعلم الذاتي الإشراف هو مفهوم حيوي لمستقبل الذكاء الاصطناعي والتعلم الآلي ، لأنه له القدرة على تمكين المطورين من إنشاء نماذج تعلم الآلة تتوافق جيدًا مع السيناريوهات الحقيقية ، ولديها العديد من التطبيقات بدلاً من هدف معين.
نموذج SEER يأخذ الخطوة الأولى في تحويل مجال الرؤية الحاسوبية ، وتقليل اعتمادنا على مجموعات البيانات المخططة.
يهدف نموذج SEER إلى القضاء على الحاجة إلى تعليم مجموعات البيانات التي سوف تسمح للمطورين بالعمل مع كميات كبيرة ومتنوعة من البيانات.
تنفيذ نموذج SEER مفيد بشكل خاص للمطورين الذين يعملون على نماذج تتعامل مع مجالات لها صور ومعلومات محدودة مثل المجال الطبي.
علاوة على ذلك ، سوف يسمح إلغاء العلامات البشرية للمطورين بإنشاء و نشر النماذج بشكل أسرع ، مما سوف يسمح لهم بالاستجابة لأوضاع متغيرة بسرعة وبدقة.



