
زاوية Anderson
RigNeRF: طريقة جديدة للتزييف العميق تستخدم حقول الإشعاع العصبية

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةRigNeRF هي أول طريقة قابلة للتطبيق للتزييف العميق باستخدام حقول الإشعاع العصبي مع…
عرض المزيد
- RigNeRF هي أول طريقة قابلة للتطبيق للتزييف العميق باستخدام حقول الإشعاع العصبي مع التحكم في النموذج ثلاثي الأبعاد للوجه (3DMM).
- يتطلب النظام فقط فيديو مدته 70 ثانية من الهاتف الذكي للتدريب، على عكس مجموعات بيانات الترميز الذاتي الشاقة.
- يتيح RigNeRF التوليف الكامل للمشهد بما في ذلك الجسم والخلفية، وليس فقط تبديل الوجوه.
تقدم أبحاث جديدة طُورت في أدوبي (ADBE ) أول طريقة عملية وفعالة للتزييف العميق تعتمد على حقول الإشعاع العصبية (NeRF)، وربما تكون أول ابتكار حقيقي في البنية أو النهج خلال السنوات الخمس منذ ظهور التزييف العميق عام 2017.
تستخدم الطريقة المسماة RigNeRF نماذج الوجه ثلاثية الأبعاد القابلة للتشكيل (3DMMs) كطبقة تحكم وسيطة بين الإدخال المطلوب، أي الهوية المراد إدراجها في تصيير NeRF، والفضاء العصبي. وهذه طريقة اعتُمدت على نطاق واسع في السنوات الأخيرة في أساليب توليد الوجوه بالشبكات التوليدية التنافسية (GAN)، لكن أياً منها لم ينتج بعد إطاراً عملياً ومفيداً لاستبدال الوجوه في الفيديو.
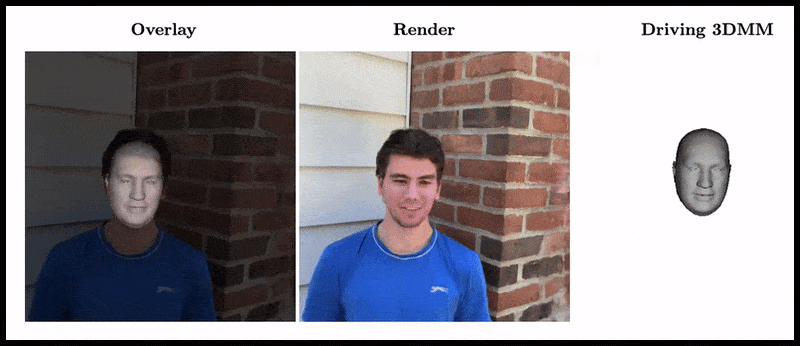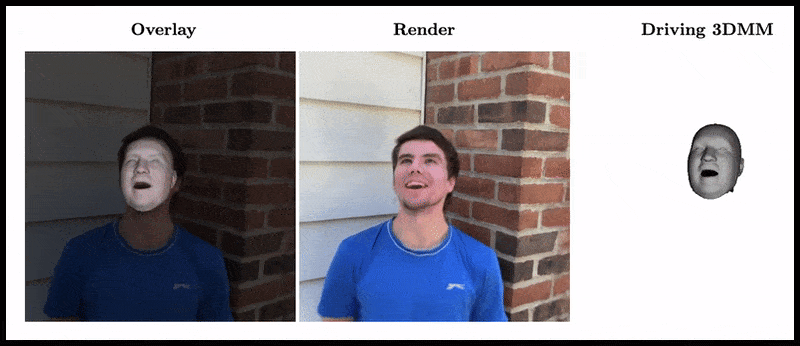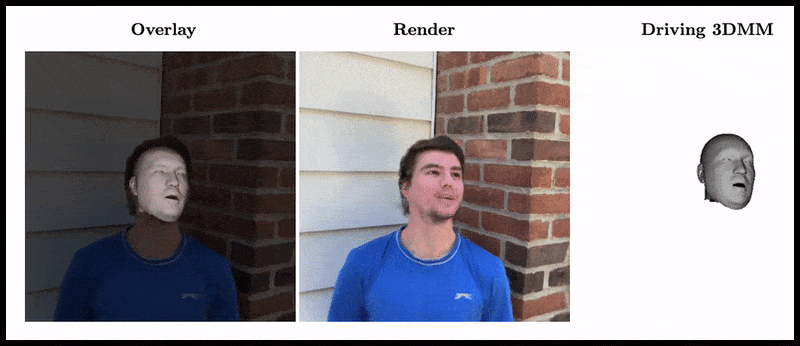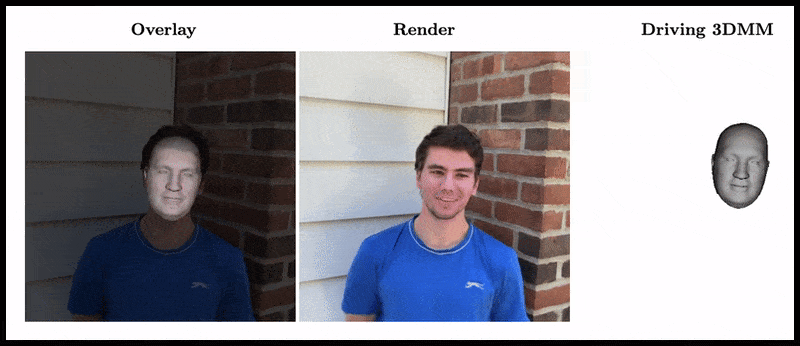
بخلاف فيديوهات التزييف العميق التقليدية، لا شيء من المحتوى المتحرك الظاهر هنا «حقيقي»، بل هو فضاء عصبي قابل للاستكشاف دُرب على مقطع قصير. على اليمين يعمل نموذج الوجه ثلاثي الأبعاد القابل للتشكيل كواجهة بين التعديلات المطلوبة، مثل الابتسام والنظر يساراً أو إلى أعلى، ومعلمات عرض حقل الإشعاع العصبي التي يصعب عادة التحكم فيها. للاطلاع على نسخة عالية الدقة من هذا المقطع وأمثلة أخرى، انظر صفحة المشروع أو الفيديوهات المضمنة في نهاية المقال. المصدر: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html
نماذج 3DMM هي عملياً نماذج وجوه منشأة بالرسوم الحاسوبية، يمكن تكييف معلماتها مع أنظمة أكثر تجريداً لتوليد الصور مثل NeRF وGAN، والتي يصعب التحكم فيها بخلاف ذلك.
ما تراه في الصورة أعلاه، الرجل بالقميص الأزرق في الوسط، وفي الصورة أدناه مباشرة، الرجل بالقميص الأزرق يساراً، ليس فيديو حقيقياً أُضيفت إليه رقعة صغيرة لوجه مزيف؛ بل مشهد مولد بالكامل لا يوجد إلا كتصيير عصبي حجمي، بما في ذلك الجسم والخلفية:
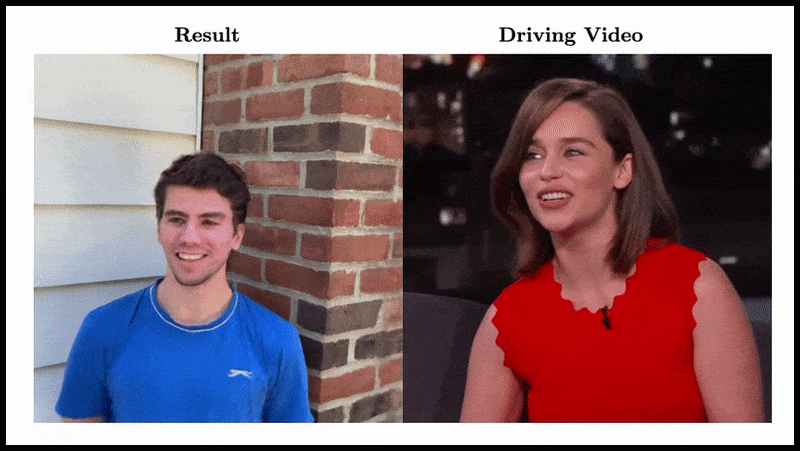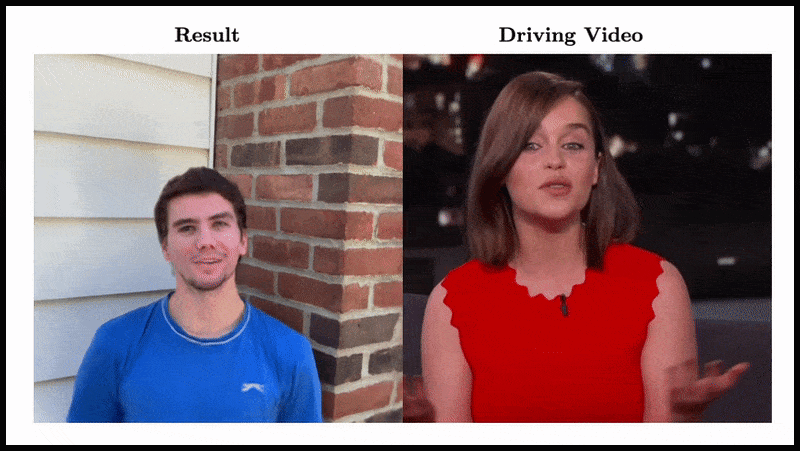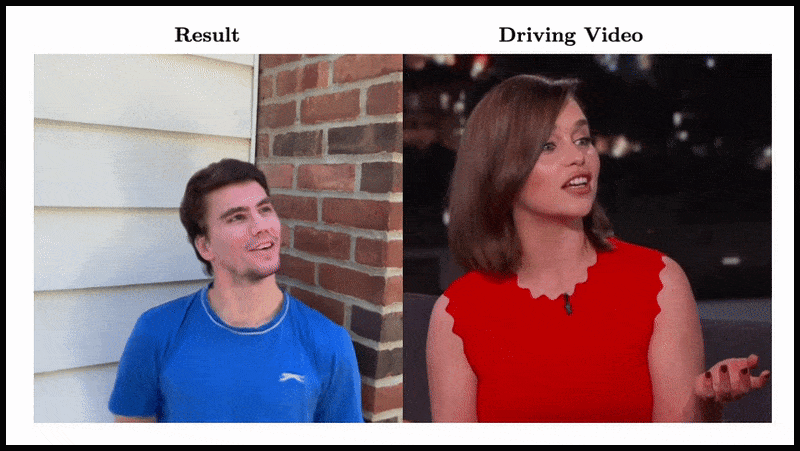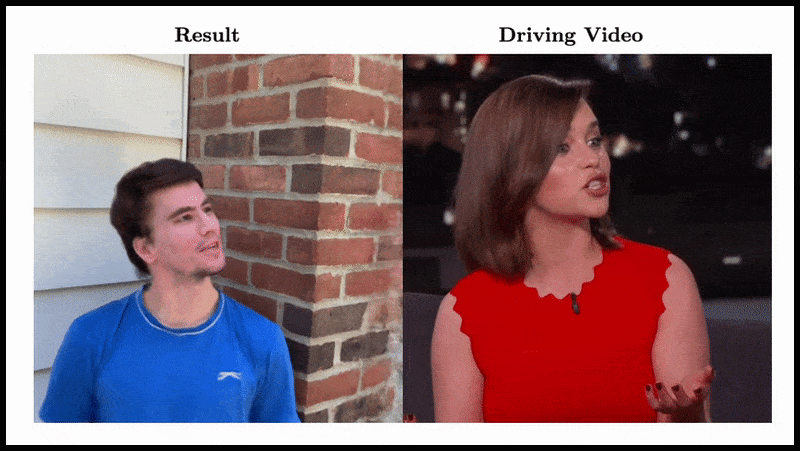
في المثال أعلاه، يُستخدم الفيديو الحقيقي على اليمين، المرأة بالفستان الأحمر، لتحريك الهوية الملتقطة على اليسار، الرجل بالقميص الأزرق، عبر RigNeRF. ويقول المؤلفون إنه أول نظام قائم على NeRF يفصل وضعية الرأس عن التعبير، مع القدرة على توليد مشاهد من زوايا رؤية جديدة.
التُقط الرجل على اليسار من فيديو هاتف ذكي مدته 70 ثانية، ثم استُخدمت بيانات الإدخال، بما فيها معلومات المشهد بأكمله، للتدريب على أربع وحدات V100 للحصول على المشهد.
وبما أن الهياكل البارامترية على غرار 3DMM متاحة أيضاً في صورة بدائل بارامترية للجسم بأكمله منشأة بالرسوم الحاسوبية، لا للوجه وحده، فقد يتيح RigNeRF تزييفاً عميقاً للجسم بالكامل: تُمرر الحركة البشرية الحقيقية وملمس السطح والتعبير إلى طبقة بارامترية قائمة على CGI، لتحول الحركة والتعبير إلى بيئات وفيديوهات NeRF مصيّرة.
هل يُعد RigNeRF طريقة للتزييف العميق بالمعنى الذي تستخدمه العناوين الإخبارية؟ أم أنه مجرد بديل آخر محدود الإمكانات ومتأخر عن DeepFaceLab وغيره من الأنظمة المعتمدة على المشفرات التلقائية منذ 2017، والتي تتطلب عملاً مكثفاً؟
موقف الباحثين في الورقة الجديدة واضح لا لبس فيه:
«لكونه طريقة قادرة على إعادة تحريك الوجوه، فإن RigNeRF عرضة لإساءة الاستخدام من الجهات الخبيثة لإنشاء تزييف عميق».
تحمل الورقة الجديدة عنوان RigNeRF: صور شخصية عصبية ثلاثية الأبعاد قابلة للتحكم بالكامل، وهي من إعداد ShahRukh Atha من جامعة Stonybrook، الذي كان متدرباً في أدوبي أثناء تطوير RigNeRF، وأربعة مؤلفين آخرين من Adobe Research.
ما وراء التزييف العميق المعتمد على المشفرات التلقائية
معظم فيديوهات التزييف العميق الرائجة التي تصدرت العناوين خلال السنوات الأخيرة أُنتجت بأنظمة تعتمد على المشفرات التلقائية، ومشتقة من الشفرة المنشورة عام 2017 في منتدى r/deepfakes الذي حُظر سريعاً، ولكن ليس قبل نسخ الشفرة إلى GitHub، حيث تفرعت عنها حالياً أكثر من ألف نسخة، من بينها توزيعة المثيرة للجدل والشهيرة DeepFaceLab، وكذلك مشروع FaceSwap.
إلى جانب GAN وNeRF، جربت أطر المشفرات التلقائية أيضاً استخدام 3DMM كأدلة توجيهية لتحسين توليد الوجوه. ومن الأمثلة مشروع HifiFace من يوليو 2021. لكن لا يبدو أن هذا النهج أفضى حتى الآن إلى مبادرات عملية أو شائعة.
تُجمع بيانات مشاهد RigNeRF بتسجيل فيديوهات قصيرة بهاتف ذكي. استخدم الباحثون iPhone XR أو iPhone 12 في جميع التجارب. في النصف الأول من التسجيل، يؤدي الشخص مجموعة متنوعة من التعبيرات والكلام مع إبقاء رأسه ثابتاً، بينما تتحرك الكاميرا حوله.
في النصف الثاني، تثبت الكاميرا في موضع واحد، بينما يحرك الشخص رأسه ويظهر تعبيرات متنوعة. وتشكل اللقطات الناتجة، ومدتها 40–70 ثانية أو نحو 1200–2100 إطار، مجموعة البيانات الكاملة لتدريب النموذج.
تقليل جمع البيانات
في المقابل، تتطلب أنظمة المشفرات التلقائية مثل DeepFaceLab جمع آلاف الصور المتنوعة وانتقاءها بجهد كبير، وغالباً ما تؤخذ من فيديوهات YouTube ووسائل التواصل الأخرى، وكذلك الأفلام في حالة تزييف المشاهير.
غالباً ما تستهدف النماذج المدربة الناتجة استخدامات متعددة. لكن بعض أكثر صناع تزييف المشاهير تدقيقاً قد يدربون نموذجاً كاملاً من الصفر لفيديو واحد، رغم أن التدريب قد يستغرق أسبوعاً أو أكثر.
على الرغم من تحذير الباحثين، يُستبعد أن تنتج مجموعات البيانات المجمعة من مصادر متفرقة، المستخدمة في المواد الإباحية المولدة بالذكاء الاصطناعي واستبدال الشخصيات الرائج على YouTube وTikTok، نتائج مقبولة ومتسقة في نظام مثل RigNeRF، الذي يعتمد منهجية خاصة بمشهد معين. وقد تمثل قيود جمع البيانات الموضحة في العمل حماية إضافية، إلى حد ما، من انتحال الهوية العابر بواسطة صناع التزييف الخبيثين.
تكييف NeRF مع فيديو التزييف العميق
NeRF طريقة قائمة على القياس التصويري تجمع عدداً صغيراً من الصور الأصلية الملتقطة من زوايا مختلفة في فضاء عصبي ثلاثي الأبعاد قابل للاستكشاف. برز هذا النهج في وقت سابق من ذلك العام عندما كشفت NVIDIA (NVDA ) عن نظام Instant NeRF، القادر على تقليص أوقات تدريب NeRF الهائلة إلى دقائق، أو حتى ثوانٍ:
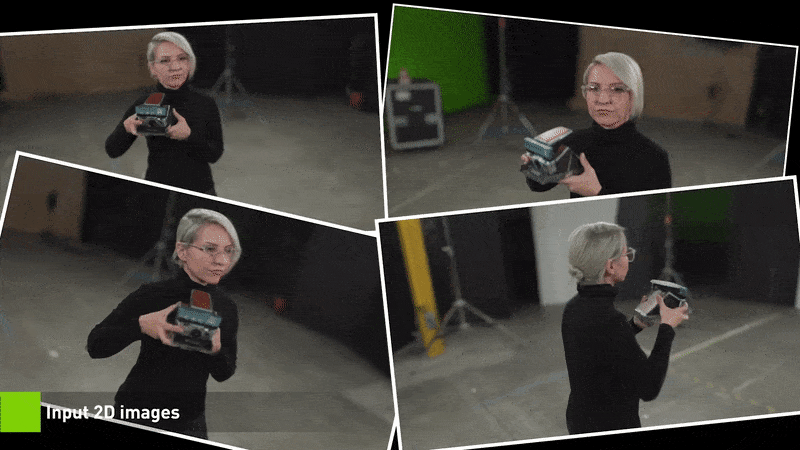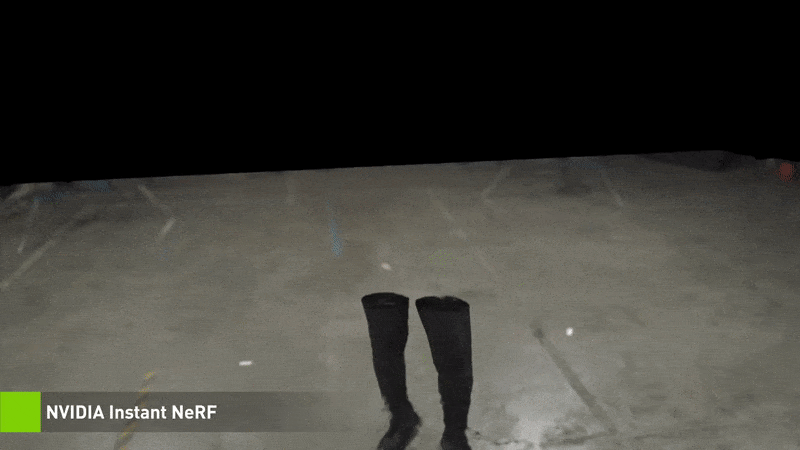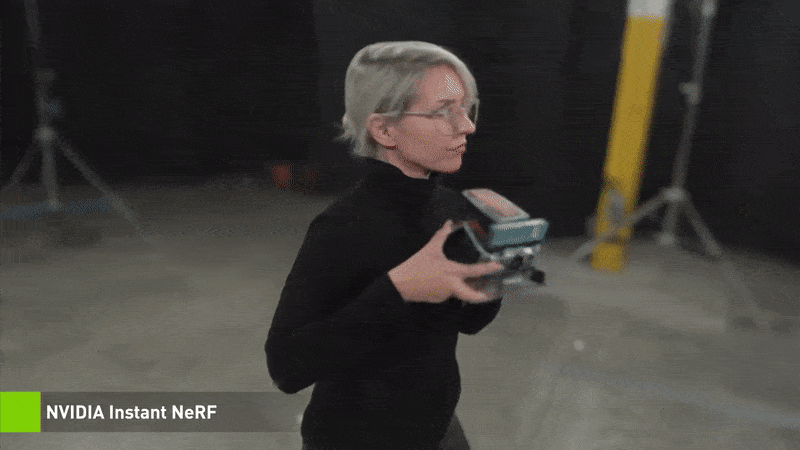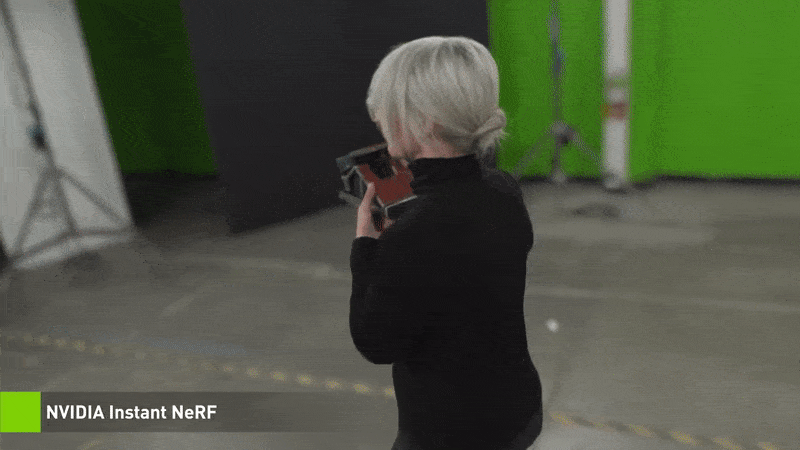
Instant NeRF. المصدر: https://www.youtube.com/watch?v=DJ2hcC1orc4
مشهد حقل الإشعاع العصبي الناتج هو في جوهره بيئة ثابتة يمكن استكشافها، لكن يصعب تحريرها. يشير الباحثون إلى أن مبادرتين سابقتين قائمتين على NeRF، هما HyperNeRF + E/P وNerFACE، حاولتا توليد فيديوهات للوجه. وقد اختبروا RigNeRF مقابل هذين الإطارين، على ما يبدو حرصاً على اكتمال المقارنة ودقتها:
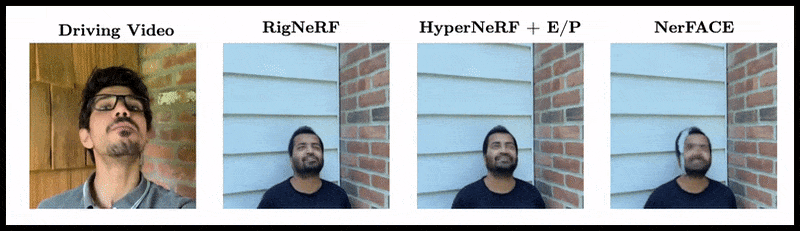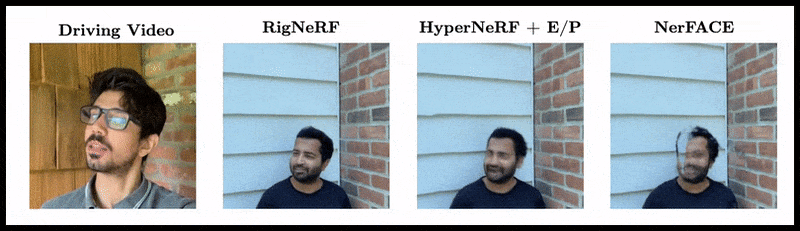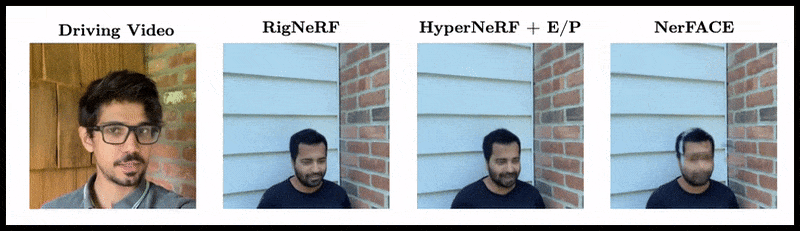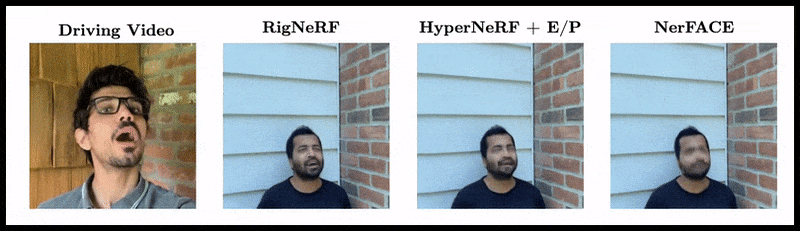
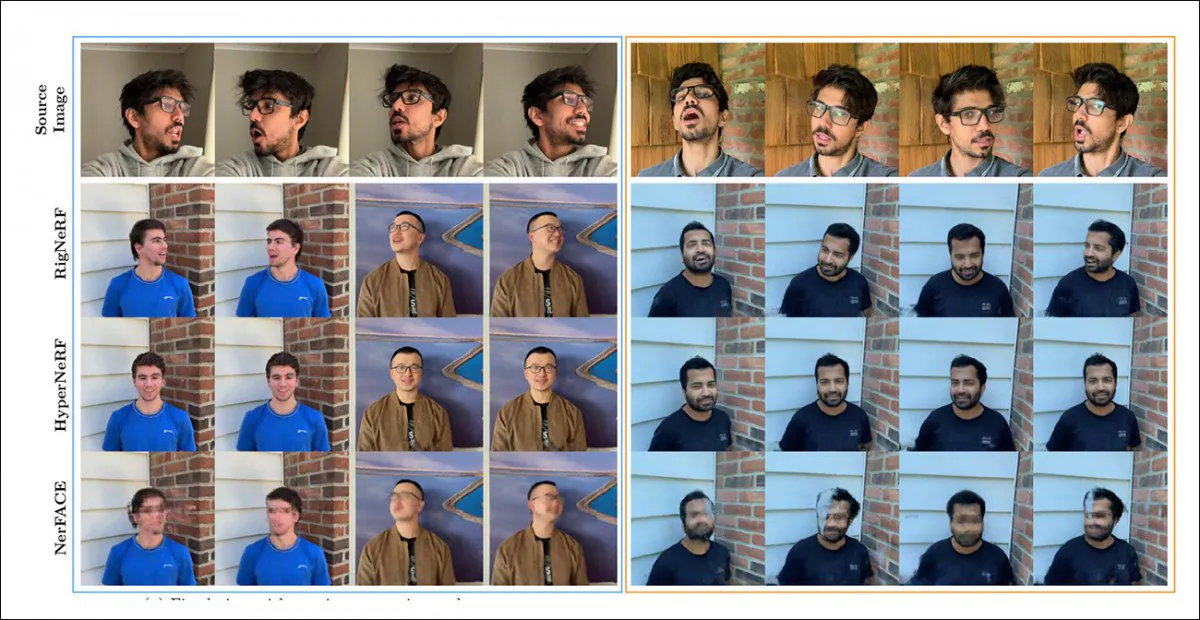
مقارنة نوعية بين RigNeRF وHyperNeRF وNerFACE. راجع الفيديوهات الأصلية وملف PDF المرتبطين للاطلاع على نسخ أعلى جودة. مصدر الصورة الثابتة: https://arxiv.org/pdf/2012.03065.pdf
لكن النتائج التي ترجح RigNeRF غير اعتيادية لسببين: أولاً، يذكر المؤلفون أنه لا يوجد عمل سابق يتيح مقارنة مباشرة متكافئة؛ وثانياً، اقتضى ذلك تقييد قدرات RigNeRF حتى تطابق جزئياً على الأقل الوظائف الأكثر محدودية للأنظمة السابقة.
ولأن النتائج ليست تحسناً تدريجياً على أعمال سابقة، بل تمثل قفزة في قابلية تحرير NeRF وفائدته، سنترك جولة الاختبارات جانباً وننظر إلى ما يفعله RigNeRF بصورة مختلفة.
الجمع بين نقاط القوة
القيد الأساسي في NerFACE، الذي يتيح التحكم في الوضعية والتعبير داخل بيئة NeRF، أنه يفترض تسجيل اللقطات الأصلية بكاميرا ثابتة. لذلك لا يستطيع توليد زوايا رؤية جديدة تتجاوز حدود التسجيل. والنتيجة نظام قادر على إنشاء صور شخصية متحركة، لكنه غير مناسب لفيديوهات على غرار التزييف العميق.
أما HyperNeRF فيستطيع توليد زوايا رؤية جديدة شديدة الواقعية، لكنه يفتقر إلى وسائل لتغيير وضعيات الرأس أو تعبيرات الوجه، فلا يصبح بذلك منافساً للتزييف العميق المعتمد على المشفرات التلقائية.
يجمع RigNeRF بين هاتين الوظيفتين بإنشاء فضاء معياري يمثل خط أساس افتراضياً، يمكن إحداث انحرافات وتشوهات عنه بمدخلات وحدة 3DMM.

إنشاء فضاء معياري بلا وضعية أو تعبير، تطبق عليه التشوهات، أي الوضعيات والتعبيرات، التي ينتجها 3DMM.
بما أن نظام 3DMM لن يطابق الشخص الملتقط تماماً، فلا بد من تعويض ذلك. يحقق RigNeRF هذا باستخدام معلومات مسبقة عن حقل التشوه، تُحسب من مدرك متعدد الطبقات (MLP) مشتق من اللقطات الأصلية.

تُستخرج معلمات الكاميرا اللازمة لحساب التشوهات عبر COLMAP، وتُستخرج معلمات التعبير والشكل لكل إطار من DECA.
ويُحسن تحديد الموضع أكثر باستخدام ملاءمة النقاط المرجعية ومعلمات كاميرا COLMAP. وبسبب قيود موارد الحوسبة، تُخفض دقة الفيديو إلى 256×256 للتدريب، وهو تقليص تفرضه الأجهزة ويؤثر أيضاً في التزييف العميق بالمشفرات التلقائية.
بعد ذلك تُدرب شبكة التشوه على وحدات V100 الأربع، وهي أجهزة قوية يُستبعد أن تكون في متناول الهواة العاديين. لكن تدريب التعلم الآلي يسمح غالباً باستبدال القدرة الحاسوبية الأقل بوقت أطول، وقبول أن يستغرق التدريب أياماً أو حتى أسابيع.
ويخلص الباحثون إلى القول:
«بخلاف الطرق الأخرى، يستطيع RigNeRF، بفضل وحدة تشوه موجهة بنموذج 3DMM، نمذجة وضعية الرأس وتعبيرات الوجه والمشهد الكامل للصورة الشخصية ثلاثية الأبعاد بدقة عالية، مما ينتج إعادة بناء أفضل وتفاصيل حادة».
شاهد الفيديوهات المضمنة أدناه لمزيد من التفاصيل والنتائج.
نُشر أول مرة في 15 يونيو 2022.


