
زاوية Anderson
GAN أداةً لتصيير الوجوه في الرسوم الحاسوبية التقليدية

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةلا يزال فصل الهوية عن التعبير في الفضاء الكامن لشبكات GAN التحدي المركزي غير المحلول في…
عرض المزيد
- لا يزال فصل الهوية عن التعبير في الفضاء الكامن لشبكات GAN التحدي المركزي غير المحلول في تركيب الفيديو الوجهي.
- تُستخدم النماذج البارامترية للصور المولدة بالحاسوب مثل SMPL و3DMMs بشكل متزايد لفرض النظام على الرموز الكامنة الجامحة لشبكات GAN.
- أنتج النهج الهجين لشركة ديزني 'Rendering with Style' نتائج غريبة من خلال دمج خرائط النسيج التقليدية مع الصور المولدة بواسطة GAN.
رأي عندما أثبتت الشبكات التوليدية التنافسية (GAN) لأول مرة قدرتها على إنتاج وجوه ثلاثية الأبعاد مذهلة الواقعية، أشعل ذلك سباقاً لاستكشاف قدرتها غير المستغلة على إنشاء فيديو لوجوه بشرية متسق عبر الزمن.
بدا أن مكاناً ما في الفضاء الكامن لهذه الشبكات لا بد أن يخفي نظاماً وعقلانية: منطقاً دلالياً ناشئاً مدفوناً في الرموز الكامنة، يسمح بتوليد مناظر وتفسيرات متعددة ومتسقة، مثل تغيرات التعبير، للوجه نفسه. وقد يتيح ذلك طريقة لفيديو التزييف العميق مقنعة زمنياً، تتفوق كثيراً على المشفّرات التلقائية.
كان الإخراج عالي الدقة سيصبح سهلاً مقارنة ببيئات الدقة المنخفضة التي تفرضها قيود GPU على DeepFaceLab وFaceSwap. وستتحول منطقة استبدال الوجه في سير عمل المشفّرات التلقائية إلى منطقة إنشاء لدى GAN، تسترشد ببضع صور إدخال أو حتى بصورة واحدة.
ولن يبقى اختلاف بين الوجه المستبدَل والوجه المضيف، لأن الصورة بأكملها ستنشأ من الصفر، بما فيها الشعر وحدود الفك والأطراف الخارجية لملامح الوجه، وهي عناصر كثيراً ما تعوق التزييف العميق التقليدي بالمشفّرات التلقائية.
شتاء فيديو الوجوه باستخدام GAN
لكن الأمر لم يكن بهذه السهولة. ففي النهاية أصبح فصل العوامل المشكلة المركزية، وما زال التحدي الرئيسي. كيف نحافظ على هوية وجه مميزة ونغيّر وضعيته أو تعبيره من دون جمع آلاف الصور المرجعية لتعليم الشبكة نتائج هذه التغييرات، كما تفعل أنظمة المشفّرات التلقائية بجهد كبير؟
اتجه التفكير اللاحق في أبحاث تحريك الوجوه وتركيبها بشبكات GAN إلى إمكان إخضاع الهوية المدخلة لتحويلات موجّهة نحو غاية وعامة وقائمة على قوالب، لا تختص بتلك الهوية. مثال ذلك تطبيق تعبير على وجه GAN لا يظهر في أي صورة معروفة للشبكة عن ذلك الشخص.

من دراسة Tensor-based Emotion Editing in the StyleGAN Latent Space المنشورة عام 2022: تطبيق تعبيرات قائمة على قوالب على وجه إدخال من مجموعة FFHQ. المصدر: https://arxiv.org/pdf/2205.06102.pdf
من الواضح أن نهجاً موحداً للجميع لا يغطي تنوع تعبيرات الوجه الخاصة بكل فرد. فهل يمكن لابتسامة فريدة مثل ابتسامة جاك نيكلسون أو ويليم دافو أن تُفسَّر بأمانة تحت تأثير رموز كامنة لتعبير متوسط؟

من هذا الغريب اللاتيني الساحر؟ رغم أن GAN ينتج وجهاً أكثر واقعية وأعلى دقة، فإن التحويل لا يستند إلى صور حقيقية متعددة للممثل، بخلاف DeepFaceLab الذي يتدرب مطولاً على آلاف الصور. ولذلك تتضرر درجة الشبه. في الخلفية تُستورد إحدى نماذج DeepFaceLab إلى DeepFaceLive، وهو تطبيق للبث المباشر من هذا البرنامج الشائع والمثير للجدل. الأمثلة من https://www.youtube.com/watch?v=9tr35y-yQRY (2022) وhttps://arxiv.org/pdf/2205.06102.pdf.
اقتُرحت في السنوات الأخيرة أدوات عديدة لتحرير تعبيرات الوجوه بشبكات GAN. ومعظمها يتعامل مع هويات غير مألوفة، فلا يستطيع القارئ العادي تقييم أمانة التحويلات لأنه لا يعرف هذه الوجوه.

تحويل هويات غير مألوفة في Cascade-EF-GAN لعام 2020. المصدر: https://arxiv.org/pdf/2003.05905.pdf
ربما كان محرر الوجوه الذي حظي بأكبر اهتمام واستشهادات خلال السنوات الثلاث الماضية هو InterFaceGAN. إذ يجتاز الفضاء الكامن عبر رموز ترتبط بالوضعية، أي زاوية الكاميرا أو الوجه، والتعبير والعمر والعرق والجنس وغيرها من السمات الأساسية.
قدرات التحويل التدريجي بأسلوب الثمانينيات لدى InterFaceGAN والأطر المشابهة توضح أساساً مسار التحويل عند إعادة إسقاط الصورة عبر رمز كامن مناسب، مثل العمر. لكن في إنتاج فيديو ذي استمرارية زمنية، ظلت هذه المخططات حتى الآن كوارث مثيرة للإعجاب.
وإذا أضفنا صعوبة إنشاء شعر متسق زمنياً، وافتقار استكشاف الرموز الكامنة ومعالجتها إلى توجيه زمني مدمج، فقد نستنتج أن GAN ليست كل ما تحتاج إليه™ لتركيب فيديو الوجوه. وليس واضحاً كيف نضيف هذا التوجيه إلى إطار صُمم للصور الثابتة ولا يدعم إخراج الفيديو أصلاً.
حققت الجهود اللاحقة تحسينات تدريجية في فصل العوامل. وأضافت أبحاث أخرى أساليب من الرؤية الحاسوبية كطبقة توجيه، مثل استخدام التقسيم الدلالي آليةً للتحكم في دراسة SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing الصادرة في أواخر 2021.
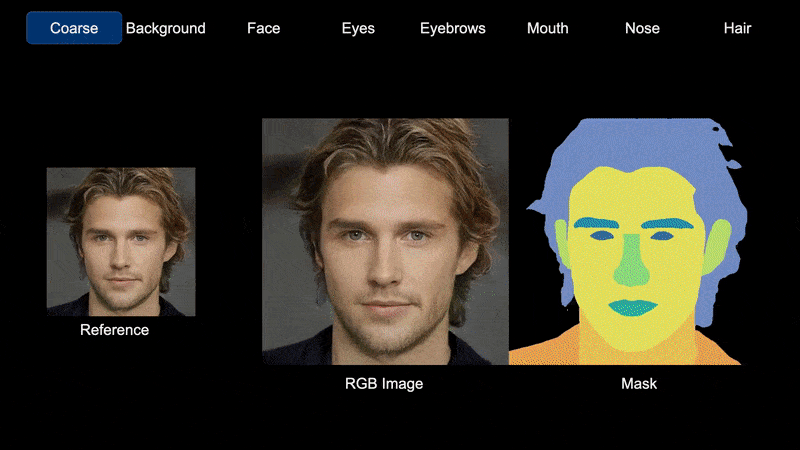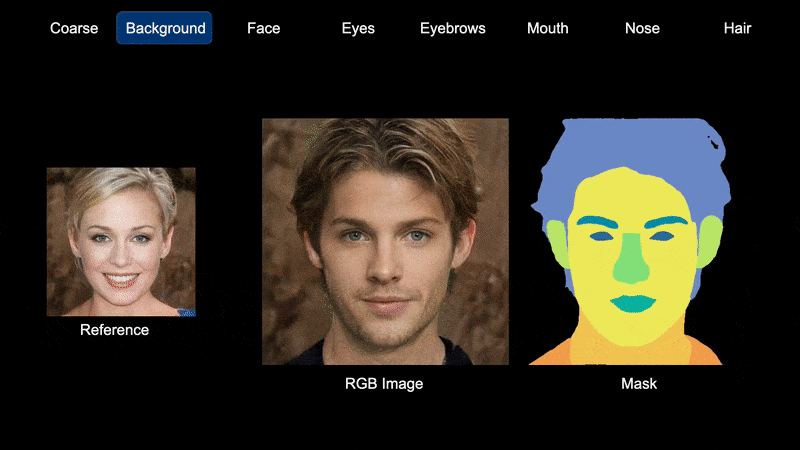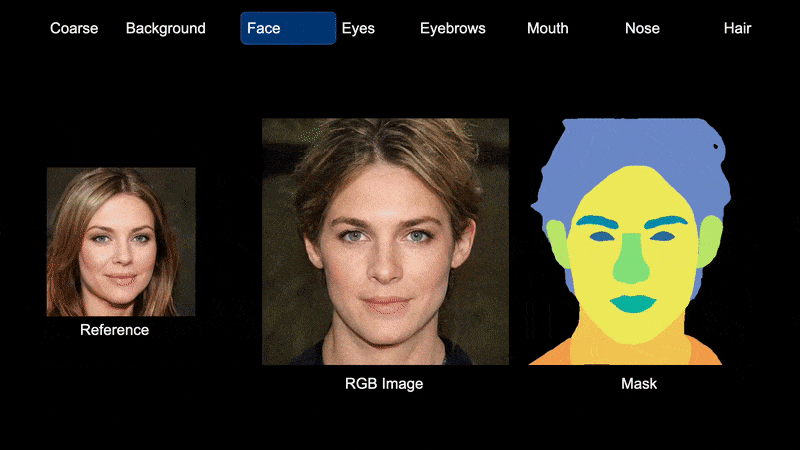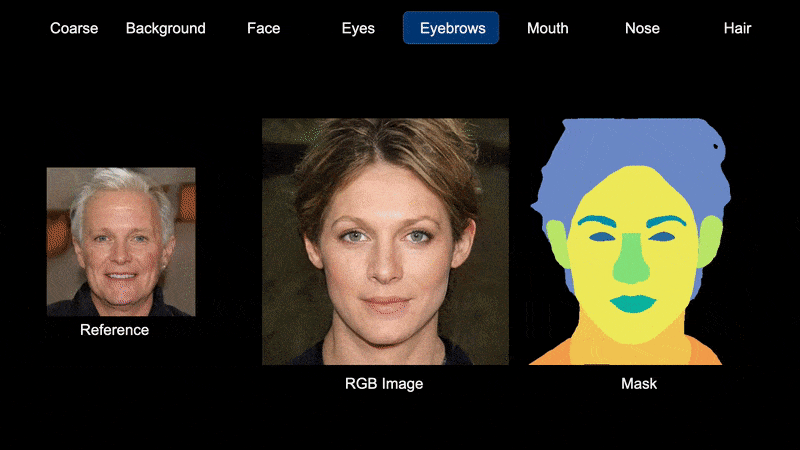
التقسيم الدلالي وسيلةً للتحكم في الفضاء الكامن في SemanticStyleGAN. المصدر: https://semanticstylegan.github.io/
التوجيه البارامتري
يتجه باحثو تركيب الوجوه بشبكات GAN بصورة متزايدة إلى الوجوه البارامترية التقليدية المنشأة حاسوبياً CGI، لتوجيه الرموز الكامنة المبهرة وصعبة الضبط وإضفاء النظام عليها.
رغم أن العناصر الأولية للوجوه البارامترية راسخة في أبحاث الرؤية الحاسوبية منذ أكثر من عشرين عاماً، فقد تجدد الاهتمام بها مع زيادة استخدام عناصر CGI من نوع Skinned Multi-Person Linear Model (SMPL). وهو نهج أسسه معهد ماكس بلانك وILM، ثم حُسّن بإطار Sparse Trained Articulated Human Body Regressor (STAR).

يمكن لـSMPL، وهنا المتغير المسمى SMPL-X، فرض شبكة هندسية بارامترية CGI تطابق الوضعية المقدَّرة لكامل الجسم البشري الظاهر في الصورة، بما فيها التعبيرات عند الحاجة. وتتيح الشبكة عمليات جديدة على الصورة باستخدامها مرشداً حجمياً أو إدراكياً. المصدر: https://arxiv.org/pdf/1904.05866.pdf
كان أبرز تطور في هذا الاتجاه مبادرة ديزني لعام 2019 Rendering with Style، التي جمعت خرائط الملمس التقليدية بصور GAN لمحاولة إنشاء رسوم متحركة محسنة بأسلوب التزييف العميق.

يلتقي القديم بالجديد في نهج ديزني الهجين للتزييف العميق المُنشأ بشبكات GAN. المصدر: https://www.youtube.com/watch?v=TwpLqTmvqVk
يُدخل نهج ديزني عناصر CGI المصيّرة تقليدياً إلى StyleGAN2 لاستكمال الوجوه في المناطق الصعبة، مثل ملمس البشرة، حيث يصعب الحفاظ على الاتساق الزمني عند توليد الفيديو.

سير عمل Rendering with Style.
لأن الرأس البارامتري CGI الذي يوجه العملية قابل للتعديل وفق احتياجات المستخدم، يستطيع الوجه الناتج من GAN عكس تلك التغييرات، ومنها وضعية الرأس والتعبير.
ومع أن الهدف جمع قابلية التحكم في CGI بالواقعية الطبيعية لوجوه GAN، فإن النتائج تُظهر أسوأ ما في النهجين. فهي لا تحافظ حتى الآن على اتساق ملمس الشعر أو حتى مواضع الملامح الأساسية.
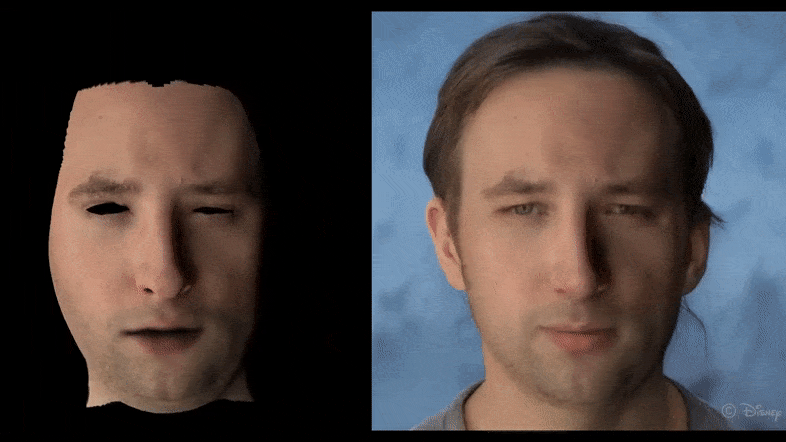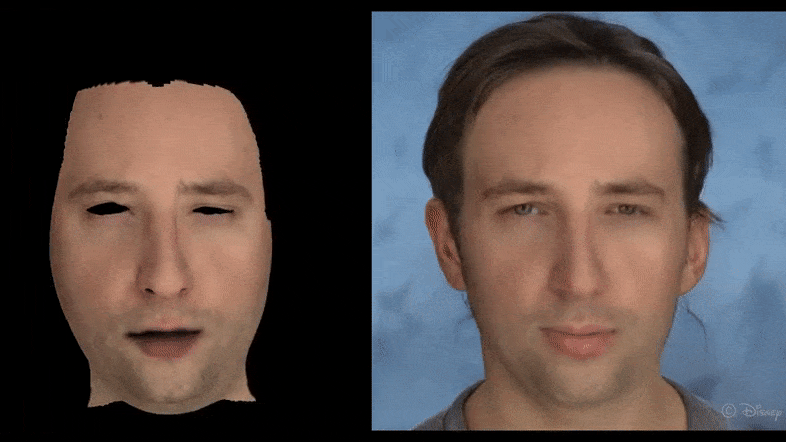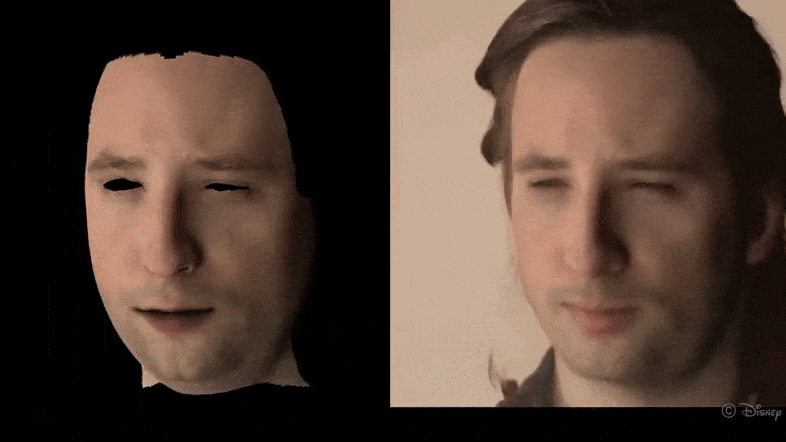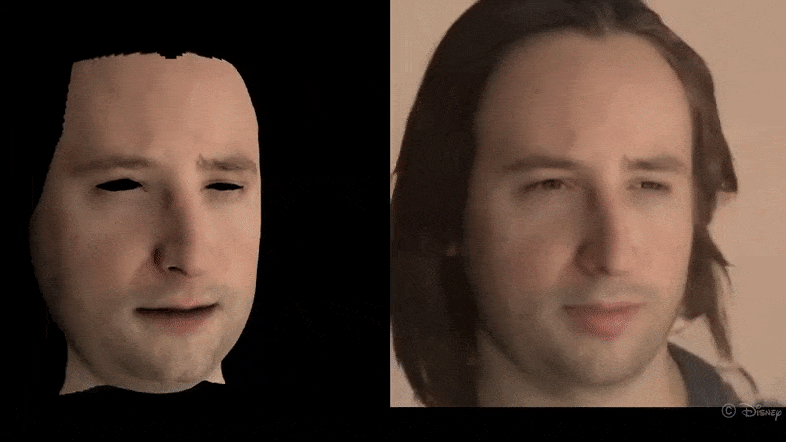
يُنتج Rendering with Style شكلاً جديداً من الوادي الغريب، رغم أن المبدأ ما زال يحمل بعض الإمكانات.
تتبع دراسة StyleRig: Rigging StyleGAN for 3D Control over Portrait Images لعام 2020 نهجاً يزداد شيوعاً، باستخدام نماذج وجوه ثلاثية الأبعاد قابلة للتشكيل (3DMM) وسيطاً لتغيير الخصائص داخل StyleGAN، وفي هذه الحالة عبر شبكة ربط وتحكم جديدة تدعى RigNet.

تعمل نماذج 3DMM وسيطاً لتفسير الفضاء الكامن في StyleRig. المصدر: https://arxiv.org/pdf/2004.00121.pdf
لكن كالمعتاد في هذه المبادرات، تبدو النتائج حتى الآن محدودة بتغييرات طفيفة في الوضعية وتغييرات في التعبير أو الحالة الوجدانية غير موجّهة بخصائص الشخص.

يحسّن StyleRig مستوى التحكم، لكن الشعر المتسق زمنياً يظل تحدياً لم يُحل. المصدر: https://www.youtube.com/watch?v=eaW_P85wQ9k
تظهر نتائج مماثلة في MOST-GAN من Mitsubishi Research، وهي دراسة لعام 2021 تستخدم نماذج 3DMM غير الخطية بنيةً لفصل العوامل، لكنها أيضاً تواجه صعوبة في تحقيق حركة ديناميكية ومتسقة.
أحدث الأبحاث التي تحاول الجمع بين التحكم وفصل العوامل هي One-Shot Face Reenactment on Megapixels، وتستخدم مجدداً رؤوساً بارامترية 3DMM واجهةً سهلة لـStyleGAN.

في سير عمل MegaFR ضمن One-Shot Face Reenactment، تركّب الشبكة الوجه بدمج صورة حقيقية أُجري لها انعكاس إلى التمثيل الكامن مع معاملات مأخوذة من نموذج 3DMM مصيَّر. المصدر: https://arxiv.org/pdf/2205.13368.pdf
تنتمي OSFR إلى فئة متنامية من محررات وجوه GAN التي تسعى إلى سير عمل تحرير خطي شبيه بـPhotoshop أو After Effects. يستطيع المستخدم إدخال الصورة المطلوبة وتطبيق التحويلات عليها، بدلاً من البحث في الفضاء الكامن عن رموز تخص هوية ما.
لكن التعبيرات البارامترية تظل طريقة عامة غير مخصصة للشخص لإضافة التعبير. وينتج عنها تعديل يبدو غريباً على نحو خاص، ليس إيجابياً دائماً.

تعبيرات مضافة إلى OSFR.
مثل الأعمال السابقة، تستنتج OSFR وضعيات قريبة من الأصل من صورة واحدة. ويمكنها أيضاً تحويل الوجه المصوَّر بزاوية إلى صورة شخصية أمامية.

الصورة الأصلية في الأعلى والصور الأمامية المستنتجة بإحدى تطبيقات OSFR الموصوفة في الدراسة الجديدة.
عملياً، يشبه هذا الاستدلال بعض مبادئ المسح التصويري التي تدعم حقول الإشعاع العصبية (NeRF). لكن الهندسة هنا يجب تحديدها بصورة واحدة بدلاً من 3–4 زوايا نظر، تتيح لـNeRF استنتاج الوضعيات الوسيطة المفقودة وإنشاء مشاهد عصبية ثلاثية الأبعاد قابلة للاستكشاف تضم أشخاصاً.
(ومع ذلك، ليست NeRF كل ما تحتاج إليه™ أيضاً؛ ففي تركيب فيديو الوجوه تواجه عقبات تكاد تكون مختلفة تماماً عن عقبات GAN.)
هل لـGAN مكان في تركيب فيديو الوجوه؟
يبدو أن الحصول على تعبيرات ديناميكية ووضعيات خارج توزيع بيانات التدريب من صورة مصدر واحدة هوس يشبه الخيمياء في أبحاث تركيب وجوه GAN حالياً. ويرجع ذلك أساساً إلى أن GAN هي الطريقة الوحيدة القادرة الآن على إنتاج وجوه عصبية بدقة مرتفعة إلى حد كبير وأمانة مرتفعة نسبياً. يمكن للمشفّرات التلقائية تعلم أوضاع وتعابير حقيقية عديدة، لكنها تعمل بدقة إدخال وإخراج تحدها VRAM وتحتاج إلى صورة مضيفة. وNeRF محدودة بالمثل؛ وخلافاً للنهجين الآخرين لا تملك حالياً منهجيات راسخة لتغيير تعابير الوجه، كما أن قابلية تعديلها محدودة عموماً.
يبدو أن الطريق الوحيد نحو تركيب دقيق للوجوه بنظام CGI/GAN هو إيجاد طريقة لتجميع كيان هوية متعدد الصور داخل الفضاء الكامن. عندها لن يحتاج رمز هوية الشخص إلى عبور الفضاء كله لاستغلال معاملات وضعية غير مرتبطة به، بل يمكنه الرجوع إلى صوره الحقيقية المرتبطة به كمراجع للتحويل.
حتى في هذه الحالة، أو لو دُرّبت شبكة StyleGAN كاملة على صور وجه لهوية واحدة كما في مجموعات تدريب المشفّرات التلقائية، فقد يظل المنطق الدلالي المفقود بحاجة إلى تقنيات مساعدة كالتقسيم الدلالي أو وجوه 3DMM البارامترية. وفي هذا السيناريو سيكون لديها على الأقل مزيد من المادة للعمل عليها.


