
مقابلات
فرانك ليو، مدير العمليات في Zilliz – سلسلة المقابلات

 أضف Unite.AI إلى مصادرك المفضلة على Google
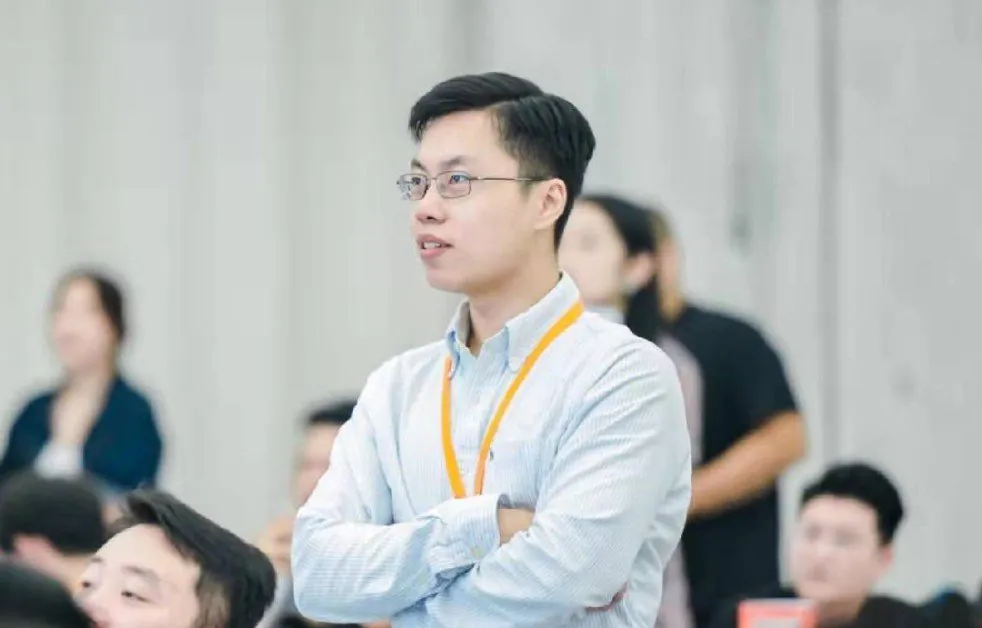
فرانك ليو هو مدير العمليات في Zilliz، وهي شركة رائدة في مجال قواعد البيانات المتجهة وتكنولوجيا الذكاء الاصطناعي. كما أنها تعتبر فريقًا من المهندسين والعلماء الذين أنشأوا LF AI Milvus، وهو قاعدة البيانات المتجهة مفتوحة المصدر الأكثر شعبية في العالم.
ما الذي جذبك في البداية إلى تعلم الآلة؟
كان تعريفي الأول لقوة ML / AI عندما كنت طالبًا في الجامعة في ستانفورد، على الرغم من أن هذا كان بعيدًا قليلاً عن تخصصي (الهندسة الكهربائية). لقد جذبتني الهندسة الكهربائية في البداية لأن القدرة على تقليص الأنظمة الكهربائية والفيزيائية المعقدة إلى تقريبات رياضية بدت لي قوية جدًا، وشعرت بالقوة نفسها في الإحصاء وتعلم الآلة. في النهاية، أخذت المزيد من فصول الرؤية الحاسوبية وتعلم الآلة خلال الدراسات العليا، ووصلت إلى كتابة أطروحتي للماجستير حول استخدام ML لتقييم الجماليات في الصور. كل هذا أدى إلى وظيفتي الأولى في فريق الرؤية الحاسوبية وتعلم الآلة في Yahoo، حيث كنت في دور بحث وتطوير برمجيات هجين. كنا ما زلنا في أيام AlexNet و VGG قبل المحولات، وكان من الرائع رؤية مجالًا كاملاً وصناعة تتحرك بسرعة كبيرة، من تحضير البيانات إلى تدريب النماذج بتوازٍ هائل ثم نشرها في بيئة الإنتاج. ومن نواحٍ كثيرة، يبدو من الغريب قليلًا استخدام عبارة «في ذلك الوقت» للإشارة إلى شيء حدث قبل أقل من عشر سنوات، لكن ذلك يعكس مدى التقدم الذي تحقق في هذا المجال.
بعد Yahoo، شغلت منصب المدير التقني لشركة ناشئة شاركت في تأسيسها، حيث استخدمنا تعلم الآلة لتحديد المواقع داخل المباني. هناك، كان علينا تحسين النماذج المتسلسلة لتعمل على متحكمات دقيقة صغيرة جدًا – تحدٍّ هندسي مختلف جدًا لكنه مرتبط بالنماذج اللغوية الكبيرة ونماذج الانتشار الضخمة اليوم. كما بنينا أجهزة، لوحات لعرض البيانات بصريًا، وتطبيقات بسيطة مصممة أصلًا للعمل في السحابة، ولكن AI / ML دائمًا كانت جزءًا أساسيًا من العمل الذي كنا نفعله.
على الرغم من أنني كنت في مجال ML أو مجالات متعلقة به لمدة 7 أو 8 سنوات الآن، إلا أنني ما زلت أحتفظ بحب كبير لتصميم الدوائر والمنطق الرقمي. أن يكون لديك خلفية في الهندسة الكهربائية هو، من نواحٍ كثيرة، مفيد جدًا للعديد من الأعمال التي أشترك فيها هذه الأيام. العديد من المفاهيم المهمة في التصميم الرقمي مثل الذاكرة الافتراضية، والتنبؤ بالتفرعات، والتنفيذ المتزامن في HDL توفر نظرة شاملة للعديد من أنظمة ML والموزعة اليوم. على الرغم من أنني أفهم جاذبية علوم الحاسوب، إلا أنني آمل في رؤية نهضة في مجالات الهندسة التقليدية – الهندسة الكهربائية، الهندسة الميكانيكية، الهندسة الكيميائية، إلخ – في السنوات القليلة القادمة.
لمن يجهل مصطلح “البيانات غير المهيكلة”، ما هو؟
البيانات غير المهيكلة تشير إلى “البيانات المعقدة”، والتي هي في الأساس بيانات لا يمكن تخزينها في تنسيق محدد مسبقًا ولا ملاءمتها لنموذج بيانات موجود. وللمقارنة، البيانات المهيكلة تشير إلى أي نوع من البيانات التي لها هيكل محدد مسبقًا – البيانات الرقمية، السلاسل، الجداول، الكائنات، ومخازن المفتاح / القيمة هي أمثلة على البيانات المهيكلة.
لفهم ماهية البيانات غير المهيكلة حقًا ولماذا يصعب تقليديًا معالجتها حاسوبيًا، من المفيد مقارنتها بالبيانات المهيكلة. في أبسط الحالات، يمكن تخزين البيانات المهيكلة التقليدية عن طريق نموذج علاقي. خذ مثلًا قاعدة بيانات علائقية تحتوي على جدول لتخزين معلومات الكتب: كل صف في الجدول يمكن أن يمثل كتابًا معينًا تمت فهرسته بواسطة رقم ISBN، بينما ستشير الأعمدة إلى الفئات المقابلة للمعلومات، مثل العنوان، المؤلف، تاريخ النشر، إلخ. في الوقت الحالي، هناك نماذج بيانات أكثر مرونة – مخازن الأعمدة الواسعة، قواعد البيانات الكائنية، قواعد بيانات الرسوم البيانية، إلخ. لكن الفكرة العامة لا تزال هي نفسها: هذه القواعد مصممة لتخزين البيانات التي تتناسب مع نموذج بيانات معين.
البيانات غير المهيكلة، من ناحية أخرى، يمكن اعتبارها بمثابة كتلة من البيانات الثنائية شبه العشوائية. يمكن أن تمثل أي شيء، وتكون كبيرة أو صغيرة بأي مقدار، ويمكن تحويلها وقراءتها بطرق لا حصر لها. هذا يجعل من المستحيل وضعها في أي نموذج بيانات، ناهيكم عن جدول في قاعدة بيانات علاقة.
ما هي بعض الأمثلة على هذا النوع من البيانات؟
البيانات التي يولدها الإنسان – الصور، الفيديو، الصوت، اللغة الطبيعية، إلخ – هي أمثلة رائعة على البيانات غير المهيكلة. لكن هناك العديد من الأمثلة الأقل روتينية على البيانات غير المهيكلة أيضًا. ملفات تعريف المستخدم، هياكل البروتين، تسلسلات الجينوم، وحتى الشفرة القابلة للقراءة البشرية هي أمثلة رائعة على البيانات غير المهيكلة. السبب الرئيسي الذي جعل من البيانات غير المهيكلة صعبة الإدارة تقليديًا هو أن البيانات غير المهيكلة يمكن أن تظهر بأي شكل ويمكن أن تتطلب وقت تشغيل مختلفًا بشكل كبير.
استخدام الصور كمثال، يمكن أن يكون لصورتين لمنظر واحد قيم بيكسل مختلفة بشكل كبير، لكن كلاهما يحتوي على محتوى عام مشابه. اللغة الطبيعية هي مثال آخر على البيانات غير المهيكلة التي أحب أن أذكرها. العبارات “الهندسة الكهربائية” و “علوم الحاسوب” متعلقة بشكل وثيق – لدرجة أن مباني الهندسة الكهربائية وعلوم الحاسوب في ستانفورد متجاورة – لكن بدون طريقة لترميز المعنى الدلالي وراء هذه العبارات، قد تفكر الحاسوب ببساطة أن “علوم الحاسوب” و “العلوم الاجتماعية” أكثر ارتباطًا.
ما هي قاعدة البيانات المتجهة؟
لفهم قاعدة بيانات متجهة، من المفيد أولاً فهم ما هو التضمين. سأقوم بذلك بعد قليل، لكن الإصدار القصير هو أن التضمين هو متجه ذو أبعاد عالية يمكن أن يمثل معاني البيانات غير المهيكلة. بشكل عام، التضمينات التي تكون قريبة من بعضها البعض فيما يتعلق بالمسافة هي في الغالب محتملة أن تتوافق مع بيانات إدخال متشابهة دلاليًا. مع ML الحديث، لدينا القدرة على ترميز وتحويل أنواع مختلفة من البيانات غير المهيكلة – الصور والنص، على سبيل المثال – إلى متجهات تضمين قوية دلاليًا.
من منظور المنظمة، تصبح البيانات غير المهيكلة صعبة الإدارة بشكل كبير بمجرد أن ينمو الحجم إلى حد معين. هنا يأتي دور قاعدة بيانات متجهة مثل Zilliz Cloud. قاعدة بيانات متجهة مبنية خصيصًا لتخزين وفهرسة وبحث عبر كميات هائلة من البيانات غير المهيكلة من خلال الاستفادة من التضمينات كتمثيل أساسي. يتم إجراء البحث عبر قاعدة بيانات متجهة عادةً باستخدام متجهات استعلام، ونتيجة الاستعلام هي النتائج N الأكثر تشابهًا بناءً على المسافة.
أفضل قواعد البيانات المتجهة لديها العديد من ميزات سهولة الاستخدام للقواعد التقليدية: التوسيع الأفقي، الذاكرة المؤقتة، النسخ المتماثل، والتحويل التلقائي عند التعطل، وتنفيذ الاستعلامات هي بعض الميزات العديدة التي يجب أن تنفذها قاعدة بيانات متجهة حقيقية. بصفتنا روادًا لهذه الفئة، لقد كنا نشطين في الدوائر الأكاديمية أيضًا، حيث نشرنا أوراقًا في SIGMOD 2021 و VLDB 2022، وهما أبرز مؤتمرين لقواعد البيانات في العالم حاليًا.
هل يمكنك شرح ما هو التضمين؟
بشكل عام، التضمين هو متجه ذو أبعاد عالية يأتي من تنشيطات طبقة متوسطة في شبكة عصبونية متعددة الطبقات. يتم تدريب العديد من الشبكات العصبونية لإخراج تضميناتها نفسها، ويستخدم بعض التطبيقات متجهات موصولة بعضها ببعض من طبقات وسيطة متعددة كتضمين، لكنني لن أتعمق في ذلك الآن. هناك طريقة أقل شيوعًا ولكنها مهمة بنفس القدر لتوليد التضمينات وهي الميزات المصممة يدويًا. بدلاً من أن يتعلم نموذج ML تلقائيًا التمثيلات الصحيحة للبيانات الإدخال، يمكن أن تعمل هندسة السمات التقليدية الجيدة للعديد من التطبيقات أيضًا. بغض النظر عن الطريقة الأساسية، التضمينات للكائنات المتشابهة دلاليًا هي قريبة من بعضها البعض فيما يتعلق بالمسافة، وهذه الخاصية هي ما يمنح قواعد البيانات المتجهة قوتها.
ما هي بعض الحالات الأكثر شعبية لاستخدام هذه التكنولوجيا؟
قواعد البيانات المتجهة رائعة لأي تطبيق يتطلب بعض أشكال البحث الدلالي – توصية المنتجات، تحليل الفيديو، البحث في المستندات، وكشف التهديدات والاحتيال، وروبوتات المحادثة المدعومة بالذكاء الاصطناعي هي بعض الحالات الأكثر شعبية لاستخدام قواعد البيانات المتجهة اليوم. لتوضيح ذلك، Milvus، قاعدة البيانات المتجهة مفتوحة المصدر التي أنشأتها Zilliz و التي تعتبر النواة الأساسية ل Zilliz Cloud، تم استخدامها من قبل أكثر من ألف مستخدم مؤسسي عبر مجموعة متنوعة من الحالات.
أنا دائمًا سعيد لمناقشة هذه التطبيقات ومساعدة الناس على فهم كيفية عملها، لكنني أستمتع حقًا بمناقشة بعض الحالات الأقل شهرة لاستخدام قواعد البيانات المتجهة أيضًا. اكتشاف دواء جديد هو أحد حالات الاستخدام المتخصصة المفضلة لدي لقواعد البيانات المتجهة. التحدي في هذا التطبيق هو البحث عن مرشحين محتملين للدواء لمعالجة مرض أو أعراض معينة في قاعدة بيانات تحتوي على 800 مليون مركب. تمكنت شركة الأدوية التي تواصلت معها من تحسين عملية اكتشاف الدواء بشكل كبير، بالإضافة إلى تقليل موارد الأجهزة المطلوبة، من خلال الجمع بين Milvus ومكتبة للمعلوماتية الكيميائية تسمى RDKit.
أداة AI ArtLens لمتحف كليفلاند للفنون (CMA) هي مثال آخر أحب أن أذكره. AI ArtLens هي أداة تفاعلية تأخذ صورة استعلام كمدخلات وتستخرج صورًا متشابهة بصريًا من قاعدة بيانات المتحف. هذا ما يسمى عادة بالبحث العكسي عن الصور، وهو حالة استخدام شائعة لقواعد البيانات المتجهة، لكن القيمة الفريدة التي قدمتها Milvus إلى CMA كانت القدرة على تشغيل التطبيق في غضون أسبوع مع فريق صغير جدًا.
هل يمكنك التحدث عن منصة Towhee مفتوحة المصدر؟
عند التواصل مع الأشخاص من مجتمع Milvus، وجدنا أن الكثير منهم يرغبون في وجود طريقة موحدة لإنشاء تضمينات لميلفوس. كان هذا صحيحًا تقريبًا لجميع المنظمات التي تحدثنا معها، خاصة الشركات التي لم تكن لديها العديد من مهندسي التعلم الآلي. مع Towhee، نهدف إلى سد هذه الفجوة من خلال ما نسميه “ETL بيانات المتجه”. في حين تركز مسارات ETL التقليدية على دمج وتحويل البيانات المهيكلة من مصادر متعددة إلى تنسيق قابل للاستخدام، Towhee مصممة للعمل مع البيانات غير المهيكلة وتشمل بشكل صريح ML في مسارات ETL الناتجة. Towhee يحقق ذلك من خلال تقديم مئات من النماذج والخوارزميات والتحويلات التي يمكن استخدامها كوحدات بناء في مسارات ETL للبيانات المتجهة. بالإضافة إلى ذلك، Towhee يوفر واجهة برمجة تطبيقات Python سهلة الاستخدام التي تمكن المطورين من بناء واختبار مسارات ETL هذه في سطر واحد من التعليمات البرمجية.
على الرغم من أن Towhee هو مشروع مستقل، إلا أنه أيضًا جزء من النظام البيئي الأوسع لقواعد البيانات المتجهة الذي تقوم Zilliz بإنشائه حول Milvus. نتخيل Milvus و Towhee كمشروعين متكاملين للغاية، والذي، عند استخدامهما معًا، يمكن أن يتيح معالجة البيانات غير المهيكلة للجميع بالفعل.
أعلنت Zilliz مؤخرًا عن جمع جولة تمويل من الفئة B بقيمة 60 مليون دولار. كيف سيسرّع ذلك تحقيق مهمة Zilliz؟
أود أن أشكر Prosperity7 Ventures و Pavilion Capital و Hillhouse Capital و 5Y Capital و Yunqi Capital و آخرون للاعتقاد في مهمة Zilliz ودعمنا في هذه الجولة الإضافية من تمويل الفئة B. لقد جمعنا الآن ما مجموعه 113 مليون دولار، وستدعم هذه الجولة الأخيرة من التمويل جهودنا لتوسيع فرق الهندسة وطرح المنتجات في السوق. على وجه الخصوص، سنعمل على تحسين خدمتنا السحابية المُدارة، الذي هو حاليًا في مرحلة الوصول المبكر ولكن من المقرر إطلاقه للجميع في وقت لاحق من هذا العام. سنواصل الاستثمار في البحث المتقدم حول قواعد البيانات والذكاء الاصطناعي كما فعلنا في السنوات الأربع الماضية.
هل هناك أي شيء آخر تود أن تشاركه حول Zilliz؟
كشركة، ننمو بسرعة، لكن ما يميز فريقنا الحالي عن الآخرين في مجال قواعد البيانات والذكاء الاصطناعي هو شغفنا الفريد لما نبني. تتمثل مهمتنا في إتاحة معالجة البيانات غير المهيكلة للجميع، ومن المذهل رؤية العديد من المواهب في Zilliz يعملون نحو هدف واحد. إذا كان أي شيء من ما نقوم به يبدو مثيرًا للاهتمام، فلا تتردد في التواصل معنا. يسعدنا انضمامك إلى فريقنا.
إذا كنت ترغب في معرفة المزيد، أنا أيضًا شخصيًا متاح للنقاش حول Zilliz، قواعد البيانات المتجهة، أو التطورات المتعلقة بالتضمين في AI / ML. بابي (الرمزي) دائمًا مفتوح، لذا لا تتردد في التواصل معي مباشرة على تويتر / LinkedIn.
أخيرًا وليس آخرًا، شكرًا لقراءتك!
شكرًا على المقابلة الرائعة، القراء الذين يرغبون في معرفة المزيد يجب أن يزوروا Zilliz.



