
مقابلات
د. ماثيلد بافيس، رئيس القانون في OpenOrigins – سلسلة المقابلات

 أضف Unite.AI إلى مصادرك المفضلة على Google
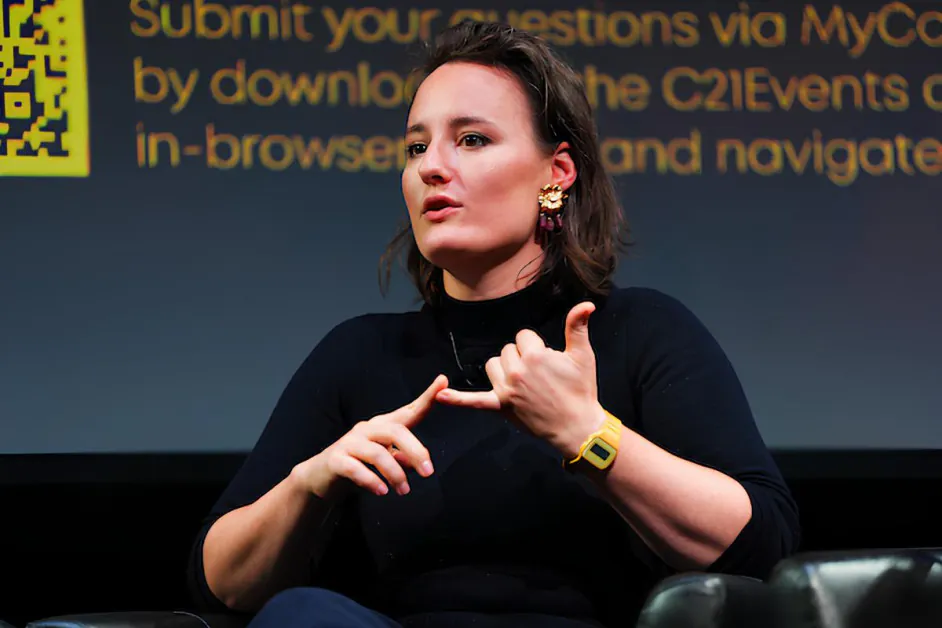
د. ماثيلد بافيس، رئيس القانون في OpenOrigins، هي خبيرة رائدة في تنظيم الذكاء الاصطناعي وحوكمة الإعلام الرقمي، وتتخصص في التعامل مع المحاكاة العميقة والوسائط الإعلامية الاصطناعية ومصدر المحتوى. وتقدم استشارات للشركات والحكومات والاتحادات التجارية بشأن الامتثال والترخيص والمخاطر في الذكاء الاصطناعي، وقد عملت مع مايكروسوفت وElevenLabs على سياسة و استراتيجية الذكاء الاصطناعي. كما أنها قدمت استشارات لليونسكو بشأن الذكاء الاصطناعي والملكية الفكرية، وتقدم بشكل منتظم أدلة خبيرة للمشرعين في المملكة المتحدة.
(MSFT )OpenOrigins تطور تكنولوجيا لمكافحة المعلومات الخاطئة والمحاكاة العميقة من خلال إنشاء سجلات قابلة للتحقق ومقاومة للتلاعب من المحتوى الرقمي. تركز منصتها على إنشاء مصدر واضح، مما يسمح للإعلام والمبدعين والمنصات بثبات متى وكيف تم إنشاء المحتوى وتعديله وتوزيعه – وهي قدرة حرجة بشكل متزايد مع تقدم وسائط الإعلام الاصطناعية وأصبحت أكثر صعوبة في الكشف عنها.
لقد قمت بتقديم استشارات للحكومات والمؤسسات العالمية مثل اليونسكو والشركات مثل مايكروسوفت وElevenLabs بشأن تنظيم الذكاء الاصطناعي. ما الذي دفعك إلى التركيز بشكل خاص على المحاكاة العميقة والنسخ الرقمي والوسائط الإعلامية الاصطناعية، وكيف شكلت هذه الرحلة قرارك بتأسيس Replique؟
لم يبدأ عملي على المحاكاة العميقة مع التكنولوجيا – بل بدأ مع لغز قانوني قديم. عندما بدأت أبحاثي في الملكية الفكرية لدراستي للدكتوراه في عام 2013، كنت مدفوعة بكيفية حماية المبدعين مقارنة بالمؤلفين والملحنين وصناع الأفلام. في الممارسة العملية، يعني ذلك أن كلماتك أو موسيقاك تنتهي بتحقيق حماية أفضل في القانون من صوتك ووجهك وجسدك. هذا الخلل يبدو غريباً، ويدفعني إلى طرح سؤال أعمق: كيف نقدر ثقافياً وقانونياً عمل شخص تكون مساهمته وجهه وصوته وجسده على الشاشة؟
ذلك السؤال أداني إلى حقوق المبدعين والبيانات. في ذلك الوقت، كان يعتبر مجالًا ضيقًا ذا أهمية تجارية قليله. كنت قد نصحني بنشاط بالانتقال إلى مجالات أكثر ربحية مثل البراءات أو حقوق التأليف والنشر التقليدية. كان الافتراض هو أن القضايا المتعلقة بالشبه أو الصوت تُدار في الغالب بشكل غير رسمي – من خلال معايير الصناعة أو “اتفاقيات شرف في هوليوود”. لكن بالنسبة لي، هذا النقص في الحماية الرسمية يشير إلى فجوة، وليس نهاية لبحثي، لذا واصلت.
ما تغير هو أن الجميع تقريباً يعتبرون مبدعين اليوم. حياتنا تُتوسط من خلال الكاميرات – على الهواتف والكمبيوترات المحمولة والمكالمات المرئية والمنصات الاجتماعية. سواء كان ذلك من أجل العمل أو الاستخدام الشخصي، الناس يُسجلون ويُشاركون باستمرار إصدارات من أنفسهم. الأسئلة القانونية التي كانت تطبق في الماضي بشكل رئيسي على الممثلين أو الموسيقيين تُطبق الآن على أي شخص يمتلك هاتفًا ذكيًا.
المحاكاة العميقة لم تخلق هذه القضايا – بل كشفتها وأسرعتها. الأبحاث التي كنت أجرها منذ عام 2013 فصاعدًا أصبحت فجأة ملحة. حوالي عام 2017 و2018، بدأت التطورات في الشبكات العصبية – وخاصة تلك التي خرجت من أماكن مثل معهد ماساتشوستس للتكنولوجيا وجامعة كاليفورنيا، بيركلي – تُظهر كيف يمكن التلاعب بوجه شخص و صوته وجسده بشكل مقنع. في غضون عام، أصبحت هذه القدرة معروفة على نطاق واسع باسم “المحاكاة العميقة”، وبدأت في اكتساب زخمًا أولاً من خلال طرق ضارة بشكل خاص، وخاصة من خلال المحتوى الجنسي غير المُتَطَبّع الذي يستهدف النساء والأطفال.
في وقت لاحق فقط ظهرت الآثار التجارية، عندما بدأت الصناعات الإبداعية في تبني الوسائط الإعلامية الاصطناعية. ذلك هو عندما أصبحت الأسئلة التعاقدية والاقتصادية التي كنت أعمل عليها في طليعة الأمور. تقريباً في ليلة وضحاها، ما كان يُعتبر مجالًا قانونيًا نظريًا أو عقائديًا أصبح مجالًا عمليًا للغاية ومهمًا تجاريًا واجتماعيًا.
في جوهره، لم تتغير التحديات القانونية: الناس يريدون مشاركة جوانب من أنفسهم، لكنهم يريدون أيضًا الحفاظ على سيطرة معنوية. الإطارات الحالية تعاني من صعوبة في التعامل مع هذه النُّعَما. تميل إلى معاملة الأفراد على أنهم إما خاصين تمامًا أو عامين تمامًا – إما محميين أو مفتوحين للجميع. لكن معظم الناس يوجدون في مكان ما بين ذلك. هذا التوتر يصبح الآن مركزيًا لا فقط للممثلين المحترفين، بل لأي شخص يشارك في الحياة الرقمية.
أصبحت معروفة كشخصية تُبحث وتعمل في هذا المجال، مما أدى بي إلى العمل مع الحكومات المهتمة بحماية الناس من المحاكاة العميقة، والشركات التي تريد جعل منتجات التكرار الرقمي آمنة للاستخدام، مثل ElevenLabs. في Replique، أُجلب كل ما تعلمته إلى الأشخاص والشركات التي تريد استخدام تقنية التكرار الرقمي أو تقنية النسخ الرقمي بشكل مسؤول وآمن. لقد حولت بشكل أساسي بحثي “السماوي” إلى عمل استشاري يُقدم نصائح قانونية متخصصة إلى الصناعات الإبداعية.
كما رئيس قانون في OpenOrigins، شركة تركز على إنشاء سجل لا يمكن تغييره لمصدر المحتوى لمكافحة المحاكاة العميقة، كيف ترى أنظمة مصدر القائمة تنافس أو تحل محل نهج الكشف عن المحاكاة العميقة التقليدية؟
مقارنة أدوات الكشف عن المحاكاة العميقة يمكن أن تصبح بسرعة مثل مقارنة التفاح بالبرتقال، لأن فعاليتها تعتمد على السياق والغرض. من منظور سياسي، ما نحتاجه هو مجموعة من الأدوات التكميلية – لا يوجد حل واحد أفضل، وOpen Origins هو جزء من هذا النظام البيئي الأوسع. حيث تبرز تقنية OpenOrigins كحل للكشف عن المحاكاة العميقة في الحالات التي يحتاج فيها مُنشئ المحتوى أو منظمة المعلومات إلى إثبات صحة المحتوى الذي يُشاركه مع الشركاء أو الجمهور.
من خلال تقديم مصدر موثوق و “إيصالات” في نقطة الإنشاء، توفر شكلًا قويًا من الوقاية من خلال إثبات أن المحتوى ليس محاكاة عميقة. ومع ذلك، هذا النهج أقل فائدة للمستخدمين العاديين على الإنترنت الذين يريدون تقييم المحتوى بسرعة. في تلك الحالات، يعتمد الكشف أكثر على أساليب التحليل المحتمل والتحليل المحتوى بدلاً من التحقق من مصدر القائمة. نحن بحاجة إلى أدوات مختلفة لاحتياجات مختلفة، ونحن بحاجة إلى قبول أن هناك لا يوجد حل فضي ضد المحاكاة العميقة.
من منظور قانوني، ما هو أكبر فجوة حاليًا في كيفية تعامل السلطات القضائية مع الموافقة والملكية في المحتوى المُنشأ أو المُكرر بواسطة الذكاء الاصطناعي؟
أوه، كم من الوقت لديك؟ الإجابات تعتمد على ما نعني بالمحتوى المُنشأ بواسطة الذكاء الاصطناعي أو المُكرر. القضايا تختلف إذا كنت تنظر إلى صورة مُنشأة بواسطة الذكاء الاصطناعي لمنزل أو قطة. أو إعادة إنشاء رقمية لوجه شخص أو صوته. دعونا نركز على موضوع المحاكاة العميقة والنسخ الرقمي، وأجيب على سؤالك في سياق “التكرار الرقمي”.
فيما يتعلق بالموافقة، القضية الأساسية هي أن معظم العقود – سواء كانت اتفاقيات توظيف أو شروط المنصة – تحتوي على شروط واسعة وغامضة تمنح حقوقًا واسعة على محتوى المستخدم. يمكن تفسير هذه الشروط على أنها شكل من أشكال “الموافقة الخلفية” حيث قد يُفهم الاتفاق على الشروط على أنه موافقة على استخدامات مثل التكرار، على الرغم من أن معظم الناس سيختلفون بشدة مع هذا التفسير. هذا يخلق فجوة كبيرة بين التفسير القانوني وتوقعات المستخدم، واحدة تُفيد الشركات حاليًا بينما تقع التنظيم في الخلف.
فيما يتعلق بالملكية، لا يوجد إجابة قانونية واضحة لمن يملك نسخة رقمية، لأن الإطارات الحالية مثل حماية البيانات و حقوق التأليف والنشر و حقوق الشخصية لم تُصمم لهذه التكنولوجيا. اليوم، يُمسح معظم الناس ويُكرر رقميًا في العمل، بناءً على طلب وتمويل من صاحب العمل أو العميل. وتتوقع هذه الكيانات عادةً درجة عالية من السيطرة على هذا الأصل، وهو أمر مفهوم ولكن غالبًا ما يكون مشكلاً لأن هذا الأصل هو نسخة رقمية لوجهك أو صوتك، ويمكن أن يجعلك تقول أشياء لم تقُلها قط أو تفعل أشياء لم تفعلها قط.
سؤال “من يملك نسختك؟” مهم للغاية، ومع ذلك لا يوجد إجابة قانونية له اليوم.
لقد عملت بشكل وثيق على تقنيات تكرار الصوت. ما هي أكبر مخاطر قانونية مُسيئة عندما يتعلق الأمر بالصوت الاصطناعي، لكل من الشركات والأفراد؟
المسألة الأكثر سوء فهمًا في الامتثال القانوني هي التوازن بين المصلحة التجارية للشركة في تمويل واستغلال النسخة الرقمية، وحق الفرد في الخصوصية والكرامة الرقمية. هذا التوتر يقع عبر أنظمة قانونية متعددة (بشكل رئيسي حقوق التأليف والنشر وحماية البيانات والخصوصية) التي لم تُصمم للعمل معًا وتفسر النسخ في طرق مختلفة بشكل جوهري. ونتيجة لذلك، ترجمة ذلك إلى ممارسات تجارية قابلة للعمل معقدة وغالبًا ما تكون غير واضحة. الشركات إما تتجاهل المخاطر الرئيسية أو تتكبد تكاليف كبيرة للتحرك بشكل صحيح. هذا يخلق نتيجة معكوسة حيث يصبح الامتثال المسؤول أقل سهولة وأكثر تكلفة، بدلاً من أن يكون المسار الافتراضي.
كيف يجب على الشركات التفكير في هيكل الموافقة في أنظمة الذكاء الاصطناعي، خاصة عند التعامل مع الشبه والهوية وبيانات التدريب؟
الشركات يجب أن تصمم أنظمتها حول ثلاثة قدرات أساسية. أولاً، يجب أن يأمّنوا موافقة مستنيرة وسياقية عند التسجيل. ثانيًا، يجب أن يُسهلوا على المستخدمين سحب هذه الموافقة وحذف بعض أو كل بياناتهم، وهو شيء صعب تقنيًا وغالبًا ما يُغفل، لكنه ضروري للامتثال لقوانين مثل قانون حماية البيانات العام في المملكة المتحدة والاتحاد الأوروبي وقوانين مماثلة في الولايات المتحدة. الحفاظ على الموافقة مع مرور الوقت يعني بناء أنظمة حيث يكون سحب الموافقة سلسًا ومتوافقًا مع نموذج العمل.
الموافقة يجب أن تكون دقيقة. ثالثًا، يجب أن يكون المستخدمون قادرين على إدارة الأذونات على مستوى الملفات الفردية، وتحديث بيانات الشبه، وفهم كيف يتم استخدامها. ذلك يتطلب شفافية وسيطرة – أدوات تسمح للمستخدمين بمراقبة ومراجعة وتعديل كيفية نشر نسخهم الرقمية. هذا المستوى من المرونة نادر، لكنه حيث تقع الميزة التنافسية بشكل متزايد.
من خلال خبرتك في تقديم استشارات للشركات الناشئة والحكومات، أين يقع أكبر انقطاع بين كيفية بناء الذكاء الاصطناعي وكيفية تنظيمه؟
الانقطاع بين كيفية بناء الذكاء الاصطناعي وكيفية تنظيمه يعود إلى مهام أساسية مختلفة. الحكومات تنظم في المصلحة العامة، بينما الشركات التي تعمل بالذكاء الاصطناعي (غالبًا مدعومة بالاستثمار الجريء) مدفوعة في الغالب بالنمو والإيرادات والربح. تلك الأولويات لا تتعارض دائمًا، لكنها تسحب غالبًا في اتجاهات مختلفة، مع اعتبار التنظيم كعقبة بدلاً من دعم.
هذا يخلق توترًا هيكليًا: المنظمون والمبتكرون يعملون مع حوافز وقيم ولغات مختلفة. هذا يجعل التناغم صعبًا في الممارسة، حتى لو لم يكن مستحيلًا. نحن نبدأ في رؤية موجة جديدة من الشركات التكنولوجية التي تتماشى بشكل أوثق مع أهداف المصلحة العامة، لكنها تبقى الاستثناء وليس القاعدة – خاصة بين تلك التي تنجح في التوسع.
تركز OpenOrigins على التحقق من المحتوى عند نقطة الإنشاء باستخدام مصدر تشفيري موثّق. كيفية أهمية هذا النهج مقارنة بالحماية بعد التوزيع؟
هذا يعود إلى إجابتي السابقة. التحقق من المحتوى عند الإنشاء “في أعلى المنبع” أكثر فعالية من محاولة التحقق منه عند نقطة التوزيع أو الاستهلاك، أي “في أسفل المنبع”. التحقق من المحتوى عند الإنشاء يشبه تتبع الطعام من لحظة زراعته في المزرعة، بدلاً من محاولة معرفة ذلك من الطبق الذي أمامك. إذا كنت تعرف أين تم تربية الدجاج، وكيف تم التعامل معه، وكيف انتقل عبر سلسلة التوريد، يمكنك الثقة في ما تأكله. إذا كنت بدلاً من ذلك تحاول استنتاج كل ذلك من الطبق النهائي، فستعتمد على التخمين. الأمر نفسه مع التمييز بين المحتوى المُنشأ بواسطة الإنسان والمحتوى المُنشأ بواسطة الذكاء الاصطناعي على الإنترنت: مصدر القائمة في المصدر يوفر لك ضمانًا موثوقًا، بينما الكشف في أسفل المنبع هو أكثر انعدامًا للثقة وتفاعليًا.
ما الدور الذي ترى أن معايير مثل C2PA ستلعبه في مستقبل الإعلام، وهل هي كافية بحد ذاتها لاستعادة الثقة على الإنترنت؟
C2PA هي مبادرة مرحب بها، وتدعم في الكثير من الجوانب نفس الحركة من أجل مصدر المحتوى الموثوق مثل OpenOrigins. وهي جزء مهم من نظام بيئي لسلامة المحتوى وصدق المحتوى. كما مع كل أداة أمن السيبرانية، لا يوجد رصاصة فضية.
لمبدعين والموهوبين في صناعات مثل السينما والموسيقى والألعاب، ما هي الخطوات العملية التي يجب أن يتبعوها اليوم لحماية أنفسهم من النسخ الرقمي غير المصرح به؟
يواجه الفنانون اليوم مخاطر متميزة: تكرار عملهم (مثل الموسيقى أو الصور أو الكتابة) وتكرار شبههم، بما في ذلك وجههم و صوتهم وجسدهم. مع مدخلات قليلة، يمكن للنظم التي تعمل بالذكاء الاصطناعي إعادة إنتاج كليهما بدقة عالية. من الناحية العملية، الحماية تبدأ من كونك متعمدًا فيما تشاركه على الإنترنت، معترفًا بأن أي محتوى منشور قد يتم حصدُه و استخدامه في مجموعات بيانات التدريب، غالبًا بدون موافقة واضحة أو رؤية.
ذلك الخطر هو الآن حقيقة أساسية للعمل على الإنترنت. لكن الخطر الأكثر إيلامًا غالبًا ما يكمن في العقود. الاتفاقيات التي يبرمها الفنانون مع شركائهم أو موزعيهم أو منصاتهم قد تحتوي على شروط تسمح باستخدام الذكاء الاصطناعي أو إعادة استخدامه أو بيعه لأغراض التدريب – غالبًا بدون مشاركة معنوية في الإيرادات اللاحقة.
للفنانين، هذا يجعل فحص العقود حاسمًا. فهم كيف يمكن استخدام عملك و شبهك، والترخيص أو إعادة استخدامه، هو الآن أمرًا مهمًا مثل العملية الإبداعية نفسها. الكثير من المناقشة الحالية (عبر النقابات والهيئات الصناعية والمنصات) تركز على تصحيح هذا الخلل وضمان حصول المبدعين على السيطرة والتعويض العادل.
إذاً هناك نصيحتان مهمتان: كن حذرًا فيما تشاركه على الإنترنت، واقرأ عقودك وابحث عن شروط الذكاء الاصطناعي قبل التوقيع.
في النظر إلى الأعوام الثلاثة إلى خمس سنوات القادمة، هل تعتقد أننا سنجعل كل قطعة من المحتوى الرقمي تحتاج إلى مصدر موثوق، أو ستبقى الثقة منقسمة عبر المنصات والولايات القضائية؟
أود أن أقول نعم، ولكن واقعيًا، لا – ليس في غضون خمس سنوات. في التكنولوجيا، خمس سنوات تشعر بالطول؛ فيما يتعلق بتغيير سلوك المستخدم و عاداته، فهي قصيرة جدًا. معظم المستهلكين غير محتمل أن يأخذوا قراراتهم بناءً على ما إذا كان المحتوى يأتي مع مصدر موثوق. المنصات تميل إلى اتباع الطلب، وتحسينه من أجل المشاركة بدلاً من مصدر القائمة.
ذلك قد يتغير إذا تدخلت التنظيمات. نحن نرى بالفعل تحركات أولية في أماكن مثل كاليفورنيا، حيث تظهر متطلبات التسمية والتحديث، لكن التوسع على مستوى العالم سيتطلب وقتًا – ربما أقرب إلى عقد من خمس سنوات.
منطقة أخرى من التغيير هي القطاعية: صناعات مثل الصحافة والمالية والتأمين والرعاية الصحية قد تبدأ في طلب مصدر القائمة والتحقق لأن الثقة هي أساسية لعملياتها.
أخيرًا، قد لا يهتم المستهلكون بمعلومات مصدر القائمة في المدى القصير، لكنهم سيهتمون بجودة المحتوى ومعلوماته. إذا أصبحت المحتوى المُنشأ بواسطة الذكاء الاصطناعي متماثلة أو “مملة” جدًا، قد يبدأ الجمهور في تقدير المحتوى المُنشأ بواسطة الإنسان بشكل صريح. ذلك قد يؤدي إلى تجزئة السوق، مع بعض المنصات التي تُفضل النطاق والمحتوى المُنشأ بواسطة الذكاء الاصطناعي، والآخر يُcurate لصالح الصدق ومصدر القائمة والمواد الموثوقة بقيادة الإنسان – لكن ذلك التغيير يبقى مجهولًا.
شكرًا على إجاباتك الرائعة، القراء الذين يرغبون في معرفة المزيد يجب أن يزوروا OpenOrigins.


