نماذج ومنصات الذكاء الاصطناعي
AudioSep: افصل أي شيء تصفه

 أضف Unite.AI إلى مصادرك المفضلة على Google
يمثل فصل المصادر الصوتية باستعلامات لغوية (LASS) نهجًا جديدًا في التحليل الحاسوبي للمشهد السمعي (CASA)، يهدف إلى فصل صوت مستهدف من مزيج صوتي باستخدام استعلام باللغة الطبيعية. ويوفر ذلك واجهة طبيعية وقابلة للتوسع لمهام الصوت الرقمي وتطبيقاته. ورغم التقدم الكبير الذي حققته أطر LASS خلال السنوات الماضية في التعامل مع مصادر محددة، مثل الآلات الموسيقية، فإنها لا تستطيع فصل الصوت المستهدف في المجالات المفتوحة.
AudioSep نموذج تأسيسي يهدف إلى تجاوز هذه القيود، من خلال فصل الصوت المستهدف باستعلامات باللغة الطبيعية. وقد درّبه مطوروه تدريبًا مكثفًا على مجموعة متنوعة من مجموعات البيانات متعددة الوسائط واسعة النطاق، وقيّموا أداءه في مهام تشمل فصل الآلات الموسيقية والأحداث الصوتية وتحسين الكلام وغيرها. وأظهر أداؤه الأولي قدرات لافتة على التعلم دون أمثلة وأداءً قويًا في فصل الصوت وفق الاختبارات المعيارية.
نتناول في هذه المقالة آلية عمل AudioSep، وبنية النموذج، ومجموعات بيانات التدريب والتقييم، والمفاهيم الأساسية التي يقوم عليها. ولنبدأ بالتعريف بإطار CASA.
أطر CASA وUSS وQSS وLASS: الأساس الذي يقوم عليه AudioSep
يستخدم المطورون إطار التحليل الحاسوبي للمشهد السمعي (CASA) لتصميم أنظمة استماع آلية تستطيع إدراك البيئات الصوتية المعقدة بطريقة تشبه إدراك البشر للأصوات باستخدام جهازهم السمعي. ويُعد فصل الصوت، ولا سيما الصوت المستهدف، مجالًا بحثيًا أساسيًا فيه، يسعى إلى حل «مشكلة حفلة الكوكتيل»، أي عزل المصادر الصوتية الفردية من التسجيلات الواقعية المختلطة. وتنبع أهمية ذلك من تطبيقاته الواسعة، مثل فصل المصادر الموسيقية والصوتية، وتحسين الكلام، والتعرف على الصوت المستهدف.
ركز معظم العمل السابق على فصل مصدر صوتي واحد أو أكثر، مثل الموسيقى أو الكلام. أما نهج الفصل الشامل للأصوات (USS) فيهدف إلى فصل أي أصوات في تسجيلات واقعية. لكن فصل كل مصدر من مزيج صوتي مهمة صعبة ومقيدة بسبب التنوع الهائل لمصادر الصوت في العالم، مما يجعل USS غير عملي لتطبيقات العالم الحقيقي التي تعمل في الوقت الفعلي.
يوفر فصل الصوت المعتمد على الاستعلام (QSS) بديلًا عمليًا، إذ يفصل مصدرًا فرديًا أو مستهدفًا من المزيج بناءً على استعلامات محددة. وبذلك يستطيع المطورون والمستخدمون استخراج الأصوات التي يحتاجون إليها، وهو ما يجعله أنسب لتطبيقات مثل تحرير محتوى الوسائط المتعددة أو الصوت.
واقترح المطورون مؤخرًا امتدادًا لهذا النهج هو LASS، الذي يستخدم أوصافًا باللغة الطبيعية للمصدر المستهدف لفصل مصادر صوتية غير محددة مسبقًا. وقد يصبح أداة قوية لتطبيقات الصوت الرقمي بفضل إمكانية استخراج المصادر بتعليمات لغوية. ومقارنة بالاستعلامات الصوتية أو البصرية التقليدية، توفر اللغة الطبيعية مرونة أكبر وتيسر الحصول على معلومات الاستعلام. كما أن LASS، بخلاف الأطر القائمة على تسميات محددة سلفًا، لا يقيد عدد الاستعلامات المدخلة، ويمكن تعميمه بسلاسة على المجالات المفتوحة.
يعتمد LASS في الأصل على التعلم الخاضع للإشراف باستخدام أزواج موسومة من الصوت والنص. لكن محدودية هذه البيانات تمثل مشكلة رئيسية. ولتقليل الاعتماد على بيانات الصوت والنص الموسومة، تُدرّب النماذج بإشراف متعدد الوسائط. ويعتمد هذا النهج على نماذج مدرّبة مسبقًا بالتعلم التقابلي متعدد الوسائط، مثل CLIP، لتشفير الاستعلامات. يستطيع CLIP مواءمة تضمينات النص مع وسائط أخرى كالصوت أو الصورة، مما يتيح تدريب LASS باستخدام وسائط غنية بالبيانات ثم الاستدلال باستعلامات نصية دون أمثلة. ومع ذلك، تُدرّب الأطر الحالية على مجموعات صغيرة، ولم تُستكشف تطبيقاتها بعد في مئات المجالات المحتملة.
لمعالجة هذه القيود، قدم المطورون AudioSep، وهو نموذج تأسيسي يفصل الصوت من المزيج باستخدام أوصاف باللغة الطبيعية. ويركز على بناء نموذج مدرّب مسبقًا يستفيد من مجموعات البيانات متعددة الوسائط واسعة النطاق لتعميم LASS على المجالات المفتوحة. ويمكن وصفه بأنه «نموذج تأسيسي للفصل الشامل للأصوات في المجالات المفتوحة، باستخدام استعلامات أو أوصاف باللغة الطبيعية، ومدرّب على مجموعات بيانات صوتية ومتعددة الوسائط واسعة النطاق».
AudioSep: المكونات الأساسية والبنية
تتكون بنيته من مكونين رئيسيين: مشفّر نصي ونموذج لفصل الصوت.
المشفّر النصي
يستخدم AudioSep المشفّر النصي في CLIP، أي التدريب المسبق التقابلي للغة والصورة، أو CLAP، أي التدريب المسبق التقابلي للغة والصوت، لاستخراج تضمينات الاستعلام اللغوي. يتكون الاستعلام من تسلسل يضم N من الرموز، يعالجها المشفّر عبر مجموعة من كتل المحوّل. ثم تُجمّع تمثيلات الخرج بعد مرورها بطبقات المحوّل للحصول على متجه ثابت الطول ذي D من الأبعاد، حيث تمثل D أبعاد نموذج CLIP أو CLAP. وتظل معاملات المشفّر النصي مجمدة أثناء التدريب.
يُدرّب CLIP مسبقًا على مجموعة كبيرة من أزواج الصور والنصوص باستخدام التعلم التقابلي. ولذلك يتعلم مشفّره النصي إسقاط الأوصاف في فضاء دلالي مشترك مع التمثيلات البصرية. ويتيح ذلك لـAudioSep توسيع تدريب LASS باستخدام بيانات سمعية بصرية غير موسومة، مع التضمينات البصرية بديلًا، دون الحاجة إلى أزواج صوت ونص مشروحة أو موسومة.
ويعمل CLAP بطريقة مشابهة، مستخدمًا هدفًا تقابليًا ومشفّرين للصوت والنص لربط الصوت باللغة، وجمع أوصافهما في فضاء كامن مشترك.
نموذج الفصل
يعتمد AudioSep على نموذج ResUNet في المجال الترددي بوصفه العمود الفقري للفصل، ويستقبل مزيجًا من المقاطع الصوتية. ويطبق تحويل فورييه قصير الزمن (STFT) على الشكل الموجي لاستخراج المخطط الطيفي المركب ومخطط المقدار وطور X. ثم يبني شبكة تشفير وفك تشفير لمعالجة مخطط المقدار.
تضم شبكة ResUNet ست كتل متبقية وست كتل لفك التشفير وأربع كتل عنق زجاجة. وتستخدم كل كتلة تشفير أربع كتل التفاف متبقية لخفض أخذ عينات المخطط الطيفي وصولًا إلى سمات عنق الزجاجة، بينما تستخدم كتل فك التشفير أربع كتل التفاف عكسي متبقية لرفع أخذ عينات السمات والحصول على مكونات الفصل. وتربط وصلة تجاوز كل كتلة تشفير بكتلة فك التشفير المناظرة لها عند المعدل نفسه لرفع العينات أو خفضها. وتضم الكتلة المتبقية طبقتي تنشيط Leaky-ReLU، وطبقتي تطبيع للدفعات، وطبقتي شبكة عصبية التفافية، إضافة إلى مسار متبقٍ يصل مدخل كل كتلة بمخرجها. يأخذ ResUNet المخطط الطيفي المركب X مدخلًا، وينتج قناع المقدار M، مع متبقٍ للطور مشروط بتضمينات النص يتحكم في تغيير المقدار وتدوير زاوية المخطط الطيفي. ويُستخرج المخطط المركب المفصول بضرب قناع المقدار ومتَبقّي الطور المتوقعين في تحويل STFT للمزيج.

يستخدم AudioSep طبقة FiLm، أي التعديل الخطي على مستوى السمات، للربط بين نموذج الفصل والمشفّر النصي بعد الكتل الالتفافية في ResUNet.
التدريب ودالة الخسارة
أثناء التدريب، يستخدم المطورون زيادة البيانات بتغيير شدة الصوت، ويدرّبون الإطار من البداية إلى النهاية باستخدام دالة خسارة L1 بين الشكل الموجي الحقيقي والمتوقع.
مجموعات البيانات والاختبارات المعيارية
يهدف AudioSep إلى تقليل اعتماد LASS على أزواج الصوت والنص المشروحة. ولذلك يُدرّب على مجموعات متنوعة لاكتساب قدرات التعلم متعدد الوسائط. وفيما يلي مجموعات البيانات والاختبارات المستخدمة.
AudioSet
مجموعة صوتية واسعة النطاق ذات وسوم ضعيفة، تضم أكثر من مليوني مقطع مدة كل منها عشر ثوانٍ، مستخرجة مباشرة من يوتيوب. ويُصنّف كل مقطع بحسب وجود فئات الأصوات أو غيابها، دون تحديد التوقيت الدقيق للأحداث الصوتية. وتشمل أكثر من 500 فئة متميزة، منها الأصوات الطبيعية والبشرية وأصوات المركبات وغيرها.
VGGSound
مجموعة سمعية بصرية واسعة النطاق مستخرجة من يوتيوب، تضم أكثر من 200 ألف مقطع فيديو مدة كل منها عشر ثوانٍ. وتُصنف في أكثر من 300 فئة صوتية، مثل الأصوات البشرية والطبيعية وأصوات الطيور. وتضمن أن يكون الجسم المنتج للصوت المستهدف قابلًا للوصف أيضًا في المقطع البصري المقابل.
AudioCaps
أكبر مجموعة متاحة علنًا للأوصاف النصية للصوت، وتضم أكثر من 50 ألف مقطع مدة كل منها عشر ثوانٍ مستخرج من AudioSet. وتنقسم إلى مجموعات تدريب واختبار وتحقق. وقد أضاف أشخاص أوصافًا باللغة الطبيعية باستخدام Amazon Mechanical Turk. ولكل مقطع تدريبي وصف واحد، بينما يضم كل مقطع في الاختبار والتحقق خمسة أوصاف مرجعية.
ClothoV2
مجموعة للأوصاف الصوتية تضم مقاطع مأخوذة من FreeSound. ومثل AudioCaps، أضيفت إلى كل مقطع أوصاف بشرية باللغة الطبيعية باستخدام Amazon Mechanical Turk.
WavCaps
مجموعة صوتية واسعة النطاق ذات وسوم ضعيفة، تضم أكثر من 400 ألف مقطع مع أوصاف نصية، بإجمالي يقارب 7,568 ساعة من بيانات التدريب. وتأتي مقاطعها من مصادر تشمل BBC Sound Effects وAudioSet وFreeSound وSoundBible وغيرها.

تفاصيل التدريب
أثناء التدريب، يسحب AudioSep عشوائيًا مقطعين من تسجيلين مختلفين في مجموعة التدريب، ويخلطهما لتكوين مزيج تدريبي، وتبلغ مدة كل مقطع نحو خمس ثوانٍ. ثم يستخرج المخطط الطيفي المركب من الإشارة الموجية باستخدام نافذة Hann بحجم 1024 وخطوة انتقال قدرها 320.
ويستخرج التضمينات النصية باستخدام مشفّر CLIP أو CLAP، مع الإشراف النصي بوصفه الإعداد الافتراضي. ويستخدم للفصل شبكة ResUNet ذات 30 طبقة، وست كتل تشفير وست كتل فك تشفير، ببنية شبيهة بإطار الفصل الشامل للأصوات. وتضم كل كتلة تشفير طبقتين التفافيتين بنواة 3×3، ويبلغ عدد خرائط السمات الخارجة من الكتل 32 و64 و128 و256 و512 و1024 على التوالي. وتتطابق كتل فك التشفير تماثليًا مع كتل التشفير. ويُستخدم محسّن Adam للتدريب بحجم دفعة 96.
نتائج التقييم
مجموعات البيانات التي سبق أن رآها النموذج
يقارن الشكل التالي أداء AudioSep على مجموعات رآها أثناء التدريب، بما فيها مجموعات التدريب نفسها، مع أنظمة مرجعية تشمل نماذج تحسين الكلام وLASS وCLIP. ويُشار إلى النسخة التي تستخدم المشفّر النصي لـCLIP باسم AudioSep-CLIP، وإلى النسخة التي تستخدم مشفّر CLAP باسم AudioSep-CLAP.

يوضح الشكل أن AudioSep يؤدي جيدًا عند استخدام الأوصاف الصوتية أو التسميات النصية استعلاماتٍ مدخلة. وتشير النتائج إلى تفوقه على النماذج المرجعية السابقة لـLASS وفصل الصوت باستخدام استعلامات صوتية.
مجموعات بيانات لم يرها النموذج
لتقييم التعلم دون أمثلة، اختبر المطورون النموذج على مجموعات بيانات لم يرها سابقًا. وأظهر AudioSep أداءً لافتًا في الفصل ضمن هذا الإعداد، كما يوضح الشكل التالي.

ويعرض الشكل التالي نتائج تقييم AudioSep في تحسين الكلام على Voicebank-Demand.

تشير النتائج إلى أداء قوي ومطلوب على البيانات غير المرئية سابقًا دون أمثلة، مما يمهد لتنفيذ مهام معالجة الصوت على توزيعات جديدة للبيانات.
تصوير نتائج الفصل
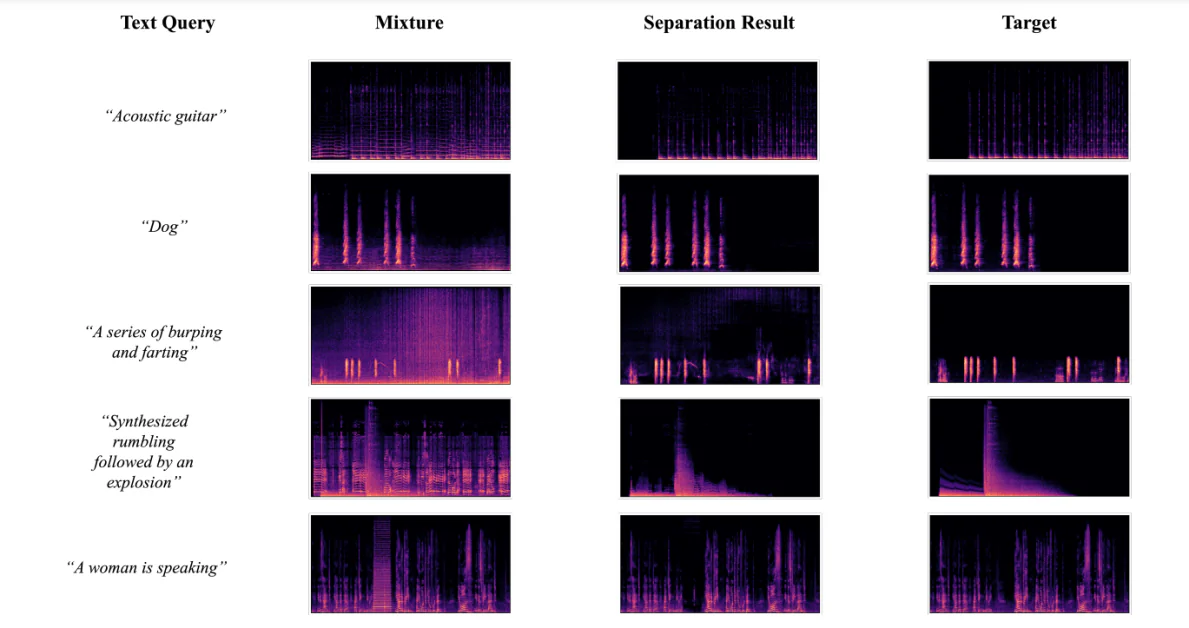
يعرض الشكل التالي التصوير البصري للمخططات الطيفية للمصادر الصوتية المستهدفة الحقيقية، والمزائج، والمصادر المفصولة باستخدام AudioSep-CLAP مع استعلامات نصية لأصوات متنوعة. ويقترب نمط المصدر المفصول من نمط المصدر المرجعي، مما يدعم النتائج الموضوعية للتجارب.
مقارنة الاستعلامات النصية
قيّم المطورون AudioSep-CLAP وAudioSep-CLIP على AudioCaps Mini، باستخدام تسميات أحداث AudioSet، وأوصاف AudioCaps، وأوصاف باللغة الطبيعية أعيدت صياغتها، لدراسة أثر اختلاف الاستعلامات. ويوضح الشكل التالي مثالًا من AudioCaps Mini.

الخلاصة
AudioSep نموذج تأسيسي صُمم ليكون إطارًا شاملًا لفصل الأصوات في المجالات المفتوحة، باستخدام أوصاف باللغة الطبيعية. وأظهر التقييم قدرته على التعلم دون أمثلة والتعلم غير الخاضع للإشراف باستخدام الأوصاف الصوتية أو التسميات النصية استعلاماتٍ. وتبين النتائج أداءً قويًا يتفوق على أطر فصل الصوت الحالية مثل LASS، وقد يساعد على تجاوز القيود القائمة في الأطر الشائعة.