
Góc nhìn Anderson
ST-NeRF: Tổng hợp và chỉnh sửa cho tổng hợp video

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google

Một tập đoàn nghiên cứu của Trung Quốc đã phát triển các kỹ thuật để đưa khả năng chỉnh sửa và tổng hợp vào một trong những lĩnh vực nghiên cứu tổng hợp hình ảnh nóng nhất trong năm qua – Trường bức xạ thần kinh (NeRF). Hệ thống này được gọi là ST-NeRF (Trường bức xạ thần kinh không gian-thời gian nhất quán).
Điều gì có vẻ như là một cuộc di chuyển máy ảnh vật lý trong hình ảnh dưới đây thực sự chỉ là người dùng ‘cuộn’ qua các điểm nhìn trên nội dung video tồn tại trong không gian 4D. Điểm nhìn không bị khóa vào hiệu suất của những người được mô tả trong video, những người có thể được xem từ bất kỳ phần nào của bán kính 180 độ.
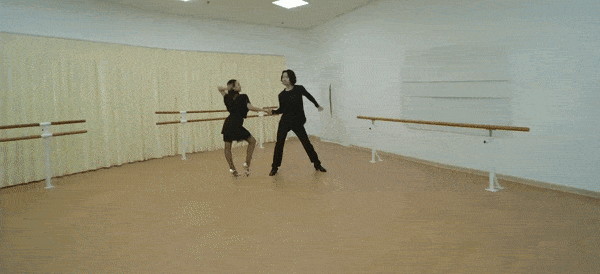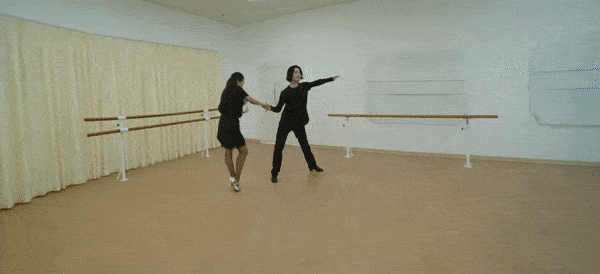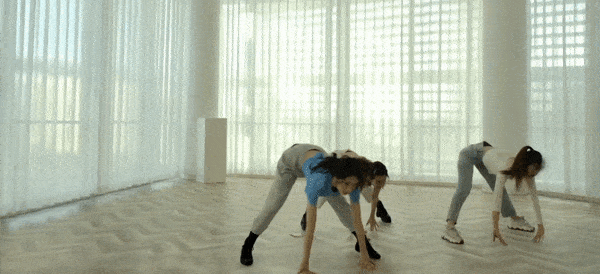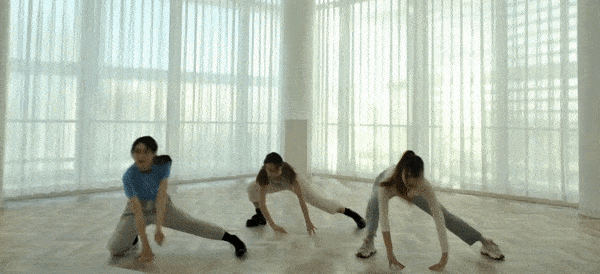
Mỗi mặt trong video là một yếu tố được chụp rời rạc, được tổng hợp thành một cảnh nhất quán có thể được khám phá động.
Các mặt có thể được sao chép tự do trong cảnh hoặc thay đổi kích thước:
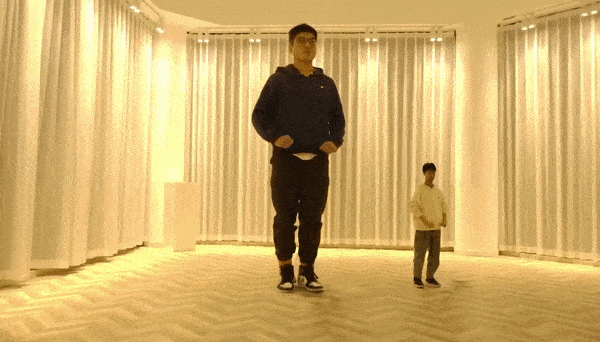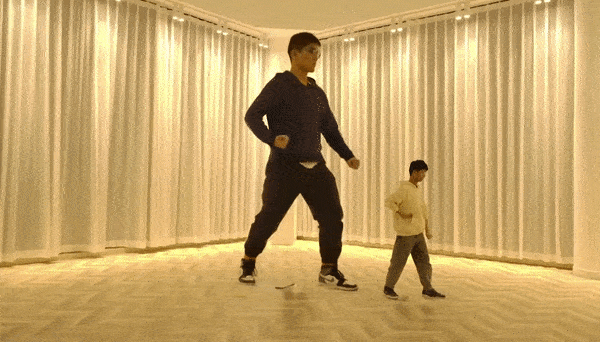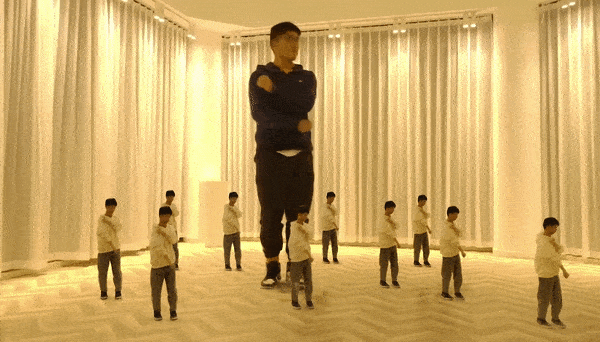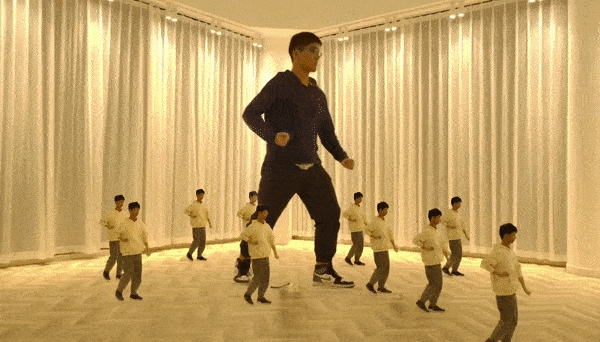
Ngoài ra, hành vi thời gian của mỗi mặt có thể được thay đổi dễ dàng, chậm lại, chạy ngược lại hoặc được thao tác theo nhiều cách, mở ra con đường đến kiến trúc bộ lọc và mức độ giải thích rất cao.
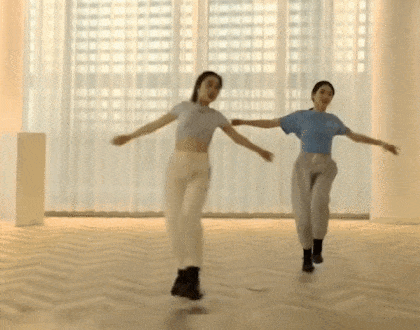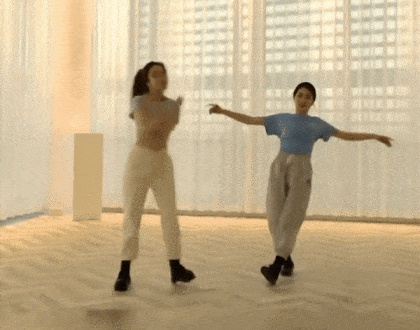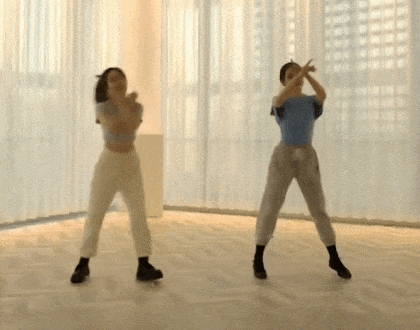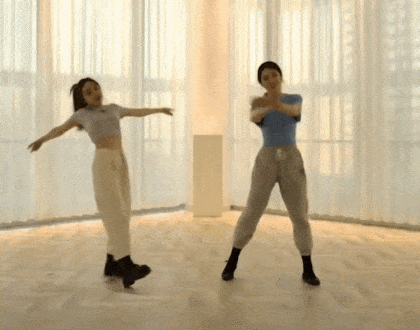
Hai mặt NeRF riêng biệt chạy ở tốc độ khác nhau trong cùng một cảnh. Nguồn: https://www.youtube.com/watch?v=Wp4HfOwFGP4

Không cần phải tạo mặt nạ cho người biểu diễn hoặc môi trường, hoặc có người biểu diễn thực hiện các chuyển động của họ một cách mù quáng và không có ngữ cảnh của cảnh được dự định. Thay vào đó, cảnh được chụp một cách tự nhiên thông qua một loạt 16 máy quay video bao phủ 180 độ:


Ba yếu tố được mô tả ở trên, hai người và môi trường, là riêng biệt và chỉ được đánh dấu để minh họa. Mỗi yếu tố có thể được thay thế và mỗi yếu tố có thể được chèn vào cảnh tại một điểm trước hoặc sau trong dòng thời gian của từng yếu tố.
ST-NeRF là một đổi mới trong nghiên cứu về Trường bức xạ thần kinh (NeRF), một khuôn khổ học máy mà nhiều điểm nhìn được tổng hợp thành một không gian ảo có thể điều hướng bằng cách đào tạo rộng rãi (mặc dù việc chụp một điểm nhìn cũng là một phân ngành của nghiên cứu NeRF).

Trường bức xạ thần kinh hoạt động bằng cách thu thập nhiều điểm nhìn vào một không gian 3D nhất quán và có thể điều hướng, với khoảng trống giữa các điểm nhìn được ước tính và được kết xuất bởi mạng nơ-ron. Khi video (thay vì hình ảnh tĩnh) được sử dụng, tài nguyên kết xuất cần thiết thường rất đáng kể. Nguồn: https://www.matthewtancik.com/nerf
Sự quan tâm đến NeRF đã trở nên mãnh liệt trong chín tháng qua, và một danh sách được duy trì bởi Reddit của các bài báo NeRF phái sinh hoặc khám phá hiện liệt kê sáu mươi dự án.

Chỉ một vài nhánh của bài báo NeRF ban đầu. Nguồn: https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
Đào tạo tiết kiệm
Bài báo này là một sự hợp tác giữa các nhà nghiên cứu tại Đại học Công nghệ Thượng Hải và DGene Digital Technology, và đã được chấp nhận với một số nhiệt tình tại Open Review.
ST-NeRF cung cấp một số đổi mới so với các sáng kiến trước đó trong các không gian video có thể điều hướng được tạo ra bởi máy học. Không kém, nó đạt được mức độ hiện thực cao với chỉ 16 máy quay. Mặc dù DyNeRF của Facebook sử dụng chỉ hai máy quay nhiều hơn, nó cung cấp một cung điều hướng bị hạn chế hơn nhiều.
Một ví dụ về môi trường DyNeRF của Facebook, với một cung điều hướng bị hạn chế hơn và nhiều máy quay hơn trên mỗi foot vuông cần thiết để tái tạo cảnh. Nguồn: https://neural-3d-video.github.io
Bên cạnh việc thiếu khả năng chỉnh sửa và tổng hợp các mặt riêng lẻ, DyNeRF đặc biệt tốn kém về tài nguyên tính toán. Ngược lại, các nhà nghiên cứu Trung Quốc cho biết chi phí đào tạo dữ liệu của họ nằm trong khoảng từ 900 đến 3.000 đô la, so với 30.000 đô la cho mô hình tạo video trạng thái nghệ thuật DVDGAN và các hệ thống chuyên sâu như DyNeRF.
Các nhà đánh giá cũng lưu ý rằng ST-NeRF đã thực hiện một đổi mới lớn trong việc tách quá trình học chuyển động khỏi quá trình tổng hợp hình ảnh. Sự tách biệt này cho phép chỉnh sửa và tổng hợp, với các phương pháp trước đây bị hạn chế và tuyến tính so sánh.
Mặc dù 16 máy quay là một mảng rất hạn chế cho một cung nhìn bán hình tròn, các nhà nghiên cứu hy vọng sẽ cắt giảm số lượng này xuống thấp hơn trong các công việc sau này thông qua việc sử dụng các nền tảng tĩnh được quét trước và các phương pháp mô hình hóa cảnh dữ liệu nhiều hơn. Họ cũng hy vọng sẽ kết hợp các khả năng tái chiếu sáng, một đổi mới gần đây trong nghiên cứu NeRF.
Địa chỉ hạn chế của ST-NeRF
Trong bối cảnh các bài báo khoa học máy tính học thuật thường vứt bỏ khả năng sử dụng thực tế của một hệ thống mới trong một đoạn cuối bị loại bỏ, ngay cả những hạn chế mà các nhà nghiên cứu thừa nhận đối với ST-NeRF cũng là không bình thường.
Họ quan sát thấy rằng hệ thống hiện không thể phân biệt và kết xuất riêng các đối tượng riêng biệt trong một cảnh, vì những người trong cảnh được phân đoạn thành các thực thể riêng biệt thông qua một hệ thống được thiết kế để nhận dạng con người và không phải đối tượng – một vấn đề dường như dễ dàng giải quyết với YOLO và các khuôn khổ tương tự, với công việc khó khăn hơn của việc trích xuất video con người đã được thực hiện.
Mặc dù các nhà nghiên cứu lưu ý rằng hiện không thể tạo ra chuyển động chậm, dường như không có gì ngăn cản việc thực hiện điều này bằng cách sử dụng các đổi mới hiện có trong nội suy khung như DAIN và RIFE.
Giống như tất cả các triển khai NeRF, và trong nhiều lĩnh vực khác của nghiên cứu thị giác máy tính, ST-NeRF có thể thất bại trong các trường hợp che khuất nghiêm trọng, nơi đối tượng bị che khuất tạm thời bởi một người hoặc một vật, và có thể khó theo dõi liên tục hoặc tái chiếm sau đó. Giống như ở nơi khác, khó khăn này có thể phải chờ giải pháp cấp trên. Trong khi đó, các nhà nghiên cứu thừa nhận rằng can thiệp thủ công là cần thiết trong các khung bị che khuất.
Cuối cùng, các nhà nghiên cứu quan sát thấy rằng các thủ tục phân đoạn con người hiện đang phụ thuộc vào sự khác biệt về màu sắc, điều này có thể dẫn đến việc kết hợp vô tình hai người vào một khối phân đoạn – một chướng ngại vật không chỉ giới hạn ở ST-NeRF, mà là固 có của thư viện được sử dụng, và có thể được giải quyết bằng cách phân tích dòng光 và các kỹ thuật mới nổi khác.
Được xuất bản lần đầu tiên vào ngày 7 tháng 5 năm 2021.


