
Mô hình và nền tảng AI
Bộ Dữ Liệu Mới (OTS) Của Appen Tăng Tốc Triển Khai Trí Tuệ Nhân Tạo

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
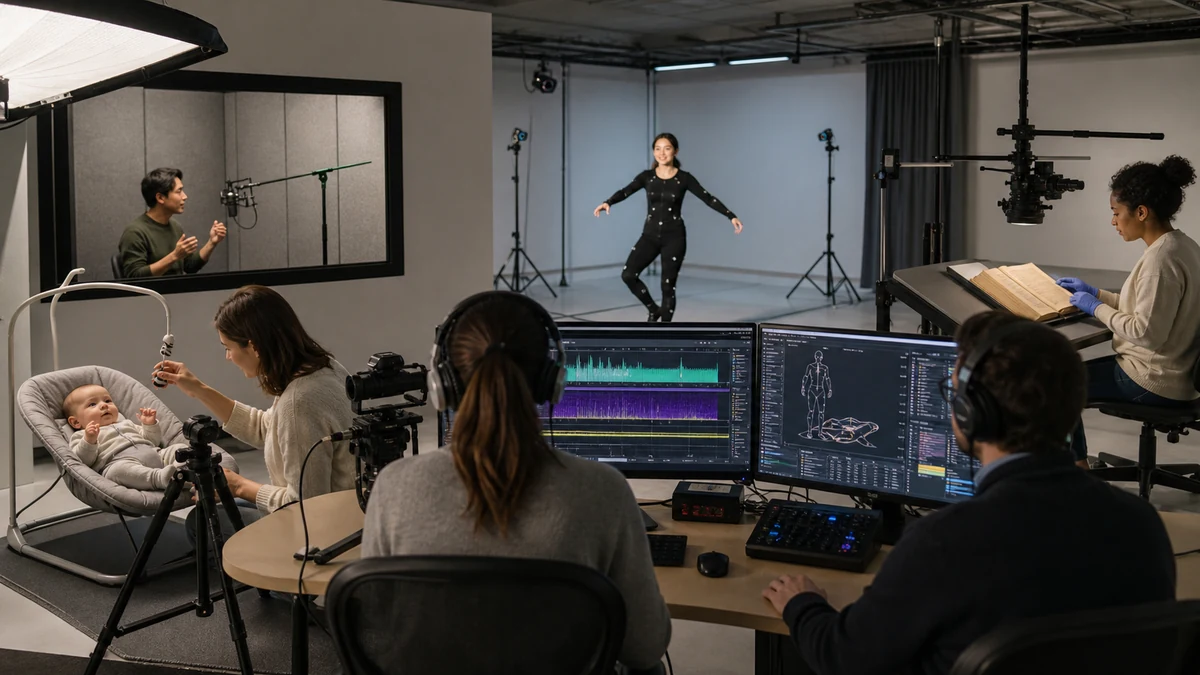
Appen Limited (ASX:APX), nhà cung cấp hàng đầu về dữ liệu đào tạo chất lượng cao cho các tổ chức xây dựng hệ thống trí tuệ nhân tạo (AI) hiệu quả trên quy mô lớn, hôm nay đã công bố bộ dữ liệu mới (OTS). Những bộ dữ liệu này được thiết kế để giúp các doanh nghiệp dễ dàng và nhanh chóng hơn trong việc thu thập dữ liệu đào tạo chất lượng cao cần thiết để tăng tốc dự án trí tuệ nhân tạo (AI) và học máy (ML) của họ. Bộ dữ liệu OTS mới bao gồm chuyển động cơ thể con người và âm thanh khóc của em bé sáng tạo, cũng như lời nói được viết sẵn và hình ảnh với văn bản phù hợp cho nhận dạng ký tự quang học (OCR) cho các ngôn ngữ khó thu thập nhưng có nhu cầu cao, chẳng hạn như tiếng Ả Rập, tiếng Croatia, tiếng Hy Lạp, tiếng Hungary, tiếng Thái và nhiều hơn. Với bộ dữ liệu được mở rộng, tổng số bộ dữ liệu OTS của Appen bao gồm hơn 250 bộ dữ liệu, bao gồm hơn 11.000 giờ âm thanh, hơn 25.000 hình ảnh và hơn 8,7 triệu từ trên 80 ngôn ngữ và nhiều phương ngữ.
Bộ dữ liệu OTS của Appen là một công cụ nhanh chóng và tiết kiệm chi phí để khởi động dự án AI hoặc ML với dữ liệu đào tạo chất lượng cao nhất quán. Các đội ngũ mở rộng khả năng AI của mình cũng có thể tận dụng bộ dữ liệu OTS để cải thiện hiệu quả, phát triển kỹ năng mô hình mới và kết hợp các cải tiến khác vào mô hình AI của họ. Bộ dữ liệu OTS thường được giao trong một tuần, ví dụ, so với tám đến mười hai tuần cho dự án thu thập và chú thích dữ liệu mới – hoặc thậm chí lâu hơn, tùy thuộc vào độ phức tạp. Tất cả các bộ dữ liệu của Appen đều được phát triển bằng phương pháp minh bạch, tự nguyện, vì vậy các chuyên gia AI có thể yên tâm rằng dữ liệu của họ sạch sẽ và tuân thủ, loại bỏ rủi ro tiềm ẩn về phản ứng dữ dội và thiệt hại về danh tiếng.
“Các đội ngũ AI trên toàn thế giới đang làm việc trên các dự án với thời hạn chặt chẽ và yêu cầu dữ liệu linh hoạt có thể được hưởng lợi từ việc sử dụng bộ dữ liệu OTS,” said Wilson Pang, CTO của Appen. “Bộ dữ liệu OTS rút ngắn thời gian đến giá trị và cung cấp quyền truy cập vào dữ liệu chất lượng cao với chi phí thấp hơn so với sử dụng phương pháp truyền thống. Chúng tôi tại Appen thực hiện các bước cần thiết để đảm bảo rằng tất cả các bộ dữ liệu của chúng tôi đều được thu thập một cách có đạo đức và cân bằng về mặt dân số, cho phép các công ty duy trì các thực hành AI có trách nhiệm bằng cách giảm thiểu sự thiên vị trong mô hình của họ và đảm bảo đối xử công bằng với người chú thích dữ liệu. Bạn luôn biết chính xác chất lượng của bộ dữ liệu OTS, điều này giúp xây dựng AI tốt hơn hoạt động trong thế giới thực.”
MediaInterface đã cung cấp các giải pháp công nghệ ngôn ngữ cho các tổ chức y tế ở Đức và các phần khác của châu Âu trong hơn 20 năm. Khi công ty này mở rộng sang Pháp, nó đã có phần mềm được bản địa hóa hoàn toàn nhưng thiếu dữ liệu từ vựng tiếng Pháp, đặc biệt là tên và địa điểm tiếng Pháp, thường được tham khảo trong thông tin sức khỏe của bệnh nhân. Sử dụng bộ dữ liệu OTS của Appen, MediaInterface đã thu được khoảng 21.000 tên tiếng Pháp và 14.000 tên địa điểm. “Dữ liệu quan trọng từ Appen đã được kết hợp vào từ vựng nền của chúng tôi để ra mắt thành công tại thị trường mới, và điều này giúp chúng tôi xây dựng từ vựng mới cho khách hàng của mình và tăng cường cách tiếp cận của chúng tôi cho các lần ra mắt thị trường trong tương lai,” said Ines Wendler, người quản lý sản phẩm tại MediaInterface.
Các chuyên gia AI giàu kinh nghiệm nhất kết hợp bộ dữ liệu OTS với các dự án thu thập và chú thích dữ liệu theo yêu cầu để đáp ứng nhu cầu đào tạo dữ liệu mô hình AI phức tạp của họ. Appen là người dẫn đầu trong việc cung cấp hỗ trợ liên tục thông qua một loạt các dịch vụ thu thập dữ liệu cụ thể, chẳng hạn như chú thích dữ liệu liên tục và gắn nhãn thông minh, thông qua các công cụ và quy trình làm việc tự động hóa để tối đa hóa hiệu quả.
“Chúng ta tương tác với AI từ lúc thức dậy đến lúc đi ngủ – thông qua các trợ lý ảo, rô-bốt trò chuyện, công cụ tìm kiếm, mạng xã hội, thiết bị y tế, xe hơi thông minh và các ứng dụng khác,” said Judith Bishop, giám đốc cấp cao của Appen về các chuyên gia AI, người lãnh đạo một đội gồm 100 chuyên gia ngôn ngữ và ngôn ngữ học. “Ngôn ngữ thường là giao diện chính cho nhiều trường hợp sử dụng AI hấp dẫn này, vì vậy để đảm bảo một trải nghiệm tuyệt vời, mô hình cần được đào tạo để hoạt động cho mọi người. Cam kết của Appen về dữ liệu chất lượng cao và phát triển AI có trách nhiệm, đạo đức cho phép các công ty mua bộ dữ liệu OTS của chúng tôi tăng tốc dự án AI của họ với sự tự tin hoàn toàn về dữ liệu của họ.”
Tham gia vào hàng trăm bộ dữ liệu hiện có trên appen.com, danh sách các bộ dữ liệu OTS mới của Appen hiện có sẵn bao gồm:
- Lời nói được viết sẵn cho tiếng Ả Rập (Ai Cập), tiếng Ả Rập (Ả Rập Xê Út), tiếng Ả Rập (Các Tiểu Vương Quốc Ả Rập Thống Nhất), tiếng Khmer (Campuchia), tiếng Croatia, tiếng Hy Lạp, tiếng Hungary, tiếng Ba Lan, tiếng Tây Ban Nha (Tây Ban Nha) và tiếng Thổ Nhĩ Kỳ
- Hình ảnh OCR cho văn bản tiếng Trung Quốc giản thể in, văn bản tiếng Thái in và văn bản tiếng Phần Lan in – Bao gồm các bảng hiệu, bao bì ngoài, biển hiệu, tạp chí và menu được thu trước để đào tạo và cập nhật các mô hình OCR tầm nhìn máy tính
- Chuyển động cơ thể con người (Trung Quốc) – Bao gồm video được chú thích về người di chuyển, được theo dõi ở mức pixel, phù hợp cho phát triển trò chơi, ứng dụng thể dục và nhiều hơn
- Âm thanh khóc của em bé (Trung Quốc) – Bao gồm âm thanh được thu trước và chú thích về âm thanh khóc của em bé có thể được sử dụng để đào tạo mô hình AI nhận ra các âm thanh khóc khác nhau và cảnh báo cho phụ huynh
Để biết thêm thông tin và yêu cầu mẫu bộ dữ liệu OTS của Appen, hãy nhấp vào đây.


