Góc nhìn Anderson
AI giúp người nói hồi hộp nắm bắt phản ứng của khán giả trong hội nghị truyền hình

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Điểm chínhCalmResponses chỉ sử dụng webcam và trình duyệt để theo dõi việc gật đầu và ánh nhìn…
Xem thêm
- CalmResponses chỉ sử dụng webcam và trình duyệt để theo dõi việc gật đầu và ánh nhìn của khán giả mà không cần phần cứng bổ sung.
- Hệ thống đã giảm lời nói thừa ở người thuyết trình bằng cách trực quan hóa các phản ứng tập thể của khán giả trong các cuộc họp video.
- Các thành viên khán giả cảm thấy được tham gia nhiều hơn khi chuyển động đầu của họ được tổng hợp một cách ẩn danh cho người thuyết trình.
Vào năm 2013, một cuộc thăm dò về các nỗi sợ hãi thông thường đã xác định rằng việc nói trước đám đông là khủng khiếp hơn so với việc đối mặt với cái chết đối với đa số người trả lời. Hội chứng này được gọi là glossophobia.
Sự chuyển dịch do COVID-19 thúc đẩy từ các cuộc họp trực tiếp sang các cuộc họp trực tuyến trên các nền tảng như Zoom và Google Spaces đã không cải thiện tình hình. Khi cuộc họp có số lượng người tham gia lớn, khả năng đánh giá mối đe dọa tự nhiên của chúng ta bị suy giảm bởi các hàng và biểu tượng người tham gia độ phân giải thấp và khó khăn trong việc đọc các tín hiệu trực quan tinh vi của biểu cảm khuôn mặt và ngôn ngữ cơ thể. Ví dụ, Skype đã được phát hiện là một nền tảng kém để truyền đạt các tín hiệu không lời.
Ảnh hưởng của sự quan tâm và phản hồi mà người nói cảm nhận được từ khán giả đối với chất lượng nói trước đám đông đã được ghi lại, và rõ ràng với hầu hết chúng ta. Phản hồi của khán giả không rõ ràng có thể khiến người nói do dự và quay lại lời nói thừa, không biết liệu các lập luận của họ có được đồng ý, khinh thường hay thờ ơ, thường tạo ra một trải nghiệm khó chịu cho cả người nói và thính giả.
Dưới áp lực từ sự thay đổi đột ngột sang họp trực tuyến do các hạn chế và phòng ngừa của COVID-19, vấn đề này có thể đang trở nên tồi tệ hơn, và một số phương án phản hồi khán giả đã được đề xuất trong cộng đồng nghiên cứu về thị giác máy tính và cảm xúc trong vài năm qua.
Giải pháp tập trung vào phần cứng
Hầu hết trong số này liên quan đến thiết bị hoặc phần mềm phức tạp có thể gây ra các vấn đề về quyền riêng tư hoặc hậu cần – các phương pháp tiếp cận có chi phí cao hoặc hạn chế về tài nguyên, đã có từ trước đại dịch. Vào năm 2001, MIT đã đề xuất Galvactivator, một thiết bị đeo tay xác định trạng thái cảm xúc của người tham gia khán giả, được thử nghiệm trong một hội thảo kéo dài một ngày.

Galvactivator của MIT năm 2001 đo phản ứng dẫn điện của da nhằm tìm hiểu cảm xúc và sự tham gia của khán giả. Nguồn: https://dam-prod.media.mit.edu/x/files/pub/tech-reports/TR-542.pdf
Nhiều năng lượng học thuật cũng đã được dành cho việc triển khai ‘clickers’ như một Hệ thống Phản hồi Khán giả (ARS), một biện pháp để tăng sự tham gia tích cực của khán giả (tự động tăng cường tham gia, vì nó buộc người xem vào vai trò của một nút phản hồi tích cực), nhưng cũng được coi là một phương tiện khuyến khích người nói.
Các nỗ lực khác để ‘kết nối’ người nói và khán giả bao gồm theo dõi nhịp tim, sử dụng thiết bị phức tạp đeo trên người để tận dụng điện não đồ, ‘đồng hồ vỗ tay’, nhận dạng cảm xúc dựa trên thị giác máy tính cho người lao động tại bàn làm việc, và sử dụng biểu tượng cảm xúc được khán giả gửi trong khi người nói đang nói.

EngageMeter năm 2017, dự án nghiên cứu chung của LMU München và Đại học Stuttgart. Nguồn: http://www.mariamhassib.net/pubs/hassib2017CHI_3/hassib2017CHI_3.pdf
Trong lĩnh vực phân tích khán giả sinh lợi, khu vực tư nhân đặc biệt quan tâm đến việc ước tính và theo dõi tầm nhìn – các hệ thống trong đó mỗi thành viên khán giả (người có thể sẽ phải nói chuyện) bị theo dõi theo dõi mắt như một chỉ số của sự tham gia và đồng tình.
Tất cả các phương pháp này đều có ma sát khá cao. Nhiều phương pháp yêu cầu thiết bị tùy chỉnh, môi trường phòng thí nghiệm, phần mềm khung phức tạp và đăng ký API thương mại đắt tiền – hoặc bất kỳ sự kết hợp nào của các yếu tố hạn chế này.
Vì vậy, việc phát triển các hệ thống tối giản dựa trên các công cụ phổ biến cho hội nghị truyền hình đã trở thành một vấn đề quan tâm trong 18 tháng qua.
Báo cáo sự đồng tình của khán giả một cách kín đáo
Để đạt được điều này, một sự hợp tác nghiên cứu mới giữa Đại học Tokyo và Đại học Carnegie Mellon cung cấp một hệ thống có thể tận dụng các công cụ hội nghị truyền hình tiêu chuẩn (như Zoom) chỉ bằng cách sử dụng một trang web có webcam trên đó chạy phần mềm ước tính tư thế và tầm nhìn nhẹ. Bằng cách này, ngay cả nhu cầu về plugin trình duyệt cục bộ cũng được tránh.
Dữ liệu về gật đầu và ước tính sự chú ý của người dùng được dịch thành dữ liệu đại diện được trực quan hóa lại cho người nói, cho phép một ‘thử nghiệm sống’ về mức độ nội dung thu hút khán giả – và cũng là một dấu hiệu mơ hồ về các giai đoạn thảo luận mà người nói có thể đang mất sự quan tâm của khán giả.
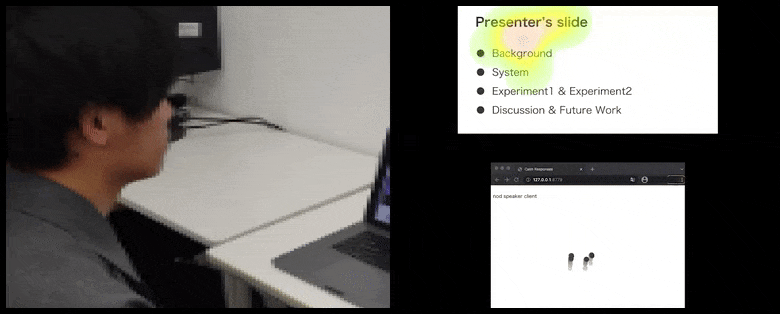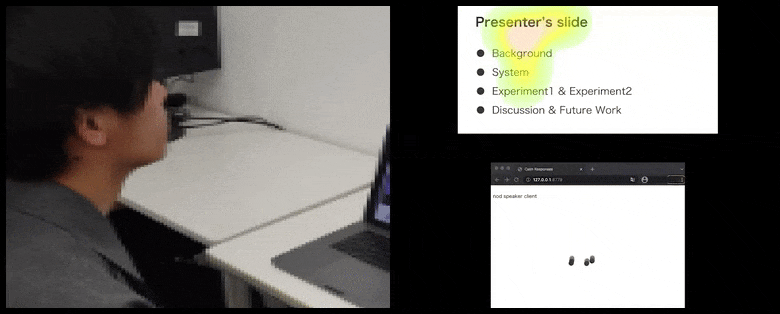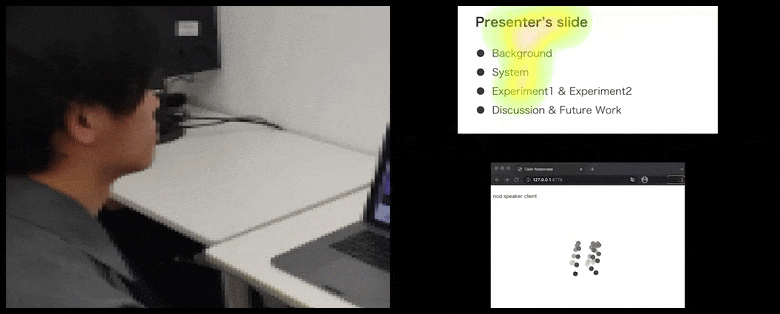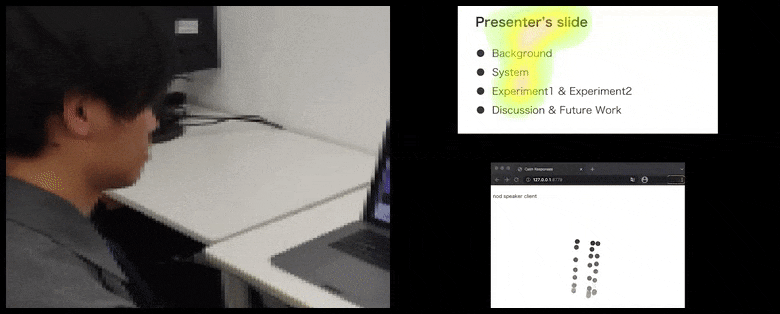
Với CalmResponses, sự chú ý và gật đầu của người dùng được đưa vào tập hợp phản hồi của khán giả và chuyển thành hình ảnh hữu ích cho người nói. Xem video cuối bài để biết thêm chi tiết và ví dụ. Nguồn: https://www.youtube.com/watch?v=J_PhB4FCzk0
Trong nhiều tình huống học thuật, như giảng bài trực tuyến, sinh viên có thể không xuất hiện trước người nói vì không muốn chia sẻ hình ảnh về phông nền hoặc ngoại hình lúc đó. CalmResponses có thể báo cáo hướng nhìn và việc gật đầu mà không truyền video của họ cho những người tham gia khác. Tuy nhiên, webcam vẫn cần được dùng để ghi nhận các chuyển động này ngay trên thiết bị.
Bài báo có tiêu đề CalmResponses: Hiển thị Phản hồi Tập thể của Khán giả trong Truyền thông Từ xa, và là một công trình chung giữa hai nhà nghiên cứu từ UoT và một từ Carnegie Mellon.
Các tác giả cung cấp một bản demo trực tuyến và đã phát hành mã nguồn tại GitHub.
Khung CalmResponses
Sự quan tâm của CalmResponses đối với việc gật đầu, trái ngược với các trạng thái đầu khác, dựa trên nghiên cứu (một số trong đó có từ thời đại của Darwin) cho thấy rằng hơn 80% tất cả các chuyển động đầu của thính giả gồm có việc gật đầu (ngay cả khi họ thể hiện sự không đồng ý). Đồng thời, các chuyển động ánh nhìn đã được chứng minh trong nhiều nghiên cứu là một chỉ số đáng tin cậy về sự quan tâm hoặc tham gia.
CalmResponses được thực hiện với HTML, CSS và JavaScript, và bao gồm ba hệ thống con: máy khách khán giả, máy khách người nói và máy chủ. Máy khách khán giả truyền dữ liệu hướng nhìn hoặc chuyển động đầu từ webcam của người dùng qua WebSockets trên nền tảng ứng dụng đám mây Heroku.

Gật đầu của khán giả được biểu diễn bằng chuyển động ở bên phải trong CalmResponses. Trong trường hợp này, cả người nói lẫn toàn bộ khán giả đều thấy hình ảnh đó. Nguồn: https://arxiv.org/pdf/2204.02308.pdf
Đối với phần theo dõi mắt của dự án, các nhà nghiên cứu đã sử dụng WebGazer, một khung theo dõi mắt dựa trên JavaScript nhẹ và có thể chạy với độ trễ thấp trực tiếp từ một trang web (xem liên kết trên để triển khai web dựa trên của các nhà nghiên cứu).
Vì nhu cầu thực hiện đơn giản và nhận dạng phản hồi tổng hợp thô vượt qua nhu cầu về độ chính xác cao trong ước tính tư thế và tầm nhìn, dữ liệu tư thế đầu vào được làm mịn theo các giá trị trung bình trước khi được xem xét cho ước tính phản hồi tổng thể.
Hành động gật đầu được đánh giá thông qua thư viện JavaScript clmtrackr, phù hợp với các mô hình khuôn mặt với khuôn mặt được phát hiện trong hình ảnh hoặc video thông qua dịch chuyển trung bình có điều chuẩn của các điểm mốc (regularized landmark mean-shift). Để tiết kiệm và độ trễ thấp, chỉ có điểm mốc phát hiện ra mũi được theo dõi tích cực trong triển khai của các tác giả, vì điều này đủ để theo dõi các hành động gật đầu.

Chuyển động vị trí đầu mũi của người dùng tạo vệt bổ sung vào tập hợp phản hồi gật đầu của khán giả, được biểu diễn tổng hợp cho tất cả người tham gia.
Bản đồ nhiệt
Mặc dù hoạt động gật đầu được đại diện bởi các điểm động (xem hình ảnh trên và video ở cuối), sự chú ý trực quan được báo cáo dưới dạng bản đồ nhiệt cho thấy người nói và khán giả nơi tập trung chung của sự chú ý trên màn hình trình bày được chia sẻ hoặc trong môi trường hội nghị truyền hình.

Tất cả người tham gia thấy được hướng tập trung chú ý chung. Bài báo không đề cập chức năng này có hoạt động khi người dùng nhìn thấy thư viện hình ảnh của những người tham gia khác hay không, điều có thể cho thấy sự tập trung bề ngoài vào một người cụ thể vì nhiều lý do.
Thử nghiệm
Hai môi trường thử nghiệm được xây dựng cho CalmResponses dưới dạng một nghiên cứu cắt giảm ngầm, sử dụng ba tập hợp hoàn cảnh khác nhau: trong ‘Điều kiện B’ (đường cơ sở), các tác giả đã sao chép một buổi giảng trực tuyến điển hình, nơi đa số sinh viên giữ webcam của họ tắt và người nói không có khả năng nhìn thấy khuôn mặt của khán giả; trong ‘Điều kiện CR-E’, người nói có thể nhìn thấy phản hồi về hướng nhìn (bản đồ nhiệt); trong ‘Điều kiện CR-N’, người nói có thể nhìn thấy cả hoạt động gật đầu và tầm nhìn từ khán giả.
Kịch bản thử nghiệm thứ nhất gồm điều kiện B và CR-E; kịch bản thứ hai gồm B và CR-N. Phản hồi được thu thập từ cả người nói và khán giả.
Trong mỗi thí nghiệm, ba yếu tố được đánh giá: đánh giá khách quan và chủ quan về bài trình bày (bao gồm một bảng câu hỏi tự báo cáo từ người nói về cảm giác của họ về cách bài trình bày diễn ra); số lượng sự kiện ‘lời nói thừa’, chỉ ra sự không an toàn và do dự tạm thời; và nhận xét định tính. Những tiêu chí này là thông thường đánh giá chất lượng lời nói và lo lắng của người nói.
Chúng bao gồm 38 người trong độ tuổi từ 19 đến 44, bao gồm 29 nam và 9 nữ với độ tuổi trung bình là 24,7, tất cả đều là người Nhật hoặc người Trung Quốc và đều nói tiếng Nhật trôi chảy. Họ được chia ngẫu nhiên thành sáu nhóm từ 5 đến 7 người tham gia, và không người tham gia nào quen biết nhau từ trước.
Thử nghiệm được thực hiện trên Zoom, với năm người nói trình bày trong thí nghiệm đầu tiên và sáu trong thí nghiệm thứ hai.

Các điều kiện lời nói đệm được đánh dấu bằng khung màu cam. Nhìn chung, lời nói đệm giảm tương ứng tương đối với mức tăng phản hồi khán giả từ hệ thống.
Các nhà nghiên cứu ghi nhận lời nói đệm của một người nói giảm đáng kể và trong điều kiện CR-N, người nói hiếm khi dùng cụm từ đệm. Bài báo trình bày các kết quả rất chi tiết; tuy nhiên, kết quả nổi bật nhất nằm ở đánh giá chủ quan của người nói và khán giả.
Những nhận xét từ khán giả bao gồm:
‘Tôi cảm thấy mình được tham gia vào các buổi trình bày” [AN2], “Tôi không chắc chắn liệu các bài nói của người nói có được cải thiện hay không, nhưng tôi cảm thấy một sự thống nhất từ các chuyển động đầu của người khác.’ [AN6]
‘Tôi không chắc chắn liệu các bài nói của người nói có được cải thiện hay không, nhưng tôi cảm thấy một sự thống nhất từ các chuyển động đầu của người khác.’
Các nhà nghiên cứu ghi nhận hệ thống tạo ra một kiểu ngắt quãng nhân tạo mới trong bài trình bày, vì người nói thường xem hình ảnh để đánh giá phản hồi của khán giả trước khi tiếp tục.
Họ cũng ghi nhận một dạng hiệu ứng áo choàng trắng khó tránh trong thí nghiệm: một số người tham gia cảm thấy gò bó do lo ngại về an toàn khi bị theo dõi dữ liệu sinh trắc học.
Kết luận
Một lợi thế đáng chú ý trong một hệ thống như này là tất cả các công nghệ phụ trợ không tiêu chuẩn hoàn toàn biến mất sau khi sử dụng. Không có plugin trình duyệt nào cần gỡ cài đặt, hoặc để tạo ra sự nghi ngờ trong tâm trí của người tham gia về việc liệu họ nên giữ chúng trên hệ thống của mình; và không cần hướng dẫn người dùng qua quá trình cài đặt (mặc dù khung web dựa trên yêu cầu một hoặc hai phút hiệu chỉnh ban đầu của người dùng), hoặc để điều hướng khả năng người dùng không có đủ quyền để cài đặt phần mềm cục bộ, bao gồm cả tiện ích mở rộng và tiện ích bổ sung dựa trên trình duyệt.
Mặc dù các chuyển động khuôn mặt và mắt được đánh giá không chính xác như chúng có thể trong các tình huống mà các khung học máy cục bộ chuyên dụng (như loạt YOLO) có thể được sử dụng, nhưng cách tiếp cận gần như không ma sát này để đánh giá khán giả cung cấp độ chính xác đủ cho phân tích tổng quát về cảm xúc và lập trường trong các kịch bản hội nghị truyền hình điển hình. Hơn hết, nó rất rẻ.
Xem video dự án liên quan dưới đây để biết thêm chi tiết và ví dụ.
Được xuất bản lần đầu vào ngày 11 tháng 4 năm 2022.