
Góc nhìn Anderson
Hệ Thống Học Máy Tự Động Chỉnh Sửa Bài Viết Trong Khi Bạn Đọc

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
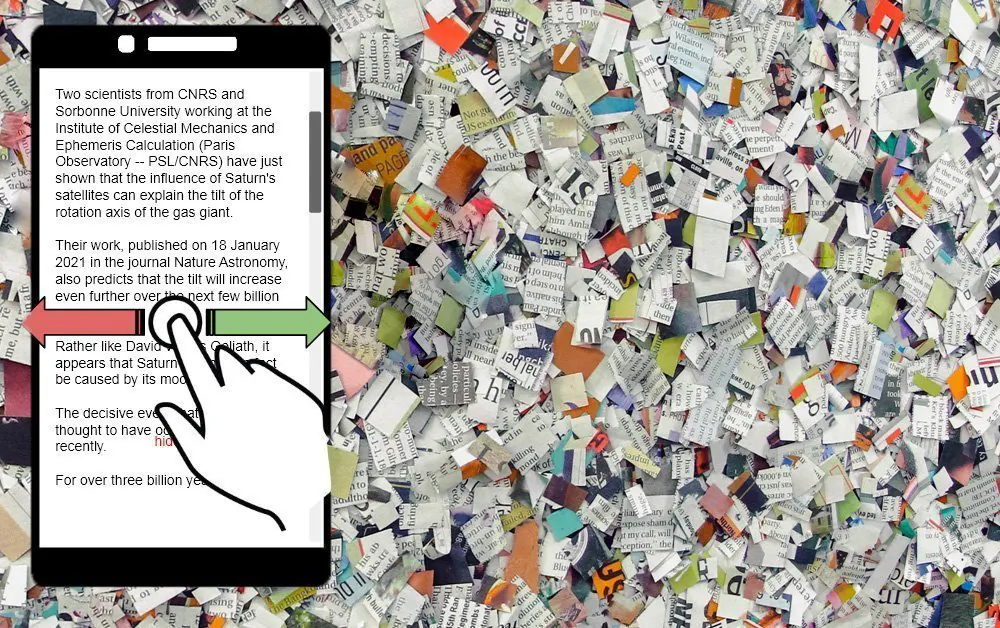
Nghiên cứu mới từ Canada đề xuất một phương pháp để tự động chỉnh sửa bài viết khi bạn đọc, dựa trên việc “vuốt” theo kiểu Tinder hoặc quan sát thụ động cách người đọc tương tác với các loại nội dung khác nhau trong bài viết.
Hệ thống, có tên Hone As You Read (HARE), được trình bày trong một bài báo từ Đại học Western tại Ontario, Canada, với mã Python tương ứng trên GitHub.
Ý tưởng trung tâm của dự án là một bài viết có thể chứa các loại nội dung khác nhau, phát triển (giống như bài viết này) từ tiêu đề xuống đến chi tiết cụ thể. Các phần sau của bài viết có thể chứa các tài liệu hỗ trợ, ví dụ, giả thuyết hoặc suy đoán về các ramification của tin tức.
Theo HARE, nếu bạn không thích loại tài liệu đó, bạn có thể bỏ phiếu chống lại nó trên cơ sở đoạn văn để hệ thống học hỏi sở thích của bạn, để khi bạn cuộn xuống, nội dung tương tự với tài liệu mà bạn “bỏ phiếu chống” đã được xóa hoặc chỉnh sửa. Nếu bạn không muốn tham gia tích cực vào việc đào tạo hệ thống, HARE có thể suy luận ra lựa chọn của bạn bằng cách quan sát các tương tác thụ động của bạn với tài liệu.
Voting Kiểu Tinder Cho Câu Displeasing
Trong hình ảnh dưới đây, chúng ta thấy ba loại phân loại có thể được suy luận cho HARE, dựa trên hành vi rõ ràng hoặc ngầm của người dùng. Trong trường hợp đầu tiên (bên trái), người dùng chủ động “vuốt trái” (hoặc phải), trong một cử chỉ bỏ phiếu kiểu Tinder thể hiện sự chấp thuận hoặc không hài lòng với nội dung của đoạn văn hoặc câu, hoặc với phong cách, độ phức tạp hoặc giọng điệu của nó.

Nguồn: https://arxiv.org/pdf/2105.02923.pdf
Trong trường hợp thứ hai (trung tâm), hệ thống sử dụng thời gian lưu lại như một thước đo sự quan tâm của người dùng, dựa trên vị trí và thời gian tạm dừng khi cuộn.
Trong trường hợp thứ ba (bên phải), HARE sử dụng camera điện thoại để ước tính đường đi và thời gian lưu lại của vị trí nhìn của người xem trên các đoạn văn của tài liệu hiển thị.
Các nhà nghiên cứu cho rằng thời gian lưu lại tăng trên bất kỳ đoạn văn nào có thể chỉ ra sự quan tâm của người dùng tăng, mặc dù logic này có thể không đúng trong trường hợp người xem đang cố gắng hấp thụ văn bản có thể phức tạp hoặc chỉ viết kém.

Phản hồi của người dùng hiệu quả chỉnh sửa, viết lại hoặc xóa hoàn toàn các phần chưa xem của bài viết.
Chỉnh Sửa Nội Dung Theo Sở Thích Của Người Dùng
Bài báo này đề cập đến trải nghiệm người dùng của HARE trên cơ sở mỗi bài viết, nhưng rõ ràng là sự tương tác lịch sử của người dùng với các tài liệu cho phép tùy chỉnh trải nghiệm đọc trong tương lai, bằng cách nhận ra nhất quán các loại nội dung và áp dụng các sở thích người dùng được tạo mẫu cho các bài viết mới, để nhu cầu tương tác giảm dần khi người dùng thấy ít và ít hơn “nội dung không mong muốn”.
HARE được đặc trưng như một thuật toán tóm tắt, cho phép nội dung chưa xem ở phía dưới trang được viết lại về phong cách hoặc độ concis của nó trước khi người dùng đến đó; nhưng bài báo làm rõ rằng nó cũng có thể loại bỏ nội dung trước đó dựa trên phản hồi của người dùng.
Với mục đích thử nghiệm, hệ thống sử dụng một corpus của 11.222 bài viết từ tờ báo Daily Mail của Anh, và được đánh giá thông qua một thử nghiệm triển khai trên ứng dụng trò chuyện Telegram. Các bài viết có ít hơn mười đoạn văn đã bị loại bỏ cho mục đích thử nghiệm.

Ứng dụng Telegram HARE trong giai đoạn thử nghiệm với người dùng.
Phương pháp của các nhà nghiên cứu sử dụng K-Means clustering trên SBERT các bản nhúng câu trong các bài viết, với các trọng số ban đầu ngẫu nhiên cho các khái niệm được xử lý.
Trong số nhiều thuật toán và phương pháp, HARE có ba mô hình so sánh, mô hình đầu tiên (ORACLEGREEDY) có quyền truy cập vào các sở thích người dùng trước, cho thấy ý định rằng thuật toán có thể tiền xử lý các bài viết khi tải, chứ không phải tương tác.
Các mô hình khác, ORACLESORTED và ORACLEUNIFORM, chọn câu dựa trên mức độ quan tâm hoặc ngẫu nhiên trên toàn bài viết.
Loại Bỏ Và Chỉnh Sửa Nội Dung
Điều đáng ngạc nhiên là ORACLEUNIFORM đã vượt qua tập hợp kiểm soát, mặc dù nó không có quyền truy cập vào các sở thích người dùng trước. Các nhà nghiên cứu cho rằng điều này là vì nó xử lý toàn bộ bài viết trong một lần, “chọn chỉ những câu quan trọng nhất”. Các nhà nghiên cứu thừa nhận rằng điều này có thể hạn chế nội dung có sẵn cho những câu chỉ liên quan đến khái niệm quan trọng nhất, logic loại bỏ các văn bản khác có thể liên quan đến các ramification hoặc đánh giá của khái niệm.
Các tóm tắt trích xuất được sử dụng trong HARE là LexRank, SumBasic, và TextRank.
HARE đã được thử nghiệm trên 13 tình nguyện viên trong 70 thử nghiệm và các phương pháp thuật toán khác nhau, và có thể cập nhật tóm tắt (nội dung được viết lại / loại bỏ) trong khoảng từ 1,3 mili giây đến 100ms trên một máy tính xách tay cấp tiêu dùng, tùy thuộc vào mô hình được thử nghiệm. Kết quả cho thấy rằng các mô hình loại bỏ nhiều văn bản nhất không hoạt động tốt, chủ yếu vì điều này có thể ảnh hưởng đến sự mạch lạc của văn bản còn lại.
Ảnh Hưởng Đạo Đức Của Việc Chỉnh Sửa Bài Viết Động
Các nhà nghiên cứu thừa nhận các vấn đề đạo đức xung quanh các công nghệ như vậy:
‘Nhiệm vụ HARE được thiết kế cho việc thiết kế các ứng dụng tương tác với người dùng trong tương lai. Theo thiết kế, các ứng dụng này có khả năng kiểm soát những gì người dùng đọc từ một bài viết nhất định. Có thể khi triển khai mà không có sự chăm sóc đầy đủ, những công cụ này có thể làm tăng hiệu ứng “phòng vang” đã được tạo ra bởi các nguồn cấp tin tức tự động, kết quả tìm kiếm và cộng đồng trực tuyến.’
Tuy nhiên, họ cũng lưu ý rằng một hệ thống như vậy có thể được sử dụng trong các ứng dụng trong tương lai để giảm thiểu hiệu ứng phòng vang bằng cách tiêm nội dung đề xuất các quan điểm thay thế có thể không có mặt ban đầu trong bài viết. Họ quan sát: ‘Trọng lượng của yếu tố này có thể được điều chỉnh để cung cấp cả trải nghiệm đọc hấp dẫn và tiếp xúc với đa dạng ý tưởng.’
Những người có thể được hưởng lợi từ một hệ thống như vậy, theo các nhà nghiên cứu, là những người đọc muốn tiết kiệm thời gian khi thu thập thông tin, và các nhà xuất bản nội dung.
trong bài viết. Họ quan sát: ‘Trọng lượng của yếu tố này có thể được điều chỉnh để cung cấp cả trải nghiệm đọc hấp dẫn và tiếp xúc với đa dạng ý tưởng.’ Những người có thể được hưởng lợi từ một hệ thống như vậy, theo các nhà nghiên cứu, là những người đọc muốn tiết kiệm thời gian khi thu thập thông tin, và các nhà xuất bản nội dung.


