
Погляд Anderson
Модель дифузії eDiffi від NVIDIA дозволяє «малювати словами» та більше

 Додайте Unite.AI до бажаних джерел у Google
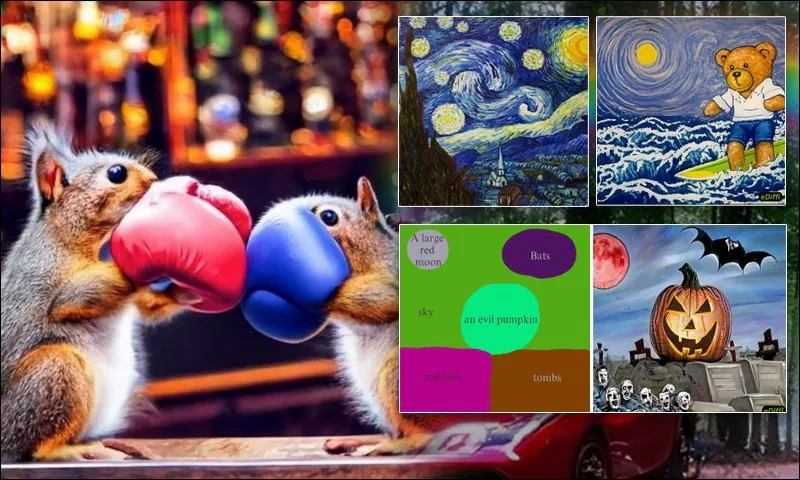
Ключові моментиNVIDIA eDiffi використовує ансамбль експертних денойзерів для покращеного контролю…
Показати більше
- NVIDIA eDiffi використовує ансамбль експертних денойзерів для покращеного контролю текст-до-зображення.
- Модель інтегрує кодери T5 та CLIP для покращення дрібних деталей та глобальної композиції.
- eDiffi дозволяє малювати словами, зіставляючи кольори з елементами підказки для точного компонування.
Спроби створити точні композиції за допомогою генеративних моделей зображень з латентною дифузією, таких як Stable Diffusion, можуть бути подібні до загону котів; ті самі уявні та інтерпретативні сили, які дозволяють системі створювати надзвичайні деталі та викликати надзвичайні зображення з відносно простих текстових підказок, також важко вимкнути, коли ви шукаєте контроль рівня Photoshop над генерацією зображення.
Тепер новий підхід від дослідників NVIDIA (NVDA ), названий ensemble дифузія для зображень (eDiffi), використовує поєднання декількох методів вкладення та інтерпретації (замість одного методу на всьому шляху процесу) для забезпечення значно вищого рівня контролю над згенерованим вмістом. У прикладі нижче ми бачимо, як користувач малює елементи, де кожен колір представляє одне слово з текстової підказки:
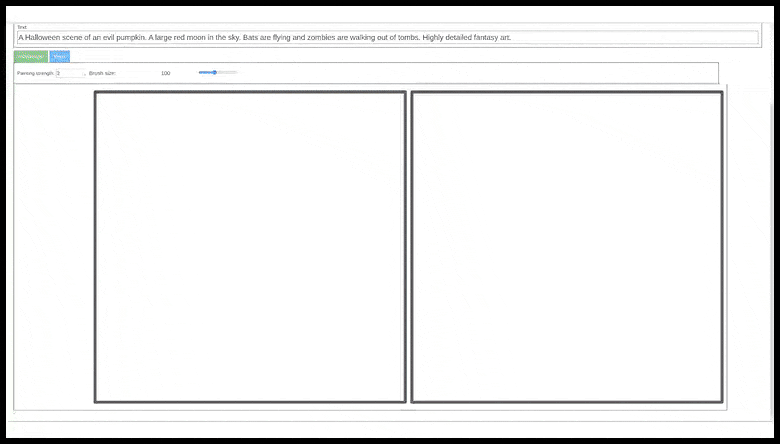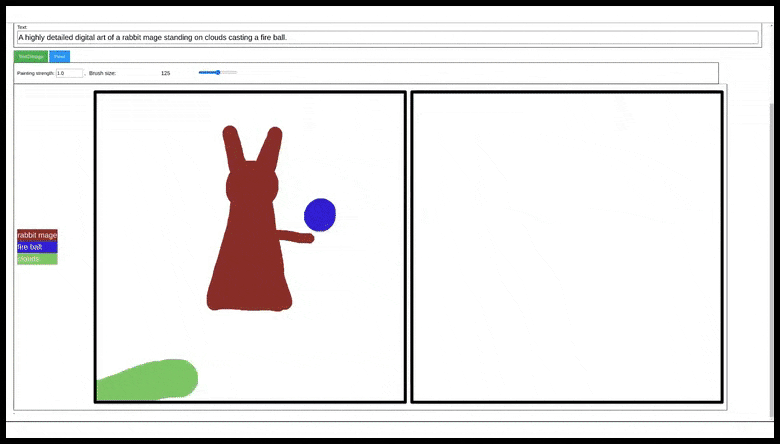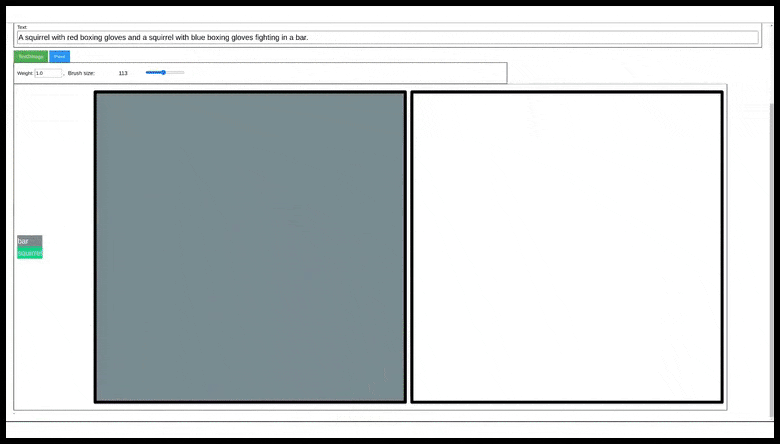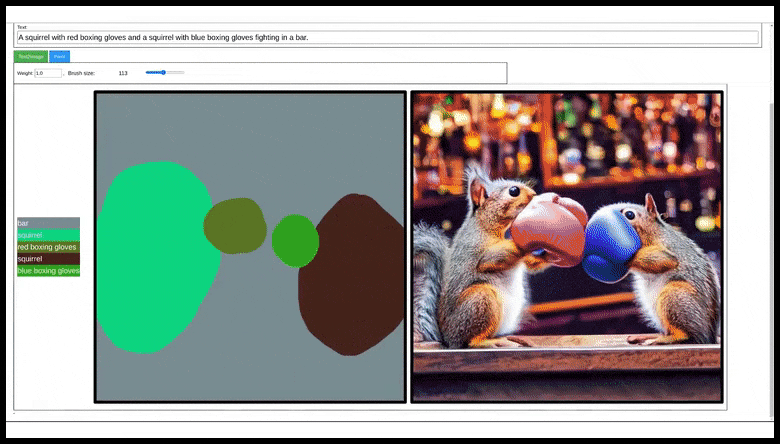
«Малювання словами» – одна з двох нових можливостей у моделі дифузії eDiffi від NVIDIA. Кожна накладена фарба представляє слово з підказки (дивіться, як вони з’являються зліва під час генерації), а застосований колір складатиметься лише з цього елемента. Дивіться офіційне відео з більшими прикладами та кращою роздільною здатністю на https://www.youtube.com/watch?v=k6cOx9YjHJc
По суті, це «малювання з масками», і змінює парадигму inpainting у Stable Diffusion, яка заснована на виправленні пошкоджених або незадовільних зображень, або розширенні зображень, які могли б бути бажаним розміром з самого початку.
Тут, навпаки, межі намальованих елементів представляють допустимі приблизні межі лише одного унікального елемента з однієї концепції, що дозволяє користувачеві встановити кінцевий розмір полотна з самого початку, а потім дискретно додавати елементи.

Приклади з нової статті. Джерело: https://arxiv.org/pdf/2211.01324.pdf
Розмаїття методів, використаних у eDiffi, також означає, що система робить значно кращу роботу з включенням кожного елемента у довгих та детальних підказках, тоді як Stable Diffusion та DALL-E 2 схильні надавати пріоритет певні частини підказки, залежно від того, як рано цільові слова з’являються у підказці, або від інших факторів, таких як потенційна складність у розрізненні різних елементів, необхідних для повної, але всеосяжної (відносно текстової підказки) композиції:

Зі статті: eDiffi здатна ретельніше опрацьовувати підказку, доки не буде відтворено максимально можливу кількість елементів. Хоча покращені результати eDiffi у крайньому правому стовпці підібрані вибірково, так само підібрані й порівняльні зображення Stable Diffusion та DALL-E 2.
Крім того, використання спеціального T5 текстового кодера означає, що eDiffi здатний генерувати зрозумілі англійські тексти, або абстрактно запрошені з підказки (тобто зображення містить деякий текст [x]), або явно запрошені (тобто футболка говорить ‘Nvidia Rocks’)

Спеціальний текстовий кодер у eDiffi означає, що текст можна відображати дослівно у зображеннях, замість того, щоб проходити лише через текстово-образну інтерпретаційну шар, яка спотворює вивід.
Одна з додаткових переваг нової структури полягає в тому, що тепер можна надати одне зображення як підказку стилю, замість того, щоб навчати модель DreamBooth або текстову вкладку на декількох прикладах жанру або стилю.

Передача стилю може бути застосована від зображення-підказки до текстово-образної підказки, або навіть від зображення до зображення.
Нова стаття називається eDiffi: текстово-образні дифузійні моделі з ансамблем експертних денойзерів, і
Текстовий кодер T5
Використання Text-to-Text Transfer Transformer (T5) від Google є ключовим елементом у покращених результатах, продемонстрованих у eDiffi. Типовий процес латентної дифузії центрується на асоціації між навченими зображеннями та підказками, які супроводжували їх під час збору з інтернету (або ж вручну скориговані пізніше, хоча це дорогий і тому рідкісний захід).

З липня 2020 року – текстові перетворення, які можуть допомогти генеративному процесу зображень у eDiffi (і, потенційно, інших моделей латентної дифузії). Джерело: https://arxiv.org/pdf/1910.10683.pdf
Перефразовуючи вихідний текст і запускаючи модуль T5, можна отримати більш точні асоціації та представлення, ніж були закладені у модель спочатку, майже як пост-факто ручне маркування, з більшою специфікою та застосовністю до вимог текстової підказки.
Автори пояснюють:
‘У більшості існуючих робіт над дифузійними моделями денойзуюча модель спільна для всіх рівнів шуму, а часова динаміка представлена простим часовим вбудовуванням, яке подається до денойзуючої моделі через мережу MLP. Ми стверджуємо, що складна часова динаміка денойзуючої дифузії може не бути вивчена з даних ефективно за допомогою спільної моделі з обмеженою ємністю.
‘Натомість, ми пропонуємо збільшити ємність денойзуючої моделі, введши ансамбль експертних денойзерів; кожен експертний денойзер є денойзуючою моделлю, спеціалізованою для певного діапазону рівнів шуму. Таким чином, ми можемо збільшити ємність моделі без сповільнення генерування вибірок, оскільки обчислювальна складність оцінки [обробленого елемента] на кожному рівні шуму залишається такою самою.’

Концептуальна архітектура eDiffi.
Існуючі модулі кодування CLIP, включені до DALL-E 2 і Stable Diffusion, також здатні знаходити альтернативні інтерпретації зображень для тексту, пов’язаного з вхідними даними користувача. Однак вони тренуються на подібній інформації до оригінальної моделі і не використовуються як окремий інтерпретаційний шар у такому ж спосіб, як T5 у eDiffi.
Автори зазначають, що eDiffi є першою моделлю, яка поєднує в собі як T5, так і CLIP-кодер:
‘Оскільки ці два кодери тренуються з різними цілями, їх вкладення схиляються до утворення різних зображень з одним і тим же вхідним текстом. Хоча текстові вкладення CLIP допомагають визначити загальний вигляд згенерованих зображень, вони схильні пропускати тонкі деталі у тексті.
‘Натомість, зображення, згенеровані лише з текстовими вкладеннями T5, краще відображають окремі об’єкти, описані у тексті, але їх загальний вигляд менш точний. Використання їх спільно дає найкращі результати генерації зображень у нашій моделі.’
Переривання та доповнення процесу дифузії
Стаття зазначає, що типова модель латентної дифузії починає свій шлях від чистого шуму до зображення, спираючись виключно на текст на ранніх стадіях генерації.
Коли шум розв’язується у якийсь вид приблизного макету, що представляє опис у текстовій підказці, текстово-керований аспект процесу фактично відпадає, а процес переймає до доповнення візуальних ознак.
Це означає, що будь-який елемент, який не був розв’язаний на початковій стадії текстово-керованої інтерпретації шуму, важко ввести до зображення пізніше, оскільки два процеси (текст-у-макет і макет-у-зображення) мають відносно мало перетину, а базовий макет досить заплутаний до моменту його появи у процесі доповнення зображення.

Зі статті: карти уваги різних частин процесу під час переходу від шуму до зображення. У нижньому рядку видно різке падіння впливу CLIP, тоді як T5 впливає на зображення значно довше у процесі генерації.
Професійний потенціал
Приклади на сторінці проекту та відео на YouTube зосереджені на генерації мемних зображень. Як зазвичай, дослідження NVIDIA занижує потенціал своєї останньої інновації для поліпшення фотореалістичного або VFX-потоку, а також її потенціал для покращення глибоких фейків та відео.
У прикладах аматор або новачок малює приблизні контури розміщення для конкретного елемента, тоді як у більш систематичному VFX-потоці можна використовувати eDiffi для інтерпретації декількох кадрів відеоелемента за допомогою текст-у-зображення, де контури дуже точні та засновані, наприклад, на фігурах, де фон було видалено за допомогою зеленого екрана або алгоритмічних методів.

Runway ML уже надає ротоскопію на основі ШІ. У цьому прикладі зелений екран навколо об’єкта позначає альфа-шар, а виокремлення виконане машинним навчанням, а не алгоритмічним видаленням справжнього зеленого фону. Джерело: https://twitter.com/runwayml/status/1330978385028374529
Використовуючи навченого персонажа DreamBooth та зображення-у-зображення з eDiffi, потенційно можливо почати вирішувати одну з проблем будь-якої моделі латентної дифузії: часову стабільність. У такому випадку обидві межі накладеного зображення та вміст зображення будуть «заповнені» проти користувацького полотна, з часовою безперервністю відтвореного вмісту (тобто перетворення реального практика тай-чі у робота) за допомогою використання закріпленої моделі DreamBooth, яка «запам’ятала» свої тренувальні дані – погано для інтерпретації, але добре для репродуктивності, вірності та безперервності.
Метод, дані та тести
Стаття зазначає, що модель eDiffi була тренована на «збірці публічних та власних даних», сильно відфільтрованих попередньо тренованою моделлю CLIP, щоб видалити зображення, які можуть знижувати загальний естетічний бал зображення. Остаточний фільтрований набір зображень складається з «близько одного мільярда» пар текст-у-зображення. Розмір тренованих зображень описується як «з найбільш коротким боком більше 64 пікселів».
Було треновано декілька моделей для процесу, з основною та супер-розрішенням моделей, тренованими на оптимізаторі AdamW з швидкістю навчання 0,0001, з ваговим спадом 0,01, та на величезному розмірі пакету 2048.
Базова модель була тренована на 256 графічних процесорах NVIDIA A100, а дві супер-розрішенні моделі – на 128 графічних процесорах NVIDIA A100 для кожної моделі.
Система була заснована на власній бібліотеці PyTorch Imaginaire від NVIDIA. Дані з COCO та Visual Genome були використані для оцінки, хоча не були включені до остаточної моделі, з MS-COCO як конкретним варіантом, використаним для тестування. Системами-суперниками були GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion, а також дві системи синтезу зображень Google — Imagen та Parti.
Відповідно до подібних попередніх робіт використовували метрику zero-shot FID-30K. Під час FID-30K 30 000 підписів були витягнуті випадково з валідаційної вибірки COCO (тобто не зображень чи тексту, використаних у тренуванні), які потім були використані як текстові підказки для синтезу зображень.
Відстань Fréchet Inception (FID) між згенерованими та реальними зображеннями була потім обчислена, а також було записано оцінку CLIP для згенерованих зображень.

Результати тестів zero-shot FID проти сучасних підходів на валідаційній вибірці COCO 2014, з нижчими результатами краще.
У результатах eDiffi змогла отримати найнижчий (найкращий) бал за zero-shot FID навіть проти систем з значно більшим числом параметрів, таких як 20 мільярдів параметрів у Parti, порівняно з 9,1 мільярдами параметрів у моделі eDiffi з найвищими специфікаціями, тренованої для тестів.
Висновок
Модель дифузії eDiffi від NVIDIA представляє бажану альтернативу простому додаванню все більшої кількості даних та складності до існуючих систем, використовуючи більш інтелектуальний та шаруватий підхід до деяких з найскладніших перешкод, пов’язаних з заплутуванням та неможливістю редагування у латентних дифузійних генеративних системах зображень.
Вже є обговорення на субреддіті та Дискорді Stable Diffusion про те, чи можна безпосередньо включити будь-який код, який може бути доступний для eDiffi, або ж повторно реалізувати принципи, що лежать в її основі, у окремій реалізації. Однак новий процес значно відрізняється, тому його впровадження становитиме цілу версію зміни для SD, відмовившись від деякої зворотної сумісності, але пропонуючи можливість значно покращеного контролю над остаточними згенерованими зображеннями, не жертвуючи захоплюючими уявними силами латентної дифузії.
Перша публікація 3 листопада 2022 року.


