Yapay zeka temelleri
Derin Pekiştirmeli Öğrenme Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
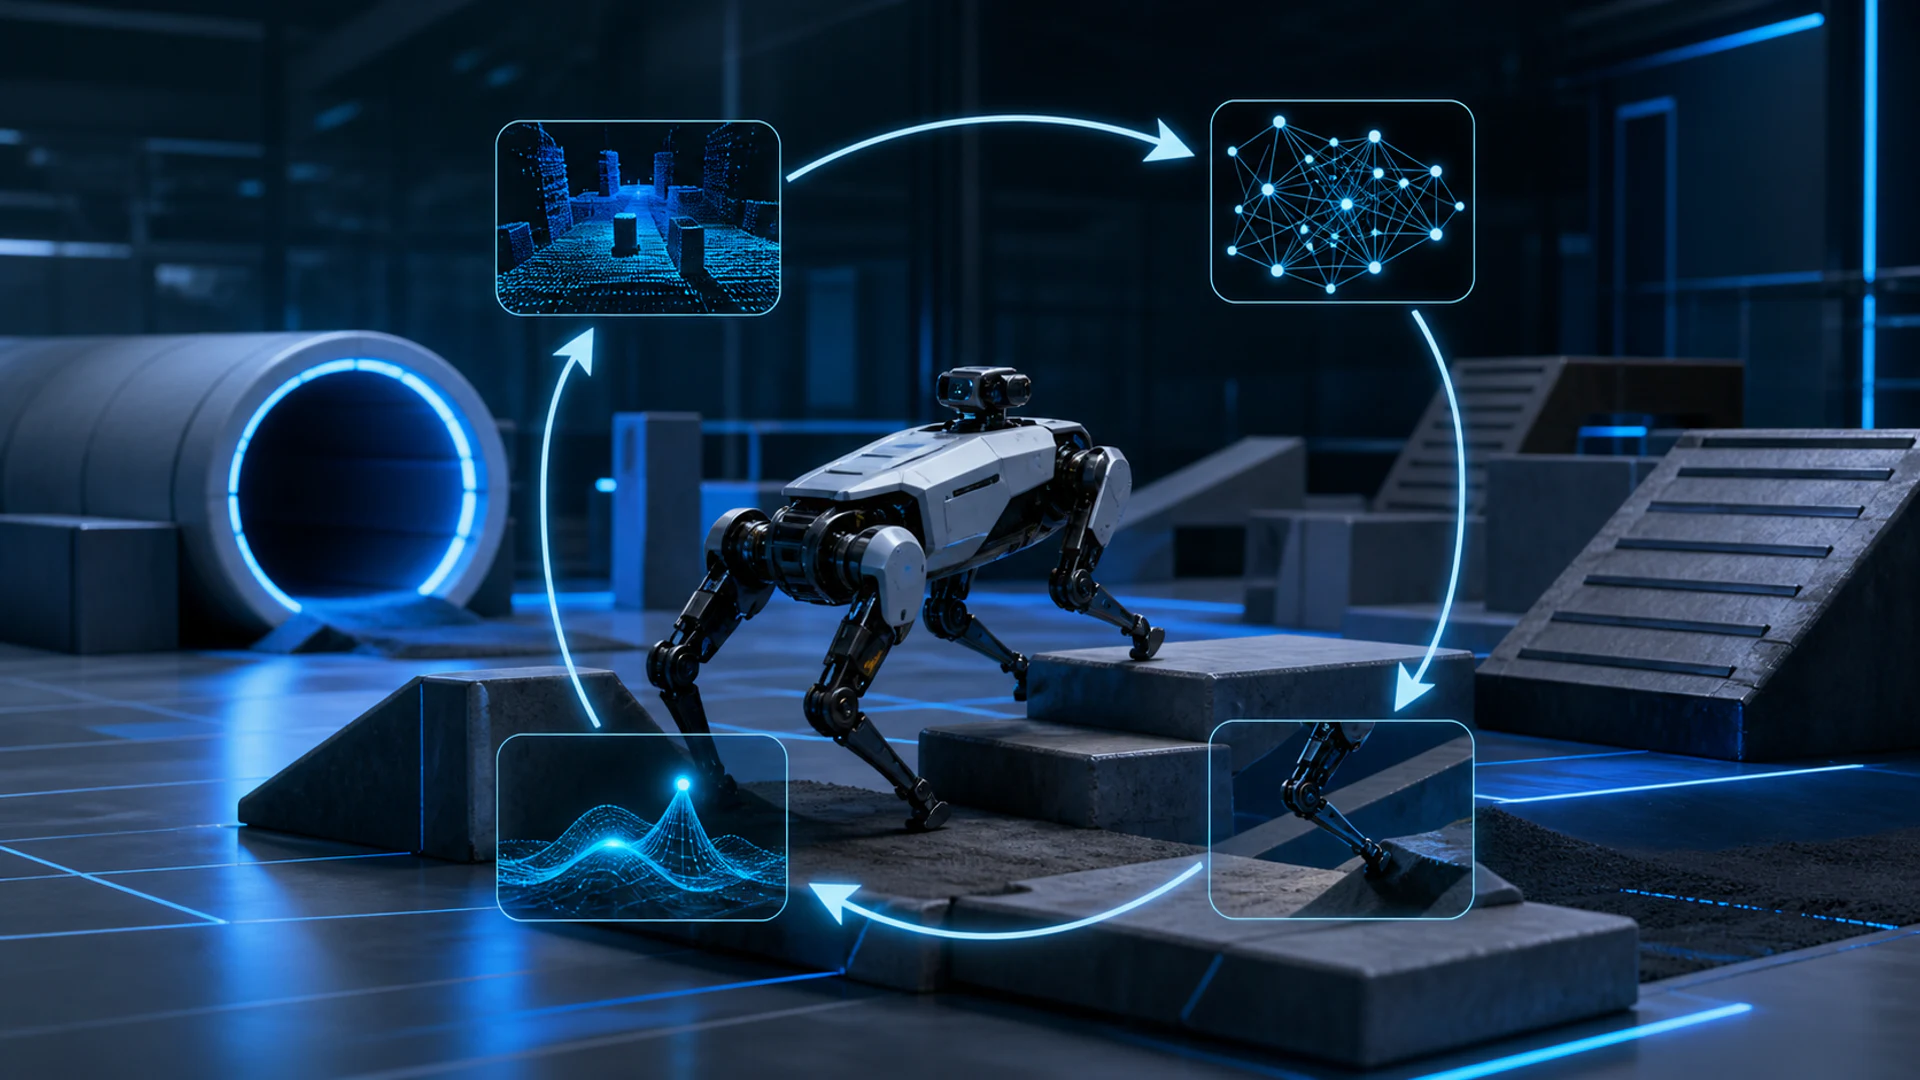
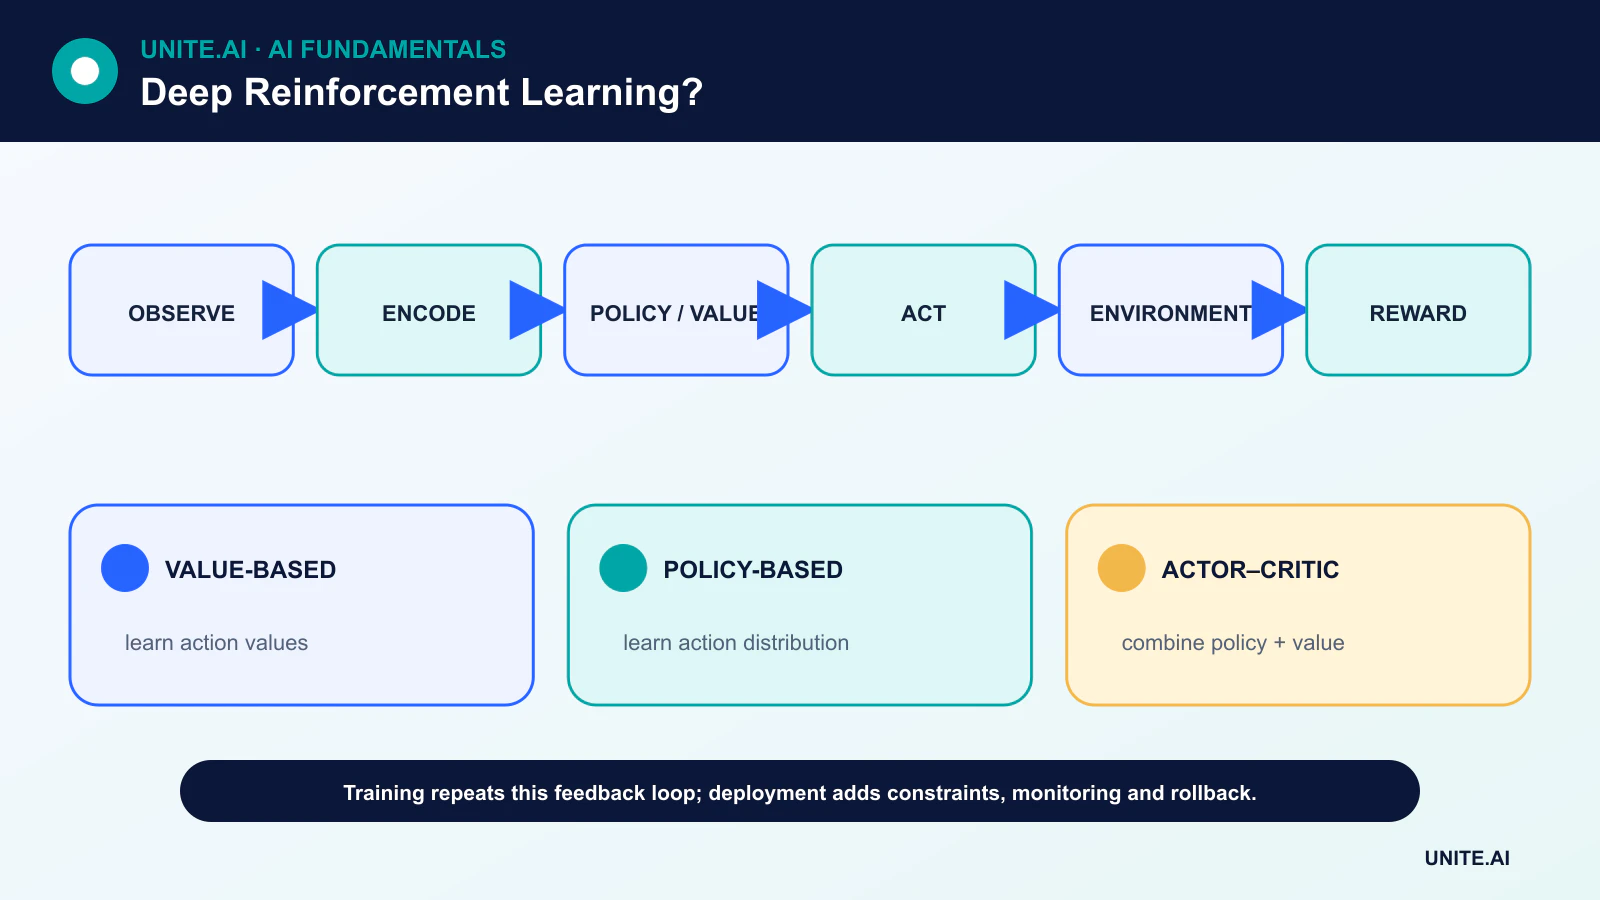
Derin pekiştirmeli öğrenme (derin RL) pekiştirmeli öğrenmeyi derin sinir ağlarıyla birleştirir. Bir ajan bir durumu gözlemler, bir eylem seçer, bir ödül ve yeni bir gözlem alır, ardından gelecekteki kararları iyileştirmek için politika ya da değer fonksiyonunu ayarlar.
Derin ağ, pekiştirmeli öğrenmenin zorlu yönlerini ortadan kaldırmaz. Görüntüler, sensör akışları, büyük eylem alanları veya karmaşık değer fonksiyonlarını temsil etmenin esnek bir yolunu sunar. Keşif, gecikmeli kredi, istikrarsız eğitim ve güvenli gerçek‑dünya değerlendirmesi hâlâ temel mühendislik sorunlarıdır.
Temel Çıkarımlar
- Derin RL, etkileşimden sıralı kararlar öğrenir; sabit bir etiketli örnek tablosundan değil.
- Değer‑tabanlı yöntemler eylemlerin ne kadar iyi olduğunu tahmin eder; politika yöntemleri eylem dağılımını doğrudan öğrenir; aktör‑eleştirmen yöntemleri ise ikisini birleştirir.
- Replay tamponları, hedef ağlar ve dikkatli ödül tasarımı eğitimi iyileştirebilir, ancak hiçbiri güvenilir davranışı garanti etmez.
- Güçlü bir simülatör skoru, sağlamlık, güvenlik veya fiziksel dünyaya başarılı transferin kanıtı değildir.
Karar Problemi: durumlar, eylemler ve ödüller
Birçok derin‑RL görevi Markov karar süreci olarak modellenir. t zamanında ajan, s_t durumunu veya gözlemini alır, a_t eylemini seçer, ardından r_{t+1} ödülünü ve sonraki durumu alır. Amaç, yalnızca bir sonraki ödül değil, beklenen iskonto edilmiş getiridir.
İskonto faktörü, uzak ödüllerin ne kadar etkili olduğunu kontrol eder. Bir ödül fonksiyonu, optimizasyon sürecinin neyi hedefleyeceğini tanımlar; bu nedenle eksik bir vekil, teknik olarak başarılı ama operasyonel olarak istenmeyen davranışlar üretebilir. Bu, ödül tasarımı ve kısıtlama testlerinin model mimarisi kadar özen gerektirdiği nedenlerden biridir.
Değer‑tabanlı, politika‑tabanlı ve aktör‑eleştirmen yöntemleri
Değer‑tabanlı bir algoritma, bir durum değeri ya da eylem değeri tahmin eder. Derin Q‑ağları, Q‑değerlerini yaklaşık olarak temsil etmek için bir sinir ağı kullanır ve genellikle bazı keşifleri koruyarak en yüksek tahmini yapan eylemi seçer. Politika‑gradyan algoritması ise bir eylem dağılımı üreten parametreli bir politikayı optimize eder.
Aktör‑eleştirmen sistemleri, eylemler öneren bir aktör ve bunların değerini tahmin eden bir eleştirmen içerir. Bu tasarım sürekli kontrolü destekler ancak etkileşimli tahmin hatası kaynakları getirir. Derin RL bu nedenle derin öğrenme, gradyan inişi ve geri yayılım gibi aynı temellere dayanır.
Replay tamponları ve hedef ağların neden yardımcı olduğu
Ardışık deney örnekleri birbirine bağlıdır, oysa bir ağ güncellemesi sonraki güncellemeler tarafından kullanılan hedefleri değiştirir. Deneyim tekrar oynatma, eski geçişleri örnekleyerek bu zamansal korelasyonu bir ölçüde kırar. Hedef ağ, çevrimiçi ağa göre daha yavaş değişir ve böylece önyüklemeli hedeflerin volatilitesini azaltır.
Bu mekanizmalar eğitim kararlılığını artırır, ancak ayarlama hâlâ önemlidir. Öğrenme hızı, keşif takvimi, ödül ölçeği, replay bileşimi ve ağ kapasitesi sonuca etki edebilir. Tek bir çalışmanın yanıltıcı olabileceği için birden fazla rastgele tohum raporlanmalıdır.
Çevrimdışı RL, model‑tabanlı RL ve sim‑gerçek transferi
Çevrimdışı RL, yeni etkileşimler toplamayarak sabit bir kayıtlı veri kümesinden öğrenir. Keşif maliyetli veya güvensiz olduğunda faydalı olabilir, ancak politika kayıtta yetersiz temsil edilen eylemlerden kaçınmalıdır. Model‑tabanlı RL, planlama için bir geçiş modeli öğrenir ya da kullanır; ek varsayımları örnek verimliliği karşılığında takas eder.
Robotik genellikle simülasyonda eğitilir, fiziksel parametreleri rastgeleleştirir ve ardından donanımda ince ayar yapar ya da doğrular. Gerçeklik boşluğu hâlâ algı, zamanlama, temas dinamiği ve modellenmemiş uç durumlarda hataları ortaya çıkarabilir. Bir pekiştirmeli‑öğrenme sistemi, bozulmalar, dağılım kayması ve açık güvenlik kısıtlamaları altında değerlendirilmelidir.
Değerlendirme ve dağıtım
Yararlı bir değerlendirme, eğitim ve test ortamlarını ayırır, yalnızca en iyi skoru değil, getiri dağılımlarını raporlar ve kısıtlama ihlallerini, müdahale sıklığını ve en kötü durum davranışını kontrol eder. Gerçek sistemler için ekiplerin izleme, geri alma prosedürleri, sınırlı eylem alanları ve insan müdahalesi de gereklidir.
Derin RL, kararlar sıralı olduğunda, geri bildirim mevcut olduğunda ve el yazısı kontrol kuralları yetersiz olduğunda en çekici seçenektir. Gözetimli etiketler bol olduğunda, geleneksel bir optimizasyon problemi çözdüğünde ya da keşif insanların ya da varlıkların risk altına girmesine neden olacağında ise zayıf bir varsayılandır.
Derin RL mimarileri ve eğitim sinyalleri
Derin pekiştirmeli öğrenme, bir değer fonksiyonu, politika, ortam modeli veya bunların bir kombinasyonunu temsil etmek için sinir ağları kullanır. Derin Q‑ağı, eylem değerlerini tahmin eder ve zamansal fark hedeflerinden öğrenir; deneyim tekrar oynatma güncellemeler arasındaki korelasyonu azaltırken, hedef ağ hareketli hedefi istikrara kavuşturur. Politika‑gradyan yöntemleri beklenen getiriyi doğrudan optimize eder ve aktör‑eleştirmen yöntemleri, gradyan varyansını azaltmak için öğrenilmiş bir eleştirmen kullanır. Sürekli eylemler genellikle deterministik ya da stokastik aktör‑eleştirmen varyantları gerektirirken, ayrık yüksek‑boyutlu eylemler dikkatli keşif ve çıktı tasarımı ister.
Eğitim, politikanın topladığı verileri değiştirmesi nedeniyle durağan değildir. Replay verileri off‑policy hâle gelir, önyüklemeli hedefler mevcut tahminlere bağlıdır ve fonksiyon yaklaştırması hataları artırabilir — bu kombinasyona bazen ölümcül üçlü denir. Çift tahminciler değer aşırı tahminini azaltır; avantaj fonksiyonları kredi atamasını iyileştirir; entropi bonusları keşfi teşvik eder; kırpılmış hedefler yıkıcı politika güncellemelerini sınırlamaktadır. Gözlemleri ve ödülleri yalnızca sızıntı‑güvenli durumla normalleştirin ve ortam, sarmalayıcı, eylem tekrarı, sonlandırma ve ödül ön işleme kaydedin; çünkü her biri problemi değiştirir.
Değerlendirme, simülatörler ve dağıtım güvenliği
En iyi çalışmayı değil, bağımsız tohumlar ve ortam örnekleri arasında getiri dağılımlarını raporlayın. Örnek verimliliğini, kısıtlama ihlallerini, felaket sonuçları, ödül ölçeğine duyarlılığı ve gözlem gürültüsü, gecikme, aktüatör hatası ve değişen dinamiklere karşı dayanıklılığı değerlendirin. Scriptli kontrol, klasik kontrol, gözetimli taklit ve daha basit RL ile karşılaştırın. Ortam varyasyonlarını dışarıda tutun ve ödülsüz sonuç ölçütlerini test edin; çünkü bir ajan, amaçlanan görevi başaramasa da programlanmış ödülü suistimal edebilir. Video ve yol izleme, toplu getiri tarafından gizlenen davranışları sıklıkla ortaya çıkarır.
Simülasyon keşfi mümkün kılar ancak bir gerçeklik boşluğu getirir. İlgili fizik ve algıyı rastgeleleştirin, gerçek ölçümlerle kalibre edin ve temkinli bir transfer kullanın. Kayıtlı veri veya çevrimdışı RL, çevrimiçi keşiften kaçınır ancak davranış politikasının desteklemediği eylemleri güvenilir bir şekilde değerlendiremez. Üretim sistemleri eylem setini, hızı, kaynakları ve çalışma aralığını sınırlamalı; yüksek etkili eylemler için onay gerektirmeli; ve doğrulanmış güvenli bir kontrolör veya durdurma mekanizması içermelidir. Politika girdilerini, eylem dağılımını, ödülü, gerçek sonuçları ve müdahaleleri izleyin; test edilmiş bir politika sürümüne geri dönmeyi sağlayın.
Somut bir kontrol örneği
Depo robotu yönlendirmesi için durum, konum, yük, pil, yakın trafiği ve görev kuyruğundan tanımlanır; eylemler izin verilen hareketler ve şarj kararlarından; ödül ise tamamlanan iş, enerji, sıkışıklık ve güvenlik kısıtlamalarından elde edilir. İlk olarak rastgele talep ve sensör hatalarıyla kalibre edilmiş bir simülatörde eğitin, ardından gerçek kararları gölgeleyin. Öğrenilen politikanın çarpışma önlemesini atlamasına asla izin vermeyin. Verimliliği, yakın kaçırmalar, kilitlenmeler, pil acil durumları ve en kötü gecikme ile birlikte değerlendirin. Proje, katmanlı sistem operasyonları iyileştiriyorsa ve kabul edilemez keşif riskini insanlara veya ekipmana aktarmıyorsa başarılı olur.
Uygulamalı örnek: Veri merkezi soğutması için DRL
Bir veri merkezi, RL ajanını onaylanmış soğutma ayarlarına sınırlayarak, geçmiş hava durumu, iş yükü, sıcaklıklar ve ekipman tepkisinden kalibre edilmiş bir simülatörde eğitir. Ödül, enerjiyi içerir ancak katı kısıtlamalar ayrı ayrı sıcaklık, nem ve ekipman döngüsünü korur. Model‑tahminli kontrol ve mevcut kurallar temel referanslardır. Değerlendirme, mevsimler, sensör gürültüsü, aktüatör gecikmesi, ekipman kaybı, alışılmadık yükler ve birden çok tohum boyunca yürütülür; enerji, ihlaller, varyans ve iyileşme raporlanır.
Öğrenilen politika, sınırlı bir bölge denemesinden önce gölge modda çalıştırılır. Harici bir güvenlik kontrolörü eylemleri keser ve operatörler devreye girebilir. Eylem hızı, durum kapsama alanı, model belirsizliği ve gerçek tesis sonuçları izlenir; simülatör uyumsuzluğu veya tekrarlanan müdahale geri almayı tetikler. Güncellenen ekipman veya kontrol mantığı yeni bir ortam sürümü ve doğrulama oluşturur. Enerji tasarrufu, güvenilirlik, termal marj, bakım ve arızalara yanıt, temel referans kadar güçlü olduğunda kabul edilir.
Uygulama kanıtları ve operasyonel hazırlık
Bir üretim kararı, sadece başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, işletim ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce yeniden üretilebilir bir temel ve sürümlendirilmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve hizmet dışı kalma ihtimali yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlikle birlikte ölçün. Bağımsız bir gözden geçiricinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamadan girdi kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve onaylanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından çevrimdışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek dünya kanıtlarını gözden geçirin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Bakımı yapılan bir sistem, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Derin pekiştirmeli öğrenme, derin öğrenme ile aynı mıdır?
Hayır. Derin öğrenme fonksiyon yaklaştırıcılarını sağlar; pekiştirmeli öğrenme ise etkileşimi, ödülü ve sıralı karar hedefini sağlar.
Yüksek bir ödül, ajanın istenen davranışı öğrendiği anlamına mı gelir?
Mutlaka değil. Bu, politikanın uygulanan ödül ve ortam altında iyi puan alan bir davranış bulduğu anlamına gelir. Bağımsız güvenlik ve hedef‑uyum testleri hâlâ gereklidir.
Temel Referanslar