Yapay zeka temelleri
Pekiştirmeli Öğrenme Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
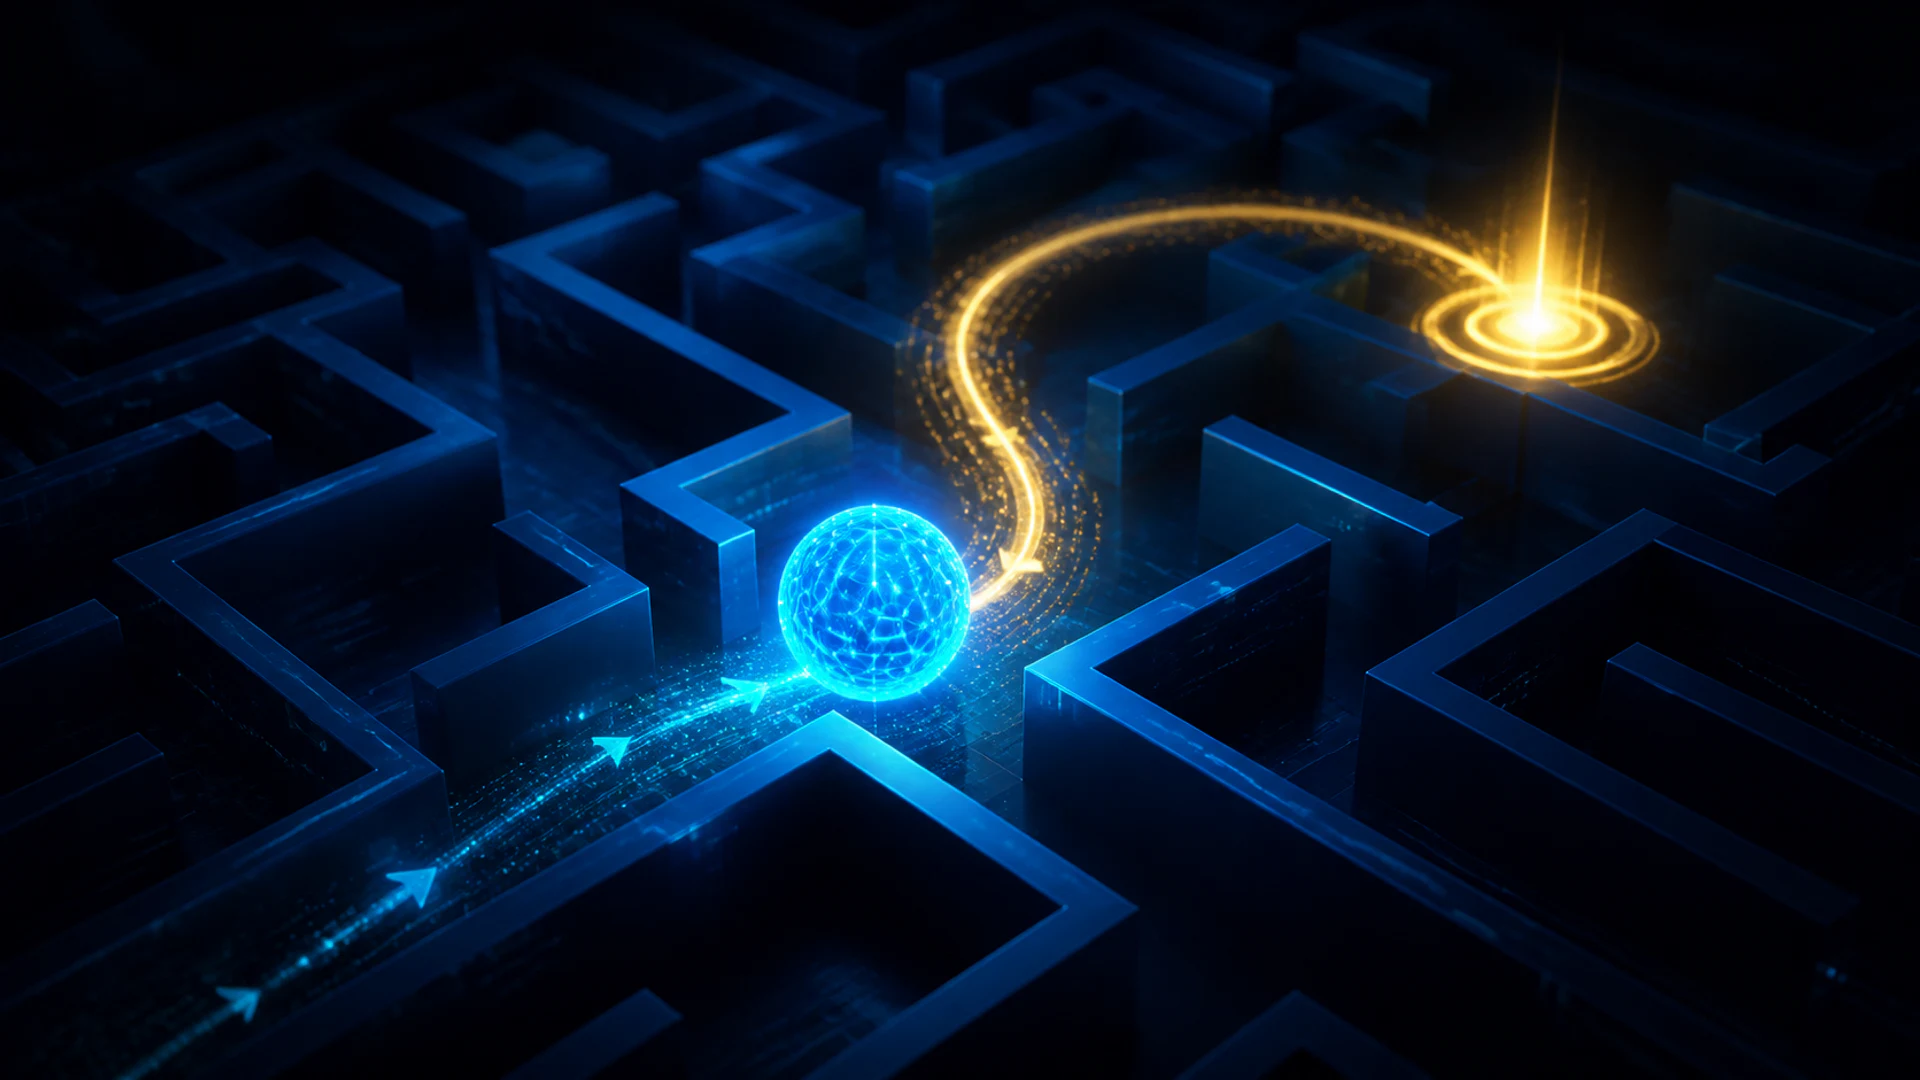
Pekiştirmeli öğrenme (RL), bir ajanın bir ortamla etkileşime girerek nasıl davranacağını öğrendiği bir makine‑öğrenmesi çerçevesidir. Her eylemden sonra ortam değişir ve bir ödül verebilir. Ajana hedefi, yalnızca bir sonraki hamlesinden elde edilen ödül değil, beklenen toplam ödülü maksimize eden bir politika öğrenmektir.
RL, kararların zaman içinde geliştiği ve bir eylemin sonrasını etkilediği durumlarda kullanılır. Denetimli öğrenme‘den kavramsal olarak farklıdır; denetimli öğrenmede bir veri kümesi her eğitim örneği için hedef yanıt sağlar.
Temel Çıkarımlar
- Bir RL problemi bir ajan, ortam, durumlar, eylemler, ödüller ve bir politika içerir.
- Olumlu ve olumsuz pekiştirme her ikisi de davranışı artırır; ceza davranışı azaltır.
- Ajan, bilinmeyen eylemleri keşfetmek ile zaten işe yaradığı bilinen eylemleri kullanmak arasında denge kurmalıdır.
- Değer‑tabanlı, politika‑tabanlı, aktör‑eleştirmen, model‑tabanlı ve çevrim‑dışı yöntemler farklı RL ortamlarını çözer.
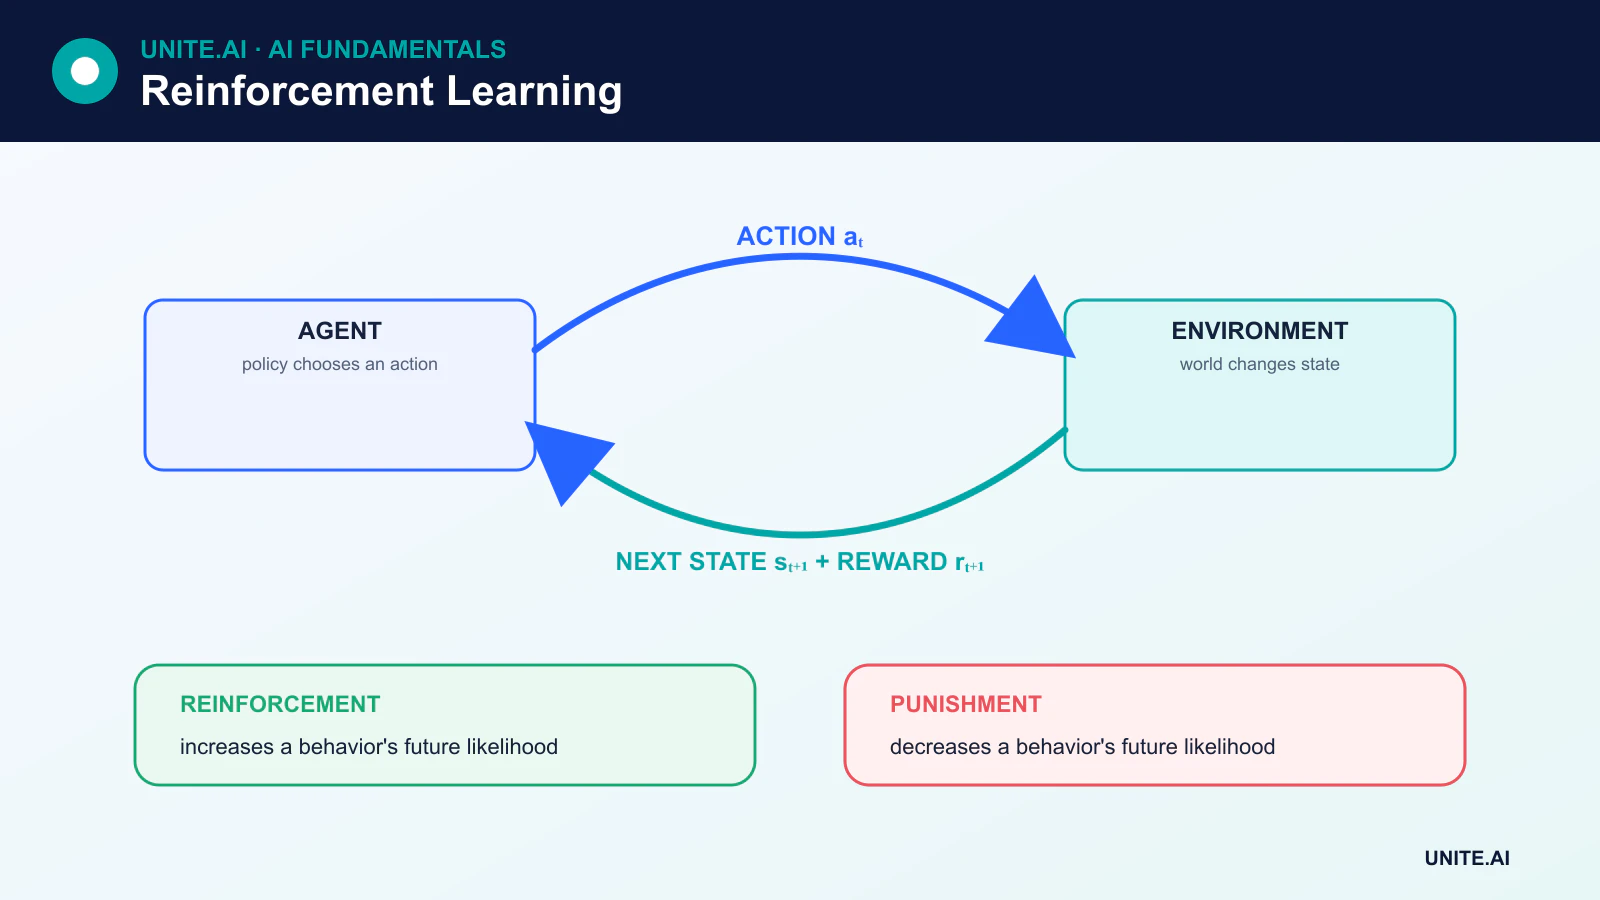
Pekiştirmeli öğrenmenin bileşenleri
Birçok RL problemi Markov karar süreci (MDP) olarak modellenir. Bir MDP şunları içerir:
- Durum: mevcut durumu tanımlayan bilgi.
- Eylem: ajana sunulan bir seçenek.
- Geçiş: bir eylem sonrasında durumun nasıl değiştiği.
- Ödül: bir geçiş tarafından üretilen anlık geri bildirim.
- Politika: ajanın eylemleri seçme stratejisi.
- İndirim faktörü: gelecekteki ödüllerin anlık ödüllere göre ne kadar sayıldığı.
Bir durum, dünya hakkında her şeyi ortaya koymak zorunda değildir. Önemli bilgiler gizli olduğunda, problem kısmen gözlemlenebilir olabilir ve ajan bir bellek ya da inanç durumu gerektirebilir.
Pekiştirme ceza ile aynı değildir
Terimler davranış psikolojisinden gelir. Olumlu pekiştirme, bir davranışı daha olası kılan bir sonuç ekler. Olumsuz pekiştirme, hoş olmayan bir koşulu ortadan kaldırır ve aynı şekilde davranışı daha olası kılar. Bir eylemi daha az olası hâle getirmeyi amaçlayan ceza, negatif pekiştirme değildir; ceza olarak adlandırılır.
Makine öğreniminde, uygulayıcılar daha sık doğrudan olumlu ödüller, olumsuz ödüller, maliyetler ve cezalar hakkında konuşur. Önemli husus, bu sinyallerin ajanın maksimize etmeye çalıştığı getiriyi nasıl şekillendirdiğidir.
Getiri, değer ve sorumluluk ataması
Bir ödül tek bir geçişi tanımlar. Getiri, zaman içinde ödülleri birleştirir ve genellikle daha uzak gelecekte gelen ödülleri indirgeyerek hesaba katar. Durum‑değer fonksiyonu, bir durumdan beklenen getiriyi tahmin ederken, eylem‑değer fonksiyonu, o durumdaki belirli bir eylemi takiben beklenen getiriyi tahmin eder.
Bu, sorumluluk‑atama sorununu ortaya çıkarır: faydalı bir sonuç çok daha sonra ortaya çıkarsa, hangi erken eylemler kredi almalı? RL algoritmaları bu ilişkiyi tahmin etme biçimlerinde farklılık gösterir.
Monte Carlo ve zaman‑farklılığı öğrenmesi
Monte Carlo yöntemleri, genellikle bir bölüm (episode) sona erdikten sonra tam örneklenmiş getirilerden öğrenir. Zaman‑farklılığı (TD) yöntemleri, gözlemlenen ödülü sonraki tahminle birleştirerek nihai sonuç gelmeden bir tahmini günceller. Bu nedenle TD öğrenmesi, mevcut değer tahminlerinden kendini besler.
Hiçbir yöntem ailesi evrensel olarak daha iyidir diyemez. Monte Carlo hedefleri, örneklenen politika altında yanlılıksızdır ancak yüksek varyans gösterebilir ve bölümün tamamlanmasını gerektirir. TD yöntemleri çevrimiçi ve sürekli görevlerden öğrenebilir, fakat kendini besleyen hedefleri yanlılık ekler.
Keşif ve sömürü
Keşif, değeri belirsiz eylemleri deneyerek bilgi toplar. Sömürü, şu anda en iyi getiriyi sunacağına inanılan eylemi seçer. Hiç keşif yapmayan bir ajan kötü bir stratejiye yerleşebilir; hiç sömürme yapmayan bir ajan ise öğrendiklerinden faydalanamaz.
Basit stratejiler arasında epsilon‑açgözlü eylem seçimi, güvene dayalı keşif, entropi bonusları ve içsel‑ödül yöntemleri bulunur. Güvenlik‑kritik ortamlarda, sınırsız keşif kabul edilemez olabilir; bu yüzden simülasyon, kısıtlamalar, çevrim‑dışı veri veya insan denetimi önem kazanır.
Temel pekiştirmeli öğrenme yaklaşımları
Değer‑tabanlı yöntemler
Q‑öğrenme ve ilgili algoritmalar eylem değerlerini öğrenir ve yüksek değerli eylemleri seçerek bir politika türetir. Derin pekiştirmeli öğrenme, durum uzayları tablo için çok büyük olduğunda değer fonksiyonlarını veya politikaları yaklaştırmak için sinir ağları kullanır.
Politika‑gradyan yöntemleri
Politika‑gradyan yöntemleri, beklenen getiriyi artırmak için parametreli bir politikayı doğrudan ayarlar. Sürekli eylemler ve stokastik politikalar için faydalıdırlar ancak yüksek varyanslı gradyan tahminlerine sahip olabilirler.
Aktör‑eleştirmen yöntemleri
Bir aktör eylemleri seçerken bir eleştirmen değeri tahmin eder ve öğrenme sinyali sağlar. Bu, doğrudan politika optimizasyonunu değer tahminiyle birleştirir.
Model‑tabanlı ve model‑serbest RL
Model‑tabanlı sistemler, planlama yapabilmek için geçiş ve ödül modelleri öğrenir ya da kullanır. Model‑serbest sistemler, ortamı açıkça modellemeden değerleri veya politikaları öğrenir. Model‑tabanlı yöntemler deneyimi verimli kullanabilir, ancak öğrenilen modeldeki hatalar planlamayı yanıltabilir.
Çevrim‑dışı pekiştirmeli öğrenme
Çevrim‑dışı RL, eğitim sırasında yeni etkileşimler toplamak yerine sabit bir veri kümesinden öğrenir. Keşif maliyetini veya riskini azaltabilir, ancak ajan veride zayıf temsil edilen eylemleri aşırı tahmin etmemelidir.
RLHF ve insan tercihleri
İnsan geri bildiriminden pekiştirmeli öğrenme (RLHF), bir ödül sinyali eğitmek ya da doğrudan bir politika optimize etmek için tercih verilerini kullanır. Dil modeli davranışını insan yargılarıyla uyumlu hâle getirmek için kullanılmıştır. Tercih optimizasyonu, doğruluk veya güvenliğin garantisi değildir: sonuçlar geri bildirimi sağlayanın kim olduğuna, neyin değerlendirildiğine ve hedefin nasıl tasarlandığına bağlıdır.
Sınırlamalar
RL, çok büyük sayıda etkileşim gerektirebilir, eğitim sırasında istikrarsız davranabilir ve bir ödül fonksiyonundaki istenmeyen kestirme yolları kullanabilir. Değerlendirme zordur çünkü sonuçlar rastgele tohumlar ve ortam detaylarıyla değişebilir. İyi uygulamalar arasında birden fazla çalıştırma, şeffaf temel modeller, kısıtlı hedefler, dağılımdan dışı testler ve ödül manipülasyonunu izleme bulunur.
RL problemi tasarlamak: durum, eylem, ödül ve ufuk
Pekiştirmeli öğrenme, ardışık kararları modeller. Ortam bir gözlem üretir, ajan bir politika çerçevesinde eylem seçer ve bir geçiş ödül ve sonraki gözlemi verir. Markov karar süreci, durumun gelecekteki geçişleri ve ödülleri tahmin etmek için gereken bilgiyi içerdiğini varsayar; kısmi gözlemlenebilirlik bellek, inanç durumu veya yinelemeli temsiller gerektirir. İndirim, gecikmiş sonuçların ağırlığını kontrol eder, bölümlü ve sürekli görevler ise farklı getiri tanımları gerektirir. Kötü durum veya eylem tasarımı, çözülebilir bir hedefi öğrenilemez hâle getirebilir.
Ödül tasarımı, davranışı dolaylı olarak belirler ve büyük bir başarısızlık kaynağıdır. Bir vekil suistimal edilebilir: hıza göre ödüllendirilen bir ajan güvenliği göz ardı edebilir, görev tamamlandığında yalnızca ödüllendirilen bir ajan ise çok az öğrenme sinyali alabilir. Gerçek gereksinimlere dayalı kısıtlamalar ve sonlandırma kuralları ekleyin, ödül duyarlılığını test edin ve istenmeyen stratejiler için yörüngeleri inceleyin. Keşif yöntemleri, bilgi toplama ile mevcut bilgiyi sömürme arasında denge kurar. Politik dışı veriler örnek verimliliğini artırabilir, ancak davranış ve hedef politika arasındaki uyumsuzluk buna yönelik algoritmalar gerektirir.
Değerlendirme, simülasyon ve güvenli dağıtım
Değer‑tabanlı yöntemler, durumlar veya eylemler için beklenen getiriyi tahmin eder; politika‑gradyan yöntemleri parametreli bir politikayı optimize eder; aktör‑eleştirmen yöntemleri her ikisini de öğrenir. Model‑tabanlı RL, planlama için geçiş dinamiklerini öğrenir ya da kullanır. Uygun yöntem ailesi, eylem tipi, veri, simülatör doğruluğu, ufuk ve istikrar gereksinimlerine bağlıdır. Heuristik, denetimli ve kontrol‑teorisi temel modelleriyle karşılaştırın. Ortalama ve en kötü durum getirisi, kısıtlama ihlalleri, örnek verimliliği, ortam değişikliklerine karşı dayanıklılık ve tohumlar arasındaki varyans gibi ölçütleri değerlendirin; en iyi öğrenme eğrisine sahip çalışmayı seçmek yerine.
Sağlık, finans, robotik ve altyapı gibi alanlarda çevrimiçi keşif kabul edilemez olabilir. Mümkün olduğunda simülasyonda veya kaydedilmiş verilerde eğitin, simülatör‑gerçeklik farkını ölçün ve görülmemiş eylemlerin desteği olmadığından çevrim‑dışı değerlendirmeyi dikkatli kullanın. Dağıtım, eylem, hız, kaynak ve çalışma bölgesini sınırlamalı; sonuçları etkileyen seçimler için insan onayı içermeli ve güvenli bir kontrolör veya kapatma mekanizması sağlamalıdır. Ödülü gerçek sonuçlarla izleyin; çünkü bir ajan puanını artırırken amaçlanan hedefe zarar verebilir. Ortam, politika veya ödül değişikliklerinden sonra yeniden doğrulama yapın.
Uygulamalı örnek: enerji kontrolü için pekiştirmeli öğrenme
Bir bina operatörü, sıcaklık, doluluk, hava durumu, ekipman durumu ve elektrik fiyatını modeller; eylemler güvenli ayar noktası ayarlamalarıyla sınırlıdır. Ödül, konfor, enerji, talep ücretleri ve ekipman kısıtlamalarını birleştirir, ancak gerçek konfor ihlalleri ayrı olarak değerlendirilir, böylece ödül optimizasyonu zararı gizleyemez. Tarihsel kontrol ve model‑tahminli kontrol temel modeller sağlar. Eğitim, rastgeleleştirilmiş hava durumu, sensör gürültüsü ve ekipman verimliliği içeren kalibre edilmiş bir simülatör kullanır.
Bina üzerinde etki yaratmadan önce politika, canlı gözlemler üzerinde eylem yapmadan çalıştırılır. Mühendisler, tatiller, sıcak dalgalar, kesintiler ve eksik sensörler sırasında yörüngeleri, kısıtlama marjlarını ve davranışı inceler. Dağıtım, eylem hızını ve aralığını sınırlar ve mevcut güvenlik kontrolörünü korur. Bir insan her zaman müdahale edebilir. İzleme, enerji ve konforu eşleşen dönemlerle karşılaştırır, müdahaleleri kaydeder ve ihlaller, beklenmeyen döngüler veya model uyumsuzluğu tanımlı eşikleri aşarsa geri alır.
Uygulama kanıtları ve operasyonel hazırlık
Üretim kararı, sadece başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girişleri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve en çok hizmet dışı kalabilecek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir denetçinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve onaylanmış sonuçları ortaya koymalıdır. Uyarı eşikleri ve bir yanıt sorumlusu tanımlayın, ardından dağıtımdan sonra gerçek‑dünya kanıtlarını gözden geçirin; çevrim‑dışı performansın devam edeceğini varsaymayın. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Bakımlı bir sistem, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması veya değiştirilmesi gereken net bir noktayı da gerektirir.
Temel referanslar