
Anderson’un Açısı
UniTune: Google’ın Alternatif Nöral Görüntü Düzenleme Tekniği

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
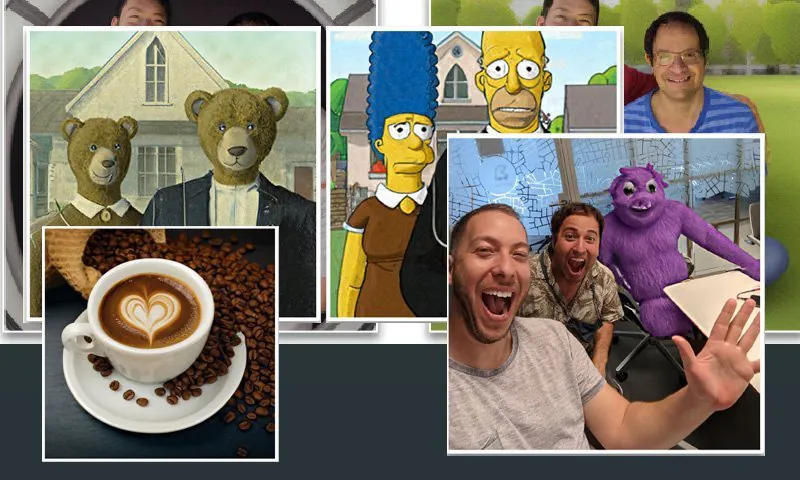
Öne çıkan noktalarUniTune, tek bir görüntü üzerinde bir difüzyon modelini ince ayar yaparak hassas metin…
Daha fazla göster
- UniTune, tek bir görüntü üzerinde bir difüzyon modelini ince ayar yaparak hassas metin odaklı düzenlemelere olanak tanır.
- DreamBooth veya Metinsel Tersine Çevirme'nin aksine UniTune, daha iyi detay koruması için her iki yaklaşımı da reddeder.
- Yöntem, radikal arka plan dönüşümleri sırasında yüzleri bozulmadan tutarak yüksek anlamsal ayrışma elde eder.
Google Araştırma, metin tabanlı görüntü düzenleme konusunda birçok yönden saldırıya geçiyor ve muhtemelen neyin “tutacağını” bekliyor. Bu haftaki Imagic makalesi yayınlandıktan kısa bir süre sonra, arama devi, metin komutları aracılığıyla görüntülerde başka türlü imkansız olan AI tabanlı düzenlemeleri gerçekleştirmek için bir başka laten difüzyon tabanlı yöntem önerdi, bu kez UniTune olarak adlandırıldı.
Projenin yeni makalesinde verilen örneklerde, UniTune’nin anlamsal poz ve fikri gerçek görüntü içeriğinden ayırmada olağanüstü bir düzeye ulaştığı görülmektedir:

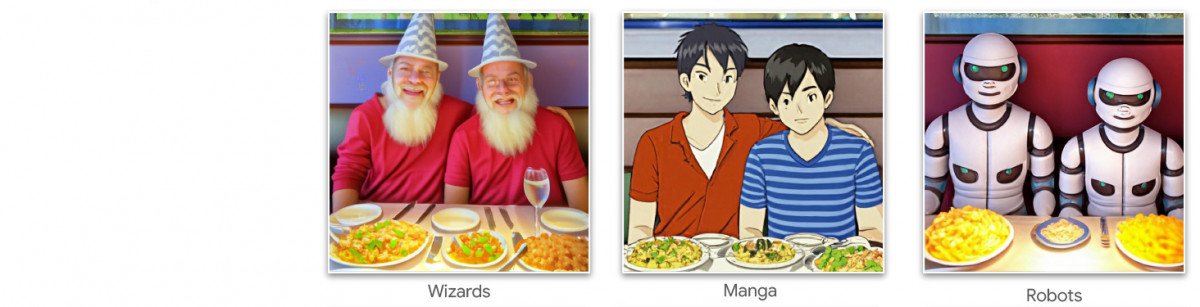

UniTune’nin anlamsal bileşim komutu mükemmel. Üstteki resimlerde, iki kişinin yüzleri, kaynak görüntünün geri kalan kısmında yapılan olağanüstü dönüşüm tarafından bozulmamış. Source: https://arxiv.org/pdf/2210.09477.pdf
Stable Diffusion severleri artık öğrendikleri gibi, bir resmin belirli kısımlarına düzenleme uygulamak ve aynı zamanda geri kalan resmin geri kalan kısmını bozmadan, zor ve bazen imkansız bir operasyon olabilir. Popüler dağıtımlar gibi AUTOMATIC1111, yerel ve kısıtlı düzenlemeler için maskeler oluşturabilir, ancak bu süreç zor ve sık sık öngörülemez.
Açık cevap, en azından bir bilgisayar görüşü uygulayıcısına göre, bir anlamsal segmentasyon katmanı oluşturmak, nesneleri bir görüntüde kullanıcı müdahalesi olmadan tanıyabilen ve izole edebilen bir katman oluşturmaktır ve gerçekten de bu düşünce çizgisinde son zamanlarda birkaç yeni girişim oldu.
Bir başka olanak dağınık ve iç içe geçmiş nöral görüntü düzenleme operasyonlarını kilitlemek için OpenAI’nin etkili Karşılaştırmalı Dil-Görüntü Ön Eğitimi (CLIP) modülünü kullanmaktır, bu modül DALL-E 2 ve Stable Diffusion gibi laten difüzyon modellerinin kalbidir. CLIP, metinden görüntü üreten model yorumladığı görüntüyü kullanıcıya göndermeye hazır olduğunda filtre işlevi görmelidir. Bu bağlamda CLIP bir nöbetçi ve kalite kontrol modülü olarak hareket etmelidir, hatalı veya diğer şekilde uygun olmayan renderları reddetmelidir. Bu, Stability.ai’nin DreamStudio API’sine bağlı portalında (Discord bağlantısı) yakında uygulanacak.
Ancak, CLIP’in bu senaryoda hem suçlu hem de çözüm olması (çünkü temelde görüntünün evrimleşmesi için de bilgilendirdiği için) ve donanım gereksinimlerinin yerel olarak bir son kullanıcıya muhtemelen mevcut olandan daha fazla olması nedeniyle, bu yaklaşım ideal olmayabilir.
Sıkıştırılmış Dil
Önerilen UniTune, var olan bir difüzyon modelini – bu durumda, Google’ın kendi Imagen’i, ancak araştırmacılar bu yöntemin diğer laten difüzyon mimarileriyle uyumlu olduğunu belirtiyorlar – “ince ayarlar” yaparak, metin komutunda çağrılabilen benzersiz bir token enjekte eder.
Yüzeyde, bu DreamBooth gibi görünüyor, şu anda Stable Diffusion severleri ve geliştiricileri arasında bir obsesyondur ve yeni karakterleri veya nesneleri var olan bir kontrol noktasına enjekte edebilir, genellikle sadece birkaç kaynak resimden ve bir saatten az sürede; ya da Textual Inversion gibi, kontrol noktası için “yan arabalar” oluşturur, Bunlar daha sonra orijinal olarak modelin içine eğitilmiş gibi davranılır ve modelin kendi geniş kaynaklarından yararlanarak metin sınıflandırıcısını değiştirerek, modelin kendi kaynaklarından yararlanarak küçük bir dosya (DreamBooth’in en az 2GB’lik budanmış kontrol noktalarına kıyasla) oluşturur.
Aslında, araştırmacılar, UniTune’nin bu yaklaşımları reddettiğini iddia ediyorlar. Textual Inversion’un önemli ayrıntıları atladığını, DreamBooth’un ise sonunda seçtikleri çözüme göre “daha kötü performans gösterdiğini ve daha uzun sürdüğünü” belirtiyorlar.
Bununla birlikte, UniTune, DreamBooth gibi aynı kapsüllü anlamsal “metaprompt” yaklaşımını kullanıyor, eğitilmiş değişiklikler, eğitmen tarafından seçilen benzersiz kelimelerle çağrılıyor, bu kelimeler halihazırda halka açık bir modelde mevcut olan terimlerle çakışmayacak.
QUOTEOPEN‘Düzenleme işlemini gerçekleştirmek için, ince ayarlanmış modelleri “[rare_tokens] edit_prompt” (ör. “beikkpic iki köpek bir restoranda” veya “beikkpic bir minion”) ile örnekleriz.’ QUOTECLOSE
Süreç
Google’ın aynı hafta nihai işlevleri neredeyse aynı olan iki makale yayımlaması şaşırtıcıdır. Ancak çok sayıdaki benzerliğe rağmen UniTune ile Imagic arasında açık bir fark vardır: Imagic, görüntü düzenlemeyi yönlendirmek için “sıkıştırılmamış” doğal dil istemleri kullanırken UniTune, DreamBooth tarzında benzersiz tokenler öğrenir. Imagic ile şu tür bir dönüşüm yapmak isteseydiniz…

UniTune makalesinden: UniTune, Google’ın favori rakip nöral düzenleme çerçevesi SDEdit ile karşılaştırılıyor. Sonuçları en sağda, tahmini maske ise soldan ikinci resimde.
…Imagic’e “arka planda oturan üçüncü kişi, sevimli tüylü bir canavar olarak” yazardınız. Eşdeğer UniTune komutu “Arkadaki adam [x] olarak” olurdu; burada x, tüylü canavar karakteriyle ilişkili ince ayarlanmış kavrama bağlanan tuhaf ve benzersiz sözcüktür. DreamBooth veya Textual Inversion, birçok poza dönüştürülebilen deepfake benzeri bir soyutlama oluşturmak için birden fazla görüntü alırken UniTune ve Imagic tek bir görüntü, yani el değmemiş orijinali alır. Bu, son yıllardaki GAN tabanlı düzenleyicilerin görüntüyü GAN’ın gizli uzayındaki kodlara dönüştürüp kodları değişiklik için başka bölgelere göndermesine benzer; örneğin genç, koyu saçlı birini “yaşlı” veya “sarışın” kodları üzerinden yansıtmak gibi. Ancak bu yöntemle bir difüzyon modelindeki sonuçlar karşılaştırıldığında şaşırtıcı derecede doğru ve çok daha az belirsizdir. 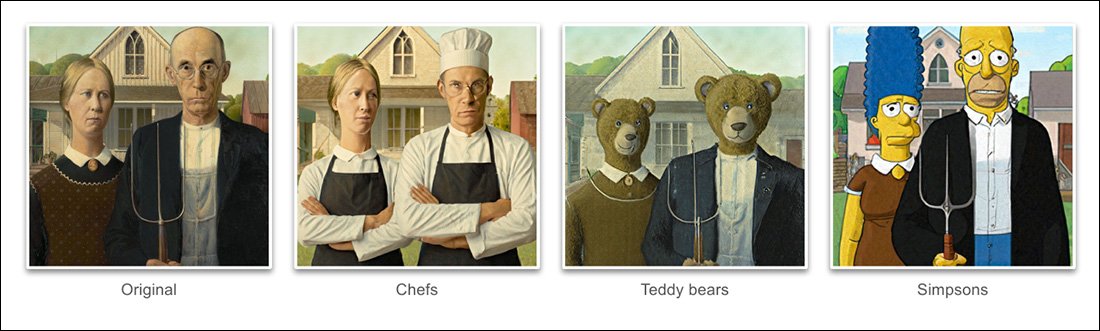
İnce Ayar Süreci
UniTune yöntemi temelde, orijinal görüntüyü, nasıl değiştirileceği konusunda talimatlar içeren bir difüzyon modeli aracılığıyla gönderir. Aslında, bu şu anda Stable Diffusion’ın img2img işlevi ile yapılabilir, ancak bu, saklamak istediğiniz resmin kısımlarını bozmadan veya değiştirmeden yapılamaz.
UniTune işlemi sırasında, sistem ince ayarlanır, yani UniTune modelin eğitimini yeniden başlatır, çoğu katmanının dondurulmamış olduğu bir durumda (aşağıya bakınız). Çoğu durumda ince ayar, oluşturulması veya geliştirilmesi istenen başka bir yönü eklemek ya da iyileştirmek uğruna, güçlükle elde edilmiş yüksek performanslı bir modelin toplam genel kayıp değerlerini düşürür.
UniTune ile birlikte, model kopyası, birkaç gigabayt veya daha fazla ağırlığında olabilir, ancak tek bir amaç için hizmet eden bir “kabuk” olarak muamele görecek ve işlemin sonunda atılacaktır. Bu tür veri tonajı, kendi modelleri budanmış olsalar bile her konu için en az 2GB olan DreamBooth severleri için günlük bir depolama krizi haline geliyor.
UniTune’de ana ayar, Imagen’de (base 64px, 64px>256px ve 256px>1024px) alttaki iki katmanda gerçekleşir. Imagic’ten farklı olarak, araştırmacılar, bu son ve en büyük süper çözünürlük katmanını (henüz denemediler) optimize etmenin potansiyel bir değerini görüyorlar.
En düşük 64px katman için, model eğitim sırasında temel görüntüye yönlendirilir, 128 iterasyon için 4’lük bir toplu boyutunda, metin/görüntü çiftlerinin birden fazla kopyası sisteme beslenir ve Adafactor olarak kayıp fonksiyonu, 0.0001’lik bir öğrenme hızında çalışır. T5 kodlayıcı tek başına bu fine-tuning sırasında dondurulur, ancak Imagen’in ilk eğitimi sırasında da dondurulur
Aşağıdaki işlem, aynı gürültü artırma prosedürü kullanılarak, 64>256px katman için tekrarlanır.
Örnekleme
Değişikliklerin elde edildiği birçok olası örnek alma yöntemi vardır, bunlar arasında Stable Diffusion’ın da bir parçası olan Sınıflandırıcısız Yönlendirme (CFG) bulunur. CFG, modelin “hayal gücünü” takip etme veya girdi verilerine uyma derecesini tanımlar – ya da daha düşük ayarlarında, değişikliklerin ne kadar dramatik veya kapsamlı olabileceğini belirler.

Textual Inversion (DreamBooth ile biraz daha az) gibi, UniTune, orijinal görüntülere farklı grafik stillerini uygulamaya ve daha fotogerçekçi düzenlemelere uygundur.
Araştırmacılar ayrıca SDEdit‘in “geç başlangıç” tekniğini denediler, burada sistem, kısmen “gürültü” ile başlayarak, ancak esas olarak orijinal ayrıntıları korur. Araştırmacılar bunu yalnızca en düşük katmanda (64px) kullandılar, ancak gelecekte faydalı bir örnek alma tekniği olabileceğine inanıyorlar.
Araştırmacılar ayrıca istemden-isteme olarak adlandırılan bir başka metin tabanlı tekniği kullanarak modeli koşullandırmak için yararlandılar:
QUOTEOPEN‘İstemden-isteme ayarı’nda, bir tekniğin, İstem Yönlendirmesi olarak adlandırdığımız, sadakat ve ifadeyi ayarlamak için özellikle faydalı olduğunu bulduk. QUOTECLOSEQUOTEOPEN‘İstem Yönlendirmesi, Sınıflandırıcısız Yönlendirme’e benzer, ancak temel, koşulsuz model yerine farklı bir istemdir. Bu, modeli iki istem arasındaki farka yönlendirir.’QUOTECLOSE

UniTune’de istemden-isteme, alanları değiştirmek için etkili bir şekilde izole ediyor.
Ancak, yazarlar, İstem Yönlendirmesi’nin yalnızca CFG’nin istenen sonucu elde edemediği durumlarda nadiren gerekli olduğunu belirtiyorlar.
UniTune’nin geliştirilmesinde ortaya çıkan bir başka yeni örnek alma yöntemi, enterpolasyon idi, burada görüntünün kısımları, orijinal ve değiştirilmiş görüntülerin bileşimi açısından birbirinden yeterince ayrılmıştı ve daha “naif” bir enterpolasyon kullanılabiliyordu.

Enterpolasyon, alanların değiştirileceği yerlerin ayrı ve iyi tanımlanmış olduğu durumlarda, UniTune’nin daha fazla çaba gerektiren süreçlerini gereksiz kılabilir.
Yazarlar, enterpolasyonun, hedef kaynak görüntülerinin büyük bir bölümü için varsayılan ayar olarak kullanılabileceğini ve karmaşık örtüşmelerin daha yoğun yöntemlerle müzakere edilmesine gerek kalmadan olağanüstü dönüşümler gerçekleştirebileceğini gözlemlediler.
UniTune, düzenleme maskeleri ile veya olmadan yerel düzenlemeler gerçekleştirebilir ve ayrıca düzenlemeleri nereye konumlandıracağını tek taraflı olarak karar verebilir, yorumlama gücü ve kaynak girdi verilerinin temel özünün benzersiz bir kombinasyonuna sahiptir:

İkinci sütundaki en üstteki resimde, UniTune, arka planda ‘kırmızı bir tren’ eklemesi talimatı verildiğinde, uygun ve otantik bir konumda yerleştirir. Diğer örneklerde, kaynak görüntüsüne anlamsal bütünlük, piksel içeriği ve temel stillerindeki olağanüstü değişikliklere rağmen korunur.
Gecikme
Her yeni sistemin ilk iterasyonu yavaş olacak ve muhtemelen topluluk katılımı veya kurumsal taahhüt (her ikisi genellikle değil) sonunda kaynak yoğun bir rutini hızlandırıp optimize edecektir, ancak hem UniTune hem de Imagic, bu harika düzenlemeleri oluşturmak için bazı önemli makine öğrenimi manevraları gerçekleştirdiğinden, bu tür bir kaynak açlıklı bir sürecin ev kullanımına göre API’ye bağlı erişim (sonuncusu Google için daha arzu edilebilir olabilir) dışında ölçeklendirilebileceğine şüphe duyulabilir.
Girişten sonuçlara kadar olan tur, bir T4 GPU’da yaklaşık 3 dakika sürüyor ve çıkarım için yaklaşık 30 saniye daha ekleniyor (herhangi bir çıkarım rutini gibi). Yazarlar, bu gecikmenin yüksek olduğunu ve “etkileşimli” olarak nitelenmeyeceğini kabul ediyorlar, ancak modelin, ilk olarak ayarlandıktan sonra, kullanıcı işlemi tamamlanıncaya kadar daha fazla düzenleme için kullanılabilir durumda kaldığını, bu da her düzenleme başına geçen süreyi azalttığını belirtiyorlar.
İlk olarak 21 Ekim 2022’de yayınlandı.


