Anderson’un Açısı
Görüntü Sentezleme Sistemlerinin Gerçekten Özgün İçerik Ürettiğini Nasıl Anlarız?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin

Öne çıkan noktalarKAIST ve NAVER'in Nadirlik Puanı, en yakın komşu mesafeleri aracılığıyla görsel…
Daha fazla göster
- KAIST ve NAVER'in Nadirlik Puanı, en yakın komşu mesafeleri aracılığıyla görsel özgünlüğü ölçer.
- Kesme Hilesi gibi mevcut metrikler, üretilen görsellerde yenilik yerine özgünlüğü tercih eder.
- Nadirlik Puanı, DALL-E 2 gibi sistemlerden gerçekten yaratıcı çıktıları belirleyebilir.
Güney Kore’de yapılan yeni bir araştırma, görüntü sentezleme sistemlerinin gerçekten yeni görüntüler mi, yoksa eğitim verilerinin küçük varyasyonlarını mı ürettiğini belirlemek için bir yöntem öneriyor. İkinci durum, bu mimarilerin yeni ve özgün görüntüler üretme amacını boşa çıkarabilir.
Makaleye göre çoğu zaman ikinci durum geçerli; çünkü eğitim boyunca üretim yeteneğini geliştirmek için kullanılan mevcut ölçütler, veri kümesindeki gerçek kaynak görüntülere yakın sonuçları tercih etmek zorunda kalıyor.
Sonuçta bir görüntü kaynak veriye görsel olarak yakınsa, özgünlükten çok gerçekçilik açısından yüksek puan alması beklenir: ilham verici olmasa da kaynağa sadıktır.
Hukuki sonuçları henüz bilinmeyen bu genç ve sınanmamış sektörde bu, önemli bir hukuki soruna dönüşebilir. Özellikle ticari sentetik görüntü içeriği, çoğunlukla telif hakkıyla korunan ve günümüzde yayılmasına izin verilen kaynak materyalden yeterince farklı değilse. Bu materyal, internetten toplanan popüler veri kümeleriyle araştırmaya giriyor. Bu tür gelecekteki ihlal iddialarının olasılığı yakın zamanda gündeme geldi; konu Microsoft’un GitHub Co-Pilot yapay zekâsıyla ilgiliydi.
OpenAI’ın DALL-E 2, Google’ın Imagen ve Çin’in CogView sistemleri ile daha düşük özellikli DALL-E mini giderek daha tutarlı ve anlamsal açıdan sağlam sonuçlar üretirken, oluşturulan bir görüntünün özgünlüğünü güvenilir biçimde sonradan sınamanın çok az yolu bulunuyor.
En popüler yeni DALL-E 2 görüntülerinden bazılarını aramak, kullanılan arama motoruna bağlı olarak çoğunlukla aynı görüntülerin başka kopyalarına götürüyor.

DALL-E 2’nin dokuz görüntülük çıktı grubunu bütünüyle yüklemek yalnızca başka DALL-E 2 gruplarını getiriyor; çünkü ızgara en baskın özellik. İlk görüntüyü ayırıp yüklemek —Weird Dall-E Generations hesabının 8 Haziran 2022 tarihli bu Twitter gönderisinden— Google’ın basketbol topuna takılmasına ve görüntü aramasının anlamsal bir çıkmaza girmesine neden oluyor. Yandex ise aynı görüntü için en azından gerçekten piksel analizi ve özellik eşleştirmesi yapıyor gibi görünüyor.
Yandex, Google Search’e göre daha çok görüntünün gerçek özelliklerini kullanıyor; bunlar görüntüden türetilen veya hesaplanan nitelikler ve mutlaka insanların yüz özellikleri değil. Ayrıca anlamsal özelliklerden çok görsel özelliklerle benzer görüntüler arıyor. Yine de tüm görüntü arama motorlarının belirli amaç veya uygulamaları var ve bunlar kaynak>üretilen türündeki intihalleri internet aramasıyla belirlemeyi güçleştirebilir.
Üretici modelin eğitim verileri de bütünüyle kamuya açık olmayabilir; bu da görüntülerin özgünlüğüne yönelik adli incelemeyi daha da zorlaştırır.
İlginç biçimde, Google’ın Imagen sitesinde sergilediği sentetik görüntülerden biriyle yapılan arama, gerçekten görüntüye bakıp tarafsızca benzerlerini arama açısından onun konusuyla karşılaştırılabilecek hiçbir şey bulmuyor. Her zamanki gibi anlama odaklanan Google Images, imagen google sözcükleri ek ve sınırlayıcı bir parametre olarak eklenmeden saf görüntü aramasına izin vermiyor:

Yandex ise amatör sanat topluluğundan çok sayıda benzer veya en azından görsel olarak ilişkili gerçek dünya görüntüsü buluyor:

Genel olarak görüntü sentezi çıktılarının yenilik veya özgünlüğünü, model eğitilirken internetteki tüm olası görüntülerden özellik çıkarmadan ya da telifli içerik kullanabilen kapalı veri kümelerini incelemeden ölçebilmek daha iyi olurdu.
Bu konuda Korea Advanced Institute of Science and Technology bünyesindeki Kim Jaechul Graduate School of AI (KAIST AI) araştırmacıları, küresel bilişim ve arama şirketi NAVER Corp ile birlikte Nadirlik Puanı (Rarity Score) geliştirdi. Bu ölçüt, görüntü sentezi sistemlerinin daha özgün yaratımlarını belirlemeye yardımcı olabilir.

Görüntüler StyleGAN-FFHQ ile oluşturuldu. Sütunlar soldan sağa en kötüden en iyiye gidiyor. Truncation trick ve Realism ölçütlerinin kendi hedefleri varken üst sıradaki yeni Nadirlik Puanı yalnızca tutarlı değil, tutarlı ve özgün görüntüler arıyor. Makaledeki görüntü boyutu sınırları nedeniyle ayrıntı ve daha yüksek çözünürlük için kaynak çalışmaya bakın. Kaynak: https://arxiv.org/pdf/2206.08549.pdf
Yeni makalenin başlığı Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images (Nadirlik Puanı: Sentezlenmiş Görüntülerin Sıra Dışılığını Değerlendirmek İçin Yeni Bir Ölçüt) ve yazarları KAIST’ten üç, NAVER Corp’tan üç araştırmacı.
Ucuz numaranın ötesinde
Yeni makalenin iyileştirmeyi hedeflediği eski ölçütlerden biri, Britanya’daki Heriot-Watt University ile Google DeepMind işbirliğinde 2019’da önerilen Truncation trick.
Bu yöntem, örnekleme için üretici modelin eğitiminde kullanılandan farklı bir gizil dağılım kullanır.
Geliştiricileri işe yaramasına şaşırmış, fakat özgün makalede çıktı çeşitliliğini azalttığını kabul etmiştir. Buna rağmen gerçekçi görünen sonuçlar elde etmek için etkili ve popüler bir ucuz numara haline gelmiştir. Sonuçlar verideki tüm olasılıkları gerçekten özümsemez ve kaynak veriye istenenden çok benzeyebilir.
Yeni makalenin yazarları şöyle diyor:
“Yöntem eğitim veri kümelerinde nadir örnekler üretmek için değil, tipik görüntüleri daha kararlı biçimde sentezlemek içindir. Üretici etkili biçimde nadir örnekler üretmeye yönlendirilirse mevcut üretici modellerin gerçek veri dağılımı açısından daha zengin örnekler oluşturabileceğini varsayıyoruz.”
Üretici model eğitiminin ilerleyişinde geleneksel ölçütlere dayanma eğilimi hakkında, örneğin Aralık 2021’de yoğun eleştiri alan Frechet Inception Distance (FID), Inception Score (IS) ve Kernel Inception Distance (KID) için yazarlar ekliyor*:
“Bu öğrenme düzeni, üreticinin gerçek görüntü dağılımında küçük yer tutan, benzersiz ve güçlü özellikli nadir örnekleri çok az sentezlemesine neden olur. Açık veri kümelerindeki örnekler arasında FFHQ içindeki çeşitli aksesuarlar takan insanlar, AFHQ’daki beyaz hayvanlar ve Metfaces’teki sıra dışı heykeller bulunur.
“Nadir örnek üretme yeteneği yalnızca üretici modellerin sınır yetenekleriyle ilişkili olduğu için değil, benzersizlik sanal insanlar gibi yaratıcı uygulamalarda önemli olduğu için de değerlidir.
“Ancak yakın tarihli bazı çalışmaların nitel sonuçlarında bu nadir örnekler pek bulunmaz. Çekişmeli öğrenmenin doğasının üretilen görüntü dağılımını eğitim kümesine benzemeye zorladığını düşünüyoruz. Böylece belirgin bireysellik veya nadirlik taşıyan görüntüler, model çıktılarının küçük bir bölümünü oluşturuyor.”
Teknik
Yeni Nadirlik Puanı, önceki çalışmalarda sunulan bir fikri uyarlar: görüntü sentezi sistemindeki gerçek eğitim ve sentetik çıktı veri dizilerini temsil etmek için K en yakın komşu (KNN) kullanmak.
Yazarlar yeni analiz yöntemini şöyle açıklıyor:
“Sıradan örneklerin birbirine daha yakın, benzersiz ve nadir örneklerin ise özellik uzayında seyrek konumlanacağını varsayıyoruz.”
Yukarıdaki sonuç görüntüsü, FFHQ üzerinde eğitilmiş bir StyleGAN mimarisinde en yakın komşu mesafelerini (NND) küçükten büyüğe gösteriyor.
“Tüm veri kümelerinde en küçük NND’li örnekler temsili ve tipik görüntülerdir. En büyük NND’li örnekler ise güçlü bireysellik taşır ve en küçük NND’li tipik görüntülerden belirgin biçimde ayrılır.”
Kuramsal olarak yeni ölçütü ayrıştırıcı olarak kullanmak veya daha karmaşık bir ayrıştırıcı mimarisine katmak, üretici sistemi saf taklitten daha yaratıcı bir algoritmaya yöneltebilir. Gerçekçi görüntü üretimi için önemli kavramların temel tutarlılığı da korunabilir; örneğin erkek, kadın, araba, kilise gibi.
Karşılaştırmalar ve deneyler
Araştırmacılar testlerde Nadirlik Puanını hem Truncation trick hem de NVIDIA’nın 2019 tarihli Realism Score ölçütüyle karşılaştırdı. Yöntemin çeşitli çerçeveler ve veri kümelerinde benzersiz sonuçları ayırt edebildiğini gördüler.
Makalede çok fazla sonuç olduğu için hepsi burada gösterilemiyor; ancak yeni yöntemin üretim sürecinde hem gerçek kaynak hem de sentetik görüntülerde nadirliği tanımlayabildiği gösterilmiş görünüyor:
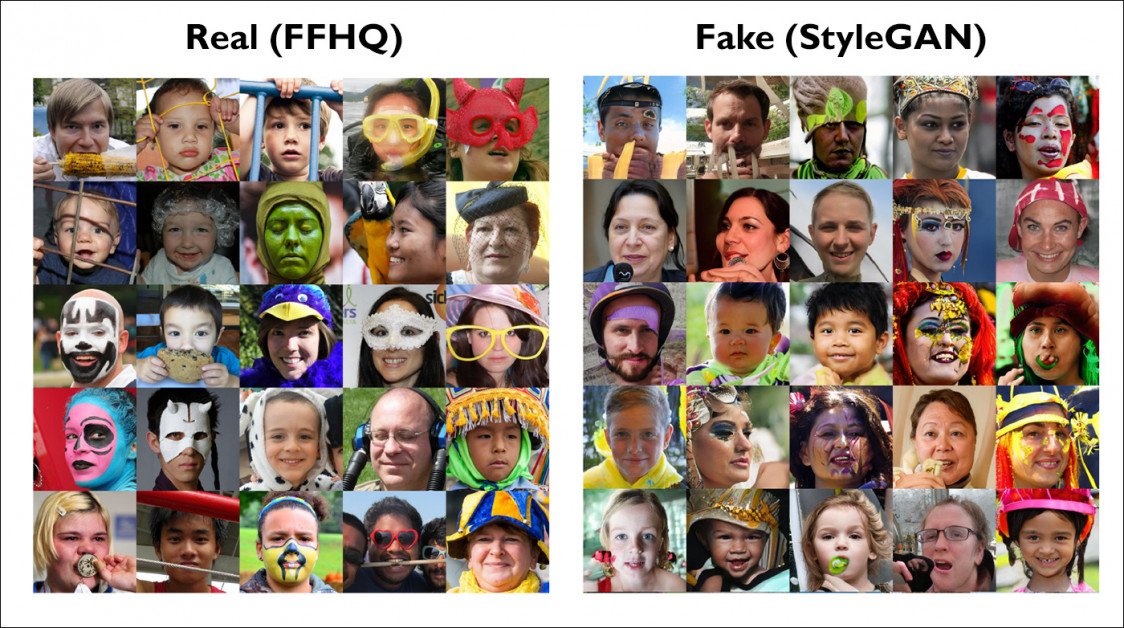
Makaledeki geniş görsel sonuçlardan seçilmiş örnekler; ayrıntılar için yukarıdaki kaynağa bakın. Solda FFHQ’dan, özgün veri kümesinde çok az yakın komşusu olan, yani yeni ve sıra dışı gerçek örnekler var. Sağda yeni ölçütün gerçekten yeni olarak tanıdığı StyleGAN görüntüleri bulunuyor. Görüntü boyutu sınırları nedeniyle ayrıntı ve yüksek çözünürlük için kaynak makaleye bakın.
Araştırmacılara göre yeni Nadirlik Puanı yalnızca tek bir mimarideki yeni çıktıları tanımlamıyor; autoencoder, VAE ve GAN gibi farklı mimarilerdeki üretici modelleri de karşılaştırabiliyor.
Makale, bu ölçütün benzersiz ve nadir görüntü yaratma yeteneğine odaklanarak önceki ölçütlerden ayrıldığını söylüyor. Geleneksel ölçütler eğitim sırasındaki üretimler arasındaki çeşitliliği daha dar bir bakışla inceliyor.
Sınırlı görevlerin ötesinde
Testler insan veya kedi görüntüleri üretmek için tasarlanmış üretici/veri kümesi eşleşmeleri gibi sınırlı alanlarla yapıldı. Ancak Nadirlik Puanı, eğitim verisinden öğrenilen dağılımları kullanan çıktıları tanımak istendiğinde herhangi bir görüntü sentezinde kullanılabilir. Bu, dış gizil dağılımlar ekleyerek gerçekçiliği artırıp çeşitliliği azaltmaya ya da gerçekçilik uğruna yeniliği feda eden kestirmelere alternatiftir.
Bu ölçüt DALL-E serisi gibi sistemlerde, görünüşte aykırı bir sonuç, eğitim verisi ve benzer komut veya girdilerin sonuçları arasındaki mesafeyi kullanarak gerçekten yeni çıktıları ayırt edebilir; görüntü tabanlı komutlar da buna dahildir.
Uygulamada sistemin görsel ve anlamsal kavramları ne kadar özümsediği açık değildir; eğitim verisi hakkında sınırlı bilgi bunu zorlaştırır. Yine de yöntem, yeterli girdi kavramı ve verinin aşırı türetilmiş veya kaynağa yakın bir şey yerine gerçekten yaratıcı bir şey doğurduğu gerçek ilham anını tanımlayabilir.
* Yazarların metin içi atıflarını ben köprülere dönüştürdüm.
İlk yayımlanma tarihi: 20 Haziran 2022.