Yapay zeka temelleri
Metin Sınıflandırması Nasıl Çalışır?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Metin sınıflandırması, bir belgeye, mesaja veya metin parçasına bir veya daha fazla etiket atar. Örnekler arasında istenmeyen posta tespiti, niyet yönlendirme, duygu analizi, konu etiketleme, denetleme ve destek talebi önceliklendirme yer alır.
Üretim sınıflandırıcısı sadece bir modelden ibaret değildir. Kesin bir etiket taksonomisi, temsilci anotasyonlar, sızıntı güvenli bölünmeler, kalibre edilmiş bir karar kuralı ve değişen dil ve sınıf yaygınlığı için izleme gerektirir.
Temel Çıkarımlar
- Mimari seçmeden önce etiketleri ve belirsiz durumları tanımlayın.
- Basit kelime torbası (bag-of-words) temelleri hâlâ değerlidir; önceden eğitilmiş kodlayıcılar bağlam ve aktarım öğrenmesi ekler.
- Doğruluk, azınlık sınıflarındaki düşük performansı gizleyebilir; bu yüzden sınıf‑bilinçli ölçütler ve hata analizi kullanın.
- Olasılık kalibrasyonu, çekimser kalma ve insan incelemesi, puanları daha güvenli kararlara dönüştürür.
Taksonomi ve Anotasyon Politikasını Tanımlama
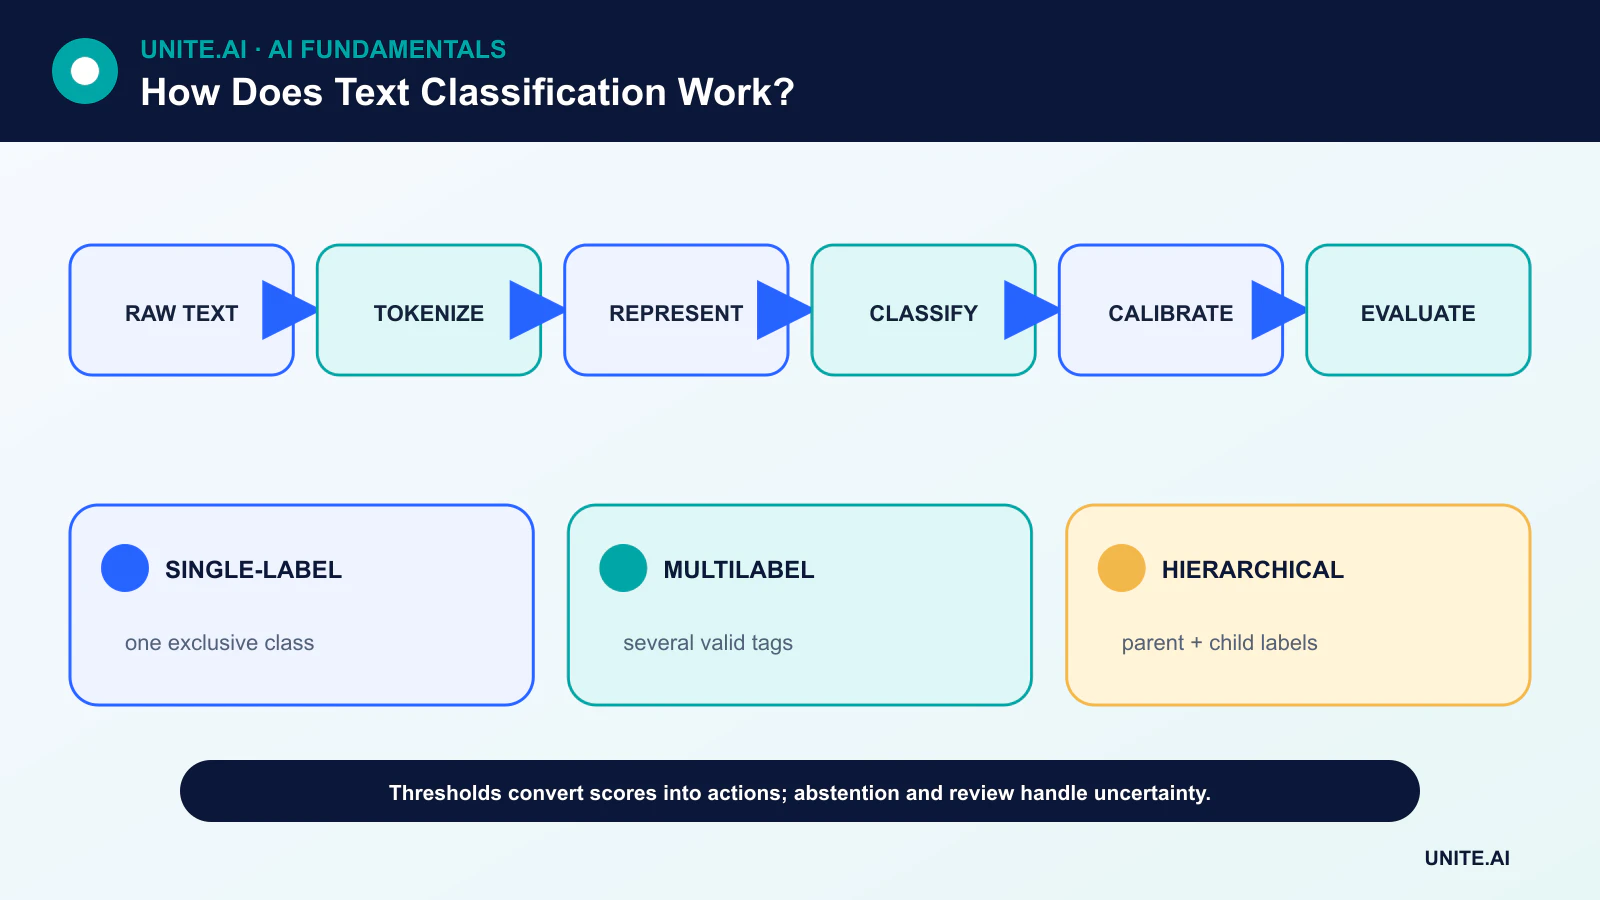
Tek etiketli bir görev, birbirini dışlayan bir sınıf seçer. Çoklu etiketli bir görev ise birden fazla bağımsız etiketi atayabilir. Hiyerarşik taksonomiler, üst ve alt etiketler içerir. Bunlar farklı öğrenme problemleridir ve farklı çıktılar ve ölçütler gerektirir.
Anotasyon yapanların tanımlara, olumlu ve olumsuz örneklere, eksik bağlam için kurallara ve bir yükseltme yoluna ihtiyacı vardır. Anlaşma istatistikleri belirsiz bir görevi ortaya çıkarabilir, ancak anlaşmazlık da sistemin koruması gereken gerçek bir belirsizliği temsil edebilir.
Metni Temsil Etme
Geleneksel veri işleme hatları, token sayımları, n‑gramlar ve TF‑IDF’i doğrusal sınıflandırıcılar veya destek vektör makineleri ile kullanır. Hızlı bir şekilde eğitilir, etkili terimleri ortaya çıkarır ve güçlü bir temel sağlar.
Sinir ağları, tokenları gömmelere (embedding) dönüştürür. Önceden eğitilmiş transformer kodlayıcıları, bağlam temelli temsiller üretmek için dikkat (attention) mekanizması kullanır ve etiketli örneklerle ince ayar yapılabilir. İstemli veya sıfır‑atış sınıflandırıcılar başlangıçtaki etiketlemeyi azaltabilir, ancak etiket ifadeleri, model sürümü ve kalibrasyonu gerçek alanda değerlendirilmelidir.
Sızıntısız Eğitim
Veri kümesi, eğitim, doğrulama ve son test verileri olarak ayrılır. Yakın‑tekrarlayan belgeler, aynı konuşmadan gelen mesajlar veya aynı kaynaktan şablonlar aynı bölmede kalmalıdır. Zaman‑bağımlı kullanım için kronolojik bir bölünme dağıtımı daha iyi temsil eder.
Sınıf dengesizliği, ağırlıklandırma, yeniden örnekleme, eşik seçimi veya ek veri ile giderilebilir. Sentetik örnekler, gerçek azınlık sınıfı hatalarının incelenmesini yerine geçmemeli ve modelin çok kolay öğrenebileceği yapay artefaktlar eklememelidir.
Ölçütler ve Kalibre Edilmiş Kararlar
Bir karışıklık matrisi, hangi etiketlerin karıştırıldığını gösterir. Kesinlik (precision), tahmin edilen pozitiflerin ne kadarının doğru olduğunu ölçer; duyarlılık (recall) ise gerçek pozitiflerin ne kadarının bulunduğunu ölçer. Makro ortalamalar sınıfları eşit ağırlıklandırırken, mikro ortalamalar bireysel örnekleri ağırlıklandırır.
Ham bir softmax skoru otomatik olarak güvenilir bir olasılık değildir. Kalibrasyon, güveni gözlemlenen doğrulukla karşılaştırır. Ekipler sınıfa özgü eşikler belirleyebilir, güven düşük olduğunda çekimser kalabilir ve hassas durumları bir inceleyiciye yönlendirebilir.
Dağıtım, Çok Dilli Kullanım ve Sapma
Metin, ürünler, etkinlikler, argo ve adversarial davranışlarla değişir. İzleme, giriş dilini, uzunluğunu, sözlük dışı kalıpları, sınıf oranlarını, güveni ve gecikmiş sonuçları takip etmelidir. Yeniden eğitim, sürümlenmiş veri ve önemli örneklerden oluşan bir regresyon paketi gerektirir.
Çok dilli performans, her dil ve lehçe için test edilmelidir. Her şeyi tek bir dile çevirmek duygu ya da varlıkları değiştirebilir; çok dilli bir kodlayıcı, ön‑eğitimi ve etiketleri eşit temsil etmediği için hâlâ dengesiz performans gösterebilir.
Temsiller ve Sınıflandırıcı Aileleri
Metin sınıflandırması, bir belgeyi, cümleyi veya token dizisini bir veya daha fazla etikete eşler. Etiketlerin birbirini dışlayıp dışlamadığını, çoklu etiketli, hiyerarşik, sıralı veya açık‑set olup olmadığını tanımlayın. Geleneksel hatlar metni tokenlaştırır, kelime‑torbası veya TF‑IDF özellikleri oluşturur ve lojistik regresyon, Naïve Bayes ya da doğrusal SVM ile eğitir. Sinir ağları, konvolüsyon, yineleme veya transformerlarla gömmeler öğrenir. İstemli dil modelleri görev‑özel eğitime ihtiyaç duymadan sınıflandırabilir, ancak çıktı kısıtlamaları, maliyet, sapma ve kanıtlar hâlâ daha basit temellere karşı değerlendirilmelidir.
Ön işleme, temsile bağlıdır. Küçük harfe çevirme veya noktalama işaretlerini kaldırma, isimler, duygu, kod veya dil için sinyalleri yok edebilir; kök bulma (stemming) farklı anlamları birleştirebilir. Transformer tokenlaştırıcıları alt‑kelimeler üzerinde çalışır ve uzunluk sınırları vardır, bu yüzden kırpma stratejisi önemlidir. Uzun belgeler parçalama ve toplama gerektirebilir. Ham metni ve dönüşüm sürümünü koruyun ve yazar, konuşma, kaynak veya zaman bazlı bölünerek yakın‑tekrarlamaların ve tekrarlayan şablonların eğitim ve test arasında karışmasını önleyin.
Etiketler, Ölçütler ve Hata Analizi
Bir anotasyon kılavuzu, kapsamı, örnekleri, belirsiz durumları ve bilinmeyen ya da çekimser kalma seçeneğini tanımlamalıdır. Anlaşmayı ölçün ve çoğunluk oyu ile gizlemek yerine anlaşmazlığı çözün. Dengesiz sınıflar için doğruluk yetersizdir; sınıfa göre kesinlik, duyarlılık, F1, karışıklık, kalibrasyon ve eşik‑özel iş yükü raporlayın. Çoklu etiketli görevler mikro, makro ve etiket‑seviyesi ölçütlere ihtiyaç duyar. Dilleri, lehçeleri, alanları, mesaj uzunluğunu ve zamanı değerlendirin. Kelime hazinesi veya şablonlar saparken rastgele bir bölünme kaliteyi aşırı gösterebilir.
Hata analizi, temsil hatasını, yetersiz bağlamı, etiket belirsizliğini, nadir kelime hazinesini, olumsuzlamayı, alaycılığı ve sahte ipuçlarını ayırmalıdır. Anlamı korurken isimleri, lehçe işaretlerini veya alakasız meta verileri değiştiren karşı‑olgu testleri kullanın. Yüksek güvenli hataları ve reddedilen durumları inceleyin. Bir model, içeriği yorumlamak yerine bir müşteri kanalı veya imzasının bir etiketi tahmin ettiğini öğrenebilir. Sızıntıyı kaldırın ve sadece model kapasitesini artırmadan önce verileri yeniden gözden geçirin.
Üretim Tasarımı
Sabit bir tokenlaştırıcı ve modeli, şema doğrulaması, uzunluk sınırları, toplu işleme ve desteklenmeyen dil ya da düşük güven durumunda bir geri dönüşle sunun. Giriş dağılımını, etiket oranlarını, kalibrasyonu, gecikmeyi ve incelenen sonuçları izleyin. Metni koruyun çünkü kişisel, gizli veya adversarial talimatlar içerebilir. Otomatik denetleme, uygunluk veya yönlendirme için itiraz imkanı sağlayın ve farklı hataları ölçün. Etiketleri ve eşikleri iş politikasıyla sürümleyin. Metin sınıflandırması, yalnızca tanımlı etiket sistemi ve veri dağılımı içinde güvenilirdir; akıcı model açıklamaları bir sınıflandırmanın doğru olduğunu kanıtlamaz.
Uygulamalı Örnek: Gelen Destek Taleplerinin Sınıflandırılması
Bir destek ekibi, birbirini dışlayan yönlendirme etiketlerini ve ayrıca acil, çok dilli ve bilinmeyen bayrakları tanımlar. Anotasyon yapanlar, karışık konular için rehberlikle kimliği gizlenmiş mesajları etiketler ve anlaşmayı ölçer. TF‑IDF lojistik temeli, ince ayarlı kodlayıcı ve istemli model aynı zaman‑bazlı test setini kullanır. Değerlendirme, sınıf kesinliği ve duyarlılığı, acil yanlış negatifler, kalibrasyon, şema geçerliliği, gecikme ve maliyeti raporlar; sızıntıyı önlemek için yakın‑tekrarlayan şablonlar gruplanır.
Dağıtılan sınıflandırıcı, dil ve uzunluğu doğrular, zayıf kanıtlarda çekimser kalır ve ajanların rotaları düzeltmesine izin verir. İstemler ve mesajlar güvensiz olarak ele alınır; araç erişimi yoktur. İzleme, etiket yaygınlığını, güveni, düzeltmeleri, yanıt süresini ve ortaya çıkan konuları takip eder. Bir politika veya ürün değişikliği, taksonomiyi ve yeniden eğitim verilerini inceleme yoluyla günceller. Sistem kuyruk yerleştirmesini iyileştirir, ancak doğrulanmış etiketlerin ötesinde müşteri duygusu veya hak talebini tahmin etmez.
Uygulama Kanıtı ve Operasyonel Hazırlık
Bir üretim kararı, başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, işletim ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötüye kullanımı ve hizmet dışı kalma olasılığı yüksek grupları veya ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenmiş hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve doğrulanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından çevrim dışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek dünya kanıtlarını inceleyin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Sürdürülen bir sistem, belgelenmiş kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Duygu analizi bir metin sınıflandırma görevi midir?
Genellikle evet, ancak duygu çoklu etiketli, yön‑bazlı veya sürekli olabilir; tek bir olumlu/olumsuz/nötr etiket yerine.
Bir metin sınıflandırıcı ne zaman çekimser kalmalıdır?
Güven düşük olduğunda, metin kapsam dışı olduğunda, gerekli bağlam eksik olduğunda veya hatalı otomatik bir eylemin maliyeti inceleme maliyetini aştığında.
Birincil Referanslar