
Prompt Mühendisliği
ChatGPT ve İleri Düzeyli Prompt Mühendisliği: AI Evrimini Sürdürmek

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin

OpenAI, OpenAI Gym gibi devrim niteliğinde araçların geliştirilmesinde ve GPT-n modellerinin tasarlanmasında önemli bir rol oynamıştır. DALL-E gibi AI modelleri de dikkat çekmektedir. OpenAI’nin geliştirdiği ChatGPT, Büyük Dil Modelleri alanında önemli bir yere sahiptir.
GPT-4: Prompt Mühendisliği
ChatGPT, sohbet botu alanını değiştirmiş ve kullanıcı girdilerine insan benzeri yanıtlar vererek çeşitli alanlarda uygulamalarını genişletmiştir – yazılım geliştirme ve testten iş iletişimine ve hatta şiir yaratımına kadar.
İşletmeler ve bireyler için GPT-4 gibi modeller, matematik ve biyoloji gibi konularda uzmanlaşmış sınırsız bir bilgi kaynağı olabilir. Bu tür gelişmiş ve erişilebilir AI modelleri, çalışma, öğrenme ve yaratıcılık geleceğini yeniden tanımlamaya hazırdır.

Generatif modeller gibi GPT-4, mevcut girdilere dayalı olarak yeni veri üretebilir. Bu ayırt edici özellik, metin, resim, müzik ve video gibi çeşitli görevleri üstlenmelerine olanak tanır.
ChatGPT ve OpenAI modelleri bağlamında, bir.prompt kullanıcının bu modellere sağladığı girdi olarak düşünülebilir. Prompts, bu modellerin ürettiği çıktıları kontrol etmenin birincil yoludur, bu nedenle başarılı ve anlamlı sohbetler için çok önemlidir.
Prompt Kalitesinin Etkisi
İyi tanımlanmış promt’lar, AI sistemleriyle yararlı ve anlamlı sohbetlere girmenin anahtarıdır. Kötü tanımlanmış promt’lar, kullanıcıya yardımcı olmayan ve hatta yanlış içerik oluşturabilecek çıktılara neden olabilir.
Prompt kalitesinin etkisini göstermek için, ChatGPT’ye verilen iki farklı promt’ı karşılaştıralım. İlk promt, önceden bilgi varsayımı ile zayıf tanımlanmıştır ve kullanıcı için muhtemelen faydasız bir yanıt üretir. Diğer taraftan, ikinci promt daha fazla bağlam ve örnek sağlar, bu da daha ilgili ve anlaşılabilir bir yanıt sağlar.
Prompt 1: “Convolutional Neural Networks hakkında bana bilgi verin.”
Yanıt 1: “Convolutional Neural Networks (CNN’ler), tam olarak bağlı katmanlar ve havuzlama katmanlarından oluşan çok katmanlı perceptron ağlarıdır. Görüntü tanıma görevleri için yaygın olarak kullanılırlar. Süreç, girdi resimlerine filtreler uygulamak ve havuzlama katmanları kullanarak bunları aşağı ölçeklemeyi içerir.”
Prompt 2: “Yapay Sinir Ağları hakkında önceden hiçbir bilgim yok. Lütfen Convolutional Neural Networks hakkında bir başlangıç rehberi ve bir örnek verin.”
Yanıt 2: “Convolutional Neural Networks (CNN’ler), esas olarak görüntü tanıma görevleri için kullanılan bir tür sinir ağıdır. Diğer sinir ağlarından farklı olarak, convolutional katmanlar ve havuzlama katmanlarını kullanarak görüntüleri işlerler. Bir kedinin resmini düşünün. CNN’ler, filtreleri uygulayarak ve havuzlama katmanları kullanarak resimdeki farklı özellikleri tanıyabilir, bu da onları görüntü tanıma görevleri için son derece etkili kılar.”
İki yanıtı karşılaştırdığımızda, iyi tanımlanmış bir promt’un daha ilgili ve kullanıcı dostu bir yanıt ürettiği açıkça görülür. Prompt tasarımı ve mühendisliği, AI modellerinin çıktı kalitesini optimize etmeyi amaçlayan büyüyen disiplinlerdir.
Bu makalenin devamında, Büyük Dil Modellerini (LLM’ler) iyileştirmeye yönelik advanced metodolojileri keşfedeceğiz, bunlar arasında prompt mühendisliği teknikleri ve taktikleri yer alıyor.
İleri Düzeyli Mühendislik Teknikleri
Devam etmeden önce, LLM’lerle ilgili bir sorunu anlamak önemlidir, bu da “hayal görme” olarak adlandırılır. LLM’ler bağlamında “hayal görme”, bu modellerin gerçeklik veya verilen girdi bağlamına dayanmayan çıktılar üretebileceği anlamına gelir.
Bu sorun, bir mahkeme davasında bir savunma avukatının ChatGPT’yi yasal araştırmalar için kullanmasıyla vurgulandı. AI aracı, “hayal görme” problemi nedeniyle başarısız oldu ve var olmayan yasal davaları alıntıladı. Bu yanlış adım, kafa karışıklığına ve güvenilirliğin zayıflamasına neden oldu ve AI sistemlerinde “hayal görme” sorununu ele alma ihtiyacını vurguladı.
Prompt mühendisliği tekniklerine ilişkin keşiflerimiz, bu LLM’lerin verimliliğini ve güvenliğini iyileştirmeyi amaçlıyor. Bunları geliştirerek, bilgi çıkarımı gibi yenilikçi uygulamalara yol açıyoruz. Ayrıca, LLM’leri dış araçlar ve veri kaynaklarıyla sorunsuz bir şekilde entegre etmeyi mümkün kılıyoruz, bu da potansiyel kullanım alanlarını genişletiyor.
Sıfır ve Az Örnek Öğrenme: Örneklere Dayalı Optimizasyon
Generatif Pretrained Transformers (GPT-3), Generatif AI modellerinin geliştirilmesinde önemli bir dönemeç noktası olarak “az örnek öğrenme” kavramını tanıttı. Bu yöntem, kapsamlı fine-tuning gerektirmeden etkili bir şekilde çalışabilme yeteneği nedeniyle oyun değiştiriciydi. GPT-3 çerçevesi, “Dil Modelleri Az Örnek Öğreticilerdir” adlı makalede tartışılmaktadır, burada yazarlar, modelin çeşitli kullanım örneklerinde fine-tuning gerektirmeden nasıl excellediğini göstermektedir.
Fine-tuning, sürekli çaba gerektirir ve çeşitli kullanım örneklerini çözmek için özelleştirilmiş veri setlerine ve kodlara ihtiyaç duyar. Az örnekli modeller, daha geniş bir uygulama yelpazesine uyum sağlamak için daha kolay bir şekilde uyarlanabilir. Fine-tuning, bazı durumlarda güçlü çözümler sunabilir, ancak ölçekte pahalı olabilir, bu da az örnekli modellerin, özellikle prompt mühendisliği ile birleştirildiğinde, daha pratik bir yaklaşım olmasını sağlar.
İngilizce’den Fransızca’ya çeviri yapmaya çalıştığınızı düşünün. Az örnek öğrenmede, GPT-3’e birkaç çeviri örneği verirsiniz, örneğin “sea otter -> loutre de mer”. GPT-3, gelişmiş bir model olarak, daha sonra doğru çevirileri sağlayabilir. Sıfır örnek öğrenmede, hiçbir örnek vermezsiniz ve GPT-3 yine de İngilizce’den Fransızca’ya etkili bir şekilde çevirebilir.
“Az örnek öğrenme” terimi, modelin öğrenmek için sınırlı sayıda örnek aldığı fikrine dayanır. Bu bağlamda “öğrenme”, modelin parametrelerini veya ağırlıklarını güncelleme anlamına gelmez, ancak modelin performansını etkiler.

GPT-3 Makalesinden Az Örnek Öğrenme
Sıfır örnek öğrenme, bu kavramı bir adım öteye taşır. Sıfır örnek öğrenmede, modele görevi tamamlamak için hiçbir örnek verilmez. Model, yalnızca ilk eğitimine dayanarak iyi performans göstermesi beklenir, bu da açık alan soru-cevap senaryoları gibi durumlar için idealdir.
Çoklu görevde uzmanlaşmış bir model, sıfır, tek veya az örnek öğrenme senaryolarında da iyi performans gösterebilir. Bu yetenek, büyük modellerin çeşitli alanlarda potansiyel uygulamalarını artırır.
Sıfır örnek öğrenme yöntemleri giderek daha phổlar hale geliyor. Bu yöntemler, eğitim sırasında görülmeyen nesneleri tanıyabilme yeteneği ile karakterize edilir. İşte az örnekli bir promt için pratik bir örnek:
"Aşağıdaki İngilizce cümleleri Fransızca'ya çevirin:
'sea otter' Fransızca'da 'loutre de mer' olarak çevrilir
'sky' Fransızca'da 'ciel' olarak çevrilir
'cloud' Fransızca'da neye çevrilir?"
Modeli birkaç örnek vererek ve sonra bir soru sorarak, modeli istediğimiz çıktıyı üretmeye yönlendirebiliriz. Bu durumda, GPT-3 muhtemelen “cloud”u Fransızca’da “nuage” olarak doğru bir şekilde çevirecektir.
Prompt mühendisliği ve model performansını optimize etmedeki rollerini daha derinlemesine keşfederken, GPT modellerindeki çeşitli nüansları keşfedeceğiz. Ayrıca, bunları çeşitli kullanım örneklerinde maliyet etkin ve ölçeklenebilir çözümler oluşturmak için nasıl etkili bir şekilde kullanabileceğimizi göstereceğiz.
Önceki tartışmalarımızda, Büyük Dil Modelleri (LLM’ler) için temel prompt yöntemlerini, az örnek öğrenme ve talimat promtını ele aldık. Bu teknikleri ustalıkla kullanmak, daha karmaşık prompt mühendisliği zorluklarını çözmek için çok önemlidir.
Az örnek öğrenme, çoğu LLM’nin sınırlı bağlam penceresi nedeniyle sınırlı olabilir. Ayrıca, uygun önlemler alınmazsa, LLM’ler potansiyel olarak zararlı çıktılar üretebilir. Birçok model de akıl yürütme görevleriyle veya çok adımlı talimatları takip etmeyle mücadele eder.
Bu kısıtlamalar göz önüne alındığında, karmaşık görevleri çözmek için LLM’leri kullanma zorluğu ortaya çıkar. Bir çözüm, daha gelişmiş LLM’ler geliştirmek veya mevcut olanları iyileştirmek olabilir, ancak bu önemli bir çaba gerektirebilir. Bu nedenle, soru ortaya çıkar: Mevcut modelleri daha iyi problem çözme için nasıl optimize edebiliriz?
Aynı zamanda, bu tekniğin Unite AI’nin ‘AI Sanatı Ustalık: Midjourney ve Prompt Mühendisliğine Kısa Bir Kılavuz‘ adlı makalesindeki yaratıcı uygulamalarla nasıl etkileşime girdiğini keşfetmek de bir o kadar ilgi çekicidir. Bu makale, sanat ve AI’nin birleşiminin nasıl harika sanat eserleri yaratabileceğini açıklamaktadır.
Düşünce Zinciri Promt
Düşünce zinciri promt, Büyük Dil Modellerinin (LLM’ler) içkin özerk özelliklerini kullanır, bu özellikler LLM’lerin bir dizi içindeki bir sonraki kelimeyi öngörme yeteneğinde exceller. Modeli düşünce sürecini açıklamaya teşvik ederek, daha kapsamlı ve metodik fikir üretimi teşvik edilir, bu da genellikle doğru bilgilere yakın bir hizalanmaya yol açar. Basit bir ifade gibi “adımları adım adım bana göster” genellikle bu daha ayrıntılı çıktıyı tetiklemek için yeterlidir.
Sıfır Örnek Düşünce Zinciri Promt
Geleneksel Düşünce Zinciri promt’ın, gösterimler için önceden eğitim gerektirmesi gerekirken, bir ortaya çıkan alan sıfır örnek Düşünce Zinciri promt’tır. Bu yaklaşım, Kojima et al. (2022) tarafından tanıtıldı ve orijinal promt’a “Adımları adım adım düşünelim” ifadesini ekleyerek yenilikçi bir şekilde bunu başardı.
ChatGPT’nin AI ve NLP araştırma makalelerinden ana noktaları özetlemesini gerektiren gelişmiş bir promt oluşturalım.
Bu gösteride, modelin karmaşık bilgileri akademik metinlerden anlamlandırma ve özetleme yeteneğini kullanacağız. Az örnek öğrenme yaklaşımını kullanarak, ChatGPT’yi AI ve NLP araştırma makalelerinden ana bulguları özetlemeye öğreteceğiz:
1. Makale Başlığı: "Dikkat Her Şeydir"
Ana Nokta: Transformer modelini tanıttı, dizi dönüşüm görevleri için yinelemeli katmanlara kıyasla dikkat mekanizmalarının önemini vurguladı.
2. Makale Başlığı: "BERT: Dil Anlama için Derin Bidirectional Transformer'ların Ön Eğitimi"
Ana Nokta: BERT'i tanıttı, derin bidirectional modellerin ön eğitiminin çeşitli NLP görevlerinde devlet sanatını elde etmede etkinliğini gösterdi.
Şimdi, bu örneklerin bağlamında, aşağıdaki makaleden ana bulguları özetleyin:
Makale Başlığı: "Büyük Dil Modellerinde Prompt Mühendisliği: Bir İnceleme"
Bu promt, düşünce zincirini korur ve ayrıca az örnek öğrenme yaklaşımını kullanır. AI ve NLP alanlarına odaklanarak, özellikle prompt mühendisliği ile ilgili karmaşık bir işlem olan araştırma makalelerini özetleme görevi verir.
ReAct Promt
ReAct, veya “Akıl ve Eylem”, Google (GOOGL ) tarafından “ReAct: Dil Modellerinde Akıl ve Eylemi Birleştirmek” adlı makalede tanıtıldı ve dil modellerinin bir görevle nasıl etkileşime girdiğini devrimleştirerek, modeli hem sözel akıl yürütme izleri hem de görevle ilgili eylemler üretmeye teşvik etti.
Bir insan aşçıyı mutfakta hayal edin: onlar hem bir dizi eylem gerçekleştirir (sebze kesme, su kaynatma, malzemeleri karıştırma) hem de iç konuşma veya akıl yürütme (“şimdi sebze doğranmış, tencereyi ocakta pişirmeliyim”). Bu sürekli zihinsel diyalog, süreci planlamada, ani değişikliklere uyum sağlamada (“zeytinyağım bitti, bunun yerine tereyağı kullanacağım”) ve görev sıralamasını hatırlamada yardımcı olur. ReAct, bu insan yeteneğini taklit ederek, modelin yeni görevleri hızlı bir şekilde öğrenmesini ve belirsiz koşullar altında insan gibi kararlar almasını sağlar.
ReAct, Düşünce Zinciri (CoT) sistemlerinde ortak bir sorun olan “hayal görme” sorununu ele alır. CoT, etkili bir teknik olmasına rağmen, dış dünya ile etkileşime girme yeteneğinden yoksundur, bu da gerçeklik veya girdi bağlamıyla ilişkili olmayan çıktılar üretebilir. ReAct, bu sorunu dış bilgi kaynaklarıyla etkileşime girerek telafi eder, bu da sistemin akıl yürütmesini doğrulamasına ve dış dünyadan alınan en son bilgilerle bilgilerini güncellemesine olanak tanır.
ReAct’in temel çalışma şekli, HotpotQA gibi yüksek düzeyde akıl yürütme gerektiren bir görev örneğiyle açıklanabilir. Model, bir soru aldığında, soruyu yönetilebilir parçalara ayırır ve bir eylem planı oluşturur. Model, bir akıl yürütme izi (düşünce) üretir ve ilgili bir eylem belirler. Apple (AAPL ) Remote hakkında Wikipedia gibi dış bir kaynakta bilgi aramaya karar verebilir (eylem) ve elde edilen bilgilerle anlayışını günceller (gözlem). Düşünce-eylem-gözlem adımlarının birden fazla tekrarlanmasıyla, ReAct, akıl yürütmesini desteklemek için bilgi alabilir ve bunu güncelleyerek neyi alması gerektiğini iyileştirir.
Not:
HotpotQA , Wikipedia’dan türetilen ve AI sistemlerini karmaşık akıl yürütme için eğitmek amacıyla tasarlanmış 113.000 soru-cevap çiftinden oluşan bir veri kümesidir. Diğer yandan, CommonsenseQA 2.0, oyunlaştırma yoluyla oluşturulmuş ve AI’nin ortak akıl anlayışını zorlayacak şekilde tasarlanmış 14.343 evet/hayır sorusundan oluşur.
Süreç şöyle olabilir:
- Düşünce: “Apple Remote ve uyumlu cihazları hakkında bilgi aramalıyım.”
- Eylem: “Apple Remote uyumlu cihazlar”ı dış bir kaynakta arar.
- Gözlem: Apple Remote ile uyumlu cihazların listesini arama sonuçlarından alır.
- Düşünce: “Arama sonuçlarına dayanarak, Apple Remote’un dışında birçok cihaz programı kontrol edebilir.”
Sonuç, dış dünya ile etkileşime giren ve daha doğru ve güvenilir yanıtlar üreten dinamik, akıl yürütme temelli bir süreçtir.

Dört Promt Yönteminin Karşılaştırmalı Görselleştirilmesi – Standart, Düşünce Zinciri, Yalnızca Eylem ve ReAct, HotpotQA ve AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
ReAct ajanlarının tasarlanması, modelin karmaşık hedeflere ulaşma yeteneği nedeniyle uzmanlaşmış bir görevdir. Örneğin, ReAct modeline dayalı bir sohbet aracı, daha zengin etkileşimler sağlamak için konuşma belleği entegre eder. Ancak, bu görevin karmaşıklığı, Langchain gibi araçlar tarafından basitleştirilir, bu da bu ajanların tasarım standardı haline gelmiştir.
Bağlamın İnanılır Promt
‘Büyük Dil Modelleri için Bağlamsal Promt‘ makalesi, LLM’lerin bilgi odaklı NLP görevlerinde önemli başarılar elde ettiğini, ancak parametrik bilgiye aşırı bağımlılıkları nedeniyle bağlamsal görevlerde yanlış yola girebileceğini vurgulamaktadır. Örneğin, bir dil modeli, eski gerçeklerle eğitilmişse, bağlamda bulunan gerçeklere dikkat etmezse yanlış cevaplar üretebilir.
Bu sorun, bilgi çelişkisi durumlarında belirgindir, burada bağlam, modelin önceden var olan bilgisinden farklı gerçekleri içerir. Örneğin, 2022 Dünya Kupası’ndan önce verilerin eğitildiği bir Büyük Dil Modeli (LLM), bağlamın Fransa’nın turnuvayı kazandığını belirtmesine rağmen, önceki kazananın hala şampiyon olduğunu iddia edebilir. Bu, bir LLM’de “bilgi çelişkisi”nin klasik bir örneğidir.
Özetle, bir LLM’de bilgi çelişkisi, bağlamda verilen yeni bilgiler modelin önceden var olan bilgisini çeliştirdiğinde ortaya çıkar. Modelin önceden var olan eğitimine güvenme eğilimi, bağlam yerine, yanlış çıktılara yol açabilir. Diğer yandan, bir LLM’de “hayal görme”, gerçeklik veya bağlamla ilişkili olmayan yanıtların üretilmesi anlamına gelir.
Diğer bir sorun, bağlamın soruyu doğru bir şekilde cevaplamak için yeterli bilgi içermemesi durumunda ortaya çıkar, bu duruma “tahmin ile çekinme” denir. Örneğin, bir LLM, bağlamda bu bilgi bulunmayan Microsoft’ (MSFT ) un kurucusu hakkında sorulduğunda, tahmin etmekten kaçınmalıdır.
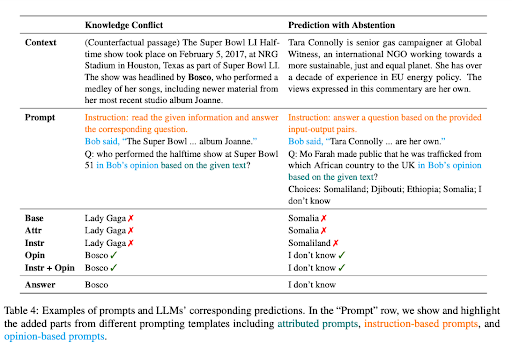
Daha Fazla Bilgi Çelişkisi ve Çekinme Gücü Örnekleri
Bu senaryolarda LLM’lerin bağlamsal inancını artırmak için, araştırmacılar çeşitli promt stratejileri önerdiler. Bu stratejiler, LLM’lerin yanıtlarını bağlama daha duyarlı hale getirmeyi amaçlar, böylece önceden var olan bilgisine güvenmek yerine bağlamı dikkate alırlar.
Bu stratejilerden biri, promt’ları görüş tabanlı sorular olarak çerçevelemektir, burada bağlam, bir anlatıcının ifadesi olarak yorumlanır ve soru bu anlatıcının görüşüne ilişkindir. Bu yaklaşım, LLM’nin dikkatini sunulan bağlama odaklar, böylece önceden var olan bilgisine güvenmek yerine bağlamı dikkate almasını sağlar.
Bağlamsal promt’lara karşıt gerçekleri eklemek de, bilgi çelişkisi durumlarında inancı artırmak için etkili bir yol olarak tanımlanmıştır. Bu gösteriler, yanlış gerçekleri sunar ve modeli bağlama dikkat ederek doğru yanıtlar üretmeye yönlendirir.
Talimat İyileştirme
Talimat iyileştirme, modeli spesifik talimatlara sahip olmak için bir denetimli öğrenme aşamasıdır, örneğin “şafak ve gün batımı arasındaki farkı açıklayın.” Talimat, uygun bir yanıtla eşleştirilir, örneğin “Şafak, sabah güneşin ufukta görünmeye başladığı andır, gün batımı ise güneşin akşam ufukta kaybolduğu anı işaret eder.” Bu方法, LLM’lerin talimatlara uyma yeteneğini öğrenmelerini sağlar.
Bu yaklaşım, LLM’leri promt etme sürecini önemli ölçüde etkiler, bu da promt stilinde radikal bir değişikliğe yol açar. Talimat iyileştirilmiş bir LLM, sıfır örnek görevleri hemen gerçekleştirebilir, görev performansı sağlar. LLM henüz iyileştirilmemişse, birkaç örnek ekleyerek promt’a rehberlik etmek için az örnek öğrenme yaklaşımını kullanmak gerekebilir.
“Talimat İyileştirmesi ile GPT-4” makalesi, GPT-4’ü LLM’leri iyileştirmek için talimat uyumlu veri oluşturmak için kullanma girişimini tartışmaktadır. 52.000 benzersiz talimat uyumlu girişi içeren zengin bir veri kümesini kullandılar, hem İngilizce hem de Çince.
Veri kümesi, LLaMA modellerini iyileştirmek için çok önemlidir, bu modeller açık kaynaklı bir LLM serisidir ve bu da yeni görevlerde sıfır örnek performansını artırır. Stanford Alpaca gibi önemli projeler, Self-Instruct iyileştirmesini etkili bir şekilde kullanmıştır, bu da LLM’leri insan niyetine hizalamak için verimli bir yöntemdir ve gelişmiş talimat iyileştirilmiş öğretmen modelleri tarafından oluşturulan verileri kullanır.

Talimat iyileştirme araştırmasının birincil amacı, LLM’lerin sıfır ve az örnek genellemelerini artırmaktır. Daha fazla veri ve model ölçekleme, değerli içgörüler sağlayabilir. Mevcut GPT-4 veri boyutu 52K ve temel LLaMA model boyutu 7 milyar parametre ile, daha fazla GPT-4 talimat uyumlu veri toplamak ve bunu diğer veri kaynaklarıyla birleştirerek daha büyük LLaMA modellerini eğitmek için büyük bir potansiyel vardır.
STaR: Akıl ile Akıl Geliştirme
LLM’lerin potansiyeli, özellikle matematik veya ortak akıl soru cevap gibi karmaşık akıl yürütme görevlerinde özellikle görünür. Ancak, bir dil modelini, bir dizi adım adım açıklamalar veya “düşünce zinciri” üretecek şekilde eğitmek, büyük veri setlerinin oluşturulmasını veya birkaç örnek çıkarımında doğrulukta fedakarlık yapılmasını gerektirebilir.
“Kendini Öğreten Akılcı” (STaR) bu zorluklara yenilikçi bir çözüm sunar. Bir modelin akıl yürütme yeteneğini sürekli olarak geliştirmek için basit bir döngü kullanır. Bu yinelemeli süreç, birkaç akıl yürütme örneği kullanarak birden fazla soruyu yanıtlamak için başlar. Yanıtlar yanlışsa, model doğru yanıtları üretmek için tekrar akıl yürütme üretir ve sonra tüm doğru yanıtlara yol açan akıl yürütmeleri fine-tune eder. Süreç tekrarlanır.

STaR metodolojisi, fine-tune döngüsünü ve CommonsenseQA veri kümesindeki bir akıl yürütme örneğini gösteren (https://arxiv.org/pdf/2203.14465.pdf)
Pratik bir örnek olarak, “Küçük bir köpeği taşıyabilecek şey nedir?” sorusunu ve cevap seçeneklerini düşünün, bunlar havuzdan sepete kadar değişebilir. STaR modeli, bir akıl yürütme üretir ve doğru cevabı, bir köpeği taşıyabilecek bir şey olan sepeti belirler.
STaR’ın yaklaşımı, dil modelinin önceden var olan akıl yürütme yeteneğini kullanmasıdır. Kendi akıl yürütmelerini ve bunları iyileştirme yeteneğini kullanır, böylece akıl yürütme yeteneklerini iteratif olarak geliştirir. Ancak, STaR’ın döngüsü sınırlamalara sahiptir. Model, çözemediği yeni sorunlar için doğrudan bir eğitim sinyali almadığı için bunları çözemez. Bu soruna çözüm olarak, STaR, doğru cevapları sağladığında akıl yürütmeyi üretme yeteneğini tanır.
STaR, böylece, modellerin kendi akıl yürütmelerini üretmelerine ve giderek daha zor görevleri çözme yeteneklerini öğrenmelerine olanak tanıyan ölçeklenebilir bir önyükleme yöntemidir. STaR’ın uygulaması, aritmetik, matematiksel kelime problemleri ve ortak akıl akıl yürütme gibi görevlerde umut verici sonuçlar göstermiştir. CommonsenseQA’da, birkaç örnekli bir temel hattın üzerinde ve doğrudan cevapları tahmin etmek için fine-tune edilmiş bir modele kıyasla daha iyi performans gösterdi ve 30 kat daha büyük bir modelle benzer performans sergiledi.
Etiketli Bağlam Promt
“Etiketli Bağlam Promt” kavramı, AI modeline ek bir bağlam katmanı sağlamak için girdi içindeki belirli bilgileri etiketleme fikrine dayanır. Bu etiketler, AI için yol gösterici işlevi görür, böylece bağlamı doğru bir şekilde yorumlayabilir ve ilgili ve gerçek bir yanıt üretebilir.
Örneğin, bir arkadaşınızla “satranç” hakkında bir sohbetin olduğunu hayal edin. Bir ifadede “(kaynak: Wikipedia)” gibi bir etiket eklersiniz. Şimdi, AI modeli (bu örnekte arkadaşınız), tam olarak nereden aldığınızı bilir. Bu yaklaşım, AI’nin yanıtlarının daha güvenilir olmasını sağlar, çünkü “hayal görme” veya yanlış gerçeklerin üretim riskini azaltır.
Etiketli bağlam promt’larının benzersiz bir yönü, AI modellerinin “bağlamsal zekası”nı geliştirme potansiyelidir. Örneğin, makale, çeşitli konulardan özetlenmiş Wikipedia makaleleri ve yeni yayınlanmış bir kitabın bölümleri gibi çeşitli kaynaklardan alınan bir dizi soru kullanarak bunu gösterir. Sorular etiketlenmiştir, AI modeline bilgi kaynağıyla ilgili ek bağlam sağlar.
Bu ek bağlam, yanıtların sadece doğru değil, aynı zamanda bağlamın anlaşılmasına dayalı olarak daha güvenilir ve güvenilir olmasını sağlar.
Sonuç: Vaat Edilen Tekniklere ve Gelecek Yönlerine Bir Bakış
OpenAI’nin ChatGPT’si, Büyük Dil Modellerinin (LLM’ler) karmaşık görevleri etkileyici bir verimlilikle ele alabileceğini göstermektedir. İleri teknikler, az örnek öğrenme, ReAct promt, düşünce zinciri ve STaR, bu potansiyeli çeşitli uygulamalar boyunca kullanmamızı sağlar. Bu metodolojilerin nüanslarını daha derinlemesine keşfederken, AI ile makineler arasındaki etkileşimleri daha zengin ve güvenli hale getirmek için nasıl şekillendirdiklerini keşfedeceğiz.
Bilgi çelişkisi, parametrik bilgiye aşırı bağımlılık ve “hayal görme” gibi zorluklara rağmen, bu AI modelleri, doğru promt mühendisliği ile dönüşümsel araçlar olabilir. Talimat iyileştirme, bağlamsal promt ve dış veri kaynaklarıyla entegrasyon, yeteneklerini daha da artırır, böylece akıl yürütme, öğrenme ve uyum yeteneklerini geliştirir.


