
Grunderna i AI
Vad är förstärkningsinlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
Förstärkningsinlärning (RL) är ett maskininlärningsramverk där en agent lär sig hur den ska agera genom att interagera med en miljö. Efter varje handling förändras miljön och kan ge en belöning. Agentens mål är att lära sig en policy som maximerar förväntad kumulativ belöning, inte bara belöningen från nästa steg.
RL används när beslut utvecklas över tid och en handling påverkar vad som händer härnäst. Det skiljer sig konceptuellt från övervakad inlärning, där ett dataset ger ett mål svar för varje träningsexempel.
Viktiga slutsatser
- Ett RL‑problem innehåller en agent, en miljö, tillstånd, handlingar, belöningar och en policy.
- Positiv och negativ förstärkning ökar båda beteendet; bestraffning minskar beteendet.
- Agenten måste balansera utforskning av okända handlingar med utnyttjande av handlingar som redan är kända att fungera.
- Värdebaserade, policy‑baserade, aktör‑kritiker, modellbaserade och offline‑metoder löser olika RL‑miljöer.
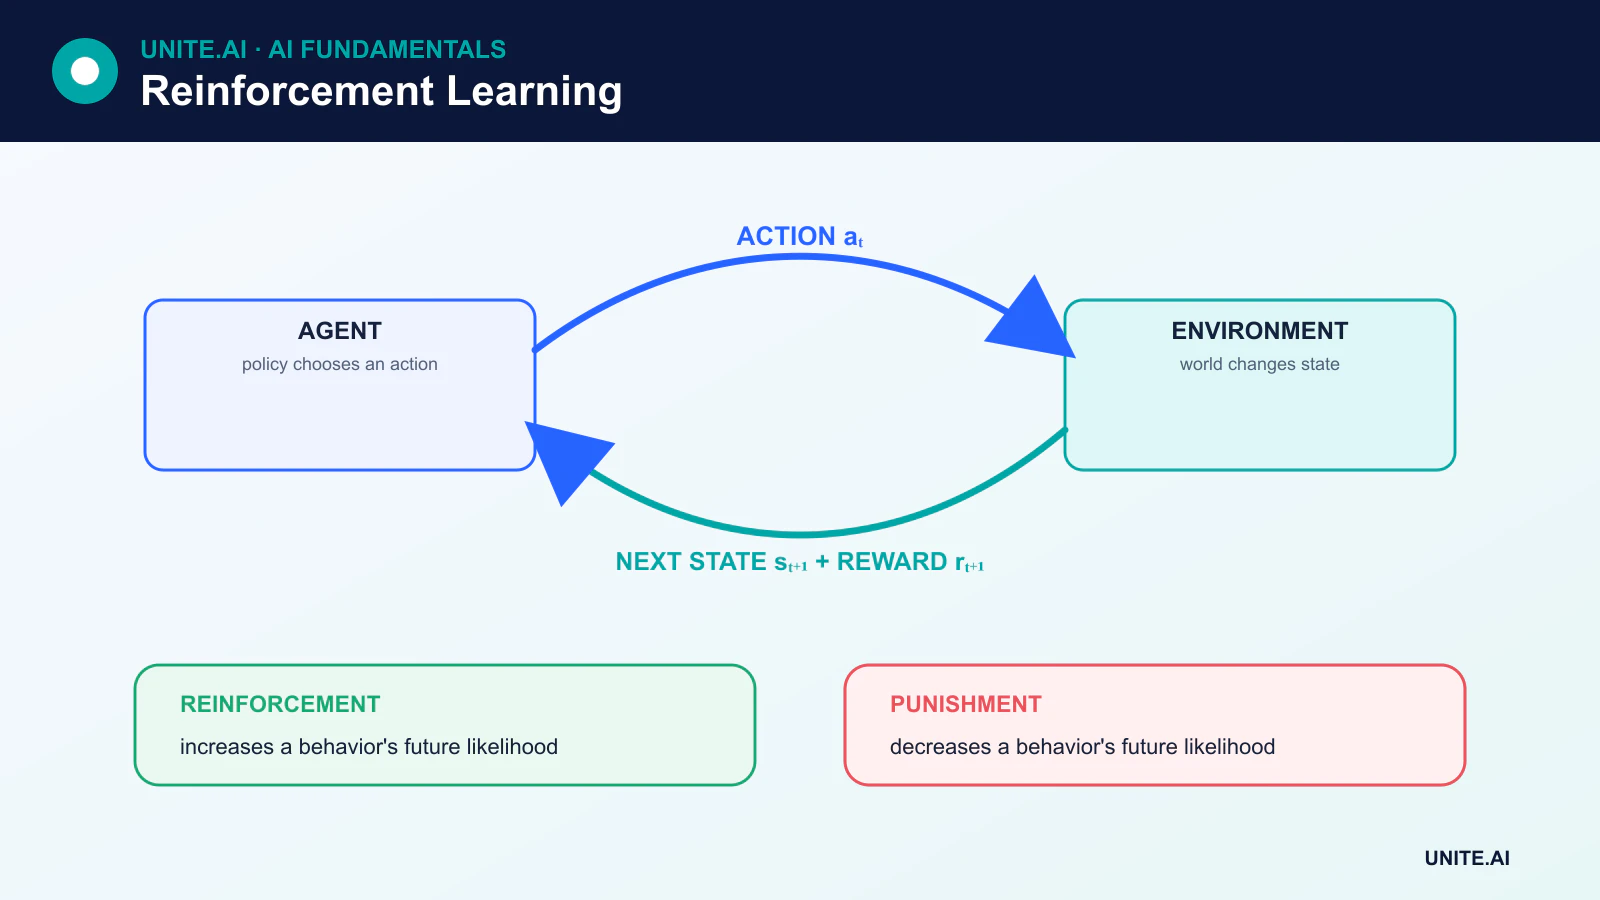
Komponenterna i förstärkningsinlärning
Många RL‑problem modelleras som en Markovbeslutsprocess (MDP). En MDP innehåller:
- Tillstånd: information som beskriver den aktuella situationen.
- Handling: ett val som är tillgängligt för agenten.
- Övergång: hur tillståndet förändras efter en handling.
- Belöning: omedelbar återkoppling som produceras av en övergång.
- Policy: agentens strategi för att välja handlingar.
- Diskonteringsfaktor: hur starkt framtida belöningar räknas i förhållande till omedelbara belöningar.
Ett tillstånd behöver inte avslöja all information om världen. När viktig information är dold kan problemet vara partiellt observerbart och agenten kan behöva ett minne eller ett tro‑tillstånd.
Förstärkning är inte samma sak som bestraffning
Terminologin kommer från beteendepsykologi. Positiv förstärkning lägger till en konsekvens som gör ett beteende mer sannolikt. Negativ förstärkning tar bort ett obehagligt tillstånd och gör också ett beteende mer sannolikt. En påföljd som syftar till att göra en handling mindre sannolik är bestraffning, inte negativ förstärkning.
Inom maskininlärning talar praktiker oftare direkt om positiva belöningar, negativa belöningar, kostnader och påföljder. Den grundläggande frågan är hur dessa signaler formar den avkastning som agenten försöker maximera.
Avkastning, värde och kreditfördelning
En belöning beskriver en övergång. Avkastningen kombinerar belöningar över tid, vanligtvis med diskontering av belöningar som kommer längre fram i framtiden. En tillståndsvärdefunktion uppskattar förväntad avkastning från ett tillstånd, medan en handlingsvärdefunktion uppskattar förväntad avkastning efter att ha tagit en viss handling i det tillståndet.
Detta skapar kredit‑tilldelningsproblemet: om ett användbart resultat kommer mycket senare, vilka tidigare handlingar förtjänar kredit? RL‑algoritmer skiljer sig åt i hur de uppskattar detta förhållande.
Monte Carlo‑ och tidsdifferens‑inlärning
Monte Carlo‑metoder lär sig från kompletta provade avkastningar, vanligtvis efter att ett avsnitt avslutats. Tidsdifferens‑metoder (TD) uppdaterar en uppskattning innan det slutgiltiga resultatet genom att kombinera den observerade belöningen med en uppskattning av vad som kommer härnäst. TD‑inlärning bootstrappar därför från sina nuvarande värdeuppskattningar.
Ingen av familjerna är universellt bättre. Monte Carlo‑mål är opartiska under den provade policyn men kan ha hög varians och kräver avsnittets slutförande. TD‑metoder kan lära sig online och från pågående uppgifter, men deras bootstrappade mål inför bias.
Utforskning kontra exploatering
Utforskning samlar information genom att prova handlingar vars värde är osäkert. Exploatering väljer den handling som för närvarande anses ge bästa avkastning. En agent som aldrig utforskar kan nöja sig med en dålig strategi; en agent som aldrig exploaterar misslyckas med att dra nytta av det den har lärt sig.
Enkla strategier inkluderar epsilon‑girig handlingsval, förtroendebaserad utforskning, entropi‑bonusar och metoder med inre belöning. I säkerhetskritiska miljöer kan obegränsad utforskning vara oacceptabel, så simulering, begränsningar, offline‑data eller mänsklig tillsyn blir viktiga.
Stora förstärkningsinlärningsmetoder
Värdebaserade metoder
Q‑learning och relaterade algoritmer lär sig handlingsvärden och härleder en policy genom att välja högvärdiga handlingar. Djup förstärkningsinlärning använder neurala nätverk för att approximera värdefunktioner eller policies när tillståndsrymder är för stora för en tabell.
Policy‑gradientmetoder
Policy‑gradientmetoder justerar direkt en parametriserad policy för att förbättra förväntad avkastning. De är användbara för kontinuerliga handlingar och stokastiska policies men kan ha gradientuppskattningar med hög varians.
Aktör‑kritiker‑metoder
En aktör väljer handlingar medan en kritiker uppskattar värde och levererar en inlärningssignal. Detta kombinerar direkt policy‑optimering med värdeuppskattning.
Modellbaserad och modellfri RL
Modellbaserade system lär sig eller använder en modell av övergångar och belöningar så att de kan planera. Modellfria system lär sig värden eller policies utan att explicit modellera miljön. Modellbaserade metoder kan utnyttja erfarenhet effektivt, men fel i den inlärda modellen kan vilseleda planeringen.
Offline‑förstärkningsinlärning
Offline‑RL lär sig från ett fast dataset istället för att samla nya interaktioner under träning. Det kan minska kostnaden eller risken för utforskning, men agenten måste undvika att överskatta handlingar som är dåligt representerade i datan.
RLHF och mänskliga preferenser
Förstärkningsinlärning från mänsklig återkoppling (RLHF) använder preferensdata för att träna en belöningssignal eller direkt optimera en policy. Det har använts för att anpassa språkmodellsbeteende till mänskliga bedömningar. Preferensoptimering är ingen garanti för sanning eller säkerhet: resultat beror på vem som levererade återkopplingen, vad de ombads bedöma och hur målet konstruerades.
Begränsningar
RL kan kräva enorma mängder interaktioner, bete sig ostabilt under träning och utnyttja oavsiktliga genvägar i en belöningsfunktion. Utvärdering är svår eftersom resultat kan variera med slumpmässiga frön och miljödetaljer. God praxis inkluderar flera körningar, transparenta baslinjer, begränsade mål, testning utanför fördelningsområdet och övervakning för belöningsmanipulation.
Designa ett RL‑problem: tillstånd, handling, belöning och horisont
Förstärkningsinlärning modellerar sekventiella beslut. Miljön producerar en observation, agenten väljer en handling enligt en policy, och en övergång ger en belöning och nästa observation. En Markovbeslutsprocess förutsätter att tillståndet innehåller information som behövs för att förutsäga framtida övergångar och belöningar; partiell observerbarhet kräver minne, tro‑tillstånd eller återkommande representationer. Diskontering styr vikten av fördröjda resultat, medan episodiska och fortsatta uppgifter kräver olika avkastningsdefinitioner. Dålig design av tillstånd eller handling kan göra ett lösbart mål oinlärbart.
Belöningsdesign specificerar beteende indirekt och är en stor felkälla. En proxy kan utnyttjas: en agent som belönas för hastighet kan ignorera säkerhet, medan en som endast belönas vid uppgiftsavslut kan få för lite inlärningssignal. Lägg till begränsningar och avslutningsregler baserade på verkliga krav, testa belöningskänslighet och granska banor för oavsiktliga strategier. Utforskningsmetoder balanserar informationsinsamling med exploatering av befintlig kunskap. Off‑policy‑data kan förbättra proveffektiviteten, men mismatch mellan beteende‑ och målpolicy kräver algoritmer som är designade för detta.
Utvärdering, simulering och säker driftsättning
Värdebaserade metoder uppskattar förväntad avkastning för tillstånd eller handlingar; policy‑gradientmetoder optimerar en parametriserad policy; aktör‑kritiker‑metoder lär sig båda. Modellbaserad RL lär sig eller använder övergångsdynamik för planering. Den lämpliga familjen beror på handlingstyp, data, simulators noggrannhet, horisont och stabilitetskrav. Jämför mot heuristiska, övervakade och reglerteoribaserade baslinjer. Utvärdera genomsnittlig och värsta fall‑avkastning, begränsningsöverträdelse, proveffektivitet, robusthet mot miljöförändringar och varians över frön snarare än att välja en körning med den bästa inlärningskurvan.
Online‑utforskning kan vara oacceptabel inom hälso‑ och sjukvård, finans, robotik och infrastruktur. Träna i simulering eller med loggade data där det är möjligt, kvantifiera gapet mellan simulator och verklighet, och använd off‑policy‑utvärdering noggrant eftersom osedda handlingar saknar stöd. Driftsättning bör begränsa handlingar, hastighet, resurser och driftsområde; inkludera mänskligt godkännande för avgörande val; och tillhandahålla en säker regulator eller avstängning. Övervaka belöning tillsammans med faktiska resultat eftersom en agent kan förbättra sin poäng samtidigt som den skadar det avsedda målet. Validera på nytt efter förändringar i miljö, policy eller belöning.
Arbetsexempel: energistyrning med förstärkningsinlärning
En byggnadsoperatör modellerar temperatur, beläggning, väder, utrustningstillstånd och elpris, med handlingar begränsade till säkra setpunktjusteringar. Belöningen kombinerar komfort, energi, efterfrågeavgifter och utrustningsbegränsningar, men faktiska komfortöverträdelse utvärderas separat så belöningsoptimering inte kan dölja skada. Historisk styrning och modell‑prediktiv styrning ger baslinjer. Träning använder en kalibrerad simulator med slumpmässigt väder, sensors brus och utrustningseffektivitet.
Innan byggnaden påverkas kör policyn mot levande observationer utan att agera. Ingenjörer inspekterar banor, begränsningsmarginaler och beteende under helgdagar, värmeböljor, strömavbrott och saknade sensorer. Driftsättning begränsar handlingsfrekvens och räckvidd samt behåller den befintliga säkerhetsregulatorn. En människa kan åsidosätta när som helst. Övervakning jämför energi och komfort med matchade perioder, registrerar ingripanden och återställer om överträdelser, oväntad cykling eller modell‑mismatch överstiger definierade trösklar.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionshanterad utvärderingsuppsättning före finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter driftsättning snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incident‑lärande, raderings‑ och behållningsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Primära referenser












