
Fundamentele AI
Ce este otrăvirea datelor? Cum corup atacatorii modelele și seturile de date de IA
Otrăvirea datelor manipulează datele de antrenare, de ajustare fină, de evaluare sau de regăsire, astfel încât un sistem de IA să învețe un comportament corupt sau să producă rezultate alese de atacator. Acest ghid explică mecanismul, compromisurile, evaluarea și măsurile de control relevante în practică.

 Adaugă Unite.AI la sursele tale preferate pe Google
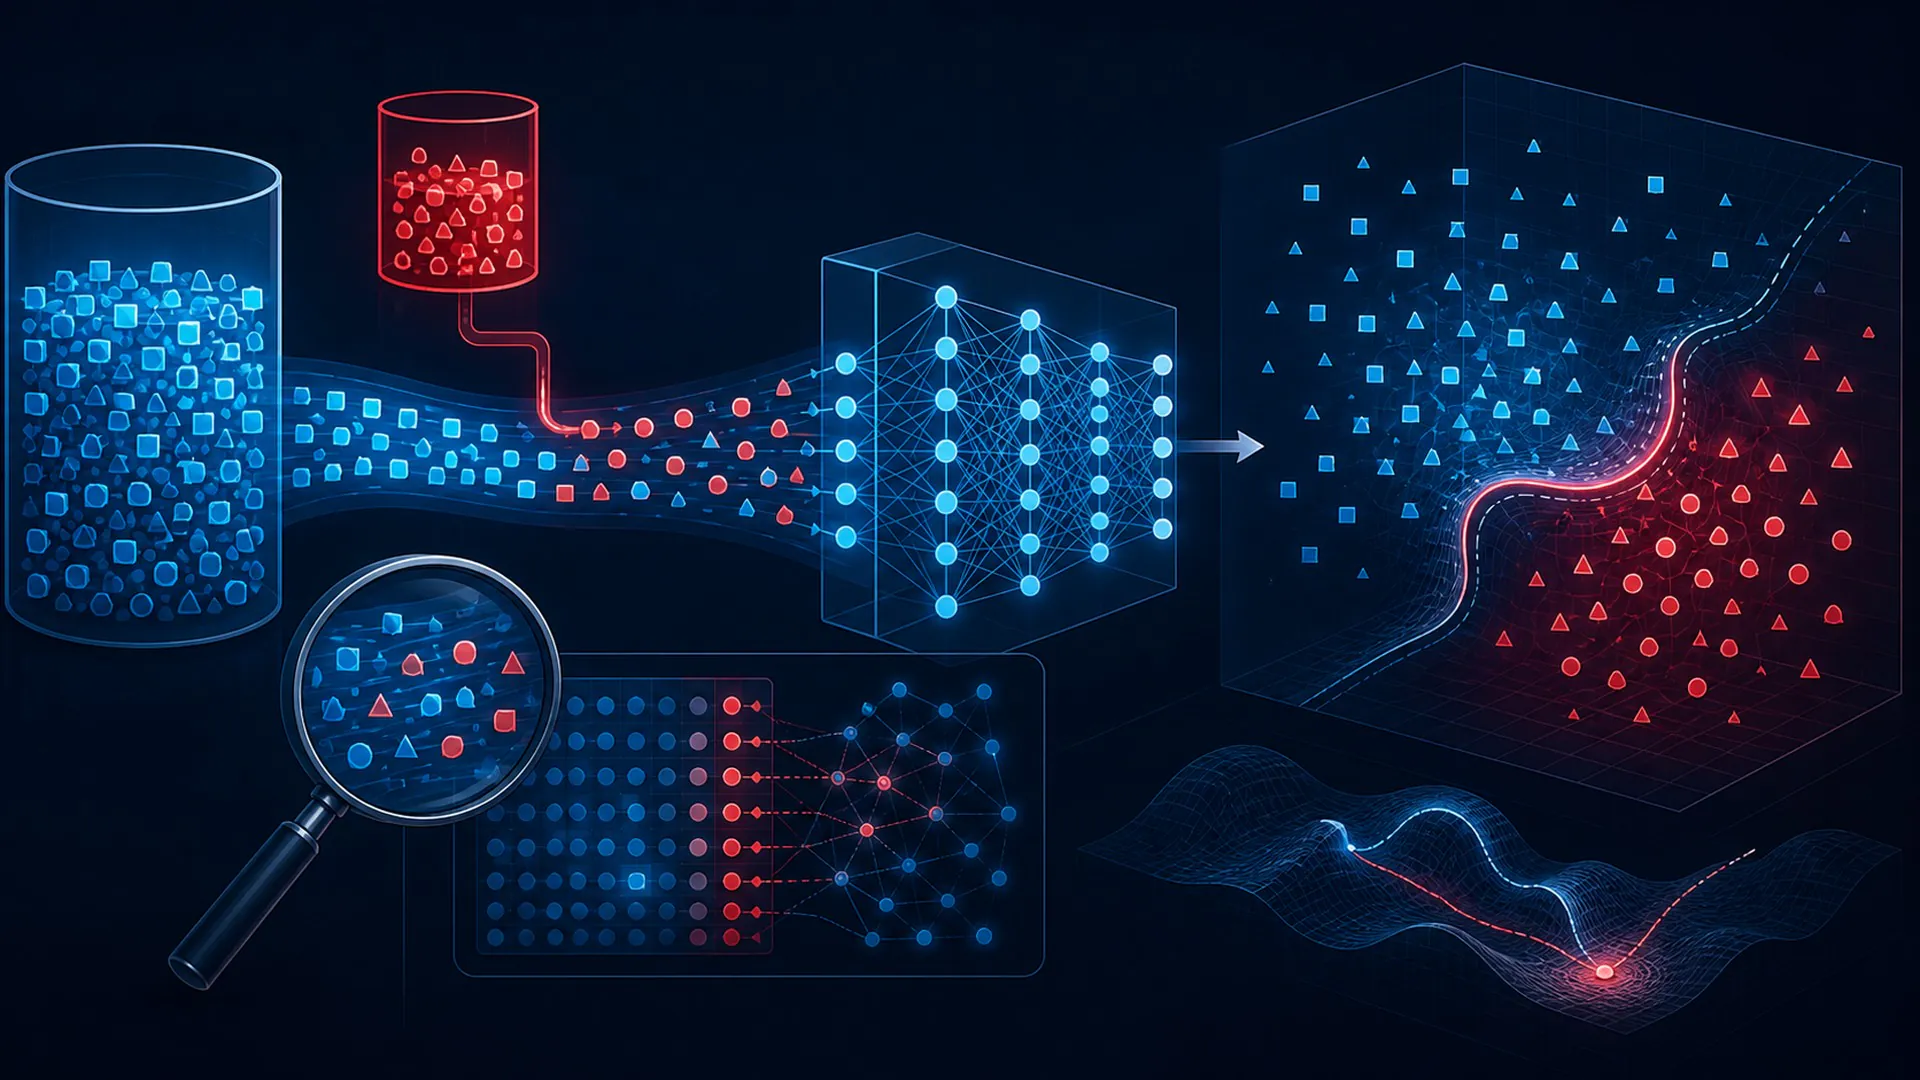
Otrăvirea datelor manipulează datele de antrenare, de ajustare fină, de evaluare sau de regăsire, astfel încât un sistem de IA să învețe comportamente corupte sau să producă rezultate alese de atacator.
Otrăvirea datelor merită o explicație precisă, deoarece denumirea sa desemnează un anumit flux de informații, o alegere legată de antrenare, un mecanism de execuție sau o limită de guvernanță. Dacă este tratată ca sinonim pentru „IA avansată”, afirmațiile devin imposibil de verificat. Acest ghid urmărește conceptul de la datele de intrare și ipotezele sale până la rezultatul observabil, apoi analizează scurtătura cel mai ușor de confundat cu acesta.
Otrăvirea datelor: definiție, limite și scop
Otrăvirea datelor manipulează datele de antrenare, de ajustare fină, de evaluare sau de regăsire, astfel încât un sistem de IA să învețe comportamente corupte sau să producă rezultate alese de atacator. Definiția presupune trei angajamente practice: existența unei date de intrare identificabile, a unei transformări sau decizii caracteristice otrăvirii datelor și a unui rezultat care poate fi evaluat în raport cu un obiectiv declarat. Dacă lipsește unul dintre aceste elemente, eticheta poate descrie o aspirație, nu un mecanism implementat.
IA de încredere necesită dovezi de-a lungul întregului ciclu de viață. Un mecanism de control are sens numai dacă sunt precizate responsabilul, domeniul de aplicare, declanșatorul, comportamentul așteptat și metoda de verificare. În cazul otrăvirii datelor, această perspectivă asupra sistemului este importantă, deoarece performanța poate fi determinată de datele, interfețele, hardware-ul, permisiunile și persoanele din jur, chiar și atunci când modelul de bază rămâne neschimbat. Prin urmare, o explicație utilă separă comportamentul învățat de model de produsul care decide când, unde și cu ce autoritate este folosit acel comportament.
Cea mai apropiată scurtătură înșelătoare este un atac de evaziune aplicat numai după implementarea modelului. Acesta poate avea o trăsătură vizibilă în comun cu otrăvirea datelor, dar schimbă explicația cauzală: succesul ar trebui demonstrat prin alte dovezi, costurile ar fi dominate de alte resurse, iar prevenirea prejudiciilor ar necesita alte mecanisme de control. Prin urmare, limita este una operațională, nu terminologică.
O hartă operațională în cinci etape a otrăvirii datelor
Diagrama este o hartă cauzală compactă a otrăvirii datelor, nu o afirmație potrivit căreia fiecare implementare folosește cinci componente software. Unele sisteme combină etapele, iar altele le repetă într-o buclă. Harta rămâne utilă deoarece impune ca fiecare schimbare de informație sau de autoritate să aibă un responsabil, o intrare, o ieșire și un test.
1. Obținerea influenței asupra unei surse de date: datele de intrare și ipotezele otrăvirii datelor
În această etapă a otrăvirii datelor, sistemul trebuie să obțină influență asupra unei surse de date. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații utilizează, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată deosebi operațiunea de un atac de evaziune aplicat numai după implementarea modelului și să-i poată reproduce rezultatul în aceleași condiții declarate.
Trecerea la această etapă a otrăvirii datelor pornește de la obiectivul declarat și ar trebui să se încheie cu un rezultat care să permită introducerea de exemple etichetate greșit, părtinitoare sau purtătoare de declanșatori. Înregistrați incertitudinile, alternativele respinse, resursele utilizate și orice măsură de control umană sau software aplicată la această limită. Această urmă le permite echipelor să detecteze dacă un subset mic, țintit, poate fi greu de identificat în volume de date de dimensiunea webului, înainte ca aceeași vulnerabilitate să afecteze un rezultat cu consecințe importante.
2. Introducerea de exemple etichetate greșit, părtinitoare sau purtătoare de declanșatori: reprezentarea sau decizia în otrăvirea datelor
În această etapă a otrăvirii datelor, sistemul trebuie să introducă exemple etichetate greșit, părtinitoare sau purtătoare de declanșatori. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații utilizează, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată deosebi operațiunea de un atac de evaziune aplicat numai după implementarea modelului și să-i poată reproduce rezultatul în aceleași condiții declarate.
Trecerea la această etapă a otrăvirii datelor începe cu obținerea influenței asupra unei surse de date și ar trebui să se încheie cu un rezultat care să permită supraviețuirea filtrării și eliminării duplicatelor. Înregistrați incertitudinile, alternativele respinse, resursele utilizate și orice măsură de control umană sau software aplicată la această limită. Această urmă le permite echipelor să detecteze dacă un subset mic, țintit, poate fi greu de identificat în volume de date de dimensiunea webului, înainte ca aceeași vulnerabilitate să afecteze un rezultat cu consecințe importante.
3. Să reziste filtrării și eliminării duplicatelor: transformare distinctivă în otrăvirea datelor
În această etapă a otrăvirii datelor, sistemul trebuie să reziste filtrării și eliminării duplicatelor. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații folosește, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge această operațiune de un atac prin evaziune aplicat abia după implementarea modelului și să-i poată reproduce rezultatul în aceleași condiții declarate.
Transferul către această etapă a otrăvirii datelor începe cu inserarea unor exemple etichetate greșit, părtinitoare sau care conțin declanșatori și ar trebui să se încheie cu un rezultat care să permită modificarea modelului antrenat sau a contextului recuperat. Înregistrați incertitudinile, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această trasabilitate le permite echipelor să detecteze dacă un subset mic, selectat în mod țintit, poate fi dificil de identificat în date la scară web, înainte ca aceeași vulnerabilitate să afecteze un rezultat cu consecințe importante.
4. Modificarea modelului antrenat sau a contextului recuperat: limită de constrângere și verificare în otrăvirea datelor
În această etapă a otrăvirii datelor, sistemul trebuie să modifice modelul antrenat sau contextul recuperat. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații folosește, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge această operațiune de un atac prin evaziune aplicat abia după implementarea modelului și să-i poată reproduce rezultatul în aceleași condiții declarate.
Transferul către această etapă a otrăvirii datelor începe cu rezistența la filtrare și la eliminarea duplicatelor și ar trebui să se încheie cu un rezultat care să permită activarea unei degradări generalizate sau a unui backdoor țintit. Înregistrați incertitudinile, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această trasabilitate le permite echipelor să detecteze dacă un subset mic, selectat în mod țintit, poate fi dificil de identificat în date la scară web, înainte ca aceeași vulnerabilitate să afecteze un rezultat cu consecințe importante.
5. Activarea unei degradări generalizate sau a unui backdoor țintit: rezultat, feedback și regulă de oprire în otrăvirea datelor
În această etapă a otrăvirii datelor, sistemul trebuie să activeze o degradare generalizată sau un backdoor țintit. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații folosește, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge această operațiune de un atac prin evaziune aplicat abia după implementarea modelului și să-i poată reproduce rezultatul în aceleași condiții declarate.
Transferul către această etapă a otrăvirii datelor începe cu modificarea modelului antrenat sau a contextului recuperat și ar trebui să se încheie cu un rezultat care să permită monitorizarea sau luarea unei decizii finale. Înregistrați incertitudinile, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această trasabilitate le permite echipelor să detecteze dacă un subset mic, selectat în mod țintit, poate fi dificil de identificat în date la scară web, înainte ca aceeași vulnerabilitate să afecteze un rezultat cu consecințe importante.
Parcurgeți schema otrăvirii datelor în ordine pentru a înțelege producția și în sens invers pentru a diagnostica defecțiunile. Analiza în ordine urmărește modul în care o etapă o alimentează pe următoarea. Analiza inversă pornește de la un rezultat incorect, lent, costisitor sau nesigur și identifică ipoteza anterioară care l-a permis. Adesea, pe traseul invers, echipa descoperă că eroarea decisivă s-a produs înainte ca modelul să genereze vreun rezultat.
Un exemplu concret de otrăvire a datelor
Un atacator poate introduce exemple care învață un clasificator să asocieze o mică zonă vizuală rară cu o etichetă de încredere.
Acest exemplu este relevant deoarece otrăvirea datelor poate fi evaluată prin raportare la intrări observabile, stări intermediare și un rezultat, nu printr-o demonstrație bine pregătită. Un test riguros ar construi cazuri obișnuite, dificile și înșelătoare în mod deliberat în jurul scenariului, ar păstra un reper de bază fără această tehnică și ar înregistra atât performanța medie, cât și gravitatea defecțiunilor individuale.
Modificați o ipoteză din exemplul de otrăvire a datelor și repetați analiza. Eliminați o intrare necesară, introduceți un semnal contradictoriu, limitați resursele de calcul, modificați populația de utilizatori sau obligați sistemul să se abțină. Un mecanism care reușește doar într-o demonstrație atent regizată nu a dovedit că se generalizează la mediul operațional.
Otrăvirea datelor și cea mai frecventă scurtătură
Otrăvirea datelor este adesea redusă la un atac prin evaziune aplicat abia după implementarea modelului. Această simplificare elimină tocmai limita care definește conceptul. Drept urmare, cumpărătorii pot ajunge să compare produse diferite, cercetătorii să exagereze ceea ce demonstrează un experiment, iar operatorii să monitorizeze semnalul greșit după implementare.
| Perspectivă | Răspuns practic |
|---|---|
| Definiție | Otrăvirea datelor modifică datele de antrenare, de ajustare fină, de evaluare sau de regăsire, astfel încât un sistem de inteligență artificială să învețe comportamente corupte sau să producă rezultate alese de atacator. |
| Confuzie | un atac de evaziune aplicat doar după implementarea modelului. |
| Risc | un subset țintit minuscul poate fi greu de detectat în date la scară web. |
Comparația ar trebui să identifice și unitatea de analiză. O lucrare despre otrăvirea datelor poate analiza separat un model sau un algoritm, în timp ce un serviciu implementat adaugă regăsirea, rutarea, memorarea în cache, politicile, identitatea, interfețele utilizator și monitorizarea. Două produse pot folosi același termen în titlu, dar pot implementa componente diferite ale acelei stive. Întrebați-vă ce componentă realizează transformarea definitorie și ce alte componente sunt necesare pentru rezultatul raportat.
De ce contează otrăvirea datelor în sistemele actuale de inteligență artificială
Otrăvirea datelor contează acum, deoarece sistemele de inteligență artificială primesc contexte mai ample, mai multe modalități, mai multă putere de calcul în timpul rulării, acces mai extins la instrumente și legături mai profunde cu deciziile organizaționale. În aceste condiții, ceea ce părea cândva un detaliu de cercetare poate determina latența, securitatea, accesibilitatea, costul de mediu, calitatea produsului sau răspunderea juridică.
Criteriul relevant nu este dacă otrăvirea datelor poate produce un singur rezultat impresionant. Important este dacă tehnica îmbunătățește un rezultat semnificativ în condiții reprezentative și dacă o face mai eficient decât o metodă de referință mai simplă. Raportați distribuțiile, categoriile de eșecuri, latența la percentilele extreme, utilizarea resurselor și subgrupurile afectate, în loc să comprimați toate rezultatele într-o singură medie.
Monitorizați atât indicatorii tehnici, cât și impactul asupra oamenilor. Documentați incertitudinea, păstrați trasabilitatea, permiteți escaladarea și proiectați măsuri de recuperare înainte ca sistemul să fie expus unor condiții reale aflate în schimbare. Aplicată în mod specific otrăvirii datelor, această disciplină face ca dovezile să poată fi folosite și în alte contexte: o altă echipă poate evalua dacă este probabil ca îmbunătățirea declarată să se mențină în cazul unui model, al unei limbi, al unei platforme hardware, al unui set de date, al unei populații de utilizatori sau al unui nivel de toleranță la risc diferit.
Beneficiile pe care le poate aduce otrăvirea datelor
Cel mai puternic argument în favoarea utilizării otrăvirii datelor este că aceasta poate aborda direct blocajul vizat. În funcție de implementare, beneficiul se poate manifesta printr-o ancorare mai bună, o reprezentare mai fidelă, o generalizare îmbunătățită, o latență mai mică, mai puțină deplasare a datelor în memorie, o responsabilitate mai clară sau o delimitare mai sigură între propunerea unui model și o acțiune reală.
Beneficiile ar trebui exprimate prin decizii și măsurători. „Mai inteligent” nu este un criteriu de acceptare pentru otrăvirea datelor. Un obiectiv util ar putea preciza rata erorilor în cazurile dificile, capacitatea de recuperare după apariția unor dovezi contradictorii, costul la un anumit percentil al traficului, timpul necesar verificării umane, calibrarea sau procentul de acțiuni menținute în limitele de autoritate definite.
Modul de eșec care definește otrăvirea datelor
Principala limitare este că un subset țintit minuscul poate fi greu de detectat în date la scară web. Acest mod de eșec nu este un aspect secundar de menționat abia după încheierea dezvoltării. Încă de la început, el ar trebui să influențeze colectarea datelor, arhitectura, permisiunile, evaluarea, criteriile de lansare și monitorizarea otrăvirii datelor.
O măsură de control pentru otrăvirea datelor este utilă numai dacă intervine înainte de apariția unei consecințe costisitoare sau ireversibile. Identificați cel mai timpuriu precursor observabil al eșecului, stabiliți un prag sau o regulă, desemnați un responsabil și testați recuperarea. În funcție de cazul de utilizare, recuperarea poate însemna abținerea de la un răspuns, revenirea la un sistem mai simplu, solicitarea unor dovezi suplimentare, escaladarea către o persoană, revenirea la o versiune anterioară a modelului sau oprirea completă a unei acțiuni.
Un plan de evaluare a otrăvirii datelor
Începeți evaluarea otrăvirii datelor formulând decizia pe care trebuie să o susțină dovezile. Definiți populația vizată, consecințele unui rezultat greșit, informațiile disponibile efectiv în momentul luării deciziei și cea mai simplă alternativă credibilă. Astfel, evitați ca un benchmark să devină scopul în sine doar pentru că este ușor de rulat.
Folosiți un set de testare neatins pentru comparații controlate, apoi validați otrăvirea datelor într-un mediu operațional etapizat. Evaluarea offline permite compararea variantelor; modul de umbră, testele canary, limitele de rată sau porțile de aprobare arată cum modifică comportamentul traficul real, buclele de feedback și oamenii. Etapa de implementare ar trebui să aibă o condiție explicită de oprire, în loc să se presupună că orice îmbunătățire merită o implementare completă.
Înregistrați versiunile intrărilor necesare pentru a reproduce otrăvirea datelor: datele-sursă, preprocesarea, tokenizerul sau codificatorul, ponderile modelului, configurația, promptul sau politica, indexul de regăsire, setul de evaluare, ipotezele privind hardware-ul și codul de servire, după caz. Fără trasabilitate, o echipă nu poate stabili dacă un rezultat modificat se datorează tehnicii, mediului sau unei modificări neobservate a fluxului de procesare.
În cele din urmă, întrebați-vă ce constatare ar infirma afirmația că otrăvirea datelor este utilă. Dacă niciun rezultat nu ar putea schimba decizia de adoptare, evaluarea este doar marketing. Pragurile de acceptare stabilite în prealabil și un set de confirmare păstrat transformă demersul în dovezi.
Întrebări de pus înainte de adoptarea otrăvirii datelor
- Obiectiv: Ce blocaj măsurabil ar trebui să rezolve otrăvirea datelor?
- Mecanism: În care dintre cele cinci etape are loc transformarea specifică?
- Reper de comparație: Cum se compară cu un atac de evitare aplicat numai după implementarea modelului sau cu o altă alternativă mai simplă?
- Dovezi: Ce cazuri obișnuite, dificile, adversariale și din subgrupuri au fost testate?
- Operațiuni: Ce costuri de latență, memorie, calcul, energie, întreținere și revizuire apar la scară largă?
- Risc: Cum va detecta echipa faptul că un subset minuscul, țintit, poate fi dificil de detectat în datele de la scară web?
- Recuperare: Poate sistemul să se abțină de la un răspuns, să recurgă la o soluție de rezervă, să revină la o versiune anterioară sau să escaladeze situația înainte de producerea unui prejudiciu?
Surse principale pentru studierea otrăvirii datelor
Punctele de pornire autorizate pentru partea din stiva IA care înconjoară otrăvirea datelor includ Cadrul NIST de management al riscurilor IA, specificațiile C2PA și Cadrul NIST de confidențialitate. Consultați-le împreună cu documentația modelului, setului de date, hardware-ului și jurisdicției specifice în cauză. O sursă generală poate defini mecanismul, dar numai dovezile specifice implementării pot stabili dacă o anumită punere în practică este adecvată.
Ce trebuie reținut despre otrăvirea datelor
Otrăvirea datelor este un mecanism definit în cadrul unui sistem sociotehnic mai amplu. Valoarea sa constă în îmbunătățirea unui rezultat specific în condiții explicite, nu în eticheta în sine. Schema în cinci etape face vizibil fluxul informațional, comparația arată ce nu este otrăvirea datelor, iar traseul de control indică unde poate interveni un operator responsabil.
Regula practică pentru otrăvirea datelor este să definiți obiectivul, să îl comparați cu un reper credibil, să testați defecțiunea cea mai importantă și să păstrați dovezile necesare pentru monitorizarea schimbărilor. Odată îndeplinite aceste condiții, conceptul devine o opțiune de inginerie și guvernanță care poate fi evaluată. În lipsa lor, rămâne doar o denumire promițătoare asociată unui risc operațional necunoscut.



