
Fundamentele AI
Ce sunt gardurile de protecție AI? Cum controlează sistemele de producție comportamentul modelului
Gardurile AI sunt controale tehnice și procedurale stratificate care restricționează intrările, acțiunile, ieșirile și escaladarea în jurul unui model sau agent. Acest ghid explică mecanismul, compromisurile, evaluarea și controalele care contează în practică.

 Adaugă Unite.AI la sursele tale preferate pe Google
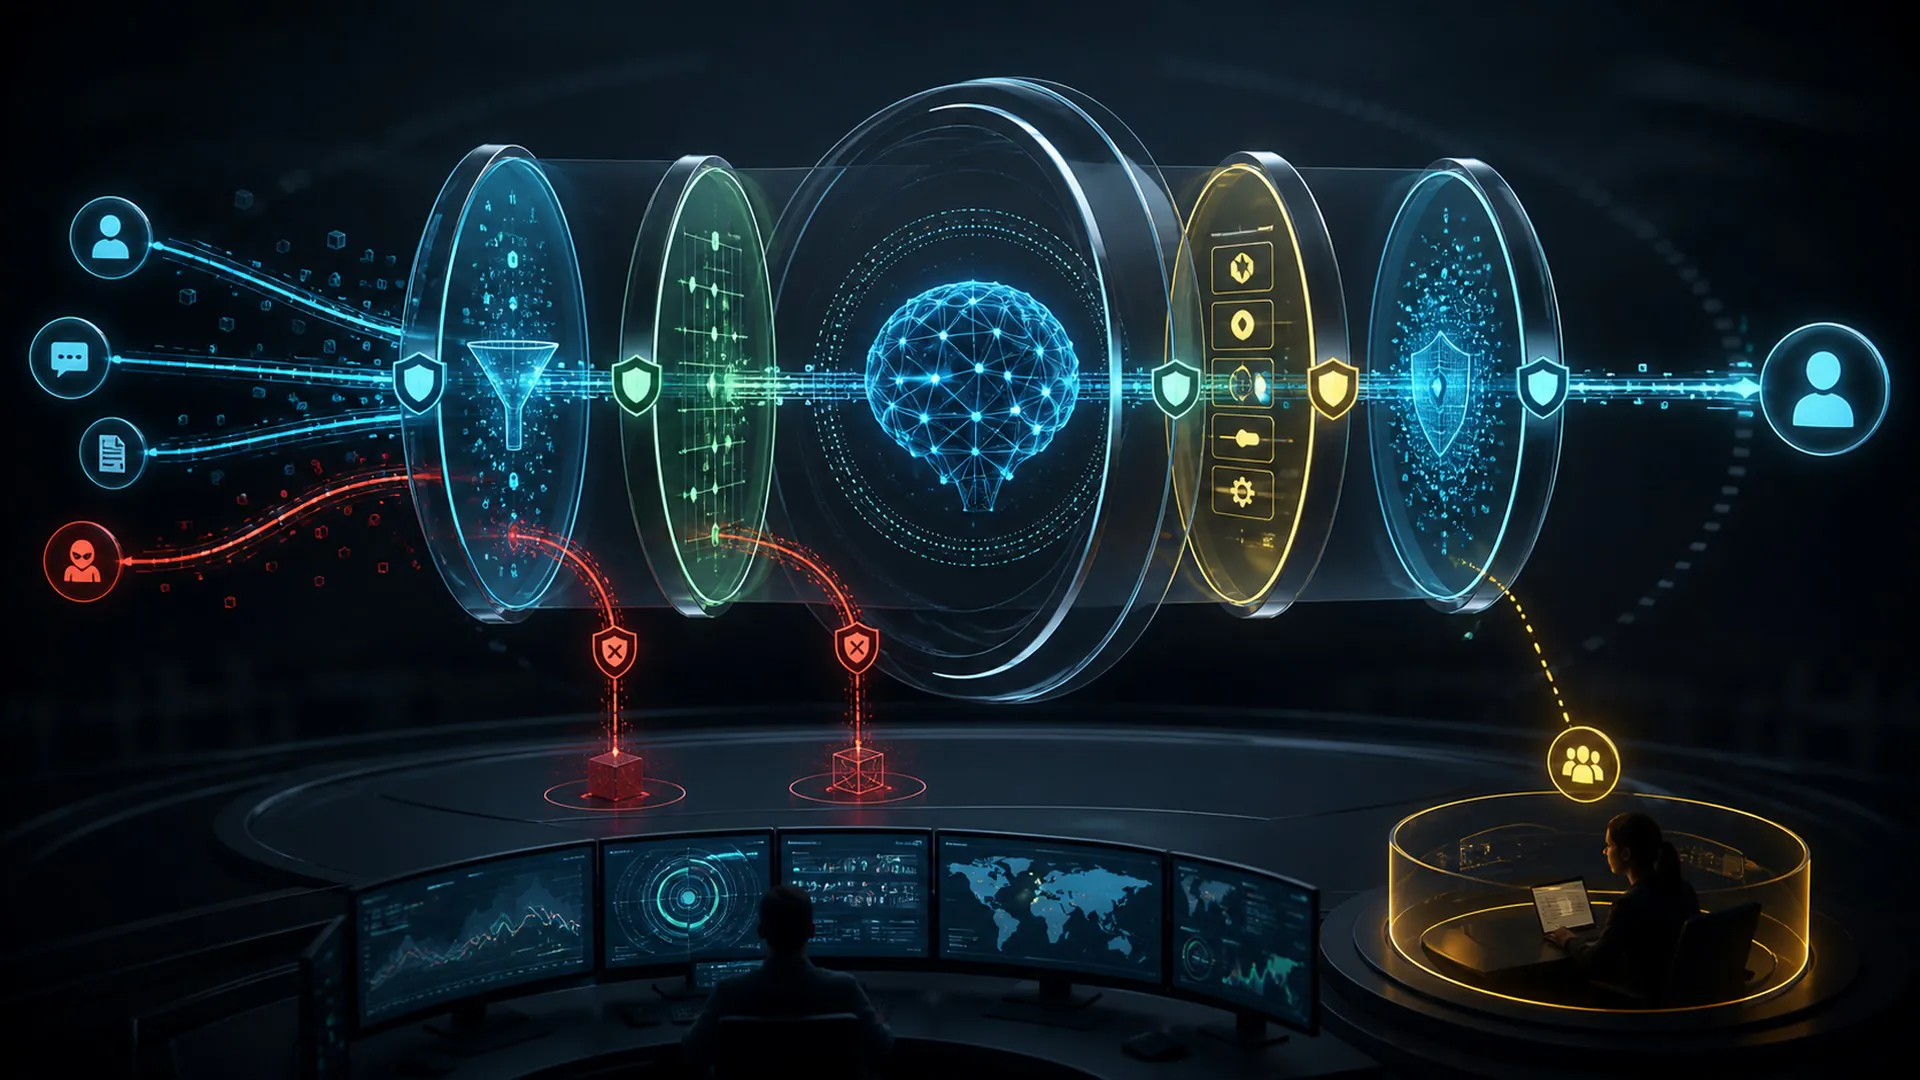
Gardurile de protecție AI sunt controale tehnice și procedurale stratificate care restricționează intrările, acțiunile, ieșirile și escaladarea în jurul unui model sau agent.
Gardurile de protecție AI necesită o explicație precisă deoarece denumirea lor identifică un flux specific de informații, o alegere de antrenament, un mecanism de rulare sau o limită de guvernanță. Tratarea lor ca sinonim pentru „AI avansată” face ca afirmațiile să fie imposibil de testat. Acest ghid urmărește conceptul de la intrare și presupuneri până la rezultatul său observabil, apoi testează scurtătura cea mai susceptibilă să fie confundată cu acesta.
Gardurile de protecție AI: definiție, limită și scop
Gardurile de protecție AI sunt controale tehnice și procedurale stratificate care restricționează intrările, acțiunile, ieșirile și escaladarea în jurul unui model sau agent. Definiția conține trei angajamente practice: există o intrare identificabilă, o transformare sau decizie caracteristică gardurilor de protecție AI și un rezultat care poate fi evaluat în raport cu un obiectiv declarat. Dacă unul dintre aceste elemente lipsește, eticheta poate descrie o aspirație mai degrabă decât un mecanism implementat.
AI de încredere necesită dovezi pe parcursul întregului ciclu de viață. Un control are sens numai când proprietarul, domeniul, declanșatorul, comportamentul așteptat și metoda de verificare sunt explicite. Pentru gardurile de protecție AI, această perspectivă sistemică este importantă deoarece performanța poate fi determinată de datele, interfețele, hardware-ul, permisiunile și oamenii din jur, chiar și atunci când modelul de bază rămâne neschimbat. O explicație utilă separă, așadar, comportamentul învățat al modelului de produsul care decide când, unde și cu ce autoritate este utilizat acel comportament.
Scurtătura înșelătoare cea mai apropiată este un singur prompt de sistem așteptat să impună fiecare limită. Poate împărtăși o caracteristică vizibilă cu gardurile de protecție AI, totuși modifică povestea cauzală: dovezi diferite ar stabili succesul, resurse diferite ar domina costul și controale diferite ar preveni daunele. Limita este, așadar, operațională și nu terminologică.
O hartă operațională în cinci etape a gardurilor de protecție AI
Diagrama este o hartă cauzală compactă pentru gardurile de protecție AI, nu o afirmație că fiecare implementare folosește cinci componente software. Unele sisteme combină etapele, altele le repetă într-un ciclu. Harta rămâne utilă deoarece impune ca fiecare schimbare în informație sau autoritate să aibă un proprietar, o intrare, o ieșire și un test.
1. Clasificați cererea și politica aplicabilă: intrare și presupuneri în gardurile de protecție AI
În această etapă a gardurilor de protecție AI, sistemul trebuie să clasifice cererea și politica aplicabilă. Întrebarea utilă nu este doar dacă acea operație are loc, ci ce informație consumă, ce stare modifică și ce dovezi dovedesc că modificarea a fost validă. Un revizor ar trebui să poată distinge operația de un singur prompt de sistem așteptat să impună fiecare limită și să reproducă rezultatul său în aceleași condiții declarate.
Transferul în această etapă a gardurilor de protecție AI începe cu obiectivul declarat și ar trebui să se încheie cu un rezultat care poate susține restricționarea contextului, instrumentelor și accesului la date. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Acea urmă este locul în care echipele pot detecta dacă gardurile pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță înainte ca aceeași slăbiciune să ajungă la o ieșire semnificativă.
2. Restricționați contextul, instrumentele și accesul la date: reprezentare sau decizie în gardurile de protecție AI
În această etapă a gardurilor de protecție AI, sistemul trebuie să restricționeze contextul, instrumentele și accesul la date. Întrebarea utilă nu este doar dacă acea operație are loc, ci ce informație consumă, ce stare modifică și ce dovezi dovedesc că modificarea a fost validă. Un revizor ar trebui să poată distinge operația de un singur prompt de sistem așteptat să impună fiecare limită și să reproducă rezultatul său în aceleași condiții declarate.
Transferul în această etapă a gardurilor de protecție AI începe cu clasificarea cererii și a politicii aplicabile și ar trebui să se încheie cu un rezultat care poate susține validarea acțiunilor propuse înainte de execuție. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Acea urmă este locul în care echipele pot detecta dacă gardurile pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță înainte ca aceeași slăbiciune să ajungă la o ieșire semnificativă.
3. Validarea acțiunilor propuse înainte de execuție: Transformare distinctivă în cadrul AI Guardrails
În această etapă a AI Guardrails, sistemul trebuie să valideze acțiunile propuse înainte de execuție. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că schimbarea a fost validă. Un revizor ar trebui să poată diferenția operația de un singur prompt de sistem așteptat să impună fiecare limită și să reproducă rezultatul în aceleași condiții declarate.
Transferul către această etapă a AI Guardrails începe cu restricționarea contextului, a instrumentelor și a accesului la date și ar trebui să se încheie cu un rezultat care să poată susține inspectarea ieșirilor și a stării modificate. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Acea urmă este locul în care echipele pot detecta dacă guardrails pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță înainte ca aceeași slăbiciune să ajungă la o ieșire cu consecințe.
4. Inspectarea ieșirilor și a stării modificate: Limită de constrângere și verificare în AI Guardrails
În această etapă a AI Guardrails, sistemul trebuie să inspecteze ieșirile și starea modificată. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că schimbarea a fost validă. Un revizor ar trebui să poată diferenția operația de un singur prompt de sistem așteptat să impună fiecare limită și să reproducă rezultatul în aceleași condiții declarate.
Transferul către această etapă a AI Guardrails începe cu validarea acțiunilor propuse înainte de execuție și ar trebui să se încheie cu un rezultat care să poată susține escaladarea, înregistrarea și îmbunătățirea din incidente. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Acea urmă este locul în care echipele pot detecta dacă guardrails pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță înainte ca aceeași slăbiciune să ajungă la o ieșire cu consecințe.
5. Escaladare, înregistrare și îmbunătățire din incidente: Ieșire, feedback și regulă de oprire în AI Guardrails
În această etapă a AI Guardrails, sistemul trebuie să escaladeze, să înregistreze și să îmbunătățească din incidente. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că schimbarea a fost validă. Un revizor ar trebui să poată diferenția operația de un singur prompt de sistem așteptat să impună fiecare limită și să reproducă rezultatul în aceleași condiții declarate.
Transferul către această etapă a AI Guardrails începe cu inspectarea ieșirilor și a stării modificate și ar trebui să se încheie cu un rezultat care să poată susține monitorizarea sau o decizie finală. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Acea urmă este locul în care echipele pot detecta dacă guardrails pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță înainte ca aceeași slăbiciune să ajungă la o ieșire cu consecințe.
Citiți harta AI Guardrails în direcție înainte pentru a înțelege producția și înapoi pentru a diagnostica eșecul. Analiza în avans întreabă cum o etapă furnizează următoarea. Analiza înapoi începe de la un rezultat incorect, lent, costisitor sau nesigur și urmărește ce presupunere anterioară l-a permis. Calea inversă este adesea locul în care o echipă descoperă că eroarea decisivă a avut loc înainte ca modelul să producă ceva.
Un exemplu practic de AI Guardrails
Un asistent financiar poate redacta o instrucțiune de transfer, dar o regulă deterministă și un revizor autorizat trebuie să aprobe execuția.
Acest exemplu este informativ deoarece AI Guardrails poate fi legat de intrări observabile, stări intermediare și un rezultat, în loc să fie evaluat printr-o demonstrație lustruită. Un test riguros ar construi cazuri obișnuite, dificile și deliberat înșelătoare în jurul scenariului, ar păstra un punct de referință fără tehnică și ar înregistra atât performanța medie, cât și severitatea eșecurilor individuale.
Modificați o presupunere în exemplul AI Guardrails și repetați analiza. Eliminați o intrare obligatorie, introduceți un semnal contradictoriu, limitați calculul, alterați populația de utilizatori sau forțați sistemul să se abțină. Un mecanism care reușește doar într-o demonstrație atent aranjată nu a demonstrat că se generalizează la mediul de operare.
AI Guardrails vs. cea mai comună scurtătură a sa
AI Guardrails este adesea redus la un singur prompt de sistem așteptat să impună fiecare limită. Această reducere elimină însă limita care definește conceptul. Poate determina cumpărătorii să compare produse inadecvate, cercetătorii să exagereze ceea ce demonstrează un experiment și operatorii să monitorizeze semnalul greșit după implementare.
| Lentilă | Răspuns practic |
|---|---|
| Definiție | Gardurile AI sunt controale tehnice și procedurale stratificate care restricționează intrările, acțiunile, ieșirile și escaladarea în jurul unui model sau agent. |
| Confuzie | se așteaptă un singur prompt de sistem pentru a impune fiecare limită. |
| Risc | gardurile pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță. |
Comparația ar trebui să identifice, de asemenea, unitatea de analiză. Un articol despre gardurile AI poate izola un model sau un algoritm, în timp ce un serviciu implementat adaugă recuperare, rutare, caching, politică, identitate, interfețe de utilizator și monitorizare. Două produse pot folosi același termen de titlu, dar să implementeze părți diferite ale acelui stack. Întrebați care componentă efectuează transformarea definitorie și care alte componente sunt necesare pentru rezultatul raportat.
De ce gardurile AI contează în sistemele AI actuale
Gardurile AI contează acum deoarece sistemele AI primesc contexte mai mari, mai multe modalități, mai multă putere de calcul în timp real, acces mai larg la instrumente și conexiuni mai profunde la deciziile organizaționale. În aceste condiții, ceea ce odată părea un detaliu de cercetare poate determina latența, securitatea, accesibilitatea, costul ambiental, calitatea produsului sau responsabilitatea legală.
Măsura relevantă nu este dacă gardurile AI pot produce un rezultat impresionant. Este dacă tehnica îmbunătățește un rezultat care contează în condiții reprezentative și o face mai eficient decât un punct de referință mai simplu. Raportați distribuții, categorii de eșec, latență de coadă, utilizarea resurselor și subgrupurile afectate, în loc să comprimați fiecare rezultat într-o medie unică.
Monitorizați atât metricile tehnice, cât și impactul asupra oamenilor. Documentați incertitudinea, păstrați linia de proveniență, permiteți escaladarea și proiectați recuperarea înainte ca sistemul să fie expus la condiții reale în schimbare. Aplicat specific la gardurile AI, această disciplină face ca dovezile să fie portabile: o altă echipă poate evalua dacă câștigul revendicat este susceptibil să reziste unui model diferit, limbaj, platformă hardware, set de date, populație de utilizatori sau toleranță la risc.
Beneficiile pe care le pot oferi gardurile AI
Cel mai puternic motiv pentru a folosi gardurile AI este că pot aborda direct blocajul vizat. În funcție de implementare, beneficiul poate apărea ca o mai bună fundamentare, o reprezentare mai fidelă, o generalizare îmbunătățită, latență mai mică, reducerea mișcării memoriei, responsabilitate mai clară sau o limită mai sigură între propunerea unui model și o acțiune reală.
Beneficiile trebuie exprimate ca decizii și măsurători. „Mai inteligent” nu este un criteriu de acceptare pentru gardurile AI. Un obiectiv util ar putea specifica rata de eroare în cazuri dificile, recuperarea după dovezi contradictorii, costul la un percentil de trafic, timpul de revizuire umană, calibrarea sau procentul de acțiuni menținute în limita unei autorități definite.
Modul de eșec care definește gardurile AI
Limitarea centrală este că gardurile pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță. Acest eșec nu este un gând ulterior de enumerat odată ce dezvoltarea este finalizată. Ar trebui să modeleze colectarea de date, arhitectura, permisiunile, evaluarea, porțile de lansare și monitorizarea gardurilor AI de la început.
Un control pentru gardurile AI este util numai dacă acționează înainte de o consecință costisă sau ireversibilă. Identificați cel mai timpuriu precursor observabil al eșecului, stabiliți un prag sau o regulă, alocați un responsabil și testați recuperarea. În funcție de caz, recuperarea poate însemna abținere, revenire la un sistem mai simplu, solicitarea de dovezi suplimentare, escaladarea către o persoană, revenirea la o versiune anterioară a modelului sau oprirea completă a acțiunii.
Un plan de evaluare pentru gardurile AI
Începeți evaluarea gardurilor AI redactând decizia pe care trebuie să o susțină dovezile. Definiți populația de operare, consecința unui rezultat greșit, informațiile efectiv disponibile în momentul deciziei și cea mai simplă alternativă credibilă. Acest lucru previne ca un benchmark să devină scopul doar pentru că este ușor de rulat.
Utilizați un set de testare neatins pentru comparații controlate, apoi validați gardurile AI într-un mediu operațional etapizat. Evaluarea offline face variantele comparabile; modul umbră, canari, limitele de rată sau porțile de aprobare dezvăluie cum traficul real, buclele de feedback și oamenii își modifică comportamentul. Etapa de implementare ar trebui să aibă o condiție explicită de oprire, în loc să se presupună că fiecare îmbunătățire merită o lansare completă.
Versionați intrările necesare pentru a reproduce gardurile AI: datele sursă, preprocesarea, tokenizer-ul sau encoder-ul, greutățile modelului, configurația, promptul sau politica, indexul de recuperare, setul de evaluare, presupunerile hardware și codul de servire, după caz. Fără trasabilitate, o echipă nu poate determina dacă un rezultat modificat provine din tehnică, din mediu sau dintr-o editare net observată a fluxului de lucru.
În final, întrebați ce constatare ar falsifica afirmația că gardurile AI ajută. Dacă niciun rezultat nu ar putea inversa decizia de adoptare, evaluarea devine marketing. Pragurile de acceptare predefinite și un set de confirmare păstrat transformă exercițiul în probă.
Întrebări de pus înainte de a adopta gardurile AI
- Obiectiv: Ce blocaj măsurabil este menit să rezolve gardurile AI?
- Mecanism: Care dintre cele cinci etape conține transformarea distinctivă?
- Referință: Cum se compară cu un singur prompt de sistem așteptat să impună fiecare limită sau cu o alternativă mai simplă?
- Dovezi: Ce cazuri obișnuite, dificile, adversare și de subgrup au fost testate?
- Operațiuni: Ce costuri de latență, memorie, calcul, energie, întreținere și revizuire apar la scară?
- Risc: Cum va detecta echipa că gardurile pot bloca munca legitimă, pot fi ocolite sau pot crea o falsă senzație de siguranță?
- Recuperare: Poate sistemul să se abțină, să revină, să efectueze o revenire sau să escaladeze înainte de a produce daune?
Surse principale pentru studierea gardurilor AI
Punctele de plecare autoritare pentru partea din stiva AI care înconjoară gardurile AI includ NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Citiți-le împreună cu documentația pentru modelul exact, setul de date, hardware-ul și jurisdicția implicate. O sursă generală poate defini mecanismul, dar doar dovezile specifice implementării pot demonstra că o anumită implementare este adecvată.
Ce trebuie să rețineți despre gardurile AI
Gardurile AI reprezintă un mecanism definit în cadrul unui sistem sociotehnic mai larg. Valoarea lor provine din îmbunătățirea unui rezultat specific în condiții explicite, nu din etichetă în sine. Harta în cinci etape face fluxul de informații vizibil, comparația identifică ce nu este, iar calea de control arată unde poate interveni un operator responsabil.
Regula practică pentru gardurile AI este să definească obiectivul, să compare cu o linie de bază credibilă, să testeze eșecul care contează cel mai mult și să păstreze dovezile necesare pentru a monitoriza schimbarea. Odată ce aceste elemente sunt în loc, conceptul devine o alegere de inginerie și guvernanță care poate fi evaluată. Fără ele, rămâne un nume promițător atașat unui risc operațional necunoscut.


