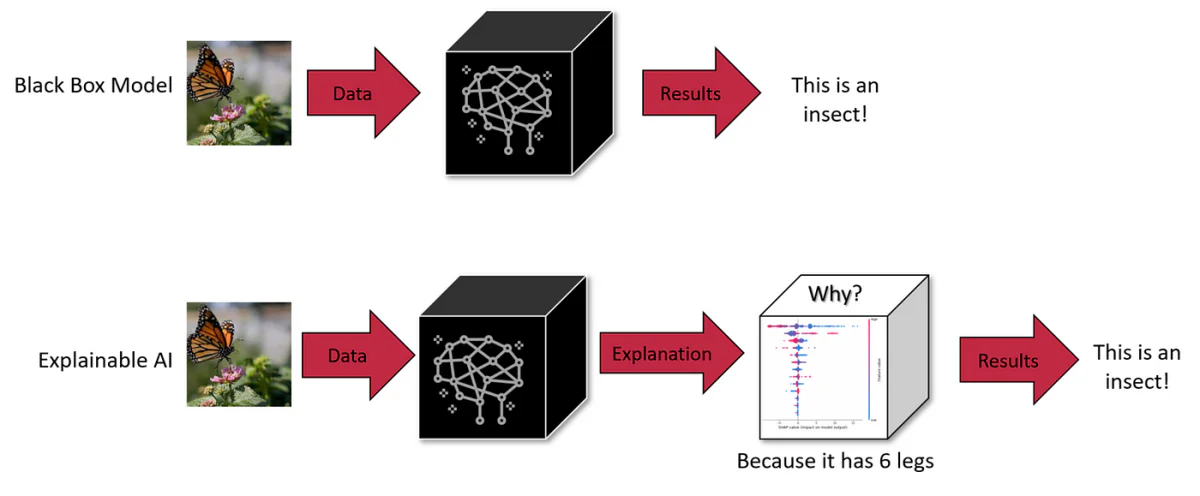
Învățarea mașinilor, o subcategorie a inteligenței artificiale, implică trei componente: algoritmi, date de antrenare și modelul rezultat. Un algoritm, în esență un set de proceduri, învață să identifice modele dintr-un set mare de exemple (date de antrenare). Rezultatul acestui antrenament este un model de învățare a mașinilor. De exemplu, un algoritm antrenat cu imagini de câini ar rezulta într-un model capabil să identifice câini în imagini.
Cutia Neagră în Învățarea Mașinilor
În învățarea mașinilor, oricare dintre cele trei componente – algoritm, date de antrenare sau model – poate fi o cutie neagră. Deși algoritmii sunt adesea cunoscuți public, dezvoltatorii pot alege să păstreze modelul sau datele de antrenare secrete pentru a proteja proprietatea intelectuală. Această obscuritate face dificilă înțelegerea procesului de luare a deciziilor al inteligenței artificiale.
Cutiile negre ale inteligenței artificiale sunt sisteme ale căror mecanisme interne rămân opace sau invizibile pentru utilizatori. Utilizatorii pot introduce date și primi ieșiri, dar logica sau codul care produce ieșirea rămâne ascuns. Acesta este un caracteristic comun în multe sisteme de inteligență artificială, inclusiv modele generative avansate precum ChatGPT și DALL-E 3.
LLM-urile, cum ar fi GPT-4, prezintă o provocare semnificativă: mecanismele lor interne sunt în mare măsură opace, făcându-le “cutii negre”. Opaicitatea nu este doar o puzzle tehnic; ridică preocupări reale de siguranță și etică. De exemplu, dacă nu putem discerne cum aceste sisteme ajung la concluzii, putem să le încredem în domenii critice precum diagnostice medicale sau evaluări financiare?
Explorarea Tehnicilor LIME și SHAP
Interpretabilitatea în învățarea mașinilor (ML) și învățarea profundă (DL) ne ajută să vedem în mecanismele interne opace ale acestor modele avansate. Explicații locale interpretabile model-agnostice (LIME) și Explicații aditive Shapley (SHAP) sunt două tehnici de interpretabilitate de uz general.
Interpretability
LIME, de exemplu, descompune complexitatea prin crearea unor modele surogat mai simple, locale, care aproximează comportamentul modelului original în jurul unei intrări specifice. Prin aceasta, LIME ajută la înțelegerea modului în care caracteristicile individuale influențează predicțiile modelelor complexe, oferind practic o “explicație locală” pentru de ce un model a luat o anumită decizie. Este deosebit de util pentru utilizatorii non-tehnici, deoarece traduce procesul complex de luare a deciziilor al modelelor în termeni mai ușor de înțeles.
Model-Agnostic Interpretability of Machine Learning (LIME) Source
SHAP, pe de altă parte, se inspiră din teoria jocurilor, în special din conceptul de valori Shapley. Atribuie o valoare de “importanță” fiecărei caracteristici, indicând cât de mult contribuie fiecare caracteristică la diferența dintre predicția reală și predicția de bază (predicția medie pe toate intrările). Forța lui SHAP constă în coerența și capacitatea sa de a oferi o perspectivă globală – nu numai că explică predicții individuale, dar oferă și insight-uri despre modelul în ansamblu. Acest lucru este deosebit de valoros în modelele de învățare profundă, unde straturile interconectate și numeroșii parametri adesea fac procesul de predicție să pară un drum prin labirint. SHAP demistifică acest proces, cuantificând contribuția fiecărei caracteristici, oferind o hartă mai clară a căilor de luare a deciziilor modelului.
Atât LIME, cât și SHAP au devenit unelte esențiale în domeniul inteligenței artificiale și al învățării mașinilor, abordând nevoia critică de transparență și încredere. Pe măsură ce integrăm inteligența artificială mai profund în diverse sectoare, capacitatea de a interpreta și înțelege aceste modele devine nu doar o necesitate tehnică, ci și o cerință fundamentală pentru dezvoltarea etică și responsabilă a inteligenței artificiale. Aceste tehnici reprezintă pași semnificativi în descifrarea complexității modelelor de învățare mașinilor și a învățării profunde, transformându-le din “cutii negre” inscrutabile în sisteme a căror decizii și comportamente pot fi înțelese, încredințate și utilizate eficient.
Scara și Complexitatea LLM-urilor
Scara acestor modele adaugă la complexitatea lor. Luați, de exemplu, GPT-3, cu cei 175 de miliarde de parametri, și modelele mai noi care au trilioane. Fiecare parametru interacționează în moduri complexe în rețeaua neurală, contribuind la capacități emergente care nu pot fi prevăzute prin examinarea componentelor individuale. Această scară și complexitate fac aproape imposibilă înțelegerea completă a logicii interne, punând un obstacol în diagnosticarea prejudecăților sau a comportamentelor nedorite în aceste modele.
Compromisul: Scară vs. Interpretabilitate
Reducerea scării LLM-urilor ar putea îmbunătăți interpretabilitatea, dar la costul capacităților avansate. Scara este ceea ce permite comportamente pe care modelele mai mici nu le pot atinge. Acest lucru prezintă un compromis inerent între scară, capacitate și interpretabilitate.
Impactul Problemei Cutiei Negre a LLM-urilor
1. Luarea Deciziilor Defectuoase
Opaicitatea în procesul de luare a deciziilor al LLM-urilor, cum ar fi GPT-3 sau BERT, poate duce la prejudecăți și erori nedetectate. În domenii precum sănătatea sau justiția penală, unde deciziile au consecințe de lungă durată, imposibilitatea de a audita LLM-urile pentru sunetul etic și logic este o preocupare majoră. De exemplu, un sistem de diagnostic medical LLM care se bazează pe date învechite sau prejudecate poate face recomandări dăunătoare. La fel, LLM-urile utilizate în procesele de angajare pot perpetua involuntar prejudecățile de gen. Natura de cutie neagră nu numai că ascunde defecte, dar poate și amplifica, necesitând o abordare proactivă pentru a îmbunătăți transparența.
2. Adaptabilitate Limitată în Contexte Diverse
Lipsa de insight în mecanismele interne ale LLM-urilor restricționează adaptabilitatea lor. De exemplu, un sistem LLM de angajare poate fi ineficient în evaluarea candidaților pentru un rol care valorizează abilitățile practice peste calificările academice, din cauza incapacității sale de a ajusta criteriile de evaluare. Similar, un sistem medical LLM poate lupta cu diagnostice de boli rare din cauza dezechilibrului datelor. Această inflexibilitate subliniază nevoia de transparență pentru a recalibra LLM-urile pentru sarcini și contexte specifice.
3. Prejudecăți și Lacune de Cunoaștere
Procesarea datelor de antrenare de către LLM-uri este supusă limitărilor impuse de algoritmii și arhitecturile modelului. De exemplu, un LLM medical poate arăta prejudecăți demografice dacă este antrenat pe seturi de date dezechilibrate. De asemenea, competența unui LLM în subiecte de nișă poate fi înșelătoare, conducând la ieșiri incorecte și pline de încredere. Abordarea acestor prejudecăți și lacune de cunoaștere necesită mai mult decât doar date suplimentare; necesită o examinare a mecanismelor de procesare ale modelului.
4. Răspundere Juridică și Etică
Natura opacă a LLM-urilor creează o zonă gri juridică în ceea ce privește răspunderea pentru orice prejudiciu cauzat de deciziile lor. Dacă un LLM într-un mediu medical oferă sfaturi greșite care duc la prejudicii asupra pacienților, stabilirea răspunderii devine dificilă din cauza opacității modelului. Această incertitudine juridică prezintă riscuri pentru entitățile care implementează LLM-uri în domenii sensibile, subliniind nevoia de guvernanță și transparență clară.
5. Probleme de Încredere în Aplicații Sensibile
Pentru LLM-urile utilizate în domenii critice, cum ar fi sănătatea și finanțele, lipsa de transparență subminează încrederea în ele. Utilizatorii și regulatorii trebuie să se asigure că aceste modele nu conțin prejudecăți sau nu iau decizii pe baza unor criterii injuste. Verificarea absenței prejudecăților în LLM-uri necesită o înțelegere a proceselor lor de luare a deciziilor, subliniind importanța explicabilității pentru implementarea etică.
6. Riscuri cu Datele Personale
LLM-urile necesită cantități mari de date de antrenare, care pot include informații personale sensibile. Natura de cutie neagră a acestor modele ridică preocupări cu privire la modul în care aceste date sunt procesate și utilizate. De exemplu, un LLM medical antrenat pe înregistrări de pacienți ridică întrebări despre confidențialitatea datelor și utilizarea lor. Asigurarea că datele personale nu sunt utilizate abuziv sau exploatate necesită procese de manipulare a datelor transparente în cadrul acestor modele.
Soluții Emergente pentru Interpretabilitate
Pentru a aborda aceste provocări, sunt dezvoltate tehnici noi. Acestea includ metode de aproximare a contrafacticelor. Prima metodă implică solicitarea unui LLM să modifice un anumit concept textual, păstrând altele constante. Acest abordare, deși eficientă, este intensivă din punct de vedere al resurselor la momentul inferenței.
A doua abordare implică crearea unui spațiu de încorporare dedicat, condus de un LLM în timpul antrenamentului. Acest spațiu se aliniază cu un grafic cauzal și ajută la identificarea potrivirilor care aproximează contrafacticele. Această metodă necesită mai puține resurse la momentul testării și s-a dovedit a fi eficientă în explicarea predicțiilor modelului, chiar și în LLM-uri cu miliarde de parametri.
Aceste abordări subliniază importanța explicațiilor cauzale în sistemele de procesare a limbajului natural pentru a asigura siguranța și a stabili încrederea. Aproximările contrafacticelor oferă o modalitate de a imagina cum ar fi un anumit text dacă un anumit concept din procesul său generativ ar fi diferit, ajutând la estimarea practică a efectelor cauzale de nivel înalt asupra modelelor de procesare a limbajului natural.
Analiză Aprofundată: Metode de Explicare și Cauzalitate în LLM-uri
Unelte de Sonde și Importanță a Caracteristicilor
Sondarea este o tehnică utilizată pentru a descifra ce reprezentări interne ale modelelor codifică. Poate fi supravegheată sau nesupravegheată și are ca scop determinarea dacă anumite concepte sunt codificate în anumite locuri din rețeaua neurală. Deși eficientă până la un anumit punct, sondele nu oferă explicații cauzale, așa cum este subliniat de Geiger et al. (2021).
Uneltele de importanță a caracteristicilor, o altă formă de metodă de explicare, se concentrează adesea pe caracteristicile de intrare, deși unele metode bazate pe gradient se extind la stări ascunse. Un exemplu este metoda Integrated Gradients, care oferă o interpretare cauzală prin explorarea intrărilor de referință (contrafactice, CF). În ciuda utilității lor, aceste metode încă luptă pentru a conecta analizele lor cu concepte din lumea reală dincolo de proprietățile simple ale intrărilor.
Metode Bazate pe Intervenții
Metodele bazate pe intervenții implică modificarea intrărilor sau reprezentărilor interne pentru a studia efectele asupra comportamentului modelului. Aceste metode pot crea stări contrafactice pentru a estima efecte cauzale, dar adesea generează intrări sau stări de rețea neverosimile, dacă nu sunt controlate cu atenție. Modelul de Proxy Cauzal (CPM), inspirat de conceptul de învățare S, este o abordare nouă în acest domeniu, imitând comportamentul modelului explicat sub intrări contrafactice. Cu toate acestea, nevoia de un explicator distinct pentru fiecare model este o limitare majoră.
Aproximarea Contrafacticelor
Contrafacticele sunt utilizate pe scară largă în învățarea mașinilor pentru augmentarea datelor, implicând perturbări ale diferiților factori sau etichete. Acestea pot fi generate prin editare manuală, înlocuire de cuvinte cheie sau rescriere automată de texte. Deși editarea manuală este precisă, este și intensivă din punct de vedere al resurselor. Metodele bazate pe cuvinte cheie au limitări, iar abordările generative oferă un echilibru între fluență și acoperire.
Explicații Fidele
Fidelitatea în explicații se referă la reprezentarea precisă a raționamentului subiacent al modelului. Nu există o definiție universal acceptată a fidelității, ceea ce duce la caracterizarea sa prin diverse metrice, cum ar fi Sensibilitate, Coerență, Acord de Importanță a Caracteristicilor, Robusteză și Simulabilitate. Cele mai multe dintre aceste metode se concentrează pe explicații la nivel de caracteristici și adesea confundă corelația cu cauzalitatea. Lucrarea noastră are ca scop furnizarea unor explicații la nivel de concept, utilizând literatura de cauzalitate pentru a propune un criteriu intuitiv: Ordinea-Fidelității.
Am explorat complexitățile inerente ale LLM-urilor, înțelegând natura lor de “cutie neagră” și provocările semnificative pe care le ridică. De la riscurile deciziilor defectuoase în domenii sensibile, cum ar fi sănătatea și finanțele, la dilemele etice care înconjoară prejudecățile și echitatea, nevoia de transparență în LLM-uri a devenit mai evidentă ca niciodată.
Viitorul LLM-urilor și integrarea lor în viața noastră de zi cu zi și în procesele de luare a deciziilor critice depinde de capacitatea noastră de a face aceste modele nu doar mai avansate, ci și mai ușor de înțeles și responsabile. Urmărirea explicabilității și interpretabilității nu este doar o întreprindere tehnică, ci și un aspect fundamental al construirii încrederii în sistemele de inteligență artificială. Pe măsură ce LLM-urile devin mai integrate în societate, cererea de transparență va crește, nu doar din partea practicienilor de inteligență artificială, ci și din partea fiecărui utilizator care interacționează cu aceste sisteme.
Am petrecut ultimii cinci ani scufundându-mă în lumea fascinantă a Machine Learning și Deep Learning. Pasinea și expertiza mea m-au condus să contribui la peste 50 de proiecte diverse de inginerie software, cu un focus deosebit pe AI/ML. Curiozitatea mea în continuare m-a atras și spre Natural Language Processing, un domeniu pe care sunt dornic să îl explorez mai departe.


 Adaugă Unite.AI la sursele tale preferate pe Google