
Unghiul lui Anderson
Îndepărtarea obiectelor din videoclipuri într-un mod mai eficient cu ajutorul învățării automate

 Adaugă Unite.AI la sursele tale preferate pe Google
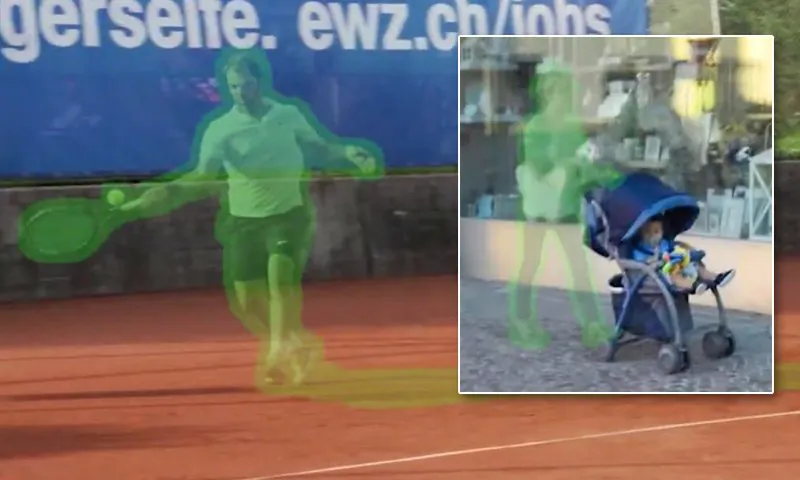
Noi cercetări din China raportează rezultate de ultimă oră, precum și o îmbunătățire impresionantă a eficienței, pentru un nou sistem de îndepărtare a obiectelor din videoclipuri care poate înlătura cu abilitate obiectele din filmări.
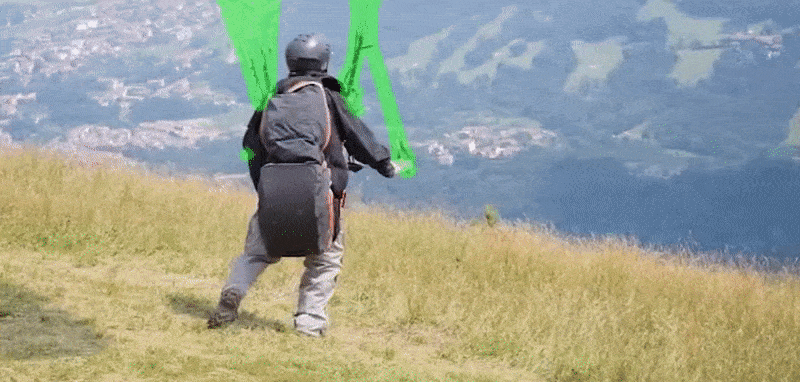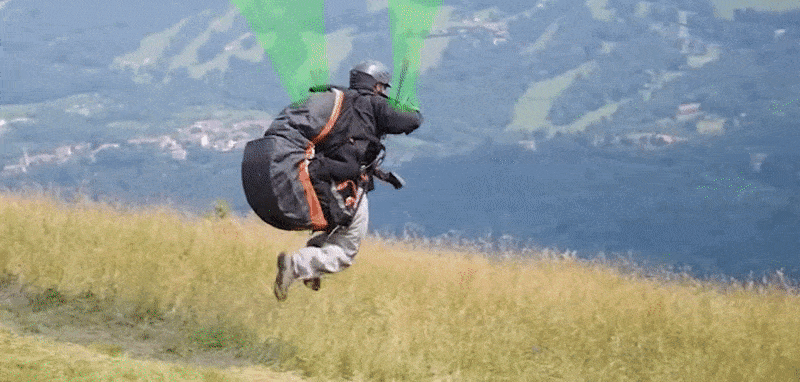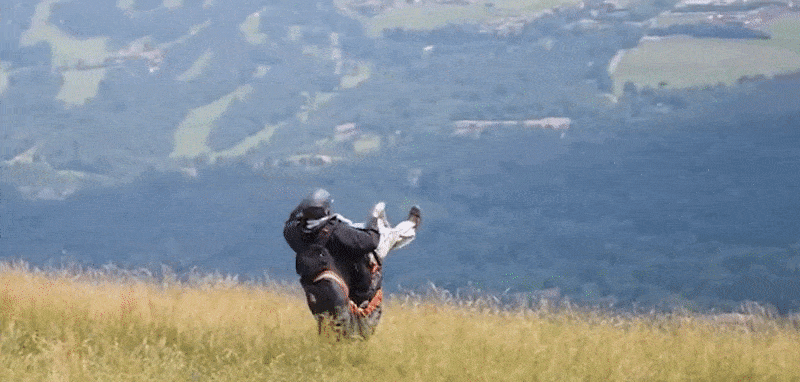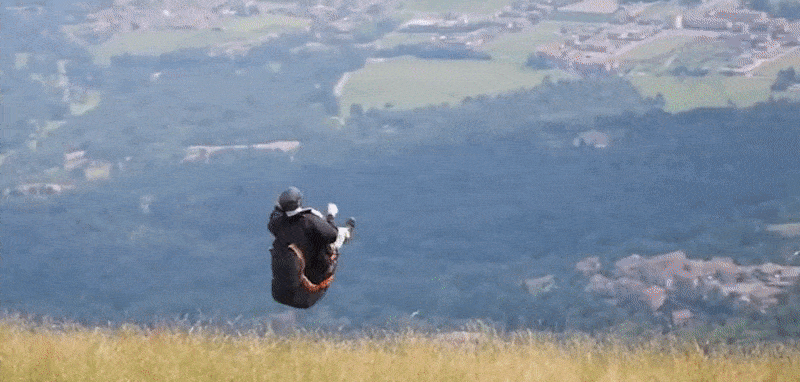
Un hamac de hang-glider este pictat de procedura nouă. Vedeți videoclipul sursă pentru o rezoluție mai bună și mai multe exemple. Sursă: https://www.youtube.com/watch?v=N–qC3T2wc4
Tehnica, numită cadru de la capăt la capăt pentru video în pictură ghidată de flux (E2FGVI), este capabilă și să înlăture filigrane și diverse alte tipuri de occluziuni din conținutul video.
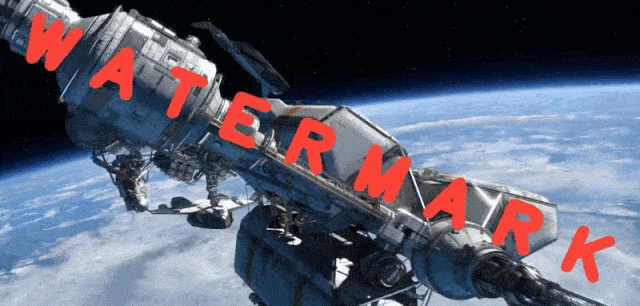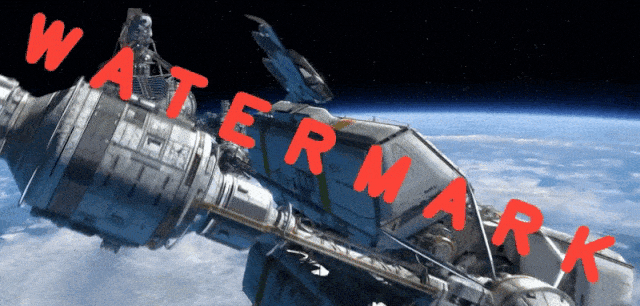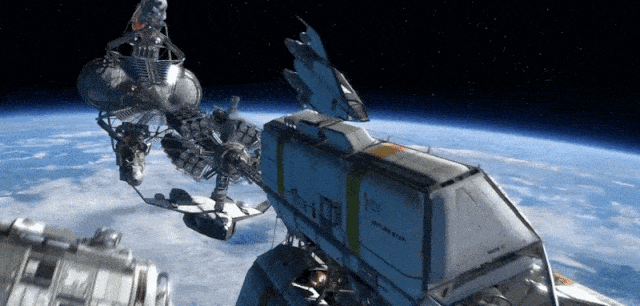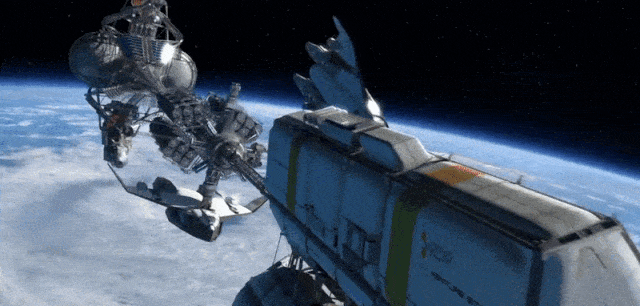
E2FGVI calculează predicții pentru conținutul care se află în spatele occluziunilor, permițând înlăturarea chiar și a filigranelor notabile și inaccesibile. Sursă: https://github.com/MCG-NKU/E2FGVI
(Pentru a vedea mai multe exemple într-o rezoluție mai bună, verificați videoclipul)
Deși modelul prezentat în lucrarea publicată a fost instruit pe videoclipuri de 432px x 240px (dimensiuni de intrare joase, limitate de spațiul disponibil pe GPU versus dimensiuni optime de lot și alte factori), autorii au lansat de curând E2FGVI-HQ, care poate gestiona videoclipuri la o rezoluție arbitrară.
Codul pentru versiunea curentă este disponibil pe GitHub, în timp ce versiunea HQ, lansată duminică, poate fi descărcată de pe Google Drive și Baidu Disk.

Copilul rămâne în imagine.
E2FGVI poate prelucra un videoclip de 432×240 la 0,12 secunde pe cadru pe un GPU Titan XP (12GB VRAM), iar autorii raportează că sistemul funcționează de cincisprezece ori mai rapid decât metodele anterioare bazate pe flux optic.
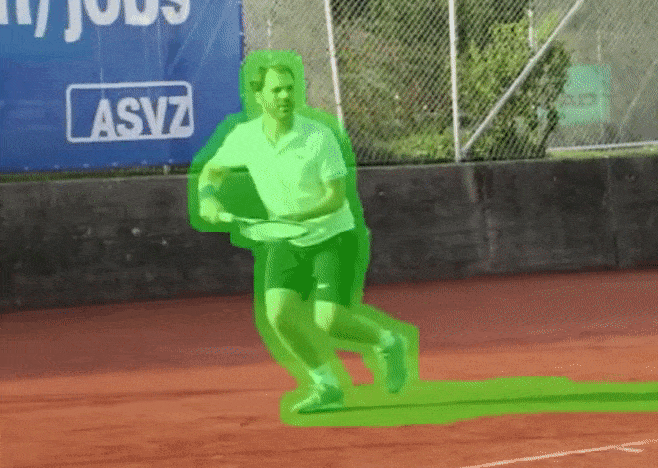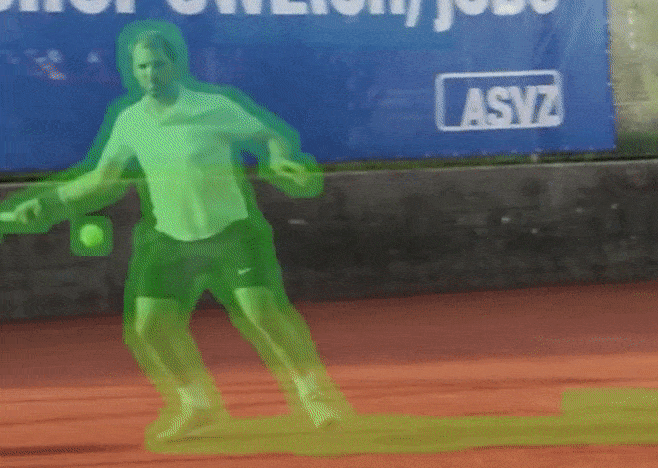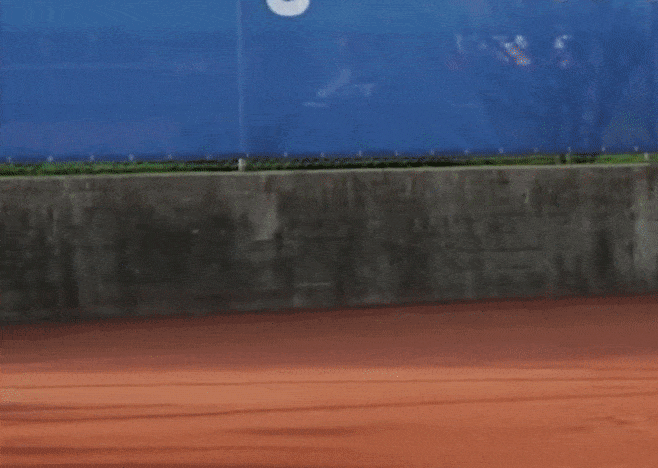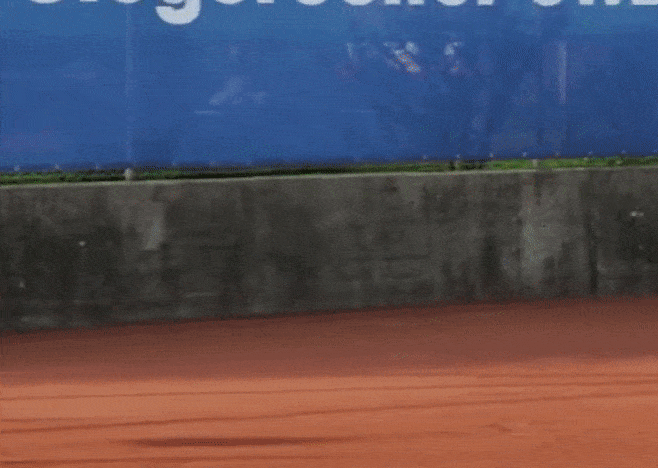
Un jucător de tenis face o ieșire neașteptată.
Testat pe seturi de date standard pentru acest subsector de cercetare a sintezei de imagini, noua metodă a fost capabilă să depășească rivalele atât în evaluări calitative, cât și cantitative.

Teste împotriva abordărilor anterioare. Sursă: https://arxiv.org/pdf/2204.02663.pdf
Articolul lucrare se intitulează Spre un cadru de la capăt la capăt pentru video în pictură ghidată de flux și este o colaborare între patru cercetători de la Universitatea Nankai, împreună cu un cercetător de la Hisilicon Technologies.
Ce lipsește în această imagine
Pe lângă aplicațiile sale evidente pentru efecte vizuale, îndepărtarea de înaltă calitate a obiectelor din videoclipuri este pe cale să devină o caracteristică definitorie a noilor tehnologii de sinteză de imagini și de modificare a imaginilor bazate pe inteligență artificială.
Acesta este în special cazul aplicațiilor de modă care alterează corpul, și altor cadre care încearcă să ‘slăbească’ sau să modifice în alt mod scenele din imagini și videoclipuri. În astfel de cazuri, este necesar să se ‘umple’ fundalul suplimentar expus prin sinteză.

Dintr-un articol recent, un algoritm de ‘reshaping’ a corpului este însărcinat cu îndepărtarea fundalului nou descoperit atunci când un subiect este redimensionat. Aici, acea lipsă este reprezentată de conturul roșu pe care l-a ocupat anterior (vezi imaginea din stânga) persoana cu siluetă mai plină. Bazat pe materialul sursă de la https://arxiv.org/pdf/2203.10496.pdf
Flux optic coerent
Fluxul optic (OF) a devenit o tehnologie de bază în dezvoltarea îndepărtării obiectelor din videoclipuri. Ca o hartă, OF oferă o hartă unică a unei secvențe temporale. Adesea utilizat pentru a măsura viteza în inițiativele de viziune computerizată, OF poate permite, de asemenea, o îndepărtare coerentă în timp, unde suma agregată a sarcinii poate fi luată în considerare într-o singură trecere, în loc de atenția ‘per-cadru’ în stil Disney, care duce inevitabil la discontinuitate temporală.
Metodele de îndepărtare a obiectelor din videoclipuri până în prezent s-au concentrat pe un proces în trei etape: completarea fluxului, unde videoclipul este esențialmente cartat într-o entitate discretă și explorabilă; propagarea pixelilor, unde găurile din videoclipurile ‘corupte’ sunt umplute prin propagarea bidirecțională a pixelilor; și halucinarea conținutului (inventarea pixelilor, care este familiară pentru majoritatea noastră din deepfakes și cadre de text-la-imagini, cum ar fi seria DALL-E) unde conținutul estimat ‘lipsă’ este inventat și inserat în filmare.
Inovația centrală a E2FGVI este de a combina aceste trei etape într-un sistem de la capăt la capăt, eliminând nevoia de a efectua operațiuni manuale asupra conținutului sau procesului.

Articolul observă că nevoia de intervenție manuală necesită ca procesele mai vechi să nu beneficieze de un GPU, făcându-le destul de consumatoare de timp. De la articol*:
‘Luând DFVI ca exemplu, finalizarea unui videoclip cu dimensiunea 432 × 240 din DAVIS, care conține aproximativ 70 de cadre, necesită aproximativ 4 minute, ceea ce este inacceptabil în majoritatea aplicațiilor din lumea reală. În plus, cu excepția dezavantajelor menționate mai sus, utilizarea unei rețele de îndepărtare a obiectelor din imagini preantrenate doar la etapa de halucinare a conținutului ignoră relațiile de conținut între vecinii temporali, ducând la conținut generat incoerent în videoclipuri.’
Prin unirea celor trei etape de îndepărtare a obiectelor din videoclipuri, E2FGVI poate înlocui a doua etapă, propagarea pixelilor, cu propagarea caracteristicilor. În procesele mai segmentate ale lucrărilor anterioare, caracteristicile nu sunt la fel de disponibile, deoarece fiecare etapă este relativ ermetică, iar fluxul de lucru este doar semi-automat.
În plus, cercetătorii au conceput un transformator focal temporal pentru etapa de halucinare a conținutului, care ia în considerare nu numai vecinii direcți ai pixelilor din cadrul curent (adică ce se întâmplă în acea parte a cadrului în imaginea anterioară sau următoare), ci și vecinii distanți care sunt la mai multe cadre distanță și care vor influența efectul coerent al oricăror operațiuni efectuate asupra videoclipului în ansamblu.

Arhitectura E2FGVI.
Noua secțiune centrală a fluxului de lucru, bazată pe caracteristici, este capabilă să profite de procese la nivel de caracteristici și să învețe decalaje de eșantionare, în timp ce transformatorul focal inovator al proiectului, potrivit autorilor, extinde dimensiunea ferestrelor focale ‘de la 2D la 3D’.
Teste și date
Pentru a testa E2FGVI, cercetătorii au evaluat sistemul împotriva a două seturi de date populare pentru segmentarea obiectelor din videoclipuri: YouTube-VOS și DAVIS. YouTube-VOS prezintă 3741 de clipuri video de antrenare, 474 de clipuri de validare și 508 de clipuri de test, în timp ce DAVIS prezintă 60 de clipuri video de antrenare și 90 de clipuri de test.
E2FGVI a fost instruit pe YouTube-VOS și evaluat pe ambele seturi de date. În timpul antrenării, măști de obiecte (zonele verzi din imaginile de mai sus și videoclipul însoțitor) au fost generate pentru a simula finalizarea videoclipului.
Pentru metrici, cercetătorii au adoptat raportul de semnal la zgomot de vârf (PSNR), asemănarea structurală (SSIM), distanța de începere a videoclipului Fréchet (VFID) și eroarea de deformare a fluxului – ultimul pentru a măsura stabilitatea temporală în videoclipul afectat.
Arhitecturile anterioare împotriva cărora sistemul a fost testat au fost VINet, DFVI, LGTSM, CAP, FGVC, STTN și FuseFormer.

Din secțiunea de rezultate cantitative a articolului. Săgețile în sus și în jos indică faptul că numerele mai mari sau mai mici sunt mai bune, respectiv. E2FGVI obține cele mai bune scoruri în general. Metodele sunt evaluate în funcție de FuseFormer, deși DFVI, VINet și FGVC nu sunt sisteme de la capăt la capăt, ceea ce face imposibilă estimarea FLOPs-urilor lor.
În plus față de obținerea celor mai bune scoruri împotriva tuturor sistemelor concurente, cercetătorii au efectuat un studiu calitativ cu utilizatorii, în care videoclipurile transformate cu cinci metode reprezentative au fost prezentate individual unor voluntari, care au fost rugați să le evalueze în funcție de calitatea vizuală.

Axa verticală reprezintă procentul de participanți care au preferat ieșirea E2FGVI în funcție de calitatea vizuală.
Autorii observă că, în ciuda preferinței unanime pentru metoda lor, unul dintre rezultate, FGVC, nu reflectă rezultatele cantitative și sugerează că acest lucru indică faptul că E2FGVI ar putea, în mod specios, genera ‘rezultate mai plăcute din punct de vedere vizual’.
În ceea ce privește eficiența, autorii observă că sistemul lor reduce semnificativ operațiunile cu virgulă mobilă pe secundă (FLOPs) și timpul de inferență pe un singur GPU Titan pe setul de date DAVIS și observă că rezultatele arată că E2FGVI rulează de 15 ori mai rapid decât metodele bazate pe flux.
Ei comentează:
‘[E2FGVI] deține cele mai mici FLOPs în contrast cu toate celelalte metode. Acest lucru indică faptul că metoda propusă este foarte eficientă pentru îndepărtarea obiectelor din videoclipuri.’
*Conversia mea a citărilor inline ale autorilor în legături hipertext.
Publicat pentru prima dată pe 19 mai 2022.
Revizuit marți, 28 octombrie 2025, pentru a înlătura încorporarea video defectuoasă și pentru a modifica referințele la videoclipul încorporat în corpul articolului.


