
Unghiul lui Anderson
Editare Consistentă a Conținutului Video cu Inteligență Artificială și Intrări Dirijate de Text

 Adaugă Unite.AI la sursele tale preferate pe Google
Puncte cheieText2Live permite edituri video consistente pornind de la instrucțiuni textuale, fără…
Vezi mai mult
- Text2Live permite edituri video consistente pornind de la instrucțiuni textuale, fără procesare cadru cu cadru.
- Sistemul utilizează un atlas neuronal stratificat pentru a aplica editurile o singură dată pe întregul interval temporal al videoclipului.
- Text2Live automatizează mascarea și compunerea, eliminând necesitatea rotoscopiei sau a ecranelor verzi.
În timp ce comunitatea profesională VFX este intrigată – și, ocazional, se simte puțin amenințată – de noile inovații în sinteza de imagini și videoclipuri, lipsa de continuitate temporală în majoritatea proiectelor de editare video bazate pe inteligență artificială le relegă pe multe dintre aceste eforturi în sfera “psihedelică”, cu texturi și structuri care strălucesc și se schimbă rapid și efecte inconsistente și o tehnologie brută care amintește de era fotochimică a efectelor vizuale.
Dacă doriți să schimbați ceva foarte specific într-un videoclip care nu intră în domeniul de deepfakes (adică, impunerea unei noi identități asupra unui material existent al unei persoane), majoritatea soluțiilor actuale funcționează sub limitări severe, în ceea ce privește precizia necesară pentru efecte vizuale de calitate de producție.
O excepție este lucrarea în desfășurare a unui grup informal de cercetători de la Institutul de Știință Weizmann. În 2021, trei dintre cercetătorii săi, în asociere cu Adobe (ADBE ), au anunțat o metodă nouă pentru descompunerea videoclipurilor și suprapunerea unei hărți interne consistente – un atlas neural stratificat – într-un rezultat compozit, cu canale alfa și coerență temporală.
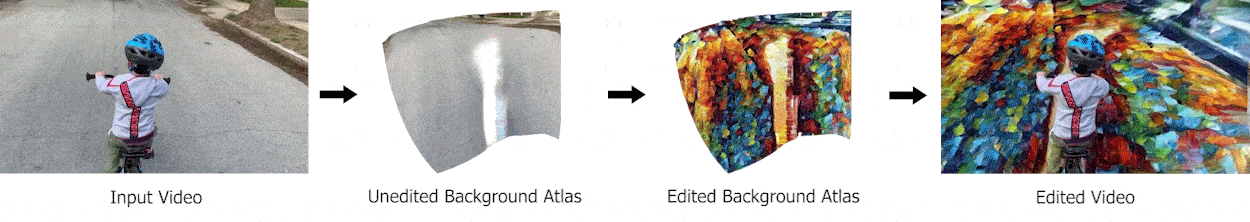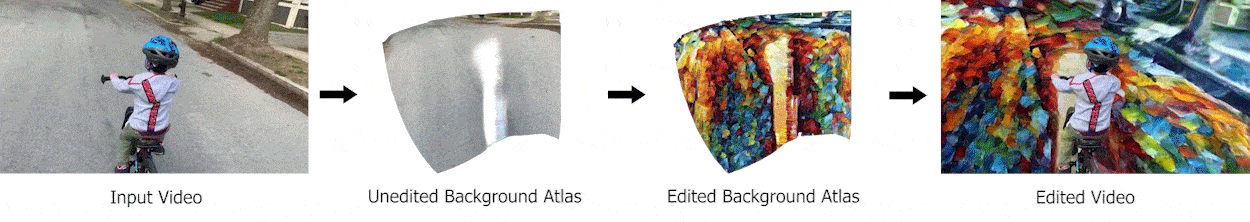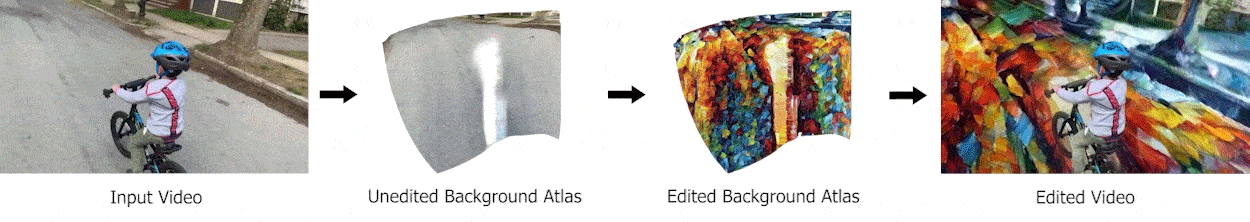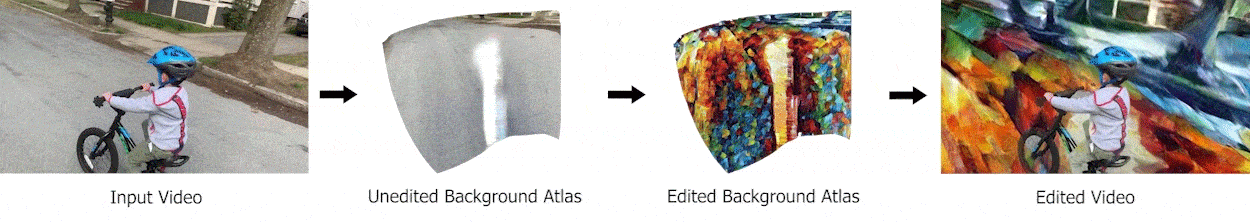
Din lucrarea din 2021: o estimare a traversării complete a drumului în clipul sursă este editată prin intermediul unei rețele neuronale într-un mod care, în mod tradițional, ar necesita multă rotoscopie și potrivirea mișcării. Deoarece elementele de fundal și prim-plan sunt gestionate de rețele diferite, măștile sunt cu adevărat ‘automate’. Sursă: https://layered-neural-atlases.github.io/
Deși se încadrează undeva în domeniul fluxului optic în fluxurile de lucru VFX, atlasul stratificat nu are un echivalent direct în fluxurile de lucru tradiționale CGI, deoarece constituie, în esență, o «hartă de textură temporală» care poate fi produsă și editată prin metode software tradiționale. În a doua imagine din ilustrația de mai sus, fundalul suprafeței drumului este reprezentat (figurativ) pe întreaga durată a videoclipului. Schimbarea acestei imagini de bază (a treia imagine de la stânga în ilustrația de mai sus) produce o schimbare consistentă a fundalului.
Imaginile “desfășurate” ale atlasului de mai sus reprezintă doar cadre interpretate individual; schimbări consistente în orice cadru țintă din videoclip sunt mapate înapoi la cadrul original, păstrând orice ocluziuni și alte efecte de scenă necesare, cum ar fi umbre sau reflexii.
Arhitectura de bază utilizează un Perceptron Multistrat (MLP) pentru a reprezenta atlasele desfășurate, canalele alfa și hărțile, toate acestea fiind optimizate împreună și în întregime într-un spațiu 2D, eliminând necesitatea cunoașterii prealabile, ca în NeRF, a punctelor de geometrie 3D, a hărților de adâncime și a altor elemente similare CGI.
Atlasul de referință al obiectelor individuale poate fi, de asemenea, modificat în mod fiabil:
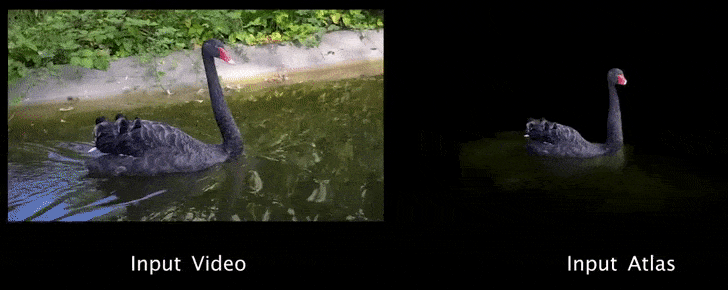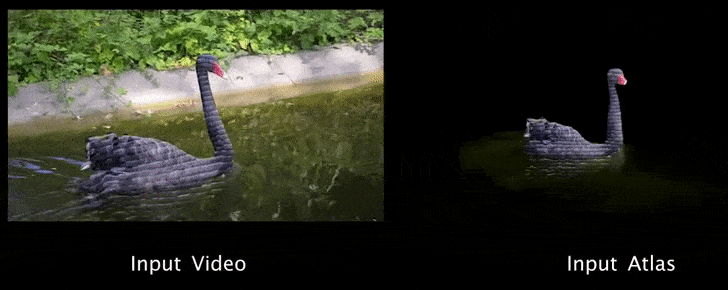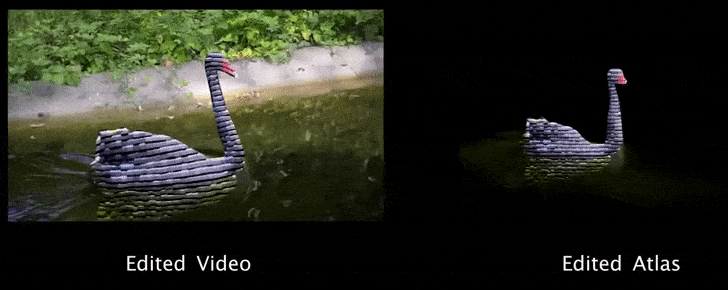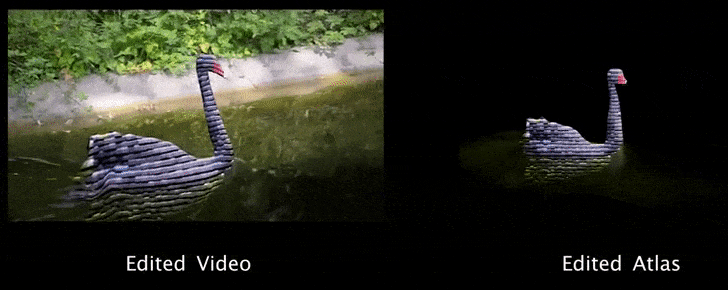
Schimbare consistentă a unui obiect în mișcare sub cadrul din 2021. Sursă: https://www.youtube.com/watch?v=aQhakPFC4oQ
În esență, sistemul din 2021 combină alinierea geometrică, potrivirea mișcării, maparea, retexturizarea și rotoscopia într-un proces neural discret.
Text2Live
Cei trei cercetători originali ai lucrării din 2021, împreună cu cercetători de la NVIDIA (NVDA ), sunt printre contributorii la o nouă inovație care combină puterea atlaselor stratificate cu tehnologia CLIP ghidată de text, care a revenit în atenție în această săptămână cu lansarea DALL-E 2 de către OpenAI.
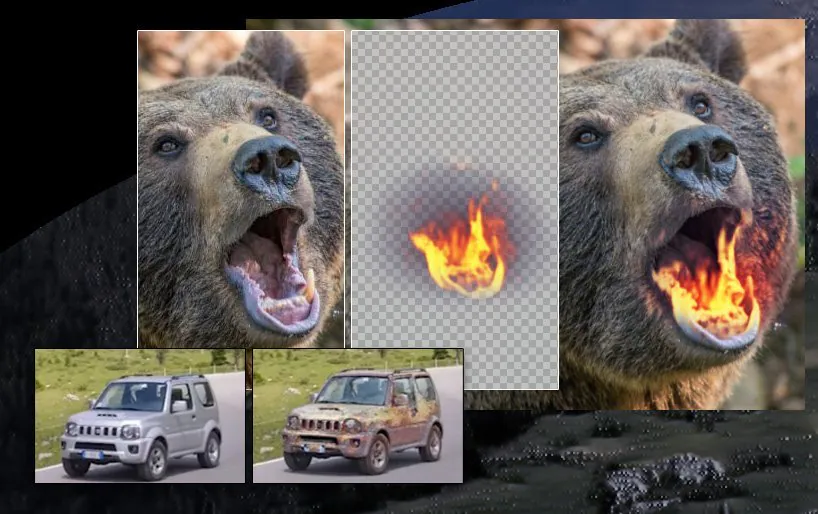
Noua arhitectură, intitulată Text2Live, permite unui utilizator final să creeze editări localizate ale conținutului video real pe baza prompturilor textuale:
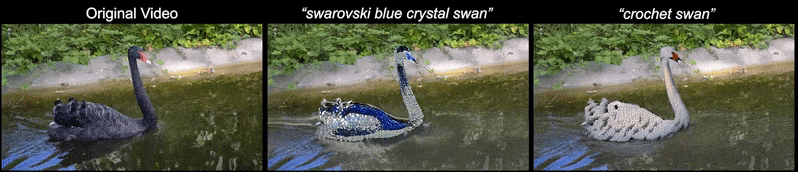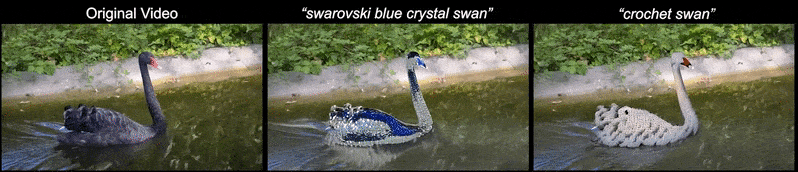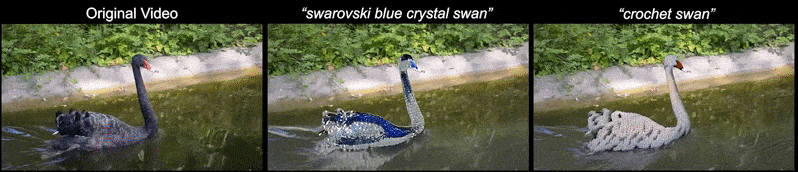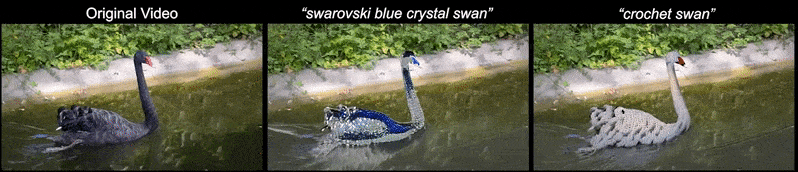
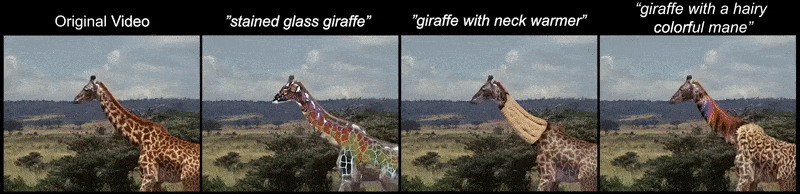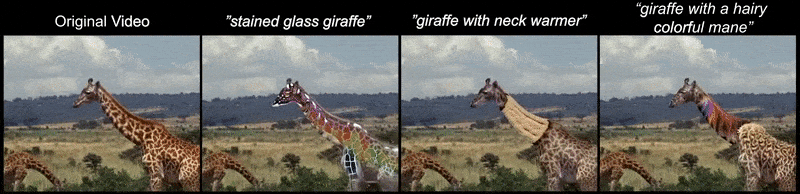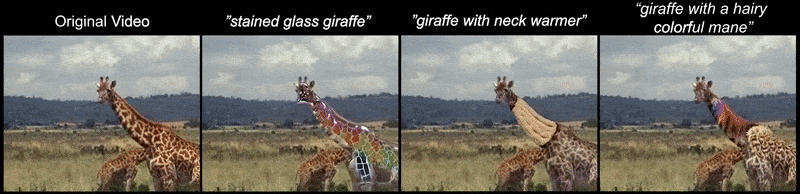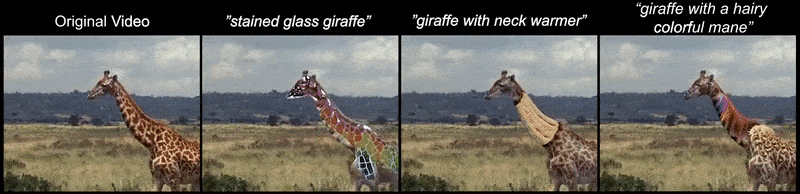
Două exemple de editare a prim-planului. Pentru o rezoluție și o definiție mai bune, consultați videoclipurile originale la https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live oferă editare semantică și foarte localizată fără utilizarea unui generator preantrenat, prin utilizarea unei baze de date interne specifice clipului video afectat.

Transformări de fundal și prim-plan (obiect) sub Text2Live. Sursă: https://text2live.github.io/sm/pages/video_results_atlases.html
Tehnica nu necesită măști furnizate de utilizator, cum ar fi o rotoscopie sau un flux de lucru cu ecran verde, ci mai degrabă estimează hărți de relevanță prin intermediul unei tehnici de bootstrapping bazate pe cercetarea din 2021 de la Școala de Informatică de la Universitatea Tel Aviv și Facebook AI Research (FAIR).

Hărți de ieșire generate prin intermediul unui model de atenție generic bazat pe transformator.
Noua lucrare se intitulează Text2LIVE: Editare stratificată a imaginilor și videoclipurilor, ghidată de text. Echipa originală din 2021 este alăturată de Omer Bar-Tal de la Weizmann și Yoni Kasten de la NVIDIA Research.
Arhitectură
Text2Live cuprinde un generator antrenat pe o singură imagine de intrare și prompturi textuale țintă. Un model de preantrenare contrastivă limbaj–imagine (CLIP), preantrenat pe 400 de milioane de perechi text-imagine oferă material vizual asociat din care transformările utilizatorului pot fi interpretate.

Generatorul acceptă o imagine de intrare (cadru) și produce un strat țintă RGBA care conține informații de culoare și opacitate. Acest strat este apoi compus în filmarea originală cu augmentări suplimentare.

Canalul alfa din stratul RGBA generat oferă o funcție de compunere internă fără recurs la fluxuri de lucru tradiționale care implică software bazat pe pixeli, cum ar fi After Effects.
Prin antrenarea pe imagini interne relevante pentru videoclipul sau imaginea țintă, Text2Live evită necesitatea de a inversa imaginea de intrare în spațiul latent al unei Rețele Adversariale Generative (GAN), o practică care este în prezent departe de a fi suficient de exactă pentru cerințele de editare video de producție, sau de a utiliza un model de difuzie care este mai precis și configurabil, dar nu poate menține fidelitatea față de videoclipul țintă.

Diverse transformări bazate pe prompturi din Text2Live.
Abordările anterioare au utilizat fie metode bazate pe propagare, fie abordări bazate pe flux optic. Deoarece aceste tehnici sunt, într-o oarecare măsură, bazate pe cadre, niciuna dintre ele nu este capabilă să creeze o aparență temporală consistentă a schimbărilor în videoclipul de ieșire. Un atlas neural stratificat, în schimb, oferă un singur spațiu în care pot fi abordate schimbările, care pot rămâne fidele modificării stabilite pe măsură ce videoclipul progresează.
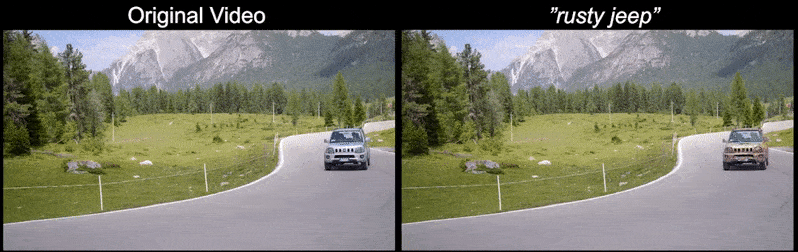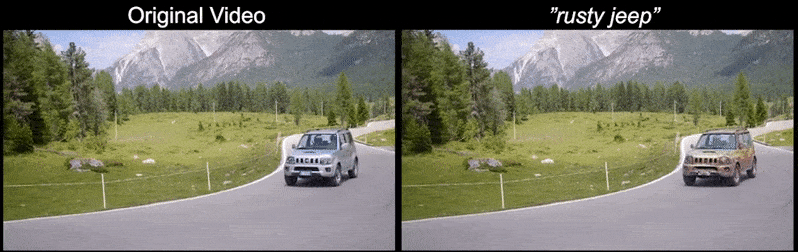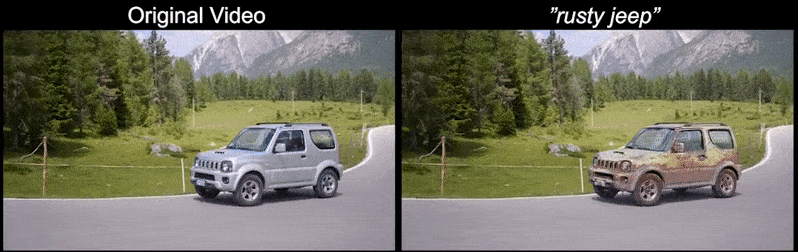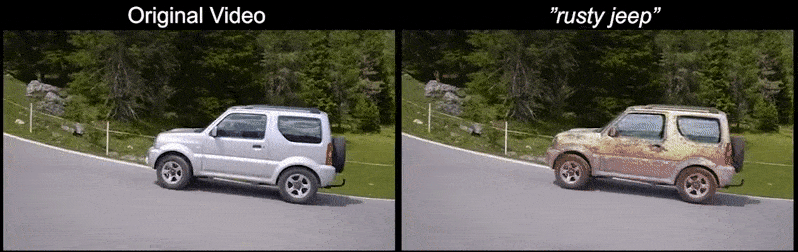
Fără ‘sclipiri’ sau halucinații aleatorii: Text2Live obține o interpretare a promptului text ‘jeep ruginit’ și o aplică o singură dată atlasului neural stratificat al mașinii din videoclip, în loc de a relua transformarea pentru fiecare cadru interpretat.

Flux de lucru al transformării consistente a unui Jeep într-o relicvă ruginită sub Text2Live.
Text2Live este mai aproape de o descoperire în domeniul compunerii bazate pe inteligență artificială, decât în spațiul fertil al imaginilor generate de text, care a atras atenția în această săptămână cu lansarea celei de-a doua generații a cadrului DALL-E de la OpenAI (care poate încorpora imagini țintă ca parte a procesului transformativ, dar rămâne limitat în capacitatea sa de a interveni direct într-o fotografie, pe lângă cenzurarea datelor de antrenament sursă și impunerea de filtre, proiectate pentru a preveni abuzul utilizatorului).
În schimb, Text2Live permite utilizatorului final să extragă un atlas și să îl editeze într-un singur pas în medii bazate pe pixeli, cu un grad ridicat de control, cum ar fi Photoshop (și, s-ar putea argumenta, chiar în sisteme de sinteză a imaginilor mai abstracte, cum ar fi NeRF), înainte de a-l reintroduce într-un mediu corect orientat, care nu se bazează, totuși, pe estimarea 3D sau pe abordări CGI care revin la metodele vechi.
În plus, Text2Live, afirmă autorii, este primul cadru comparabil care realizează mascare și compunere într-o manieră complet automată.
Publicat pentru prima dată pe 7 aprilie 2022.





