
Unghiul lui Anderson
Modelul de difuziune eDiffi de la NVIDIA permite pictarea cu cuvinte și multe altele

 Adaugă Unite.AI la sursele tale preferate pe Google
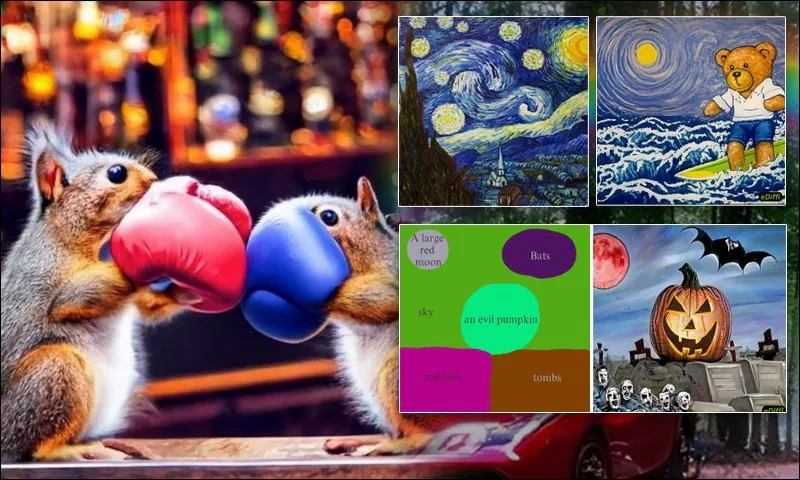
Puncte cheieeDiffi de la NVIDIA utilizează un ansamblu de denoiseri experți pentru un control…
Vezi mai mult
- eDiffi de la NVIDIA utilizează un ansamblu de denoiseri experți pentru un control superior al generării de imagini din text.
- Modelul integrează codificatoarele T5 și CLIP pentru a îmbunătăți detaliile fine și compoziția globală.
- eDiffi permite pictarea cu cuvinte prin maparea culorilor la elementele din prompt pentru o dispunere precisă.
Încercarea de a obține compoziții precise cu modele generative de imagini bazate pe difuziune latentă, precum Stable Diffusion, poate semăna cu încercarea de a mâna pisici: aceleași capacități imaginative și interpretative care permit sistemului să creeze detalii și imagini extraordinare din instrucțiuni text relativ simple sunt greu de dezactivat atunci când doriți un control asupra generării imaginilor comparabil cu cel din Photoshop.
Acum, o nouă abordare a cercetătorilor NVIDIA (NVDA ), numită ensemble diffusion for images (eDiffi), combină mai multe metode de încorporare și interpretare, în loc să folosească aceeași metodă pe tot parcursul fluxului, pentru a oferi un control mult mai mare asupra conținutului generat. În exemplul de mai jos, utilizatorul pictează elemente, fiecare culoare reprezentând un singur cuvânt din instrucțiunea text:
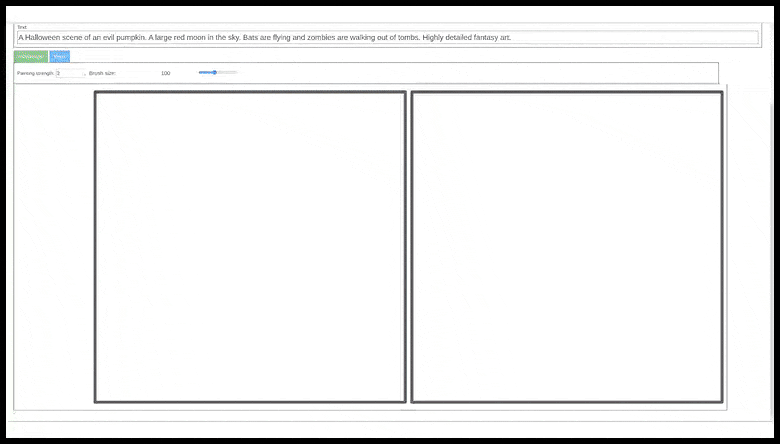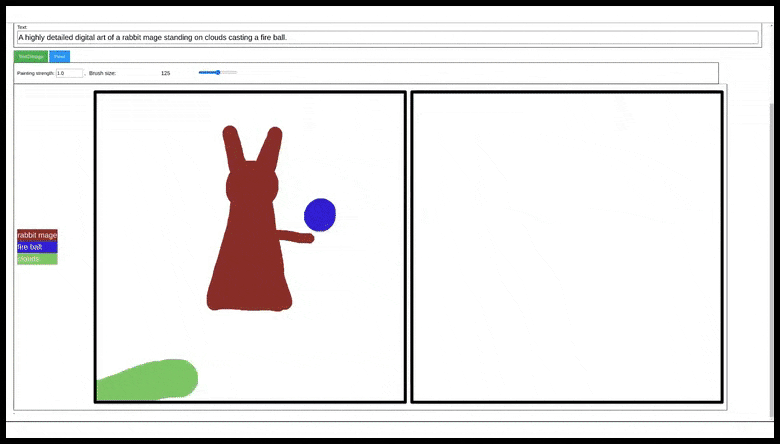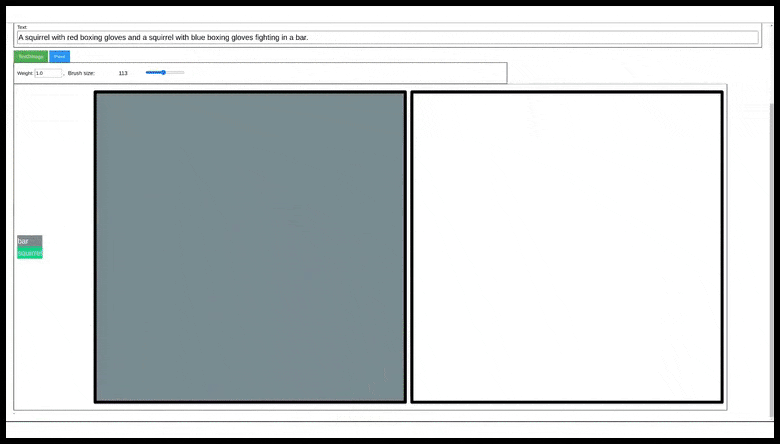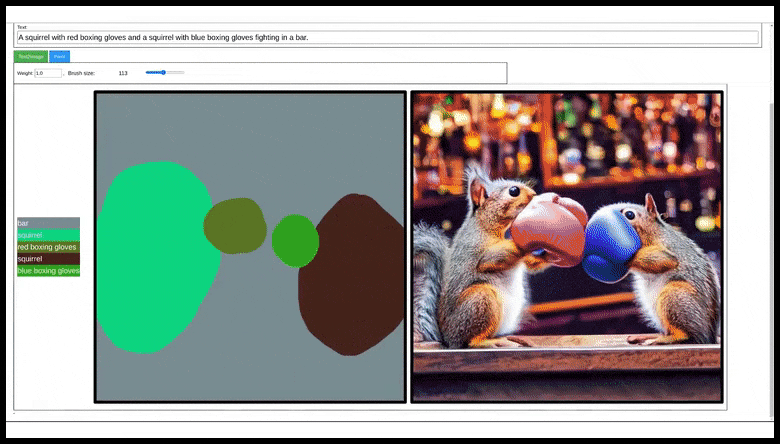
„Pictarea cu cuvinte” este una dintre cele două funcționalități noi ale modelului de difuziune eDiffi de la NVIDIA. Fiecare culoare aplicată reprezintă un cuvânt din instrucțiune, afișat în stânga în timpul generării, iar zona colorată va conține numai acel element. Videoclipul oficial oferă mai multe exemple și o rezoluție mai bună. https://www.youtube.com/watch?v=k6cOx9YjHJc
În esență, aceasta este „pictare cu măști” și inversează paradigma inpainting din Stable Diffusion, care se bazează pe repararea imaginilor deteriorate sau nesatisfăcătoare ori pe extinderea unor imagini care ar fi putut avea de la început dimensiunea dorită.
Aici, în schimb, marginile petei de culoare definesc limitele aproximative permise pentru un singur element, corespunzător unui singur concept. Utilizatorul poate stabili de la început dimensiunea finală a suprafeței de lucru și apoi poate adăuga separat elementele.

Exemple din noua lucrare. Sursa: https://arxiv.org/pdf/2211.01324.pdf
Diversitatea metodelor utilizate în eDiffi înseamnă și că sistemul include mult mai bine fiecare element din instrucțiuni lungi și detaliate. Stable Diffusion și DALL-E 2 de la OpenAI tind să acorde prioritate anumitor părți ale instrucțiunii, în funcție de cât de devreme apar cuvintele vizate sau de alți factori, precum dificultatea separării diferitelor elemente necesare unei compoziții complete și cuprinzătoare în raport cu instrucțiunea text:

Din lucrare: eDiffi poate parcurge mai atent instrucțiunea până când a redat cât mai multe dintre elementele posibile. Deși rezultatele îmbunătățite ale eDiffi, din coloana din extrema dreaptă, au fost selectate favorabil, același lucru este valabil pentru imaginile comparative realizate cu Stable Diffusion și DALL-E 2.
În plus, utilizarea unui codor text-la-text T5 dedicat permite eDiffi să redea text inteligibil în limba engleză, fie cerut în mod abstract prin instrucțiune, de exemplu imaginea conține un text [x], fie solicitat explicit, de exemplu pe tricou scrie „Nvidia Rocks”:

Procesarea text-la-text dedicată din eDiffi permite redarea cuvânt cu cuvânt a textului în imagini, în locul trecerii lui numai printr-un strat de interpretare text-la-imagine care deformează rezultatul.
Un alt avantaj al noului cadru este posibilitatea de a furniza o singură imagine ca instrucțiune de stil, fără antrenarea unui model DreamBooth sau a unei încorporări textuale pe mai multe exemple ale unui gen ori stil.

Stilul unei imagini de referință poate fi transferat într-o generare text-la-imagine sau chiar imagine-la-imagine.
Noua lucrare se intitulează eDiffi: Modele de difuziune text-la-imagine cu un ansamblu de experți în eliminarea zgomotului.
Codorul de text T5
Utilizarea modelului Text-to-Text Transfer Transformer (T5) de la Google este elementul esențial al rezultatelor îmbunătățite demonstrate de eDiffi. Un flux obișnuit de difuziune latentă se concentrează pe asocierea dintre imaginile de antrenare și descrierile care le însoțeau când au fost colectate de pe internet sau care au fost ajustate ulterior manual, o intervenție costisitoare și, prin urmare, rară.

Din lucrarea despre T5 din iulie 2020: transformări bazate pe text care pot ajuta fluxul generativ de imagini din eDiffi și, potențial, din alte modele de difuziune latentă. Sursa: https://arxiv.org/pdf/1910.10683.pdf
Reformularea textului-sursă și rularea modulului T5 pot produce asocieri și reprezentări mai exacte decât cele învățate inițial de model. Procesul seamănă aproape cu etichetarea manuală post facto, cu mai multă precizie și o mai bună adecvare la cerințele instrucțiunii text.
Autorii explică:
„În majoritatea lucrărilor existente despre modelele de difuziune, același model de eliminare a zgomotului este folosit la toate nivelurile de zgomot. Dinamica temporală este reprezentată printr-o încorporare temporală simplă, transmisă modelului printr-o rețea MLP. Susținem că dinamica temporală complexă a difuziunii cu eliminarea zgomotului ar putea să nu fie învățată eficient din date folosind un model comun cu capacitate limitată.
„În schimb, propunem creșterea capacității modelului prin introducerea unui ansamblu de experți în eliminarea zgomotului. Fiecare expert este un model specializat într-un anumit interval de niveluri de zgomot. Astfel putem crește capacitatea fără a încetini eșantionarea, deoarece complexitatea de calcul pentru evaluarea elementului procesat la fiecare nivel de zgomot rămâne aceeași.”

Fluxul de lucru conceptual al eDiffi.
Modulele de codare CLIP existente în DALL-E 2 și Stable Diffusion pot găsi și ele interpretări vizuale alternative ale textului asociat intrării utilizatorului. Totuși, sunt antrenate pe informații similare celor folosite de modelul inițial și nu sunt utilizate ca un strat interpretativ separat, așa cum este T5 în eDiffi.
Autorii afirmă că eDiffi reprezintă prima integrare a unui codor T5 și a unui codor CLIP într-un singur flux:
„Deoarece cei doi codori sunt antrenați cu obiective diferite, încorporările lor favorizează formarea unor imagini diferite pornind de la același text. Încorporările text CLIP ajută la stabilirea aspectului general al imaginilor generate, dar rezultatele tind să omită detaliile fine din text.
„În schimb, imaginile generate numai cu încorporări text T5 reflectă mai bine obiectele individuale descrise, însă aspectul lor general este mai puțin exact. Folosirea celor două împreună produce cele mai bune rezultate de generare a imaginilor în modelul nostru.”
Întreruperea și îmbunătățirea procesului de difuziune
Lucrarea arată că un model obișnuit de difuziune latentă începe drumul de la zgomot pur la imagine bazându-se numai pe text în etapele timpurii ale generării.
Când zgomotul se transformă într-o schiță de compoziție care reprezintă descrierea din instrucțiunea text, componenta ghidată de text se estompează practic, iar restul procesului se concentrează pe îmbunătățirea caracteristicilor vizuale.
Prin urmare, orice element care nu a fost stabilit în etapa inițială a interpretării zgomotului ghidate de text este greu de introdus ulterior. Cele două procese, text-la-compoziție și compoziție-la-imagine, se suprapun relativ puțin, iar componentele structurii de bază sunt deja strâns interdependente când începe îmbunătățirea imaginii.

Din lucrare: hărțile de atenție din diferite etape ale fluxului pe măsură ce procesul zgomot-la-imagine avansează. Pe rândul de jos se observă scăderea bruscă a influenței CLIP, în timp ce T5 continuă să influențeze imaginea mult mai târziu în procesul de redare.
Potențial profesional
Exemplele de pe pagina proiectului și din videoclipul YouTube se concentrează pe imagini simpatice, potrivite pentru meme și ușor de promovat. Ca de obicei, cercetătorii NVIDIA minimalizează potențialul noii inovații de a îmbunătăți fluxurile fotorealiste sau VFX, precum și imaginile și videoclipurile deepfake.
În exemple, un utilizator începător sau amator schițează contururi aproximative pentru amplasarea unui element. Într-un flux VFX mai sistematic, eDiffi ar putea interpreta mai multe cadre ale unui element video prin generare text-la-imagine, folosind contururi foarte precise, bazate, de exemplu, pe personaje al căror fundal a fost eliminat prin ecran verde sau metode algoritmice.

Runway ML oferă deja rotoscopie bazată pe AI. În acest exemplu, „ecranul verde” din jurul subiectului reprezintă stratul alfa, însă extragerea s-a făcut prin învățare automată, nu prin eliminarea algoritmică a unui fundal verde real. Sursa: https://twitter.com/runwayml/status/1330978385028374529
Folosind un personaj DreamBooth antrenat și un flux imagine-la-imagine cu eDiffi, ar putea deveni posibilă abordarea uneia dintre dificultățile majore ale oricărui model de difuziune latentă: stabilitatea temporală. Atât marginile imaginii impuse, cât și conținutul ei ar fi stabilite în prealabil în raport cu suprafața de lucru. Continuitatea temporală a conținutului redat, de exemplu transformarea unui practicant real de Tai Chi într-un robot, ar fi asigurată de un model DreamBooth fixat, care și-a „memorat” datele de antrenare: nefavorabil pentru interpretabilitate, dar excelent pentru reproductibilitate, fidelitate și continuitate.
Metodă, date și teste
Lucrarea precizează că eDiffi a fost antrenat pe „o colecție de seturi de date publice și proprietare”, filtrate riguros cu un model CLIP preantrenat pentru eliminarea imaginilor care ar putea reduce scorul estetic general al rezultatului. Setul final filtrat conține „aproximativ un miliard” de perechi text-imagine. Imaginile de antrenare sunt descrise ca având „latura cea mai scurtă mai mare de 64 de pixeli”.
Au fost antrenate mai multe modele. Atât modelul de bază, cât și cele de superrezoluție au folosit optimizatorul AdamW, cu o rată de învățare de 0,0001, un coeficient de regularizare prin reducerea ponderilor de 0,01 și loturi de dimensiune impresionantă: 2.048.
Modelul de bază a fost antrenat pe 256 de GPU-uri NVIDIA A100, iar cele două modele de superrezoluție pe câte 128 de GPU-uri NVIDIA A100 pentru fiecare model.
Sistemul s-a bazat pe biblioteca PyTorch Imaginaire a NVIDIA. Seturile COCO și Visual Genome au fost utilizate pentru evaluare, fără a fi incluse în modelele finale; varianta folosită în mod specific la testare a fost MS-COCO. Sistemele concurente testate au fost GLIDE, Make-A-Scene, DALL-E 2, Stable Diffusion și cele două sisteme de sinteză a imaginilor de la Google, Imagen și Parti.
În concordanță cu lucrări anterioare similare, s-a folosit zero-shot FID-30K ca metrică de evaluare. Sunt extrase aleatoriu 30.000 de descrieri din setul de validare COCO, nu imagini sau texte folosite la antrenare, apoi sunt utilizate ca instrucțiuni text pentru sintetizarea imaginilor.
A fost calculată distanța Fréchet Inception (FID) dintre imaginile generate și imaginile de referință, în paralel cu înregistrarea scorului CLIP al imaginilor generate.

Rezultatele testelor zero-shot FID comparativ cu metodele de ultimă generație pe setul de validare COCO 2014; valorile mai mici sunt mai bune.
eDiffi a obținut cel mai mic, deci cel mai bun, scor zero-shot FID, chiar și în comparație cu sisteme cu mult mai mulți parametri: Parti are 20 de miliarde de parametri, față de 9,1 miliarde în cea mai complexă variantă eDiffi antrenată pentru aceste teste.
Concluzie
eDiffi de la NVIDIA este o alternativă binevenită la simpla creștere continuă a volumului de date și a complexității sistemelor existente. Folosește o abordare mai inteligentă și stratificată pentru unele dintre cele mai dificile obstacole legate de interdependența elementelor și de lipsa posibilităților de editare în sistemele generative bazate pe difuziune latentă.
Pe subreddit-urile și serverele Discord dedicate Stable Diffusion se discută deja despre integrarea directă a eventualului cod eDiffi disponibil sau despre reimplementarea principiilor sale separat. Noul flux diferă însă atât de mult încât ar presupune o schimbare majoră de versiune pentru SD și renunțarea la o parte din compatibilitatea cu versiunile anterioare. În schimb, ar putea oferi un control mult mai bun asupra imaginilor sintetizate finale, fără a sacrifica puterea imaginativă captivantă a difuziunii latente.
Publicat inițial la 3 noiembrie 2022.


