
Interviuri
Marlos C. Machado, profesor adjunct la Universitatea din Alberta, cercetător Amii și titular al unei catedre de IA CIFAR – seria de interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
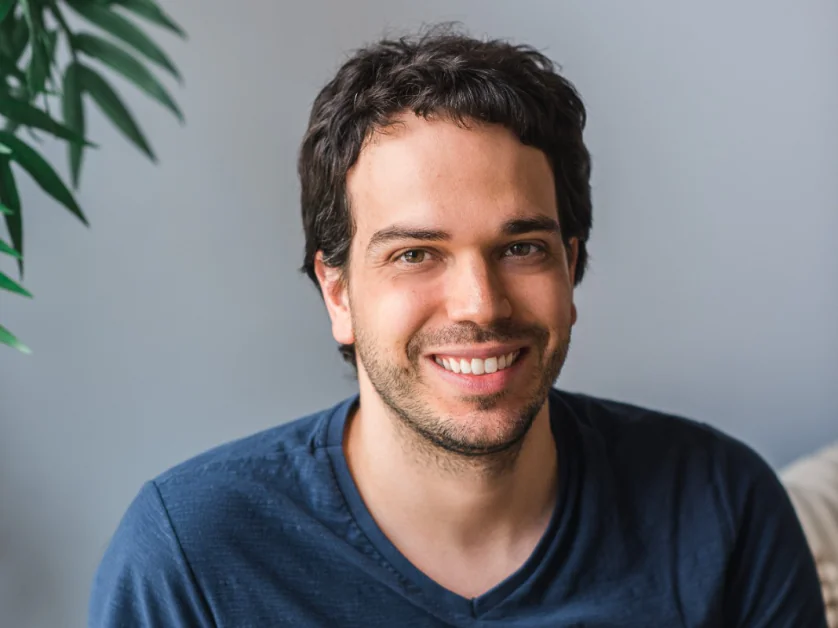
Marlos C. Machado este Fellow in Residence la Alberta Machine Intelligence Institute (Amii), profesor afiliat Universității din Alberta și fellow Amii, unde deține și o catedră Canada CIFAR AI. Cercetarea sa se concentrează în principal pe învățarea prin întărire. A obținut licența și masteratul la UFMG, în Brazilia, și doctoratul la Universitatea din Alberta, unde a popularizat explorarea extinsă în timp prin „opțiuni” (options).
A fost cercetător la DeepMind între 2021 și 2023 și la Google (GOOGL ) Brain între 2019 și 2021. A adus contribuții importante la învățarea prin întărire, mai ales la folosirea învățării profunde prin întărire pentru controlul baloanelor stratosferice Loon. Lucrările sale au apărut în publicații și conferințe de vârf din AI, inclusiv Nature, JMLR, JAIR, NeurIPS, ICML, ICLR și AAAI, și au fost prezentate de BBC, Bloomberg TV, The Verge și Wired.
Am discutat la conferința anuală de AI Upper Bound din 2023, organizată la Edmonton, Alberta, de Amii (Alberta Machine Intelligence Institute).
Vă concentrați pe învățarea prin întărire. Ce vă atrage la această formă de învățare automată?
Îmi place ideea învățării prin interacțiune. Mi se pare foarte naturală și, într-un anumit sens, asemănătoare învățării umane. Nu vreau să antropomorfizez AI, dar este intuitiv: încerci ceva, unele rezultate sunt bune, altele rele și înveți să faci ceea ce produce rezultate mai bune. Mă fascinează că agentul interacționează cu lumea, formulează o ipoteză și o poate testa.
Asta permite descoperirea unor comportamente noi. Un exemplu celebru este mutarea 37 a AlphaGo, descrisă în documentar ca fiind creativă. Nu mai fusese văzută și ne-a uimit pe toți. Nu era găsită într-un material existent, ci descoperită prin interacțiune. Am observat lucruri similare și în proiectul meu cu baloane în stratosferă.
Au apărut comportamente la care nimeni nu se gândise, dar care erau strălucite. Învățarea prin întărire este deosebit de potrivită pentru asemenea descoperiri fiindcă permite interacțiunea. O problemă grea este întrebarea contrafactuală: ce s-ar fi întâmplat dacă aș fi făcut altceva? În multe contexte de cercetare în învățarea automată nu poți verifica. În învățarea prin întărire poți încerca alternativa data viitoare când întâlnești situația. Îmi place mult acest aspect interactiv.
Desigur, nu voi nega atracția aplicațiilor interesante. Chiar și primele mari succese, de acum câteva decenii, au făcut domeniul foarte atractiv pentru mine.
Care este aplicația timpurie preferată?
Există două exemple celebre: elicopterul controlat prin învățare prin întărire la Stanford și programul de table TD-Gammon, care a devenit campion mondial în anii 1990. În timpul doctoratului am ținut să fac un stagiu la IBM cu Gerald Tesauro, conducătorul proiectului TD-Gammon. Mi s-a părut extraordinar.
Este amuzant că la început nu știam exact ce era învățarea prin întărire. Când aplicam la studii postuniversitare, știam doar că vreau să lucrez în învățarea automată. Citeam descrierile cercetării pe site-urile multor profesori și unele mi se păreau interesante. Privind în urmă, fără să cunosc domeniul, alesesem profesorii celebri în învățarea prin întărire, nu pentru notorietatea lor, ci fiindcă cercetarea descrisă mă atrăgea. Vedeam un site bun și voiam să lucrez cu persoana respectivă.
Așadar, i-ați descoperit în mod firesc.
Exact. Retrospectiv, erau oamenii cu care solicitasem să lucrez cu mult timp în urmă. Chiar înainte să știu ce voi face, citeam într-o lucrare descrierea altor cercetări și mă gândeam că ar trebui să le citesc. Interesul mă aducea mereu înapoi la învățarea prin întărire.
La Google Brain ați lucrat la navigația autonomă a baloanelor stratosferice. De ce era o soluție bună pentru internet în regiuni greu accesibile?
Nu sunt expert în această parte; aceasta era ideea Loon, o filială Alphabet (GOOG ). De obicei construim o antenă, de exemplu în Edmonton, care acoperă o rază de cinci-șase kilometri. În centrul New Yorkului poate deservi milioane de oameni. Dar pentru un trib de poate 50 de persoane în pădurea amazoniană, costul unei antene se justifică greu, fără a mai vorbi despre accesul în regiune.
Economic, o investiție mare în infrastructură într-o zonă izolată și rar populată nu are sens. Ideea era: dacă antena ar fi foarte înaltă, de 20 de kilometri? Nu știm să construim una, dar putem pune acolo un balon. O rază de zece ori mai mare înseamnă o suprafață de o sută de ori mai mare. În mijlocul pădurii, un balon ar putea deservi mai multe triburi care altfel ar avea nevoie de antene separate.
Aceasta era una dintre motivații. Îmi amintesc că deviza Loon nu era internet pentru următorul miliard de oameni, ci pentru ultimul miliard: cei mai greu de conectat. Era foarte ambițios.
Ce probleme de navigație trebuia să rezolvați?
Baloanele nu au propulsie. Navighează asemănător celor cu aer cald: urcă sau coboară pentru a găsi un curent în direcția dorită, îl urmează și schimbă din nou altitudinea când vor altă direcție. Dar acestea nu sunt baloane cu aer cald, ci baloane cu volum fix care zboară în stratosferă.
Din punctul de vedere al navigației, pot doar urca, coborî sau păstra altitudinea, găsind vânturile potrivite. Există multe dificultăți. Trebuie să rămână în regiunea unde oferă internet și să păstreze energia obținută din panouri solare. Este o optimizare cu obiective multiple: poziția potrivită și eficiența energetică.
Știi vântul unde te afli, dar nu la 500 de metri deasupra. În AI numim asta observabilitate parțială. Există prognoze, însă direcția poate fi greșită cu până la 90 de grade. Problema are foarte multe dimensiuni: sute de straturi de vânt, viteza, direcția, modelarea și încrederea în prognoză.
Este greu de înțeles și chiar de comunicat cât de dificil este. Nu vezi toate dimensiunile pe un ecran. Trebuie să iei în calcul vânturile și momentul ultimei măsurători, în timp ce te gândești la energie, ora zilei și poziția dorită. Sunt multe simultan.
Ce studiază sistemul de învățare automată? Doar tiparele vântului și temperatura?
Aveam un model al vântului bazat pe învățare automată, dar nu pe învățare prin întărire. Loon avea date istorice la altitudini diferite și construise modelul înainte de implicarea Google Brain. Eu nu am participat la acea parte. Modelul trebuia și să interpoleze între altitudini.
Puteai ști cum fusese vântul acum doi ani la o anumită înălțime, dar nu cu zece metri mai sus. Au adăugat un proces gaussian și au publicat lucrări despre calitatea modelării. Din perspectiva învățării prin întărire, aveam un simulator bun al dinamicii balonului și acest simulator al vântului. Puteam pretinde că suntem în 2010. Aveam date globale destul de grosiere din acel an, peste care aplicam modelul de învățare automată și procesul gaussian pentru a obține valorile vântului; puteam introduce zgomot și alte variații.
Combinând dinamica balonului cu vânturile și simulând trecutul, obțineam un simulator.
Ca un geamăn digital în trecut.
Exact. Am proiectat o funcție de recompensă pentru menținerea la țintă și o anumită eficiență energetică. Balonul învăța interacționând cu acea lume. Puteam face asta folosind trecutul, deoarece altfel nu știm să modelăm pe deplin vremea și vânturile. Astfel am învățat navigația: urc, cobor sau rămân? Ținând cont de tot ce este în jur, scopul final este să ofer internet regiunii.
Ce dificultăți apar la implementarea învățării prin întărire în lumea reală, comparativ cu jocurile?
Sunt mai multe. Nu este neapărat diferența dintre jocuri și realitate, ci dintre cercetarea fundamentală și cea aplicată. Poți face cercetare aplicată și pentru un joc distribuit către milioane de oameni. Un obstacol major este ingineria. Jocurile sunt medii de cercetare fiindcă includ multe proprietăți care ne interesează, dar într-un set mai bine definit de constrângeri. Putem cerceta și valida învățarea într-un context delimitat, pe care îl înțelegem mai bine.
Cercetarea nu trebuie să fie radical diferită, dar realitatea aduce probleme suplimentare, inclusiv siguranța. Trebuia să ne asigurăm că balonul nu face ceva nesăbuit și agentul nu învață un comportament neprevăzut cu consecințe rele. Era una dintre cele mai mari preocupări. Într-un joc, cel mai rău este de obicei să pierzi.
Mai există ansamblul tehnic al produsului. Ca cercetător individual, poți experimenta într-un joc. Într-un produs nu poți face orice dorești; trebuie să înțelegi și restul sistemului. Echipa este și ea diferită: Loon avea zeci, poate sute de oameni. Noi interacționam cu puțini, dar exista și o cameră de control care comunica cu personalul de aviație.
Așadar, sunt mai multe părți interesate. Dincolo de inginerie și siguranță, multe ipoteze pe care se bazează algoritmii nu mai sunt valabile în realitate și trebuie să rezolvi asta. Lumea este mai puțin prietenoasă decât un joc foarte limitat.
Îmi place acest exemplu: am primit tot ce trebuia, am lucrat o săptămână sau două și ne-am întors la inginerii Loon spunând că rezolvaserăm problema cu precizie de 100%. Au zâmbit sceptic: este imposibil, uneori nu există vânturile necesare.
Am descoperit că algoritmul învățase să ducă balonul în centrul regiunii, apoi tot mai sus până exploda. Cădea și rămânea în regiune pentru totdeauna. Evident, nu asta doream. Se întâmplase în simulare; una dintre corecții a fost să împiedicăm balonul să depășească altitudinea la care se sparge.
Aceste constrângeri reale și interacțiuni cu alte lucruri sunt ușor de omis când lucrezi doar cu jocuri. În realitate, acțiunile au consecințe de care trebuie să fii conștient. Aceasta este o dificultate principală.
Și ciclul experimentelor este mult mai lung. Într-un joc apăs pe start și, în cel mai rău caz, am rezultate după o săptămână. Dar testarea în stratosferă era ceea ce numesc „testare A/B a stratosferei”. După ce aveam o soluție în care credeam, trebuia demonstrat că este statistic mai bună. Cred că am zburat 13 baloane deasupra Pacificului mai mult de o lună pentru validare. Pe această scară de timp ai mult mai puține ocazii de a încerca lucruri.
Spre deosebire de jocuri, nu puteți rula simultan un milion de versiuni ale aceluiași experiment.
Da. La antrenare puteam folosi simularea, deși simulatorul era mult mai lent decât un joc. Am rezolvat asta prin inginerie. În lumea reală situația este diferită.
La ce cercetare lucrați acum?
Sunt la Universitatea din Alberta, unde am un grup de cercetare cu mulți studenți. Ei îmi permit să abordez teme mai diverse. Sunt deosebit de entuziasmat de învățarea continuă. În mod obișnuit facem calcule cu un simulator sau un set de date, antrenăm un model, îl implementăm și sperăm să funcționeze. Adesea este exact ce trebuie. Dar uneori lumea este prea complexă pentru ca orice model, indiferent de dimensiune, să surprindă tot. Atunci trebuie să se adapteze.
Un proiect de aici privește o stație de tratare a apei. Cum pot algoritmii de învățare prin întărire să sprijine deciziile oamenilor sau să controleze autonom tratarea? Avem date, dar calitatea apei se poate schimba în câteva ore. Chiar dacă antrenezi zilnic modelul pe datele zilei anterioare, după câteva ore poate să nu mai fie valabil: distribuția datelor se schimbă, nu este staționară. Poate există un incendiu de pădure în amonte sau începe topirea zăpezii. Ar trebui să modelezi întreaga lume pentru a surprinde totul.
Nimeni nu face asta, nici oamenii. Ne adaptăm și continuăm să învățăm când vechea abordare nu mai merge. Multe aplicații reale cer învățare permanentă, dar nu așa vorbim de obicei despre învățarea automată. Ne gândim la un calcul mare, un model implementat și poate unul nou peste zile sau săptămâni. Uneori această scară de timp nu se potrivește.
Întrebarea este cum să învățăm mereu, devenind mai buni și adaptându-ne. Este foarte greu. Avem lucrări despre asta, iar metodele actuale nu pot face suficient de bine acest lucru. Chiar soluțiile de referință se deteriorează repede dacă le lași să învețe continuu, în loc să oprești antrenarea și să implementezi un model fix. După multe succese cu modele fixe, pe care le vom folosi în continuare, învățarea continuă este una dintre frontierele cercetării.
Învățarea prin întărire este potrivită fiindcă mulți algoritmi procesează deja datele pe măsură ce sosesc. Se potrivesc natural cu învățarea permanentă, fără să însemne că o fac deja sau că sunt buni la ea. Sunt multe întrebări interesante de cercetare.
Ce aplicații viitoare ale învățării continue vă entuziasmează cel mai mult?
Aceasta este întrebarea de un miliard de dolari, pentru că tocmai caut asemenea aplicații. A pune întrebările potrivite reprezintă mai mult de jumătate din cercetare. Îmi place să pornesc de la probleme concrete: avem, de exemplu, cinci baloane în stratosferă, cum rezolvăm? Pe parcurs apar progrese științifice. Lucrez cu Adam White și Martha White la proiectul stației de tratare, pe care ei îl conduc. Mă entuziasmează fiindcă problema este greu chiar de descris în limbaj; succesele actuale în procesarea limbajului nu se aplică ușor acolo.
Apa se schimbă frecvent, inclusiv turbiditatea și temperatura, și pe scări de timp diferite. Învățarea continuă este inevitabilă. Impactul social este uriaș: greu de imaginat ceva mai important decât apa potabilă. În zone slab populate, precum nordul Canadei, uneori nu există nici măcar un operator pentru stație. Scopul nu este neapărat înlocuirea operatorilor, ci să facem posibil ceea ce altfel nu putem din lipsă de personal sau capacitate.
Este un subiect de cercetare foarte dificil, cu mare potențial social. Nu avem simulator și nici mijloace să obținem unul, deci trebuie să folosim datele cât mai bine și să învățăm online. Un alt domeniu, în care nu am lucrat mult, este răcirea clădirilor, legată de vreme și schimbările climatice. Cum decidem răcirea? Astăzi aici sunt sute de oameni, spre deosebire de săptămâna trecută. Folosim aceeași politică? Adesea avem cel mult un termostat. Putem fi mai inteligenți și adaptivi, inclusiv când într-o cameră sunt mulți oameni și în alta puțini.
Există multe oportunități în aceste sisteme de control cu multe dimensiuni, greu de cuprins intuitiv, de a depăși metodele standard actuale.
În unele locuri, până la 75% din consumul de electricitate provine chiar de la aerul condiționat, deci are mult sens.
Exact. Există deja produse pentru locuințe care folosesc învățarea automată și învață de la clienți. În clădiri mari, abordarea poate fi mult mai detaliată. Florida, Brazilia și multe alte locuri au această nevoie. Răcirea centrelor de date este alt exemplu, la care unele companii au început să lucreze. Pare aproape science-fiction, dar învățarea și adaptarea permanentă după nevoie pot avea un impact mare asupra acestor probleme de control cu multe dimensiuni.
La fel ca în proiectul baloanelor, am arătat că învățarea prin întărire, mai ales cea profundă, poate învăța decizii din senzori mult mai complexe decât cele proiectate de oameni. Un om poate alege o curbă de răspuns liniară sau pătratică; o rețea neuronală poate învăța toate neliniaritățile, oferind decizii mai fine și uneori foarte eficiente.
Mulțumim pentru interviul minunat. Cititorii care vor să afle mai multe pot vizita următoarele resurse:


