
Unghiul lui Anderson
GAN ca motor de randare facială pentru CGI tradițional

 Adaugă Unite.AI la sursele tale preferate pe Google

Puncte cheieSepararea identității de expresie în spațiul latent GAN rămâne principala provocare…
Vezi mai mult
- Separarea identității de expresie în spațiul latent GAN rămâne principala provocare nerezolvată pentru sinteza video facială.
- Modelele CGI parametrice precum SMPL și 3DMM-urile sunt din ce în ce mai utilizate pentru a impune ordine codurilor latente necontrolabile ale GAN-urilor.
- Abordarea hibridă Rendering with Style de la Disney a produs rezultate stranii prin îmbinarea hărților de textură tradiționale cu imagini generate de GAN.
Opinie Când rețelele generative adversariale (GAN) și-au demonstrat pentru prima dată capacitatea de a reproduce fețe 3D uimitor de realiste, apariția lor a declanșat o goană după potențialul încă neexploatat al GAN-urilor de a crea videoclipuri cu fețe umane coerente în timp.
Undeva în spațiul latent al unui GAN părea că trebuie să existe ordine și raționalitate ascunse: o schemă de logică semantică incipientă, îngropată în codurile latente, care să permită generarea mai multor vederi și interpretări coerente, precum schimbări de expresie, ale aceleiași fețe. Astfel, ar putea rezulta o metodă de realizare a videoclipurilor deepfake convingătoare în timp, care ar depăși categoric autoencoderele.
Rezultatul de înaltă rezoluție ar fi simplu de obținut în comparație cu mediile sărăcăcioase de joasă rezoluție în care limitările GPU obligă DeepFaceLab și FaceSwap să funcționeze. „Zona de înlocuire” a feței din fluxurile cu autoencoder ar deveni „zona de creare” a unui GAN, ghidată de câteva imagini de intrare sau chiar de una singură.
Nu ar mai exista nepotriviri între fața înlocuită și cea gazdă, deoarece întreaga imagine ar fi generată de la zero, inclusiv părul, conturul mandibulei și marginile exterioare ale trăsăturilor faciale, care sunt adesea dificile pentru deepfake-urile „tradiționale” cu autoencoder.
Iarna videoclipurilor faciale cu GAN
După cum s-a dovedit, nu avea să fie atât de simplu. În cele din urmă, separarea factorilor de variație a devenit problema centrală și rămâne principala provocare. Cum păstrezi o identitate facială distinctă și îi schimbi poziția sau expresia fără să aduni mii de imagini de referință care să învețe rețeaua ce se întâmplă la aceste schimbări, așa cum fac atât de laborios sistemele cu autoencoder?
Cercetările ulterioare privind animarea și sinteza facială cu GAN au explorat în schimb ideea că identității de intrare i s-ar putea aplica transformări orientate spre un scop, generice și bazate pe șabloane, care nu sunt specifice acelei identități. De exemplu, unei fețe GAN i s-ar putea aplica o expresie absentă din toate imaginile acelei persoane cunoscute de rețea.

În lucrarea din 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space, expresii bazate pe șabloane sunt aplicate unei fețe de intrare din setul de date FFHQ. Sursa: https://arxiv.org/pdf/2205.06102.pdf
Este evident că o soluție universală nu poate acoperi diversitatea expresiilor faciale specifice fiecărui individ. Merită să ne întrebăm dacă un zâmbet atât de distinct precum al lui Jack Nicholson sau Willem Dafoe ar putea fi vreodată interpretat fidel sub influența unor coduri latente pentru o „expresie medie”.

Cine este acest străin latin fermecător? Deși metoda GAN produce o față mai „realistă” și de rezoluție mai mare, transformarea nu se bazează pe multiple fotografii reale ale actorului, cum se întâmplă cu DeepFaceLab, care se antrenează extensiv pe mii de asemenea imagini. În consecință, asemănarea are de suferit. Aici, în fundal, un model DeepFaceLab este importat în DeepFaceLive, o implementare pentru streaming a popularului și controversatului software. Exemplele provin din https://www.youtube.com/watch?v=9tr35y-yQRY (2022) și https://arxiv.org/pdf/2205.06102.pdf.
În ultimii ani au fost propuse mai multe editoare de expresii faciale GAN, majoritatea lucrând cu identități necunoscute, ceea ce împiedică cititorul obișnuit să aprecieze fidelitatea transformărilor, deoarece fețele nu îi sunt familiare.

Identități necunoscute transformate în metoda Cascade-EF-GAN din 2020. Sursa: https://arxiv.org/pdf/2003.05905.pdf
Poate că editorul facial GAN care a atras cel mai mult interes și cele mai multe citări în ultimii trei ani este InterFaceGAN, care poate parcurge spațiul latent prin coduri asociate cu poziția, adică unghiul camerei sau al feței, expresia, vârsta, rasa, genul și alte caracteristici importante.
Capacitățile de „morphing” în stilul anilor 1980 ale InterFaceGAN și ale unor sisteme similare ilustrează în principal traseul transformării, când imaginea este reproiectată printr-un cod latent adecvat, precum cel pentru vârstă. Pentru producerea unor secvențe video cu continuitate temporală, asemenea metode au fost până acum „dezastre impresionante”.
Dacă adăugăm dificultatea de a crea păr coerent în timp și faptul că explorarea sau manipularea codurilor latente nu are reguli temporale încorporate, devine logic să concluzionăm că GAN nu este Tot Ce Îți Trebuie™ pentru sinteza video facială. Este dificil chiar să știm cum să introducem asemenea reguli într-un cadru conceput pentru imagini statice, fără suport video nativ.
Eforturile ulterioare au adus îmbunătățiri treptate ale separării factorilor, în timp ce alte cercetări au adăugat convenții din vederea computerizată ca „strat de ghidare”, precum segmentarea semantică folosită drept mecanism de control în lucrarea SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing de la sfârșitul anului 2021.
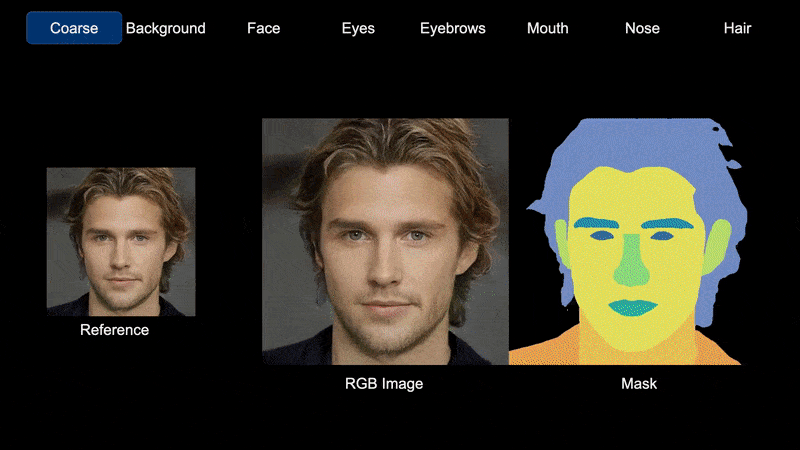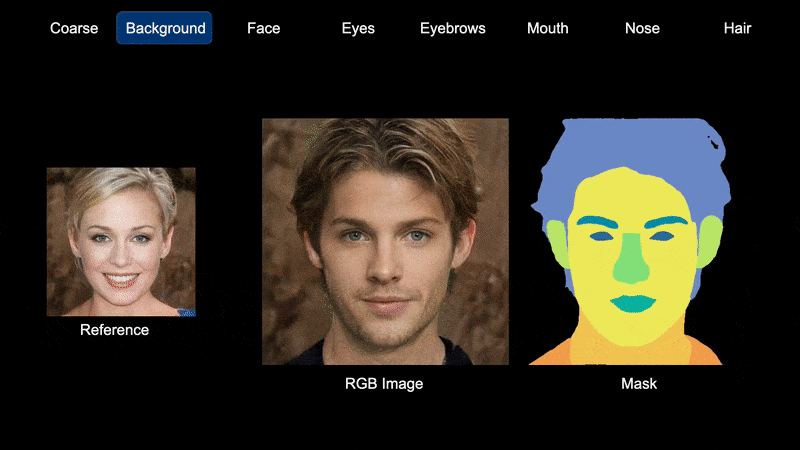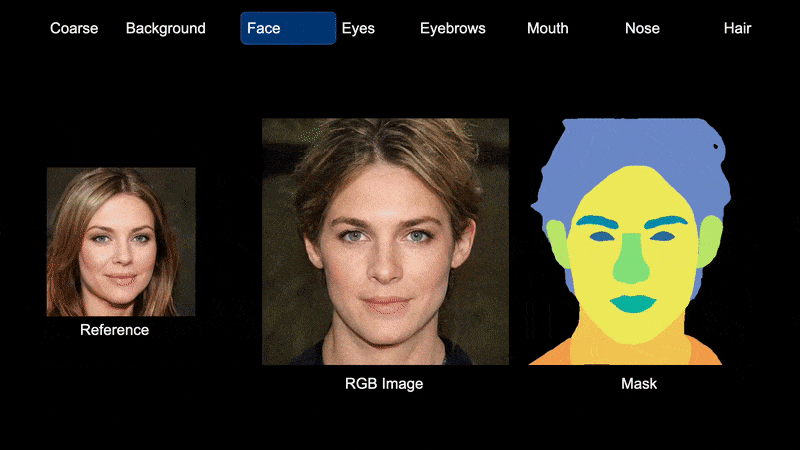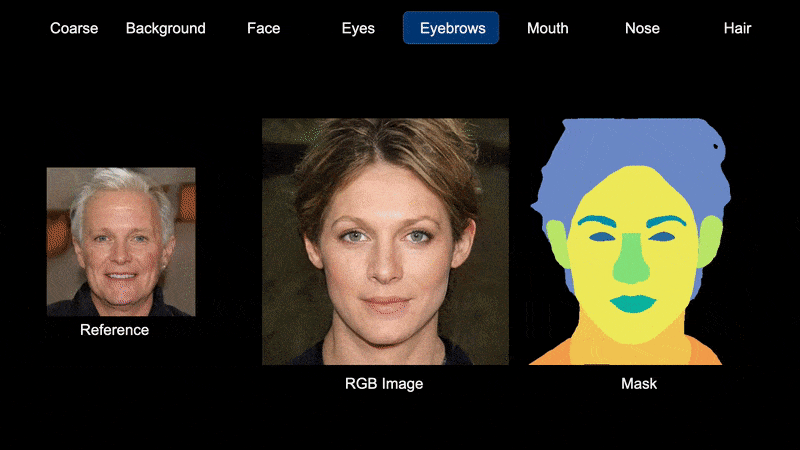
Segmentarea semantică drept metodă de control al spațiului latent în SemanticStyleGAN. Sursa: https://semanticstylegan.github.io/
Ghidare parametrică
Comunitatea cercetării sintezei faciale GAN se îndreaptă tot mai mult spre fețe CGI parametrice „tradiționale”, ca metodă de ghidare și ordonare a codurilor latente impresionante, dar greu de controlat, ale unui GAN.
Deși primitivele faciale parametrice sunt un element de bază în cercetarea vederii computerizate de peste douăzeci de ani, interesul a crescut recent odată cu utilizarea mai frecventă a primitivelor CGI Skinned Multi-Person Linear Model (SMPL), o abordare inițiată de Institutul Max Planck și ILM, îmbunătățită ulterior prin cadrul Sparse Trained Articulated Human Body Regressor (STAR).

SMPL, în acest caz varianta numită SMPL-X, poate impune o plasă CGI parametrică potrivită poziției estimate a întregului corp uman din imagine, inclusiv expresiilor, când este necesar. Aceasta permite noi operații asupra imaginii folosind plasa ca reper volumetric sau perceptual. Sursa: https://arxiv.org/pdf/1904.05866.pdf
Cea mai apreciată evoluție în această direcție a fost inițiativa Disney din 2019 Rendering with Style, care a combinat hărți tradiționale de textură cu imagini generate de GAN pentru a crea rezultate animate îmbunătățite, în stil deepfake.

Vechiul întâlnește noul în abordarea hibridă Disney pentru deepfake-uri generate de GAN. Sursa: https://www.youtube.com/watch?v=TwpLqTmvqVk
Abordarea Disney introduce elemente CGI redate tradițional într-o rețea StyleGAN2 pentru a completa fețele umane în „zone problematice”, unde coerența temporală este dificilă la generarea video, precum textura pielii.

Fluxul de lucru Rendering with Style.
Deoarece capul CGI parametric care ghidează procesul poate fi ajustat după nevoile utilizatorului, fața generată de GAN poate reflecta aceste modificări, inclusiv schimbări de poziție a capului și de expresie.
Deși concepută pentru a îmbina controlul oferit de CGI cu realismul natural al fețelor GAN, metoda ajunge să arate dezavantajele ambelor abordări. Încă nu păstrează consecvent textura părului și nici măcar poziționarea trăsăturilor de bază:
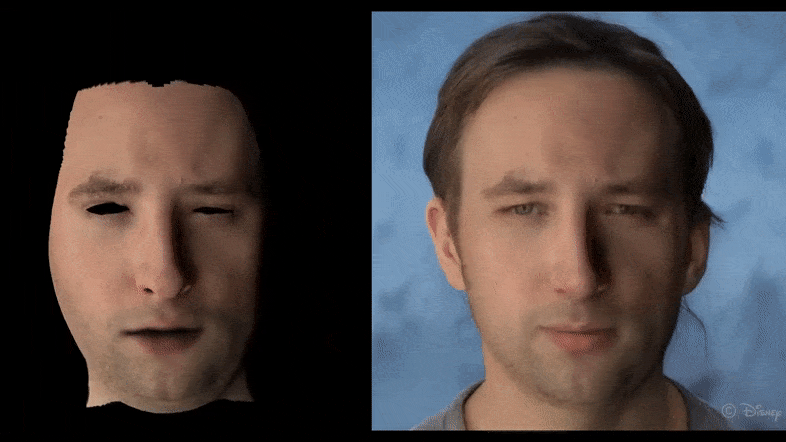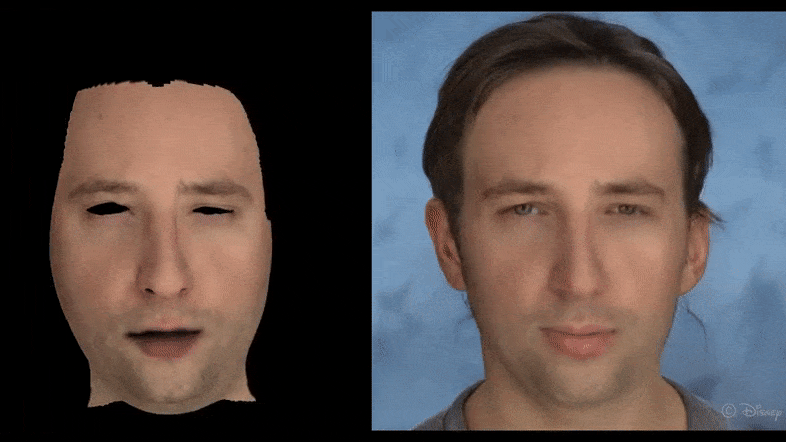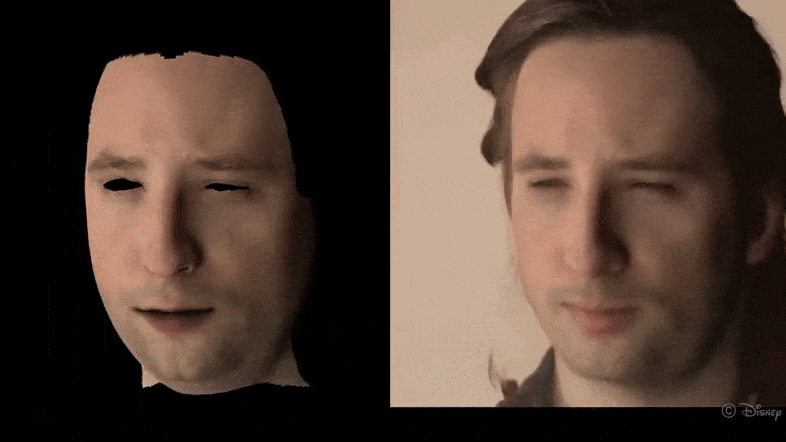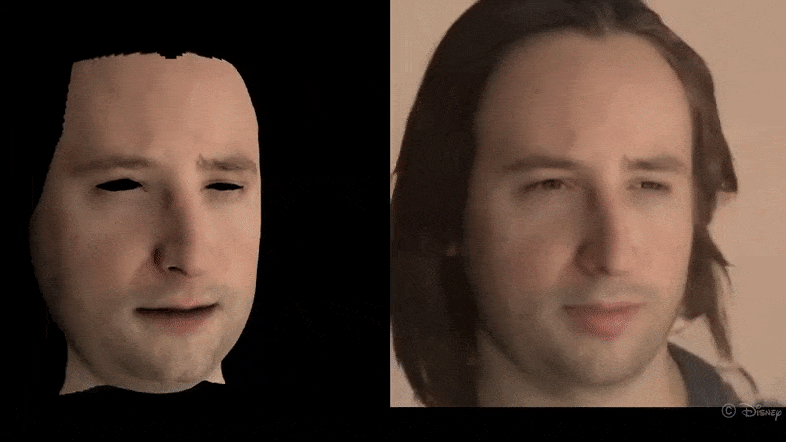
Rendering with Style produce un nou tip de „vale stranie”, deși principiul păstrează un anumit potențial.
Lucrarea din 2020 de cercetare StyleRig: Rigging StyleGAN for 3D Control over Portrait Images urmează o abordare tot mai populară, folosind modele faciale tridimensionale deformabile (3DMM) ca intermediari pentru modificarea caracteristicilor într-un mediu StyleGAN, în acest caz printr-o nouă rețea de control numită RigNet:

Modelele 3DMM servesc ca intermediari pentru interpretarea spațiului latent în StyleRig. Sursa: https://arxiv.org/pdf/2004.00121.pdf
Totuși, ca de obicei în aceste inițiative, rezultatele par limitate la schimbări minime de poziție și modificări ale expresiei sau stării afective care nu sunt informate de particularitățile persoanei.

StyleRig îmbunătățește nivelul de control, dar părul coerent în timp rămâne o provocare nerezolvată. Sursa: https://www.youtube.com/watch?v=eaW_P85wQ9k
Rezultate similare apar în MOST-GAN de la Mitsubishi Research, o lucrare din 2021 care folosește modele 3DMM neliniare ca arhitectură de separare a factorilor, dar care de asemenea întâmpină dificultăți în obținerea unei mișcări dinamice și coerente.
Cea mai recentă cercetare care încearcă să combine controlul și separarea factorilor este One-Shot Face Reenactment on Megapixels, care utilizează din nou capete parametrice 3DMM ca interfață ușor de folosit pentru StyleGAN.

În fluxul MegaFR din One-Shot Face Reenactment, rețeaua sintetizează fețe combinând o imagine reală inversată în reprezentarea latentă cu parametri preluați dintr-un model 3DMM randat. Sursa: https://arxiv.org/pdf/2205.13368.pdf
OSFR aparține unei clase în creștere de editoare faciale GAN care urmăresc fluxuri de editare liniare, în stil Photoshop/After Effects. Utilizatorul introduce imaginea dorită și îi aplică transformări, în loc să caute prin spațiul latent coduri asociate unei identități.
Din nou, expresiile parametrice sunt o metodă generală, nepersonalizată, de adăugare a expresiilor, ducând la modificări care par „stranii” în felul lor, nu întotdeauna pozitiv.

Expresii introduse în OSFR.
La fel ca metodele anterioare, OSFR poate deduce poziții apropiate de cea originală dintr-o singură imagine și poate efectua „frontalizarea”, transformând imaginea unei fețe orientate lateral într-un portret frontal:

Imaginea originală, sus, și portrete frontale deduse de una dintre implementările OSFR descrise în noua lucrare.
În practică, acest tip de inferență seamănă cu unele principii de fotogrammetrie care stau la baza câmpurilor de radianță neurale (NeRF). Aici însă geometria trebuie definită dintr-o singură fotografie, nu din cele 3–4 perspective care permit NeRF să deducă pozițiile intermediare lipsă și să creeze scene neurale 3D explorabile cu oameni.
(Totuși, nici NeRF nu este Tot Ce Îți Trebuie™, deoarece întâmpină un set de obstacole aproape complet diferit de cel al GAN-urilor când vine vorba de sinteză video facială.)
Au GAN-urile un loc în sinteza video facială?
Obținerea expresiilor dinamice și a pozițiilor din afara distribuției de antrenare dintr-o singură imagine sursă pare momentan o obsesie alchimică în cercetarea sintezei faciale GAN. Principalul motiv este că GAN-urile sunt singura metodă capabilă în prezent să producă fețe neurale la rezoluții destul de mari și cu fidelitate relativ ridicată. Deși cadrele deepfake cu autoencoder se pot antrena pe numeroase poziții și expresii reale, rezoluțiile lor de intrare și ieșire sunt limitate de VRAM și necesită o imagine „gazdă”. NeRF are limitări similare și, spre deosebire de celelalte două abordări, nu dispune în prezent de metodologii consacrate pentru schimbarea expresiilor faciale și are, în general, posibilități limitate de editare.
Singura cale spre un sistem precis de sinteză facială CGI/GAN pare a fi găsirea unei metode de reunire a unei identități din mai multe fotografii în spațiul latent. Astfel, codul identității unei persoane nu ar trebui să traverseze întregul spațiu pentru a utiliza parametri de poziție fără legătură cu ea, ci s-ar putea raporta la propriile imagini reale asociate ca referințe pentru transformări.
Chiar și într-un asemenea caz, sau chiar dacă întreaga rețea StyleGAN ar fi antrenată pe fețele unei singure identități, asemenea seturilor de antrenare ale autoencoderelor, logica semantică lipsă ar trebui probabil furnizată în continuare de tehnologii auxiliare precum segmentarea semantică sau fețele parametrice 3DMM. În acest scenariu, acestea ar avea cel puțin mai mult material cu care să lucreze.


